

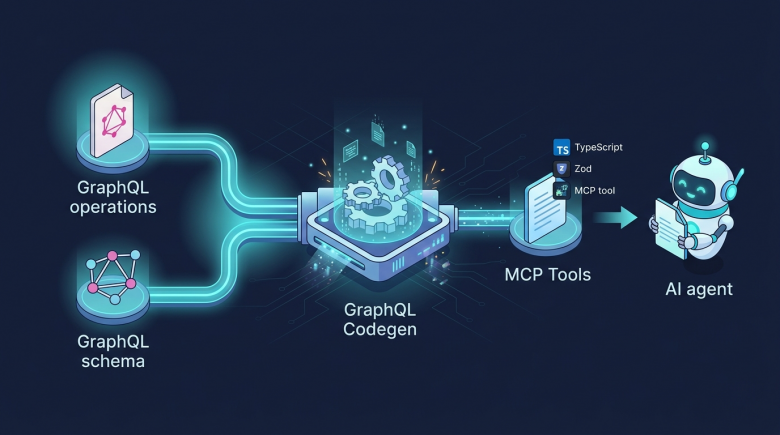
Привет! На связи Данил, TypeScript‑разработчик в команде Platform V DataSpace в СберТехе.
DataSpace — это модуль платформы для визуальной (low‑code) разработки бизнес‑приложений и управления данными. Он предоставляет GraphQL API для работы с базой данных. Мы развиваем продукт уже несколько лет, но сейчас из‑за бурного развития ИИ и MCP появилась вполне ожидаемая задача: подключить этот API к ИИ‑агентам через Model Context Protocol (МСP).
MCP нужен, чтобы ИИ‑клиент мог обнаруживать инструменты, понимать их входные параметры и вызывать внешние системы через стандартный протокол. На первый взгляд GraphQL хорошо подходит на роль источника MCP‑инструментов: схема уже описывает типы, входные аргументы и форму результата, но сама по себе не отвечает на главный вопрос: «какую часть API и с каким уровнем свободы следует открыть агенту?».
В DataSpace сценарий получился таким:
есть API GraphQL поверх модели данных;
есть ИИ‑агент, которому нужно выполнять прикладные действия;
между ними нужен MCP‑адаптер;
команда бэкенда хочет сохранить контроль над контрактом, типами и безопасностью.
Вопрос оказался не в том, можно ли подключить GraphQL к MCP. Можно. Интереснее другое: какой формы должен быть MCP‑адаптер для API GraphQL?
В этой статье я расскажу про несколько вариантов таких адаптеров и про наш выбор: генерировать MCP‑инструменты из заранее подготовленных GraphQL‑операций.
Какие бывают MCP‑адаптеры для GraphQL?
Адаптировать GraphQL под MCP можно несколькими способами. Главное различие — уровень свободы, который получает агент.
Инструмент для произвольных GraphQL‑запросов
Пример реализации: API Microsoft Fabric.
Самый гибкий вариант — сделать MCP‑инструмент, который принимает GraphQL‑запрос и переменные:
execute_graphql(
  query: string,
  variables?: Record<string, unknown>
)
Агент или MCP‑клиент сам формирует запрос, выбирает поля и передаёт переменные. Вместе с такой гибкостью модель получает ответственность за корректность GraphQL‑запроса: выбор полей, названия, правила работы с null и переменные. Selection set остаётся динамическим, поверхность API получается широкой, а команда бэкенда анализирует уже выполненные запросы.
Такой подход даёт агенту максимум свободы и хорошо подходит для исследований, локальной разработки, прототипирования, изучения незнакомой схемы или создания инструментов разработчика, когда важно быстро начать работать с произвольным API GraphQL. Для начала достаточно одного универсального инструмента, поэтому прототип можно собрать быстро.
Инструменты из схемы и корневых полей
Пример реализации: parob/graphql‑mcp.
В этом варианте MCP‑инструменты создают из корневых полей типов Query и Mutation. Агент получает готовый набор инструментов с именами и аргументами, близкими к корневым полям.
Такой формат проще инструмента для произвольных запросов и позволяет быстро открыть значимую часть API через MCP. GraphQL‑схема уже содержит достаточно информации для автоматического построения инструментов, поэтому подход удобен на ранних этапах разработки. При этом набор инструментов следует GraphQL‑схеме. Часто она шире и детальнее прикладного контракта, который мы хотим предоставить ИИ‑агенту.
Инструменты из фиксированных GraphQL‑операций
Примеры реализаций: Apollo MCP Server, WunderGraph Cosmo MCP Gateway, GraphQL Hive MCP plugin.
Здесь MCP‑инструмент соответствует заранее написанной GraphQL‑операции. Агент выбирает инструмент и заполняет переменные. Текст GraphQL‑операции заранее задаёт разработчик.
По структуре GraphQL‑операция близка к MCP‑инструменту: у неё есть имя, входные переменные, selection set и форма результата. Разработчик может прочитать её, провести ревизию и проверить по схеме.
Операции можно хранить в репозитории, обсуждать в pull request, проверять по GraphQL‑схеме и использовать как allowlist для доступной агенту поверхности API. Так мы получаем предсказуемый selection set, понятный аудит и полный контроль команды бэкенда над API‑контрактом.
Набор операций становится отдельным артефактом, который команда может поддерживать вместе с кодом. Поэтому подход хорошо подходит для production‑сценариев, корпоративных API и чувствительных данных. А ещё он хорошо ложится на динамические GraphQL‑шлюзы: Apollo, WunderGraph и Hive. Они собирают доступные операции во время запуска и сразу предоставляют по ним API MCP.
Кодогенерация из GraphQL‑операций
Примеры реализаций: наш генератор, labd/graphql‑codegen‑mcp‑tools‑poc.
Это развитие operation‑derived подхода. GraphQL‑операции остаются источником истины. На их основе генерируются TypeScript‑типы, Zod‑схемы, объявления MCP‑инструментов и вспомогательный код для регистрации инструментов.
Похожую идею развивает Lab Digital в graphql‑codegen‑mcp‑tools: GraphQL‑операции помечаются MCP‑директивами, проходят через GraphQL Code Generator, превращаются в описания инструментов.
Кодогенерация особенно полезна, когда MCP‑сервер становится частью продукта. В сгенерированном коде видно, какие инструменты появились или исчезли, какие поля стали обязательными, какие значения enum изменились, как поменялась форма результата и какие описания инструментов увидит модель.
Все эти изменения можно проверить локально и в CI до вызова инструмента агентом. При этом у подхода есть и сопутствующие издержки: в проекте появляется дополнительный этап — кодогенерация, и нужно будет поддерживать конфигурацию генератора вместе с остальным кодом.
Кодогенерация даёт типобезопасность, сокращает ручную работу, добавляет проверку данных через Zod и позволяет сформировать diff.
Мы выбрали именно этот вариант — фиксированные GraphQL операции и кодогенерацию в TypeScript/Zod, — так как нам нужен был адаптер, в котором GraphQL‑разработчики продолжают описывать и проверять контракт привычными GraphQL‑операциями, а агент получает ограниченный набор MCP‑инструментов вместо всего API GraphQL.
Общая схема работы
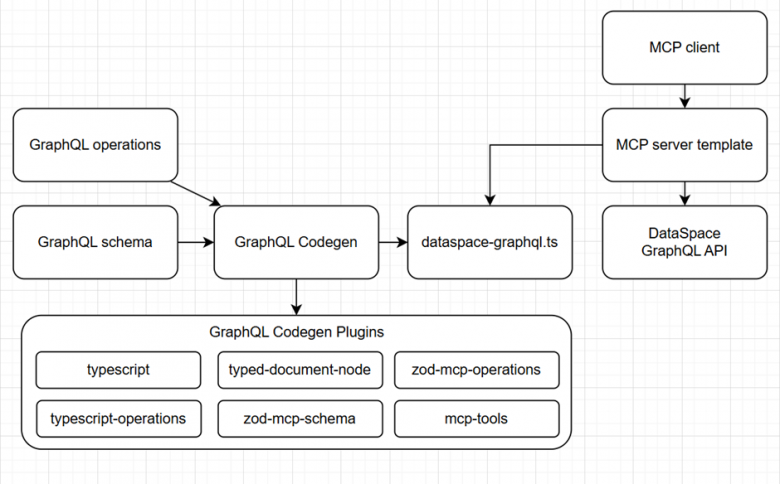
На вход генератору подаются:
GraphQL‑схема;
набор заранее написанных операций;
конфигурация;
список плагинов;
описания и аннотации инструментов, настройки пользовательских скаляров;
настройки генерации TypeScript и Zod.
Кодогенератор вызывает набор плагинов и создаёт dataspace‑graphql.ts: TypeScript‑типы, GraphQL документы, Zod‑схемы для входных и выходных данных и описания MCP‑инструментов. Шаблонный MCP‑сервер импортирует этот файл, регистрирует инструменты в McpServer и использует обработчик по умолчанию, который вызывает нужную GraphQL операцию в DataSpace и возвращает structuredContent.
Во время запуска сервер работает со сгенерированным TypeScript‑модулем с известным набором инструментов. Работа со схемой, операциями и источниками схемы происходит до запуска MCP‑сервера.
Почему всё на TypeScript? Мы выбрали его как простой и удобный язык для потребителей DataSpace и в целом нашей low‑code платформы, частью которой является DataSpace наряду с другими решениями для автоматизации, оркестрации процессов, проектирования моделей данных и генерирования отчётности. Сгенерированный TS‑модуль размещается рядом с кодом шаблонного MCP‑сервера, а кастомные инструменты можно дописывать там же.
Посмотрим, как это выглядит на простой операции: из одного GraphQL‑запроса получаются TypeScript‑типы, Zod‑схемы и MCP‑инструмент.
Демо: поиск клиник по городу
Демомодель DataSpace описывает предметную медицинскую область: клиники, врачей, пациентов, расписания, приемы и адреса. Для примера ограничимся поиском клиник по городу.
Сама GraphQL операция выглядит так:
query searchClinicByCity($cityName: String!) {
  searchClinic(
    cond: """
    it.address.city.$upper $like ${cityName}.$upper + '%'
    """
  ) @strExpr(string: $cityName) {
    elems {
      id
      name
      address {
        city
        street
      }
    }
  }
}
Разработчик операции заранее задает DataSpace cond, директиву @strExpr и набор полей клиники. Агент передаёт один параметр — cityName.
Пример ответа GraphQL API:
{
  "data": {
    "searchClinic": {
      "elems": [
        {
          "id": "7670926301867474949",
          "name": "Бест Клиник",
          "address": {
            "city": "Москва",
            "street": "Новочеремушкинская ул"
          }
        },
        {
          "id": "7670926301867474951",
          "name": "Вита Мед",
          "address": {
            "city": "Москва",
            "street": "Цурюпы ул"
          }
        }
      ]
    }
  }
}
По каждой GraphQL‑операции кодогенератор формирует Zod‑схемы для переменных и ответа:
export const SearchClinicByCityQueryVariablesSchema = z.object({
  cityName: z.string(),
}).strict();
export const SearchClinicByCityQuerySchema = z.object({
  searchClinic: z.object({
    elems: z.array(z.object({
      id: z.string(),
      name: z.string().nullable(),
      address: z.object({
        city: z.string().nullable(),
        street: z.string().nullable()
      })
    }))
  })
});
Дальше генерируется описание MCP‑инструмента:
export const SearchClinicByCityToolDefinition = {
  name: 'SearchClinicByCity',
  document: SearchClinicByCityDocument,
  inputSchemaObject: SearchClinicByCityQueryVariablesSchema,
  outputSchemaObject: SearchClinicByCityQuerySchema,
  config: {
    title: 'SearchClinicByCity',
    description: 'Search clinics by city name',
    annotations: {
      title: 'SearchClinicByCity',
      readOnlyHint: true,
      destructiveHint: false,
    },
    inputSchema: SearchClinicByCityQueryVariablesSchema.shape,
    outputSchema: SearchClinicByCityQuerySchema.shape,
  }
} satisfies ToolDefinition

export const allMcpTools: ToolDefinition[] = [
  SearchClinicByCityToolDefinition,
  // и остальные инструменты
];
Сервер импортирует сгенерированный модуль и регистрирует инструменты в McpServer:
const mcpServer = new McpServer();

for (const tool of allMcpTools) {
  mcpServer.registerTool(tool.name, tool.config, defaultMcpHandler(tool));
}
После запуска мы открываем @modelcontextprotocol/inspector и видим GraphQL‑операцию как обычный MCP‑инструмент.
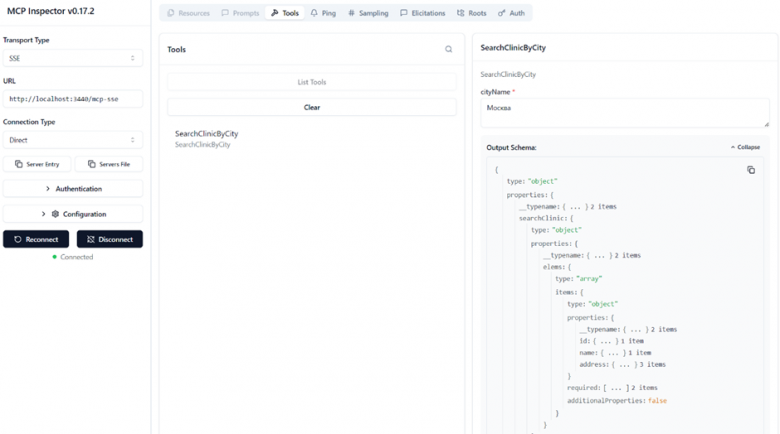
Вызов SearchClinicByCity с параметром cityName = "Москва" возвращает структурированный ответ. Текстовый fallback необходим для MCP‑клиентов, не поддерживающих structuredContent. Инспектор использует outputSchema для проверки ответа MCP‑сервера.
Не так уж много в наше время агентов, которые прокидывают outputSchema в контекст LLM.
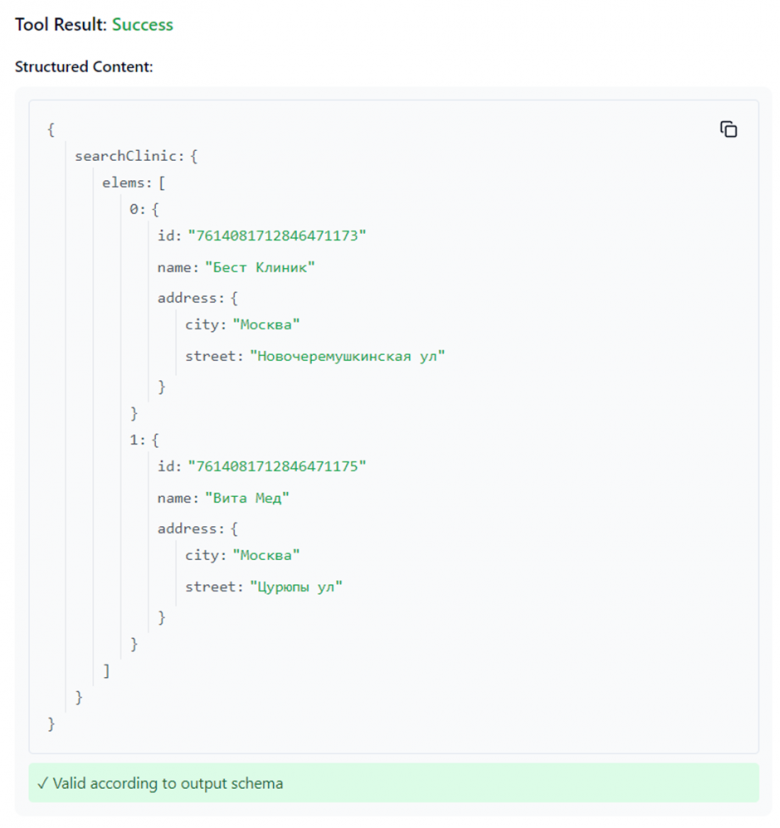
Из этого простого примера понятно главное: агент не пишет GraphQL. Он выбирает инструмент и заполняет переменные, а selection set, DataSpace‑условие, типы и форма результата уже зафиксированы в операции.
Где легко ошибиться: null, omitted и default
Мы решили использовать MCP‑контракт (JSON Schema) как раннюю проверку формы запроса, а не как полную копию GraphQL input coercion. Допускаем осознанное упрощение отдельных гибкостей GraphQL. API GraphQL остаётся финальным источником истины, а JSON Schema и Zod‑схемы отображают его для агентов.
Возьмем маленький пример:
input ClinicSearchInput {
  cityName: String!
  district: String
  limit: Int! = 10
}
Здесь легко смешать две разные оси. Первая ось — что реально пришло в запросе:
Передано |
Что значит |
Значение |
Поле передано с конкретным значением |
|
Поле передано явно как |
|
Поле не передано вообще |
Вторая ось — что объявлено в GraphQL‑схеме:
В схеме |
Что значит |
|
Поле может принять |
|
Поле не может принять |
|
Если поле не передано, то API GraphQL подставит значение на этапе |
Есть небольшая тонкость в том, что null и omitted — разные вещи. Значение по умолчанию применяется только к omitted, но не к явно переданному null. Это поведение сохранено в MCP‑генераторе.
Для генератора это можно свести к практической таблице:
Поле |
Можно не передавать |
Можно null |
Zod |
|
Нет |
Нет |
|
|
Да |
Да |
|
|
Да |
Нет |
|
Из этого следуют правила:
requiredв JSON Schema ставится только дляNon-Null‑поля без значения по умолчанию;nullable‑тип GraphQL отражается как возможность передатьnull;omittedне нужно заменять наnull;решили не переносить стандартные значения GraphQL в Zod через
.default(...), чтобы MCP‑слой не становился второй реализацией GraphQLinput coercion.
Практическое правило для агента: не передавать null вместо неизвестного или пропущенного значения — использовать только в случае явной необходимости установить значение в null.
Для списков допустимость null нужно отображать на двух уровнях: для самого списка и для его элементов.
Тип GraphQL |
Zod |
|
|
|
|
|
|
|
|
В GraphQL для типа [[Int]] можно передать значение 1, и input coercion приведёт его к [[1]]. Для упрощения JSON Schema от этой семантики решили отказаться. Указываем явный список с полной вложенностью.
GraphQL input objects не принимают поля, которых нет в типе, и MCP‑слой может поймать это до вызова GraphQL API. В JSON Schema выставляется additionalProperties: false, для Zod это .strict().
GraphQL enum хорошо отображается в строковый enum JSON и z.enum(...):
enum SortDirection {
  ASC
  DESC
}
const SortDirectionSchema = z.enum(['ASC', 'DESC']);
Базовые скаляры отображаются ожидаемо. С пользовательскими скалярами сложнее. Их бизнес‑семантику нельзя надёжно вывести из имени. DateTime, Decimal, JSON, UUID и внутренние доменные скаляры требуют явной настройки или консервативного fallback до number, string или boolean.
С рекурсивными GraphQL input objects тоже лучше быть осторожным. JSON Schema может описывать рекурсию через $defs и $ref, но лучше проверять поддержку в конкретном MCP‑клиенте и валидаторе.
Кроме схемы и операций генератору полезно дать понятные агенту описания:
для операции и инструмента, чтобы агент лучше выбирал нужный инструмент;
для входных полей, особенно если имя поля не раскрывает бизнес‑смысл;
для enum и его значений;
для аннотаций инструмента;
Чем меньше агент должен додумывать на уровне API‑контракта, тем выше шанс, что он будет полезен на уровне бизнес‑задачи.
Когда инструмент должен быть выше уровнем, чем GraphQL‑операция
Не каждый хороший MCP‑инструмент должен быть прямым отображением одной GraphQL‑операции.
Допустим, есть задача: найти свободные слоты у врача. В модели данных расписание может храниться в виде занятых интервалов. Человеку дальше всё понятно: взять рабочее расписание, вычесть занятые интервалы, отфильтровать прошедшее время и вернуть свободные окна.
Но для агента этой прикладной логики может быть уже слишком много. Он может ошибиться в границах интервала, неправильно обработать часовой пояс, вернуть слот поверх существующей записи или перепутать длительность приёма. В таком случае полезнее сделать свой TypeScript‑обработчик поверх GraphQL‑операции. GraphQL по‑прежнему отвечает за получение данных, а TypeScript‑слой превращает их в более удобный для агента результат.
const doctorFreeSlotResponseSchema = z.object({
  elems: z.array(z.object({
    doctorScheduleId: z.string(),
    beginDate: z.string(),
    endDate: z.string()
  }))
})
server.registerTool(
  'SearchDoctorFreeSlotsInPeriod',
  {
    title: 'SearchDoctorFreeSlotsInPeriod',
    description: 'Returns hourly free slots for a doctor schedule in the requested period',
    inputSchema: SearchDoctorScheduleByDoctorIdAndPeriodQueryVariablesSchema.shape,
    outputSchema: doctorFreeSlotResponseSchema.shape,
    annotations: {destructiveHint: false, readOnlyHint: true}
  },
  async (args, extra) => {
    const response = await execute(SearchDoctorScheduleByDoctorIdAndPeriodDocument, args)
    const structuredContent: z.infer<typeof doctorFreeSlotResponseSchema> = {
      elems: findDoctorFreeSlots(response.searchDoctorSchedule.elems)
    }
    return {
      content: [{type: 'text', text: JSON.stringify(structuredContent)}],
      structuredContent,
    }
  }
)
В этом примере переиспользуется входная схема от сгенерированной GraphQL‑операции SearchDoctorScheduleByDoctorIdAndPeriod. А вот результат уже другой: вместо сырых расписаний и занятых интервалов возвращается готовый массив свободных окон. Функция findDoctorFreeSlots инкапсулирует прикладную логику: берёт расписание врача, учитывает уже занятые интервалы и собирает свободные слоты. Для агента эта логика становится частью контракта инструмента, а не задачей, которую нужно каждый раз выводить заново.
Смысл в том, чтобы дать агенту инструмент на уровне задачи, а не на уровне API CRUD. Генератор при этом не закрывает систему. Он даёт базовый слой: типы, операции, Zod‑схемы, обработчики и регистрацию, а рядом можно вручную писать прикладные инструменты, переиспользуя тот же GraphQL‑клиент, авторизацию, контекст и сгенерированные типы.
Безопасность
Подход с фиксированными операциями помогает уменьшить поверхность API, которую получает агент. Если в операции нет какого‑то поля, то агент не сможет просто добавить его в запрос. Набор доступных инструментов и GraphQL‑операций известен заранее. Аннотации MCP вроде readOnlyHint и destructiveHint помогают агенту и клиенту аккуратнее выбирать инструменты, но реальные проверки прав осуществляются на стороне DataSpace:
RBAC, ABAC и RLS на стороне DataSpace;
JWT сервисного аккаунта или конкретного пользователя;
дополнительные предикаты безопасности на уровне операций;
лимиты и проверки, которые не зависят от поведения модели.
MCP‑сервер может вызывать API DataSpace GraphQL с JWT исходного пользователя или с JWT сервисного аккаунта. Выбор зависит от модели доступа. Например, RLS‑правило может ограничивать результат поиска данными текущего пользователя. В этом примере обычный пользователь видит только запись со своим email, а пользователь с ролью manager — все записи:
{
  "name": "searchPerson",
  "body": "...",
  "pathConditions": [
    {
      "path": "searchPerson",
      "cond": "it.email == ${jwt:email} || 'manager' $in ${[]:jwt:realm_access.roles}",
      "description": "Select all records for managers; otherwise select the current user's record"
    }
  ]
}
RBAC‑правило решает другую задачу: не фильтрует результат, а запрещает саму операцию, если у пользователя нет нужной роли. Например, создание клиники можно разрешить только администратору:
{
  "name": "createClinic",
  "body": "...",
  "checkSelects": [
    {
      "conditionValue": "'administrator' $in ${jwt:roles}",
      "typeName": null,
      "description": "Only administrator can create clinic"
    }
  ]
}
В DataSpace модель безопасности изначально строится вокруг фиксированных операций. Поэтому MCP‑инструменты на основе операций не создают отдельный контур ограничений, а переносят уже существующие границы доступа в MCP: агент работает только с заранее определённым набором операций, состав которого можно явно проверить.
Что получилось
Есть несколько способов соединить GraphQL и MCP:
MCP‑адаптер произвольных запросов хорош для исследования API и быстрых сценариев разработки.
MCP‑инструменты из схемы и корневых полей помогают быстро открыть API через MCP.
Для управляемой поверхности API мы выбрали инструменты на основе операций. Кодогенерация делает этот подход более контролируемым. Агент работает с заранее подготовленным набором операций: выбирает инструмент и заполняет переменные. GraphQL‑разработчики при этом сохраняют контроль над телом операции, selection set и формой результата.
Подход не привязан только к DataSpace, его можно адаптировать для других API GraphQL. Даже кажется возможным адаптировать генератор под другие языки. Например, формировать Pydantic модели для Python. А в ближайшем будущем мы планируем развивать более гибкую конфигурацию инструментов. В итоге GraphQL‑операции становятся общим контрактом: разработчики управляют составом и разрешениями GraphQL‑операций, а агент работает с предсказуемым и явно заданным набором MCP‑инструментов.