

В час пик средняя скорость передвижения по Бангалору, по данным рейтинга TomTom, около 14 км/ч. Город на втором месте в мире по загруженности. Чтобы управлять таким движением, нужны данные: где пробки сейчас и что будет на дорогах через пять минут. Дорожных датчиков в городе почти нет, зато есть больше пяти тысяч камер безопасности.
Из их видео можно получить и карту пробок, и краткосрочный прогноз. Но записи в одном месте не собрать: канал не выдержит такой поток, а камеры принадлежат разным ведомствам, и делиться сырыми кадрами те не обязаны.
Исследователи из индийского института IISc предложили другой путь: видео обрабатывать рядом с камерой, а дальше передавать только числа — сколько машин какого типа проехало. Систему назвали TrafficFab и проверили на стенде из 400 видеопотоков.
Система состоит из трех слоев и трех контуров управления
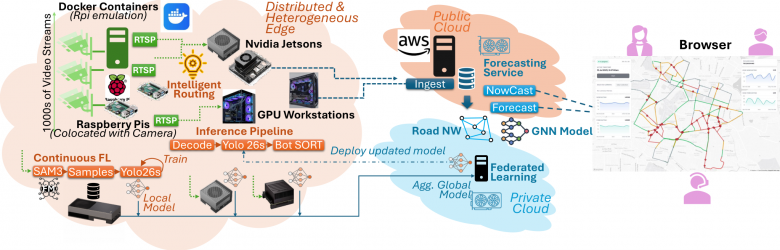
Архитектура TrafficFab с тремя слоями. Источник
Первый слой — край сети. Здесь 42 Raspberry Pi (недорогие одноплатные компьютеры) воспроизводят записанные ролики так, будто это живые камеры. А видео рядом с источником обрабатывают Jetson (компактные компьютеры Nvidia со встроенной видеокартой для ИИ) и рабочие станции с GPU.
Второй слой — публичное облако Amazon: туда приходят числа с камер, там оценивают обстановку и строят прогноз.
Третий слой — частное облако. Он не участвует в пути от камеры до прогноза, а поддерживает качество первого слоя: на его GPU‑станции собирают и усредняют обновления детектора, которые вычислили отдельные устройства. Кроме того, в стенде в частном облаке десять обычных серверов воспроизводят видеопотоки, когда нужно проверить нагрузку до тысячи камер.
Поверх этих слоев есть три контура управления, и у каждого своя задача:
Планировщик на краю решает, какое устройство обрабатывает какую камеру.
Облачный сервис выделяет ресурсы для прогноза, когда данные одновременно запрашивает большее число камер и приложений, например панелей операторов.
Контур дообучения выбирает, когда и на чем подправить детектор машин.
Прямо у дороги камера превращается в счетчик машин
Каждый видеопоток попадает на вычислительный узел рядом с камерой. Там кадры декодируются, собираются в пачки и уходят детектору YOLO26s. Модель специально дообучили на размеченных кадрах с индийских дорог. Зачем? Там трехколесники, грузовики и мотороллеры едут в одном потоке, без разметки полос. Стандартные детекторы на такой картине ошибаются.
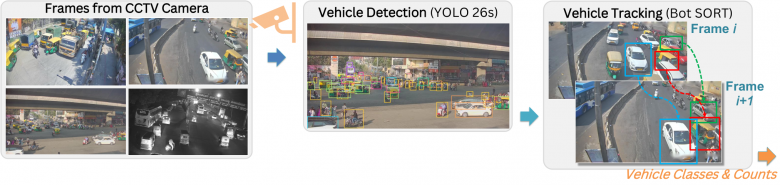
Пример кадров с перекрестков Бангалора. Источник
Одного детектора мало. Чтобы не посчитать машину дважды, поток пропускают через трекер, который присваивает машине постоянный номер на протяжении нескольких кадров. На выходе мы получаем два ряда данных. Первый показывает, сколько машин каждого класса попало в кадр за секунду. Второй хранит пары «номер трека, класс» для каждого момента времени.
В облако уходят короткие записи, без кадров и без промежуточных признаков. Облачный сервис принимает их пачками по 15 секунд (интервал можно менять) и складывает во временные ряды по камерам.
Сколько данных проходит через систему, показывает часовой прогон на 400 камерах: в сумме детектор давал до 48 тысяч обнаружений в секунду, свыше 99% времени их было больше 40 тысяч. Состав потока получился разнообразным: туктуки составили около 30% найденных машин, грузовики около 25%, хэтчбеки около 12%.
Городская сеть в эксперименте не подключена: камеры заменили записями. Утренние ролики раздают как прямые трансляции 42 одноплатных компьютера Raspberry Pi, вместе около сотни видеопотоков. Для больших нагрузок добавили десять серверов, которые вместе раздают до тысячи потоков. Остальная система получает такое видео по тому же протоколу, что и от обычной IP‑камеры, и не отличает запись от прямой трансляции. Поэтому все, что идет после камеры, работает по‑настоящему. Не проверили только работу с реальной городской сетью камер.
Как экономят энергию
Систему можно собрать из разных обрабатывающих устройств: в стенде их 29, и это восемь типов, от компактных Jetson до рабочих станций с GPU. Планировщик решает, сколько камер отдать каждому из них. От этого зависит, сколько на ту же работу уйдет энергии: включенное устройство потребляет ее даже при малой нагрузке, а потребление с числом потоков у разных моделей растет по‑разному. На 50 потоках, например, одна расстановка требует 116 Вт, а другая 235 Вт.
Предел каждого устройства определяли замером: добавляли потоки, пока оно не переставало выдавать 20 кадров в секунду на каждый поток. Jetson Xavier AGX выдерживает 7 потоков при мощности около 38 Вт. Jetson Orin AGX 32 ГБ тянет 20 потоков при 45 Вт, то есть примерно втрое больше при росте мощности лишь на 18%. Больше всех, 74 потока, обслуживает станция с RTX 6 000 Pro при 196 Вт, а RTX 4 090 на 55 потоках расходует уже 236 Вт.
Задача стоит так: имеется некоторое количество потоков и устройств. Каждый поток нужно разместить ровно один раз, не превышая предел ни одного устройства, и сохранить на включенных устройствах нужную частоту кадров. Из допустимых вариантов выбирают тот, где суммарная мощность минимальна. Мощность каждого устройства известна только из замеров — формулы не помогут. Лучшую расстановку находят точным расчетом (динамическим программированием): он шаг за шагом добавляет устройства, на каждом шаге помнит самый экономичный вариант и в конце выдает расстановку с минимальной мощностью. Если потоков больше, чем выдерживают все устройства вместе, решения нет: для стенда из Jetson этот предел равен 286 потокам, со станциями — 1000.
Разница энергопотребления у комбинаций заметнее всего, когда камеры подключают уже после запуска. Здесь мало найти лучшую расстановку по мощности: чтобы к ней прийти, работающие потоки придется переселять. А каждый переезд — это пауза в обработке и перенастройка устройства. Поэтому сравнивают не только мощность, но и цену переездов. Подходов три:
лучшую расстановку считают заново для всех потоков, старых и новых, часть работающих потоков при этом переезжает на другие устройства;
работающие потоки не трогают, новые раскладывают по оставшимся местам;
переезд разрешен, но за каждый перенесенный поток начисляют штраф.
Для сравнения взяли еще четыре правила, по которым каждый новый поток сразу ставят на подходящее устройство, не пересчитывая остальные. Такие правила называют жадными: они берут лучшее на сегодня и не заглядывают вперед.
Правила различаются двумя признаками. Устройства можно перебирать по вместимости, начиная с самых маленьких, — или по расходу энергии на кадр, начиная с самых экономных. А потоки можно набивать в одно устройство до предела и только потом брать следующее — или каждый раз ставить на то, где свободного места больше. Сочетания этих признаков и образуют четыре правила.
Сравнивать подходы можно в двух режимах. В статическом все камеры известны заранее, и расстановка считается один раз, до запуска. В динамическом потоки подключаются по ходу работы, и расстановку приходится пересматривать. Начнем со статического — он служит точкой отсчета.
В этом режиме на 50 потоках в кластере из одних Jetson лучшая из возможных расстановок (оптимум) потребляет 116,2 Вт, правило «сначала самые маленькие» — 208,6 Вт, а правило «где больше места» — 235,5 Вт. Когда к Jetson добавляют рабочие станции, плохое решение обходится дороже: на тех же 50 потоках правило «где больше места» доходит до 748,9 Вт. Проигрывают те правила, что смотрят только на вместимость.
Другое дело — динамика, когда камеры подключаются уже после запуска. Здесь у каждого подхода своя цена. Тут точка отсчета — оптимум по мощности, который пересчитывает расстановку на каждом шаге: он дает минимальную мощность, но именно из‑за пересчета и возникают переезды.
пересчет лучшей расстановки на каждом шаге дает самую низкую мощность, но 1 306 переездов работающих потоков, а каждый переезд нарушает работу;
вариант со штрафом сокращает переезды до 376, то есть в 3,5 раза, и тратит в среднем на 13,8 Вт больше оптимума;
вариант без переездов не нарушает ничего, но тратит в среднем на 164 Вт больше оптимума.
Для ориентира: при 500 потоках весь кластер по расчету потребляет около 1 437 Вт. Вариант со штрафом платит за стабильность малой долей этой мощности, а вариант без переездов — заметно большей.
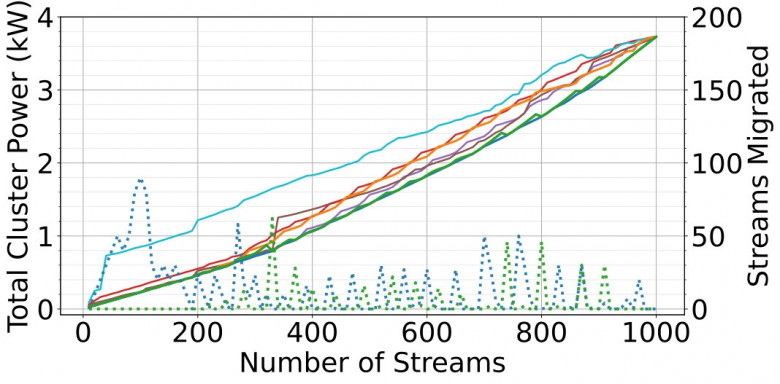
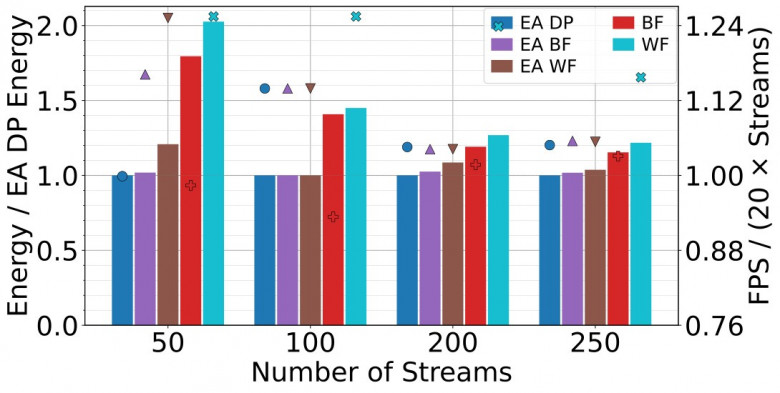
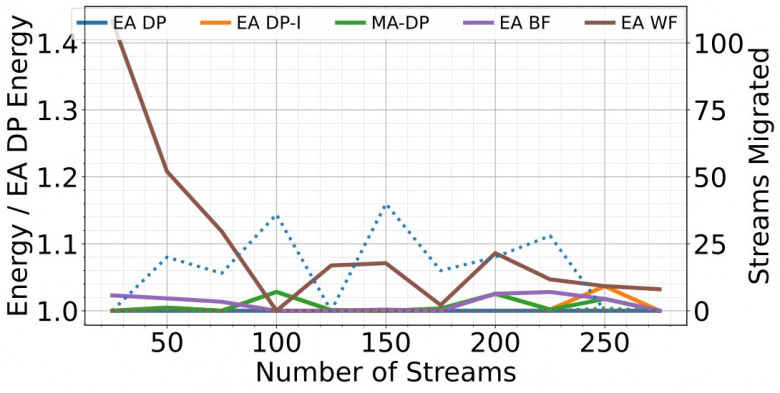
Cравнение алгоритмов размещения по мощности и числу переездов. Источник
Расчеты проверили на реальном кластере. Порядок алгоритмов по потреблению совпал с тем, что обещала теория. Все три алгоритма с динамическим программированием вытянули 20 кадров в секунду. Но экономная расстановка для 100 потоков может сильно отличаться от лучшей для 90: включается другой набор устройств, и приходится переселять часть работающих камер, в одном из шагов сразу 90 потоков. Если никого не трогать, новые потоки попадают на оставшиеся места, не всегда самые экономные, и мощность растет. Штраф за переезд задает цену: потоки переселяют, только когда экономия энергии ее перекрывает.
Облачный прогноз ограничен скоростью чтения данных
Числа с камер приходят в облако Amazon. Там три сервиса принимают их, показывают обстановку на дорогах и строят прогноз на ближайшие минуты. Прогноз делает графовая нейросеть TrendGCN. Камеры стоят не на всех перекрестках, поэтому сеть работает с упрощенным графом из перекрестков с камерами, а загруженность улиц между ними вычисляет по счетчикам.
Масштабирование проверяли на виртуальных машинах разного размера: от двух ядер и 8 ГБ памяти до 16 ядер и 64 ГБ. В самом тяжелом сценарии прогноз одновременно запрашивали восемь приложений, а видеопотоков было 2400: их получили, размножив 400 записанных роликов. На самой маленькой машине ответ приходил за 113 секунд, на самой большой — за 58. Ресурсов стало в восемь раз больше, а отвечать система стала лишь вдвое быстрее.
Причина в чтении данных с диска: оно упирается в потолок около 660 операций в секунду, а процессор загружен примерно на 13% — заняты чуть больше двух ядер из шестнадцати. В препринте предлагают разрезать граф между несколькими машинами, чтобы снять это ограничение, но пока не пробовали.
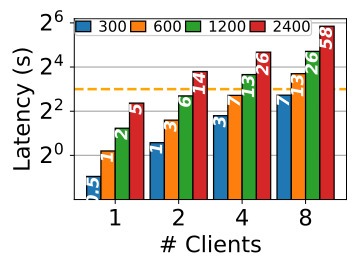
Задержка ответа при разных размерах виртуальной машины и нагрузке. Источник
Детектор доучивается на подсказках большой модели, а видео остается на месте
Детектор, обученный один раз, со временем устаревает: меняются виды машин, ракурсы камер, погода. Проще всего было бы собрать видео со всех камер в одном месте и дообучить модель на нем, но такой поток тяжело передать, а камеры могут принадлежать разным ведомствам, например полиции, метро и городскому транспорту, и делиться записями они не обязаны. Поэтому детектор дообучают рядом с камерами, а в центр уходят только обновления модели.
Раз в секунду устройство рядом с камерой берет случайный кадр. Дальше смотрит, насколько детектор уверен в найденных машинах. Если уверенность выше 0,7 — кадр идет в обучающую выборку как есть. Если ниже 0,4 — его отбрасывают как шум. А сомнительные результаты между этими значениями уходят на разметку крупной модели SAM 3. Она различает типы машин точнее базового детектора, но живет только на GPU‑станциях и работает в фоне. Jetson для нее слишком медленный — около 0,8 кадра в секунду. RTX 5 090 выдает 6,7 кадра, но потребляет около 479 Вт.
Дальше каждое устройство дообучает свою копию детектора, на раунд уходит 30–108 секунд. В центр отправляют только обновления весов, там их усредняют по схеме FedAvg.
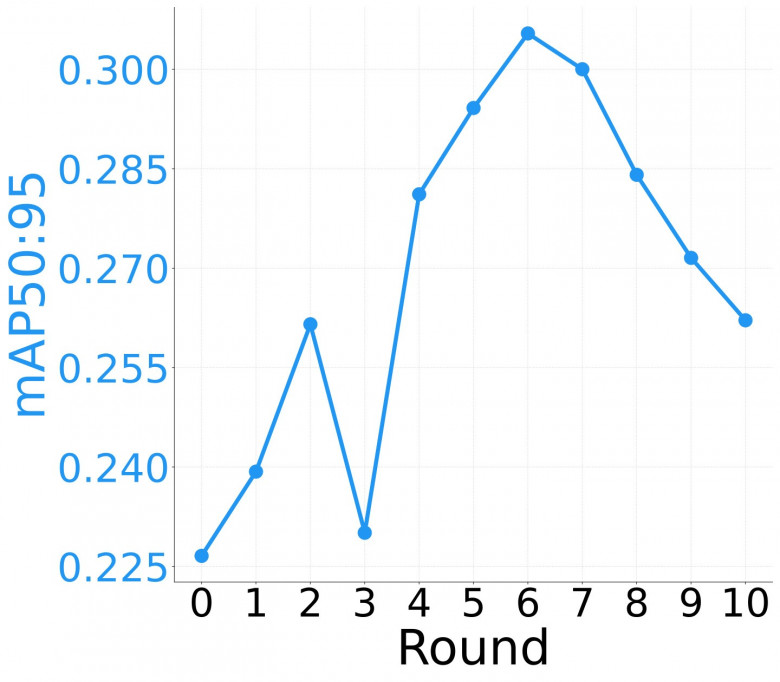
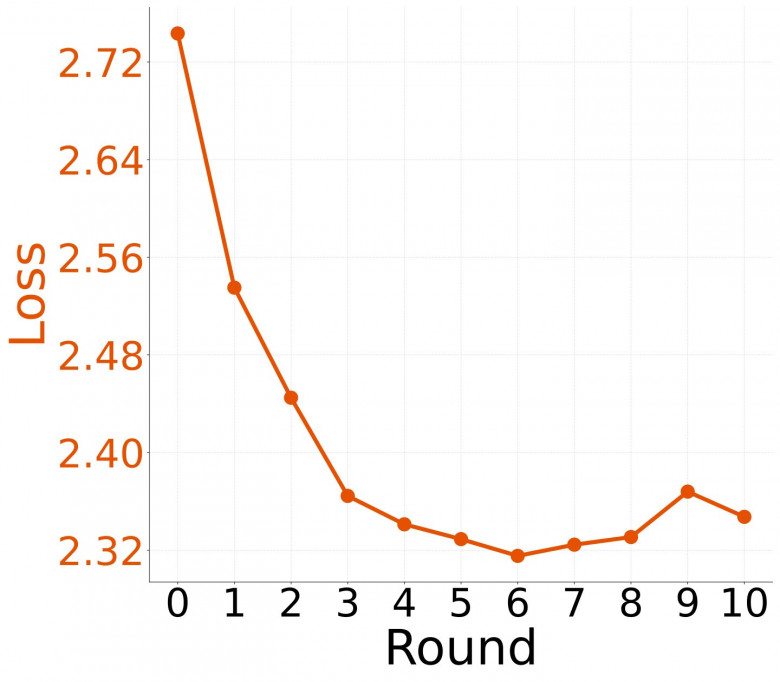
Изменение mAP и функции потерь по раундам, рисунок 10 препринта. Источник
Контуры связаны потоками и общим железом
И вот здесь мы подходим к главному. Каждый контур измерен отдельно: планировщик по профилям устройств, облачный прогноз на машинах разного размера, обучение по времени раундов и загрузке. Как они работают вместе, определяет общая единица: поток.
Количество активных потоков определяет все сразу: сколько устройств запустит планировщик, сколько записей уйдет в облако и сколько кадров попадет в выборку для дообучения. Дообучают модели там же, где обрабатывают камеры, — на Jetson и станциях. Но загрузка у них разная. У Orin во время обучения GPU загружен в среднем на 92%, у Xavier — на 83,5%, а у станций с RTX 4 090 и 5 090 — всего на 57–60%. Вот почему тяжелых «учителей» держат на станциях: там хватает запаса и на разметку, и на обучение одновременно.
Планировщик определяет предел устройства по замерам без обучения, при 20 кадрах в секунду на поток. Как этот предел меняется, пока на том же Jetson идет раунд дообучения, в препринте не показано. Цикл целиком продемонстрировали на конкурсе IEEE TCSC SCALE Challenge и заняли первое место: 400 потоков, около 90 устройств рядом с камерами, 21 вычислительный узел, четыре облачные машины и 454 контейнера. Цифр о том, как контуры влияют друг на друга при одновременной работе (скорость обработки, расход энергии, задержка), в препринте нет.
Что еще делают на эту тему
TrafficFab не единственная превращает городские камеры в источник данных без пересылки всего видео в облако. Вот три похожих проекта:
EdgeCloudAI показали на конференции ACM MobiCom 2024. Стенд стоял на городской площадке NSF COSMOS в Нью‑Йорке: городские камеры и один edge-сервер с GPU Nvidia A100. На краю небольшая нейросеть замечает изменение сцены и проверяет, есть ли в кадре нужные объекты. В примере из публикации — рабочие и строительная техника. Лишнее система обрезает, а фрагмент видео с пониженными разрешением и частотой кадров отправляет в облако. Там его проверяет GPT-4o. Что искать, задает пользователь. По данным публикации, edge-GPU загружена всего на 5–7%, а облачные запросы обходятся не дороже 10 $ в неделю на камеру при круглосуточной работе. От TrafficFab система отличается задачей и тем, что в облако уходит видео, пусть и урезанное. Она ищет заданные происшествия, а карту загруженности не строит.
FilterForward бережет канал. У камеры ограниченная полоса, поэтому видео высокого качества в дата‑центр не отправить. Рядом с камерой каждый кадр сначала проходит через одну общую нейросеть, которая выделяет в нем основные признаки: это самая тяжелая часть работы, и ее делают один раз на всех. Дальше у каждого приложения есть свой микроклассификатор — небольшая сеть, которая по этим признакам отвечает на один вопрос: есть ли в кадре нужное событие, например пешеход на переходе. В дата‑центр уходят только подходящие кадры, а их уже разбирают полностью. В экспериментах на двух наборах реальных съемок объем передаваемых данных сократился в 6–13 раз — по сравнению с отправкой всего видео в сильно сжатом виде.
CIRCLES. В ноябре 2022-го консорциум университетов провел на трассе I-24 близ Нэшвилла эксперимент MegaVanderTest. Пять дней в утренний час пик по ней ездили 100 автомобилей с адаптивным круиз‑контролем под управлением ИИ. Задача — гасить волны остановок и разгонов, из‑за которых возникают пробки без видимой причины. Участок трассы длиной 4,2 мили (около 6,8 км) оснастили системой I-24 MOTION: 276 камер на 40 опорах. По их видео восстанавливали движение каждой машины. Но камеры там измеряли эффект управления, а TrafficFab оценивает и прогнозирует загрузку дорог, машинами не управляет.
Каковы итоги и перспективы эксперимента
Пока что это стенд для проверки идеи, городской системой он еще не стал. Живых камер в нем нет: видео воспроизводят из записей, сделанных с 7 до 8 утра с конца января по конец февраля 2025-го.
Основной прогон шел на 400 потоках. Планировщик на краю довели до 1 000 потоков, облачный прогноз — до 2400, причем в облаке лишние потоки получили размножением тех же 400 роликов, так что нового трафика там нет. Что дало дообучение, пока неизвестно: итоговое качество детектора в препринте не названо.
Новых моделей в работе нет: детектор, трекер, графовую сеть и крупную модель для разметки взяли готовыми. Вклад работы такой: алгоритмы размещения потоков, которые учитывают энергию и переезды; замеры пределов облачного прогноза и дообучение детектора без общего хранилища видео. Само видео при этом не исчезает: оно идет от камеры к ближайшему устройству, а сомнительные фрагменты кадров попадают на GPU‑станции для разметки. В общее хранилище для анализа уходят только числа и обновления модели.
Реальная жизнь города куда хаотичнее, и некоторые особо непредсказуемые передвижения невозможно учесть заранее. Проверить, как все это ведет себя на улице, предстоит уже за пределами лаборатории.
keinohrhasen_pitersky
Открою секрет: EDGE-детектор он и в России EDGE-детектор. Никаких краевых детекторов у меня для вас нет)