

На проектах миграции данных есть промежуточный этап, когда новая платформа данных уже достаточно большая, чтобы начать создавать проблемы, но ещё недостаточно зрелая, чтобы вокруг неё успела появиться полноценная observability‑инфраструктура.
Появляются десятки и сотни DAG, Spark‑приложений, таблиц Iceberg и цепочек зависимостей. Часть процессов уже переведена на новую платформу, часть всё ещё живёт в legacy, постоянно что‑то догружается, пересчитывается и меняется.
И довольно быстро простой вопрос: «Что сейчас вообще происходит на платформе?» перестаёт иметь очевидный ответ.
Чтобы понять причину задержки витрины, инженер идёт в Airflow. Потом открывает upstream DAG. Потом ещё один. Затем Spark History Server. Потом логи. Потом Grafana. Потом смотрит метаданные таблицы. А через двадцать минут обнаруживает, что проблема вообще началась тремя уровнями выше по линеджу.
При этом построение полноценного внутреннего инструмента наблюдаемости платформы почти никогда не является первым приоритетом проекта. Бизнес ждёт миграцию, аналитики ждут данные, команда исправляет пайплайны, инфраструктуру и производительность.
И здесь я хотела бы поделиться тем, какие инструменты мониторинга и операционного контроля для платформы данных можно быстро навайбкодить собрать за относительно короткий срок.
В результате получилось единое рабочее место, состоящее из двух связанных инструментов. Data Operations Dashboard объединяет мониторинг lineage, расписания, инцидентов и таблиц Iceberg, а Spark Monitor отвечает за диагностику Spark‑приложений:
Анализ зависимостей — Data Lineage.
Контроль расписания и длительности расчётов (Gantt).
Оперативный мониторинг инцидентов (Operational Health).
Наблюдение за физическим состоянием таблиц Iceberg.
Анализ эффективности Spark‑приложений (Spark Monitor).
Data Operations Dashboard построен на Python и FastAPI; для обработки и анализа данных используются Pandas и NetworkX. Клиентская часть разработана на React и TypeScript со сборкой через Vite, а визуализации — на Plotly и Cytoscape.js. Решение интегрируется с Airflow, GitLab, Trino и Iceberg и разворачивается в Docker.
Spark Monitor разработан на Python без тяжёлых серверных фреймворков. Данные из Spark Event Log обрабатываются собственным аналитическим модулем и сохраняются в SQLite. Веб‑интерфейс реализован на HTML, CSS и JavaScript.
Представленные ниже инструменты будут полезны тем, кто строит или эксплуатирует платформу данных в концепции Data Lakehouse и типичном для неё стеке Spark/Iceberg с оркестрацией через Airflow.
Источниками данных для дашборда служат конфигурации DAG из GitLab, метаданные и API Airflow, логи Spark (Event Logs), а также метаданные Iceberg, получаемые через Trino. Kibana в этой концепции выступает не источником, а следующим шагом для углубленной диагностики логов, куда пользователь переходит по прямым ссылкам.
1. Анализ зависимостей — Data Lineage
Важной частью дашборда стал интерактивный Data Lineage. Его задача — не просто показать статическую схему зависимостей, а помочь инженеру ответить на практические вопросы: почему не рассчитался конкретный DAG; какой upstream‑процесс стал первопричиной задержки; какие downstream‑витрины затронет текущее падение; выполняется ли процесс сейчас или уже завершился ошибкой; какие задачи входят в проблемный DAG и так далее
Источниками служат конфигурации DAG из GitLab и фактические данные о запусках из Airflow. В зависимости от реализации механизма связности между DAG (sensors, datasets, TriggerDagRunOperator) в конфигурациях отражены upstream‑связи. Важно учитывать ограничение: граф полон настолько, насколько зависимости описаны в конфигурациях. Неявные связи (например, чтение из одной таблицы без явного сенсора) потребуют дополнительного обогащения.
Для построения полного lineage применяется комбинация парсинга конфигураций, объектной модели графа и алгоритма обхода в ширину (BFS). BFS выбран, потому что позволяет естественно ограничивать глубину обхода (1, 2, 3, 5 уровней) и строить граф по слоям. Общая схема выглядит так:
GitLab‑конфиги → поиск и сбор зависимостей → таблица зависимостей → NetworkX‑граф → обход графа в ширину (BFS) → обогащение данными Airflow → JSON → визуализация в Cytoscape.
Таким образом, на одном графе объединяются два типа информации: логическая структура платформы и её текущее операционное состояние. Для выбранного DAG строятся обе стороны: upstream (от чего он зависит) и downstream (что зависит от него). Направления включаются независимо, а глубина ограничивается.
Скриншот страницы дашборда Lineage представлен ниже.
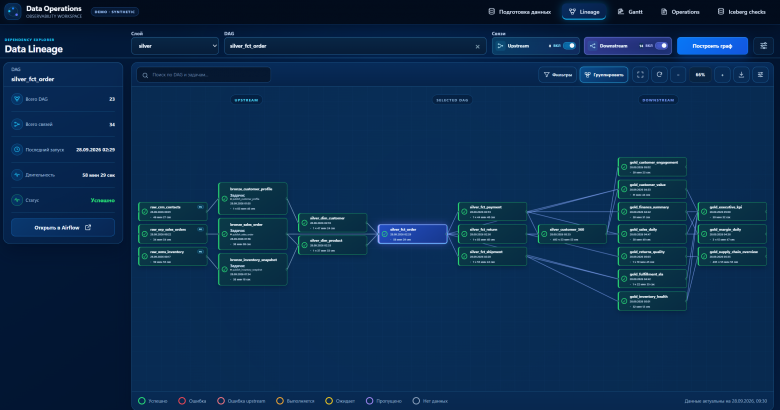
Обычный граф теряет ценность, если из него нельзя понять текущее состояние. Поэтому каждая вершина содержит операционную информацию из Airflow: статус последнего запуска, время старта, длительность, задачи и их состояния. Для выбранного DAG отображаются сводные показатели: количество связей, последний запуск, длительность, статус, а также ссылка для перехода в Airflow.
Кастомная разработка позволяет показывать в карточке DAG именно те сведения, которые нужны команде: владельца, ответственных, теги, критичность, регламент и ожидаемое время готовности.
Кастомный lineage не заменяет корпоративные каталоги (OpenMetadata, DataHub), если нужны тысячи объектов и column‑level lineage. Но он выигрывает, когда нужно быстро закрыть задачи эксплуатации и точно отразить внутреннюю архитектуру платформы без внедрения тяжелых систем.
2. Gantt‑дашборд: единая временная картина платформы
Gantt‑страница отвечает на вопрос, который сложно задать через стандартный интерфейс Airflow: какие процессы выполнялись одновременно, какие ждали upstream‑данные, когда начался реальный расчёт и где возникла задержка?
Главная особенность — отображение запусков разных DAG на одной временной шкале. Каждая строка — отдельный DAG, горизонтальная полоса — фактический интервал выполнения. Это позволяет увидеть платформу как единый производственный процесс, а не набор независимых пайплайнов.
Штатный интерфейс Airflow даёт подробную временную картину внутри выбранного DAG и его запусков. Кастомный дашборд решает другую задачу: объединяет разные DAG платформы на одной временной шкале и позволяет анализировать их совместное выполнение.
Для каждого процесса видны: момент старта и завершения, полная длительность, текущий статус, принадлежность к слою, время ожидания upstream‑данных и время непосредственного расчёта. Над основным Gantt расположен график «Одновременно выполняющиеся DAG», который показывает количество пересекающихся интервалов. Это помогает определить периоды пиковой нагрузки, корреляцию между нагрузкой и ростом длительности, а также потенциальную конкуренцию за ресурсы Spark‑ и Trino‑кластеров и Kubernetes.
Например, если в 06:00 одновременно стартуют десятки тяжёлых процессов и после этого расчётная часть большинства DAG увеличивается, это аргумент для разнесения расписаний.
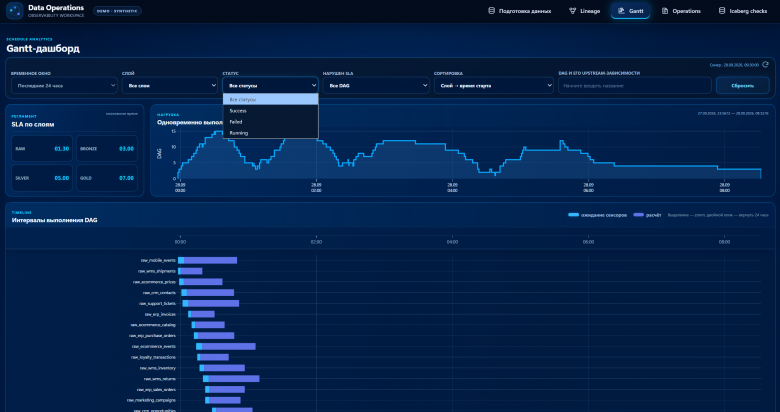
Основной Gantt и график параллельной нагрузки используют одно временное окно. Выделение участка мышью синхронно приближает оба графика, а двойной клик возвращает полное окно операционного дня (24 часа). Это позволяет заметить аномальный пик, приблизить его и изучить конкретные DAG.
Фильтры и сортировка
По слою: позволяет увидеть, во сколько фактически начинает рассчитываться слой, насколько синхронно стартуют процессы и успевает ли слой завершиться к своему SLA.
По статусу: в момент инцидента вместо десятков успешных процессов инженер сразу видит незавершённые и упавшие DAG.
По SLA: показывает DAG, завершившиеся позже регламентного срока. SLA задаётся по слоям с учётом границы бизнес‑дня (операционного окна в конкретном часовом поясе, например, с 06:00 MSK). DAG может завершиться успешно, но слишком поздно — для потребителя это нарушение.
Сортировка: по слоям и старту, по времени старта, по длительности, по названию.
Фокус на цепочке зависимостей
При выборе конкретного DAG интерфейс с использованием графа Data Lineage оставляет не только сам процесс, но и всю его upstream‑цепочку. Это полезно при расследовании задержки витрины: вместо просмотра всех процессов пользователь видит выбранную витрину, её прямые и косвенные зависимости, фактические интервалы их выполнения и время ожидания между этапами. Lineage отвечает на вопрос «кто от кого зависит», а Gantt добавляет временное измерение — «когда именно выполнялся каждый элемент цепочки».
Контроль SLA и фазы выполнения
На странице показываются регламентные сроки готовности каждого слоя. На общей шкале хорошо заметны волны запуска, слишком длинные расчёты, процессы, не успевающие к сроку, и разрывы между upstream и downstream.
Если платформа использует сенсоры в качестве механизма связности потоков данных, полное время жизни DAG можно разделить на две фазы: голубая часть — ожидание сенсоров; фиолетовая — непосредственный расчёт. Если сенсоров нет, вся полоса отображается как расчётная. При наведении на фазу появляется tooltip.
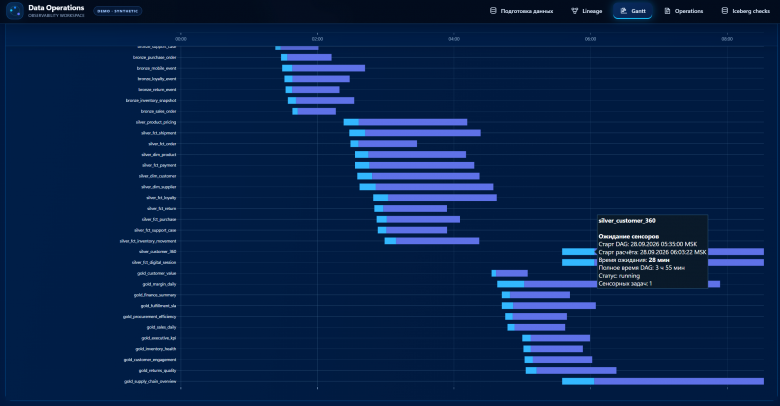
На приведённом примере для silver_customer_360 tooltip показывает: Ожидание сенсоров. Старт DAG: 28.09.2026 05:35:00 MSK. Старт расчёта: 28.09.2026 06:03:22 MSK. Время ожидания: 28 мин. Полное время DAG: 3 ч 55 мин. Статус: running. Сенсорных задач: 1. (Время ожидания сенсоров — это интервал от старта DAG до старта первой расчётной задачи).
Главное преимущество кастомизации этой страницы — возможность заложить в инструмент внутреннюю модель платформы. Дашборд понимает слои хранилища, регламентные сроки, сенсорные и расчётные задачи, связи между DAG и правила определения SLA. Кастомный интерфейс можно развивать: добавлять фильтры по владельцам, отображать Spark‑ресурсы, количество повторных попыток и ссылки на логи.
3. Оперативный мониторинг инцидентов (Operational Health)
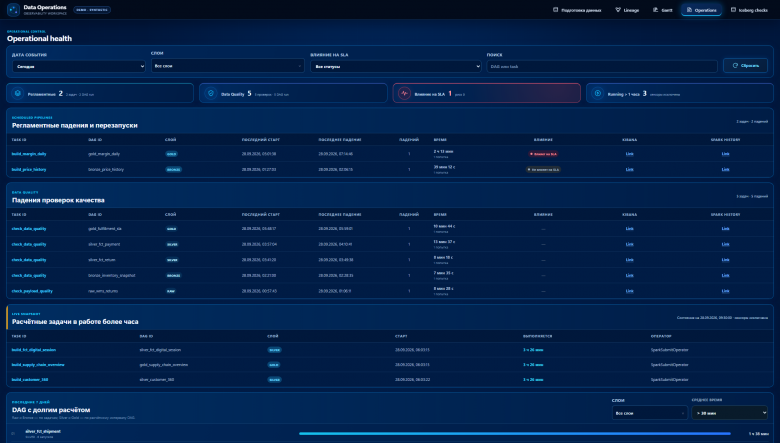
Страница Operational Health объединяет оперативный контроль состояния платформы: данные о падениях, повторных запусках, зависших задачах, рисках нарушения SLA и аномально долгих расчётах. Главная задача — быстро ответить: что сейчас сломано, какие процессы не восстановились, что может повлиять на SLA и где расчёты идут дольше обычного.
Сводные показатели и фильтрация
В верхней части расположены четыре метрики:
Регламентные падения — количество падений в регламентных пайплайнах, число затронутых задач и DAG Run.
Data Quality — количество падений проверок качества данных.
Влияние на SLA — число инцидентов, влияющих на SLA, и процессов в зоне риска.
Running > 1 часа — количество задач, выполняющихся более часа.
Метрики пересчитываются с учётом фильтров (дата события за последние семь дней, слой данных Raw/Bronze/Silver/Gold, степень влияния на SLA, поиск по имени DAG/task).
Регламентные падения и перезапуски
Основная таблица показывает проблемы в регламентных пайплайнах. Для каждого инцидента выводятся: Task ID, DAG ID, слой, время старта и падения, количество неуспешных попыток, средняя длительность неуспешного запуска (интервал от старта до падения), оценка влияния на SLA и ссылки на Kibana и Spark History Server.
Task ID является ссылкой на запуск в Airflow. Если с расчётом связано Spark‑приложение, дежурный получает прямые ссылки в Kibana и в Spark History Server. Страница сокращает путь до инструментов диагностики.
Оценка влияния на SLA
Каждому инциденту присваивается статус:
Влияет на SLA — критичные ситуации (длительность неуспешного запуска превышает два часа; задача failed/upstream_failed и имеет downstream‑зависимости).
Риск SLA — процесс восстановился, но время восстановления оказалось значительным.
Не влияет на SLA — быстро восстановившиеся задачи без downstream‑потребителей.
Перезапуск идёт — задача находится в активном состоянии (выполняется, ожидает запуска или повторной попытки).
Падения проверок качества
Проверки качества вынесены в отдельную секцию Data Quality, чтобы не смешивать технические падения с ошибками качества данных. Для каждой проверки отображаются DAG, задача, слой, время запуска и падения, количество падений, средняя длительность неуспешного запуска и ссылки. Блок особенно полезен во время миграции: технически успешная загрузка не гарантирует корректность данных.
Расчётные задачи в работе более часа
Блок представляет снимок долго выполняющихся задач.
DAG с долгим расчётом
Блок для поиска систематически медленных процессов. Анализируется среднее время успешных расчётов за последние семь дней. Доступны: выбор слоёв, пороги продолжительности (более 15, 30, 45 минут или часа), ранжирование по средней длительности, отображение числа запусков для расчёта среднего, визуальная полоса для сравнения и переход в DAG Airflow.
Operational Health обеспечивает единый сценарий: обнаружение инцидента → оценка влияния → определение затронутого слоя и DAG → переход к логам или Spark History → диагностика. Дежурному больше не нужно вручную просматривать десятки DAG и искать application ID.
4. Наблюдение за состоянием таблиц Iceberg
Страница проверки таблиц Iceberg (Iceberg tables checks) контролирует физическое состояние таблиц Data Lakehouse. Она соединяет lineage, метаданные Iceberg и анализ структуры хранения. Страница ориентирована на ответы на вопросы: из каких таблиц собирается витрина, правильно ли они партиционированы, сколько в них data‑ и delete‑файлов, нет ли проблемы мелких файлов, равномерно ли распределены данные и не пора ли менять стратегию партиционирования.
Пользователь вводит название целевого DAG, и система по lineage находит непосредственные upstream‑DAG и таблицы. Далее можно отфильтровать таблицы по размеру (от 10 ГБ, от 100 ГБ, все) и загрузить метаданные. Система собирает физические характеристики из Iceberg и Trino, отображая прогресс загрузки (кнопка «Загрузить» меняется на «Обновить»).
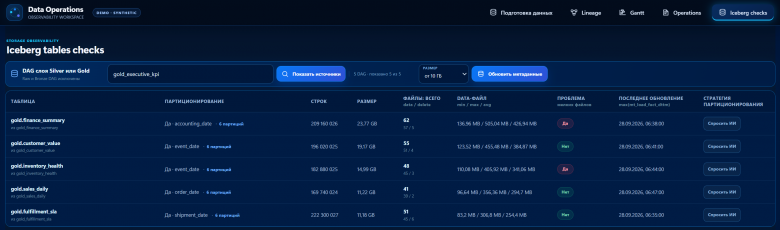
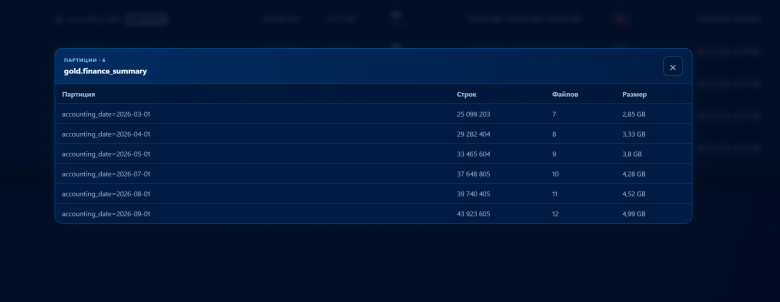
Количество партиций кликабельно: при нажатии открывается модальное окно с детализацией по партициям (значение ключа, количество строк, файлов, общий размер). Просмотр статистики по партициям позволяет отличить разовую аномалию от устойчивого накопления мелких файлов. Это помогает увидеть неравномерное распределение, перекосы по объёму и партиции, которые растут быстрее остальных.
Iceberg tables checks дополняет мониторинг пайплайнов контролем физического слоя. DAG может успешно завершаться каждый день, но таблица будет накапливать тысячи мелких файлов, delete‑файлы или неравномерные партиции. Сценарий работы: выбор витрины → определение источников по lineage → загрузка метаданных → анализ файлов и партиций → просмотр проблемных партиций → рекомендации по оптимизации. Это позволяет обнаруживать проблемы хранения до того, как они начнут влиять на производительность Spark и Trino.
Следующий уровень диагностики — разбор уже не расписания или статуса DAG, а поведения самого Spark‑приложения.
5. Spark Monitor
Spark Monitor — это инструмент диагностики и оптимизации Spark‑приложений по Event Log. Он превращает технические журналы Spark в понятную матрицу проблем: показывает, где кластер простаивает, какие операции создают узкие места и на что команда тратит вычислительные ресурсы.
Этот дашборд — система автоматизированного post‑run анализа, поиска причин деградации и оптимизации стоимости Spark‑нагрузок. При одинаковом Event Log, версии анализатора и наборе правил система сформирует тот же диагностический результат. Это позволяет воспроизводить разбор инцидента и сравнивать запуски между собой.
На главной странице одна строка соответствует одному Spark‑приложению. В колонках собраны семь областей диагностики:
использование вычислительных ресурсов;
память, GC и spill;
data skew и медленные tasks;
shuffle;
чтение данных и partition pruning;
join;
тяжёлые SQL‑операторы.
Цвет помогает расставить приоритеты: CRITICAL (подтверждённая проблема), WARNING (отклонение или потенциальная оптимизация), OK (нарушений нет).
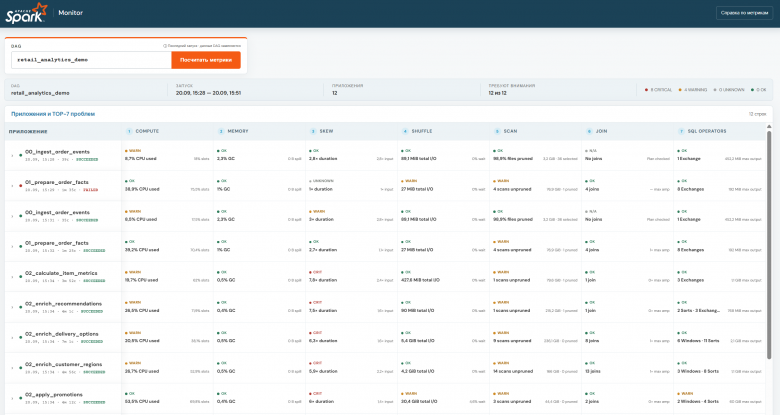
Ниже представлена диагностика и соответствующие метрики первого в списке демо‑приложения 00_ingest_order_events. Блоки с метриками раскрываются и сворачиваются по клику.
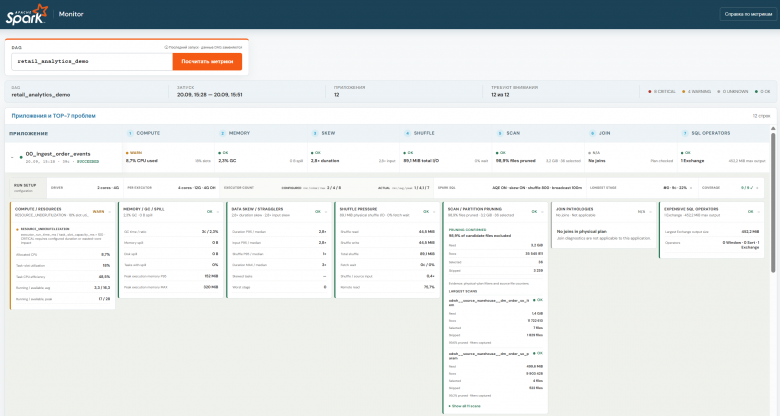
Разберём первую часть «Compute/Resources» — как Spark Monitor понимает, что кластер используется неэффективно. Большой кластер не гарантирует быстрое выполнение: Spark может получить много executors, но значительная часть cores будет простаивать. Поэтому ресурсы оцениваются с нескольких сторон:
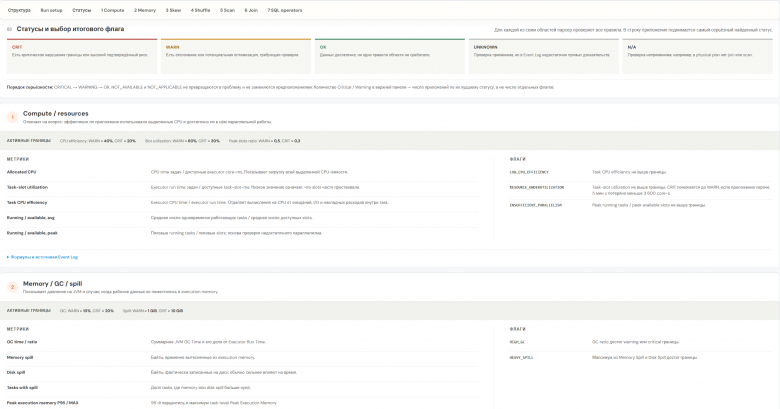
Allocated CPU utilization — отношение фактического CPU Time к доступной вычислительной мощности executors за период их жизни (с учетом изменения числа executors во времени): Executor CPU Time /интегральная доступная CPU‑мощность executors × 100%.
Task‑slot utilization — доля времени, в течение которого доступные слоты были заняты задачами: Executor Run Time задач / доступные task‑slot milliseconds. Низкое значение означает, что ресурсы выделены, но задачи не выполнялись.
Task CPU efficiency — отношение CPU Time ко времени выполнения задач: Executor CPU Time / Executor Run Time. Если показатель низкий, task проводит время в ожидании I/O, shuffle или сериализации.
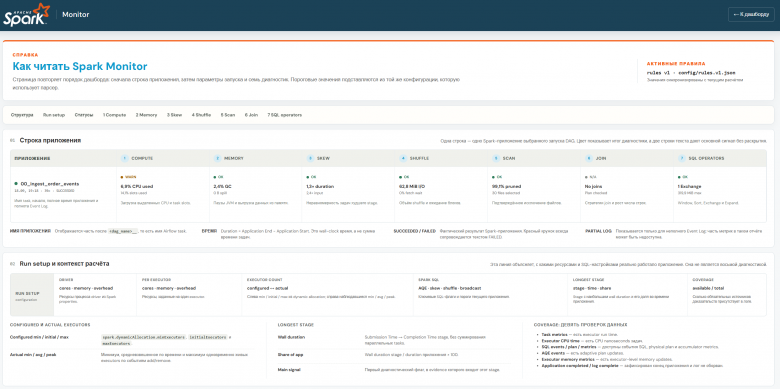
Правила считают Task CPU efficiency подозрительной при значении ≤ 40% и критической при ≤ 20%. Для Task‑slot utilization границы — 60% и 30%. Отдельно проверяется параллелизм (Peak running tasks / Peak available slots): если в пиковый момент использовалось ≤ 50% доступных slots — предупреждение, если ≤ 25% — критический сигнал (на скриншоте справки отображается 0,25).
На демо‑данных приложение 00_ingest_order_events использовало только 8,7% CPU и около 18% task slots при пиковом количестве executors — семь. Это повод проверить, нужен ли приложению такой объём ресурсов.
В правом верхнем углу дашборда находится ссылка на встроенную страницу «Справка по метрикам». Для каждого направления диагностики там приведены назначение метрик, формулы расчёта, пороговые значения и причины появления предупреждений. Инженеру не приходится отдельно искать эту информацию в документации Spark.
Итак, что получает команда от Spark Monitor. Если приложение медленное, дашборд показывает, связано ли это с простаивающими ресурсами, перекосом задач, ожиданием shuffle, чтением лишних файлов, раздуванием данных после join или тяжёлым оператором SQL‑плана. Инженер данных получает конкретное направление оптимизации. Платформенная команда видит приложения с завышенными ресурсами. При разборе инцидента остаётся воспроизводимый отчёт с метриками.
Spark Monitor не заменяет Spark UI. Он помогает понять, куда смотреть в Spark UI и какое приложение нужно исследовать первым.
Заключение
Ценность дашборда в том, что он связывает разрозненные источники в один понятный сценарий — увидеть проблему, оценить её влияние на зависимости и SLA, найти узкое место и сразу перейти к детальной диагностике.
Даже небольшой кастомный инструмент заметно упрощает эксплуатацию, если построен вокруг реальных вопросов команды. Lineage даёт контекст зависимостей, Gantt показывает время и нагрузку, Operational Health помогает расставить приоритеты, Iceberg Checks контролирует физическое состояние данных, а Spark Monitor объясняет причины неэффективных вычислений. Вместе они позволяют перейти от ручного поиска по нескольким системам к осознанному управлению платформой.