

После крупного инцидента SaaS-компании приходится отвечать на неудобный вопрос: кто заметил проблему первым — мониторинг или клиенты? У команды Atlassian долгое время не было однозначного ответа. Команда VK Tech перевела статью о том, как небольшая команда перестроила платформу обнаружения инцидентов на Apache Kafka, Apache Flink в Kubernetes и OpenTelemetry. На этой платформе работает AutoHOT — система автоматического создания инцидентов высокой серьёзности. Авторы рассказывают об архитектурных решениях, показателях, которые отслеживали ежемесячно на протяжении восемнадцати месяцев, и о том, что сделали бы иначе.
Результаты оказались неоднозначными. Доля обнаруженных реальных инцидентов среди тех, которые охватывает мониторинг, выросла примерно с 60% до 86% на пике, но в неудачный месяц снова упала до 64%. Точность — доля срабатываний, оказавшихся настоящими инцидентами, — по-прежнему ниже, чем хотелось бы авторам. Они приводят цифры и разбирают ограничения системы, включая пропущенные инциденты и ложные срабатывания.
Статья адресована тем, кто строит потоковый мониторинг на Kafka и Flink и хочет учесть ошибки авторов при проектировании собственной системы.
Сценарий использования
Мы эксплуатируем больше десяти облачных продуктов для миллионов тенантов. Каждый продукт отправляет клиентскую операционную телеметрию о действиях пользователя: одно событие при запуске задачи и ещё одно при её завершении — успешном, с ошибкой или после прерывания. События снабжены тегами тенанта, пользователя, именованного пользовательского действия (experience), например просмотра задачи, редактирования страницы или просмотра доски, и HTTP-статуса. По всем продуктам это миллиарды событий в день. Эти данные точнее других источников показывают, могут ли клиенты выполнять свою работу.
Центральная система мониторинга должна быстро обработать этот поток и ответить на три вопроса:
Есть ли проблема? Указывают ли доля ошибок или падение объёма событий на ситуацию, которую человек счёл бы инцидентом?
Каков масштаб? Сколько уникальных пользователей и тенантов затронуто и где: в отдельном тенанте, на шарде базы данных, в регионе или по всему сервису?
Кого нужно вызвать, какой уровень серьёзности назначить инциденту и какие данные передать дежурным?
В первой версии системы эту работу выполнял агрегатор на Node.js, запущенный примерно на 90 виртуальных машинах. Он получал данные из шины событий через облачную очередь, удалял дубликаты и сопоставлял события одной задачи с помощью кэша в памяти. Система работала и помогла нам разобраться в предметной области, но у неё было три проблемы, которые нельзя было устранить настройками:
Задержка. Даже в удачный день от события до появления метрики проходило больше 40 секунд. Затем детекторам требовалось накопить данные ещё за несколько минут в окне анализа.
Шумные соседи. Очередь была общей инфраструктурой. За год два инцидента произошли из-за отставания в обработке данных другого тенанта в той же очереди. Такая зависимость снижала надёжность самой системы обнаружения инцидентов.
Рост стоимости при каждом подключении. По мере подключения продуктов и пользовательских действий расходы на эксплуатацию выросли примерно со 120 тыс. до 230 тыс. $ в год. Кроме того, при рутинном изменении загрузка CPU слоя кэширования достигла 100%.
Была и проблема корректности обнаружения, которая проявилась только после появления более качественных данных. Клиентская телеметрия поступает лишь тогда, когда страница загружается. Если шард базы данных полностью недоступен, события перестают поступать, включая сообщения об ошибках. Система, которая ищет только признаки сбоев, принимает отсутствие данных за нормальную работу.
Цели проектирования
Ещё до выбора технологий мы записали пять целей. Приводим их, потому что они объясняют большинство компромиссов, о которых пойдёт речь ниже.
Цель |
Конкретный ориентир |
Задержка |
От события до метрики менее 10 секунд; решение детектора на границе следующей минуты |
Изоляция |
Выделенный путь консьюмера; никакой общей очереди на критическом пути |
Корректность при повторном чтении |
Идемпотентные записи, чтобы перезапуск или повторное чтение никогда не приводили к двойному подсчёту влияния |
Стоимость |
Стоимость эксплуатации растёт вместе с объёмом событий, а не с числом подключённых experience |
Удобство эксплуатации |
Один источник конфигурации для фильтров, преобразований, порогов и синков; подключение experience должно быть пулреквестом, а не развёртыванием |
Архитектура
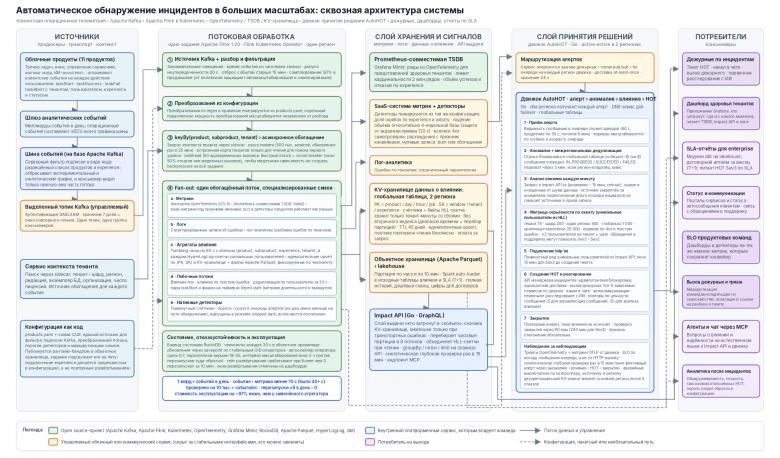
Сквозная архитектура: продюсеры и транспорт на входе, задание Apache Flink, слой хранения и сигналов, движок принятия решений AutoHOT и консьюмеры на выходе. Вся система от источников до потребителей. Зелёным отмечены open source-проекты; янтарным управляемые или коммерческие сервисы, скрытые за стабильными интерфейсами; синим сервисы, которыми владеет наша команда; фиолетовым консьюмеры.
Слева направо на схеме показаны следующие компоненты.
Источники. Продукты отправляют операционные события через аналитический шлюз в корпоративную шину событий на Apache Kafka. Чтобы не читать весь поток, мы регистрируем серверный фильтр подписки, описанный в коде. Он содержит список разрешённых продуктов и пользовательских действий (experience), а экспериментальный и синтетический трафик отсекает ещё на шине. Отобранные события попадают в выделенный топик Kafka со сроком хранения семь дней, откуда их можно повторно прочитать. У конвейера есть два дополнительных источника данных: сервис контекста тенанта, который связывает тенанта с шардом, регионом, редакцией продукта и числом лицензий, и репозиторий конфигурации.
Потоковая обработка. Всю обработку выполняет одно задание Apache Flink 1.20, развёрнутое через Flink Kubernetes Operator. Подробнее о нём расскажем в следующем разделе.
Слой хранения и сигналов. Метрики поступают через OpenTelemetry в совместимую с Prometheus базу временных рядов и в коммерческий сервис метрик, где сейчас работают наши детекторы. Поминутные агрегаты данных о влиянии записываются в мультирегиональное key-value-хранилище и файлы Apache Parquet в объектном хранилище. На основе этих файлов lakehouse формирует таблицы для отчётности по договорным SLA — соглашениям об уровне обслуживания. Небольшой GraphQL-сервис Impact API, написанный на Go, использует данные из этих хранилищ, чтобы определить, кого затронул инцидент и сколько пользователей и тенантов пострадало.
Слой принятия решений. Движок AutoHOT написан на Go и работает в режиме active-active в двух регионах. Он преобразует алерты детекторов в аномалии и каждую минуту оценивает масштаб влияния через Impact API. Движок определяет серьёзность по матрице, учитывающей охват инцидента, отфильтровывает кратковременные отклонения, которые проходят сами и не требуют создания инцидента (blip), создаёт тикет и вызывает дежурных из нужных команд. Оценка влияния продолжается, пока оно не исчезнет.
Потребители. Данные используют специалисты по реагированию, дашборд состояния тенантов, отчётность по корпоративным SLA, инструменты публикации статусов и коммуникаций, а также дашборды SLO — целевых уровней обслуживания — продуктовых команд. Аналитика по итогам инцидентов помогает корректировать пороги в конфигурации.
Что мы построили
1. Пусть фильтрацией занимается шина
Сначала мы решили перестать читать весь поток напрямую. На операционные события приходится около 55% всего трафика шины. Наш фильтр подписки описан в YAML-файле примерно на 770 строк. Файл генерируется из той же продуктовой конфигурации, которая управляет всем остальным, поэтому конвейер видит только те продукты и experience, за которые отвечает. Уже это избавило нас от целого класса задач по масштабированию и сократило объём топика настолько, что хранение событий за семь дней обходится дёшево.
2. Одно задание Flink — осознанный выбор
Мы запускаем одно задание, а не отдельное для каждого продукта. Граф выглядит так:
kafka-source

  -> filter-and-parse            (отбросить события старше 15 мин, ответы 401, события без пользователя)

  -> apply-transformations       (преобразования по regex и правилам из конфигурации)

  -> keyBy(product, subproduct, tenant)

  -> event-enricher              (асинхронно: sidecar контекста тенанта, кэш, bulkhead + circuit breaker)

  -> fan-out:

       metrics       -> экспортёр OpenTelemetry (OTLP) -> Prometheus-совместимая TSDB

                     -> StatsD (прежние имена метрик сохранены)

       logs          -> лог-аналитика

       user-dedup    -> keyed-состояние с TTL 30 с -> счётчики уникальных пользователей

       aggregate     -> tumbling-окна по 60 с с ключом (product, subproduct, experience, tenant)

                        с HyperLogLog-скетчами

                     -> key-value-хранилище (идемпотентный PutItem по (PK, SK))

                     -> Parquet FileSink (фиксация по чекпоинту)

       side streams  -> влияние 4xx, влияние по текстам ошибок, пары taskStart<->финальное событие (таймеры)

       detectors     -> поминутные счётчики -> пороги -> очередь алертов (развёрнуто, но не активировано)
Несколько решений, которые сыграли роль:
Асинхронное обогащение с bulkhead и circuit breaker. На критическом пути есть только один внешний вызов — запрос контекста тенанта. Он проходит через sidecar с кэшем в памяти на 500 тыс. записей, встроенной картой тенантов только для чтения, к которой обращаются в первую очередь, семафорным bulkhead, который сразу отклоняет новые вызовы при 50 одновременных запросах, и circuit breaker, который размыкается, если доля отказов или медленных вызовов достигает 50%. Раньше медленная зависимость создавала backpressure для всего задания. С тех пор у нас не было ни одной остановки из-за обогащения.
HyperLogLog вместо идентификаторов пользователей. Данные для метрики «уникальные затронутые пользователи» нужно объединять по минутам, тенантам, шардам и регионам. Если суммировать счётчики из отдельных строк, пользователи учитываются повторно. Каждое 60-секундное окно содержит HLL-скетч, а Impact API объединяет скетчи при чтении в соответствии с группировкой, заданной в запросе. Цена решения — зависимость продюсера на Java и консьюмера на Go от общего формата: один хотфикс пришлось выпустить, когда у них разошёлся параметр точности скетча. Ещё одна плата — погрешность около 1,5%, которую никто не заметил.
Идемпотентные синки, at-least-once для метрик. Ключ в key-value-хранилище состоит из (продукт, день, час, задание) и (окно, тенант, подпродукт, experience), поэтому при повторном чтении топика строки просто перезаписываются теми же значениями. Parquet-файлы ротируются по чекпоинтам, так что для них действует exactly-once. Метрики отправляются в режиме fire-and-forget: после перезапуска на две-три минуты возникает провал, а затем всплеск из-за повторного чтения. Нас это устраивает, потому что детекторы читают предварительно агрегированные данные из хранилища, а не сырые счётчики.
Сохраните старые имена метрик. Через StatsD метрики отправляются под прежними именами. Дашборды SLO и детекторы продуктовых команд не пришлось менять в день переключения на новую систему, и только благодаря этому переключение прошло без происшествий.
RocksDB, чекпоинты каждые 30 секунд, обновления через savepoint. Состояние хранится в RocksDB, каждые 30 секунд чекпоинты отправляются в объектное хранилище, а при обновлении состояние восстанавливается из savepoint по стабильным UID операторов. Мы на этом обожглись: если менять топологию, удаляя задание и развёртывая его заново, состояние теряется без предупреждения. Теперь мы относимся к UID операторов как к API.
Настройка автоскейлера повышает надёжность. Поначалу каждое изменение параллелизма требовало полного перезапуска задания, и таких перезапусков было около восьми в день. Мы задали автоскейлеру Flink Kubernetes Operator целевую загрузку (target utilization) 0,7 с допустимым отклонением 0,3, параллелизм вершин от 18 до 25 и трёхчасовой интервал масштабирования вниз. Число перезапусков упало до нуля. Теперь конвейер развёртывания в продакшен завершается ошибкой, если задание перезапускается больше трёх раз за десять минут.
Конфигурация как управляющий слой. Из одного файла products.yaml со схемой CUE генерируются фильтр подписки Kafka, преобразования, пороги детекторов и маршрутизация синков. С середины 2026 года задание на лету подгружает пакет этой конфигурации из объектного хранилища, поэтому для подключения experience больше не нужно повторное развёртывание.
Проектирование операторов: когда объединять, а когда разделять
Один из самых неочевидных уроков работы с этим заданием: выбор гранулярности операторов — не разовое архитектурное решение. К нему приходится возвращаться по мере развития задания и работы под реальной нагрузкой. Мы усвоили этот урок и при объединении, и при разделении операторов.
Объединяйте, когда работа дублируется. Поначалу в конвейере за фильтром шёл map: фильтр разбирал JSON, чтобы решить, обрабатывать ли сообщение, а map разбирал его снова, чтобы десериализовать в типизированный Payload. Мы объединили их в один flatMap: разбираем сообщение один раз и отправляем дальше, только если оно валидно. Повторная десериализация исчезла полностью. Тот же принцип подсказал нам использовать side outputs Flink для отправки данных в лог-аналитику, StatsD и OpenTelemetry вместо отдельных операторов: один проход по графу, три точки назначения.
Разделяйте, когда операторам нужно масштабироваться по-разному. Обратный урок мы усвоили позже, уже под продакшен-нагрузкой. Разбор JSON и преобразования выполнялись в одном операторе, но этап обогащения — асинхронные запросы метаданных тенанта — упирался в 100% загрузки CPU и становился узким местом всего конвейера. Мы явно отделили первую фазу, разбор и фильтрацию, ограниченную вводом-выводом, от второй, применения преобразований, ограниченной CPU, чтобы задавать параллелизм каждой фазы независимо. То, что на доске выглядит одним логическим шагом, может превратиться во Flink в два отдельных оператора, когда под реальным трафиком у них появляются разные профили потребления ресурсов.
Мы пришли к такому правилу: объединяйте операторы, если они обрабатывают одни и те же данные за один проход, и разделяйте, если им нужно масштабироваться независимо. Вызовы uid() для каждого оператора Flink закрепляют эту дисциплину: как только оператор получил имя и его состояние попало в чекпоинт, вы привязаны к его границам. Это заставляет хорошо подумать, прежде чем их определять.
3. Движок принятия решений
Детекторы срабатывают по метрикам. Алерт проходит через сервис вызова дежурных, топик pub/sub и очереди — по одной на каждый регион движка. Каждый алерт получают оба региона, а корректность обработки обеспечивает строка-блокировка в мультирегиональной таблице. Ключом служит бизнес-идентификатор дедупликации, а не идентификатор сообщения в очереди. Если регион-владелец зависает, через пять минут другой регион перехватывает блокировку. API менеджера инцидентов добавляет вторую блокировку, за которой остаётся окончательное решение: это последняя линия защиты от задержек репликации.
Каждую минуту движок запрашивает у Impact API данные за окно, которое начинается за пятнадцать минут до аномалии и заканчивается текущим моментом, — как сырые, так и очищенные от шума. Затем он применяет матрицу серьёзности по охвату: например, около 75 уникальных пользователей в одном тенанте, около 200 на одном шарде, около 500 в одном регионе, около 1 000 глобально или около 20 000 в критичном experience. Тенанты, в которых затронуто не больше двух пользователей, считаются шумом. Перед созданием тикета невысокой серьёзности проверка на кратковременные отклонения (blip) пятнадцать минут отслеживает поминутный ряд уникальных пользователей. Одно только обнаружение таких отклонений избавило дежурных примерно от 300 ложных вызовов в FY26. Когда тикет создан, движок вызывает дежурных пяти основных зависимых сервисов с учётом их критичности, открывает канал в чате и запускает автоматические коммуникации. Он сообщает, каких тенантов нужно уведомить о возможном влиянии, и запускает первичное расследование с помощью ИИ. Пока влияние не исчезнет, движок непрерывно переоценивает его и проверяет, нужно ли повысить серьёзность. Кроме того, он замечает резкие падения объёма телеметрии и выявляет инциденты, при которых она перестаёт поступать, учитывая ожидаемые спады в праздники и выходные.
Два проектных решения себя оправдали. Число повторных попыток зависит от ценности сообщения: для управляющих сообщений предусмотрено пять попыток, для сообщений анализа влияния — двадцать, причём последние никогда не отбрасываются по числу получений из очереди. Потерять данные о влиянии хуже, чем выполнить работу дважды. Источник данных закрепляется за каждой аномалией, поэтому переключение feature flag в разгар инцидента не приводит к смешению двух источников в одной записи об инциденте.
4. Мониторинг самой платформы обнаружения с помощью OpenTelemetry
Платформа обнаружения, которая отказывает незаметно, хуже, чем её отсутствие: люди перестают смотреть на дашборды. Не обманывать себя нам помогают три вещи:
OpenTelemetry от начала до конца. Задание Flink экспортирует метрики по OTLP (OpenTelemetry Protocol) в Prometheus-совместимую базу временных рядов (TSDB) Grafana Mimir, а движок отправляет трейсы OpenTelemetry и метрики по OTLP. Это даёт нам единое, не зависящее от вендора представление о работе потокового задания на Java и управляющего слоя на Go. На этот же путь мы планируем перевести детекторы, когда откажемся от промежуточной коммерческой системы метрик. Единственным ограничением стала кардинальность рядов: мы ограничиваем пространство имён tenant-health двумя миллионами рядов и заранее агрегируем данные по паре «тенант, минута», вместо того чтобы отправлять отдельные ряды для каждого пользователя.
Синтетическая сквозная проверка каждые 15 минут создаёт тестовый алерт и проводит его через все этапы: регистрацию аномалии, анализ влияния, создание и закрытие тикета. Если сломается любое звено, мы узнаем об этом в течение четверти часа, а не при следующем реальном инциденте.
Детекторы самомониторинга платформы отслеживают расхождения между новым и прежним конвейерами во время миграции, отсутствие записей в хранилище данных о влиянии, скорость расходования бюджета ошибок (burn rate) при обогащении и SLO, в котором результат обработки каждого сообщения движком оценивается как хороший или плохой. SLO движка рассчитывается по результату обработки сообщения из очереди, а не по HTTP-вызову: ответ API с кодом 200 ничего не говорит о том, создан ли тикет.
Результаты
Платформа
Метрика |
До |
После |
Задержка от события до метрики |
более 40 с |
менее 10 с |
Устойчивая пропускная способность |
примерно 500 млн событий в день |
более 1 млрд событий в день при сэмплировании 50%; проверено на нагрузке свыше 10 тыс. событий в секунду |
Перезапуски задания |
около 8 в день |
0 в установившемся режиме |
Вычислительные ресурсы |
около 90 ВМ, а также слои очередей и кэша |
4 пода Kubernetes |
Стоимость эксплуатации в месяц |
около 20 000 $ |
около 650 $ (примерно на 97% ниже) |
Восстановление после зависания |
вручную |
около 20 минут за счёт повторного чтения из Kafka, без потери данных |
Задержка запроса данных о влиянии для дашборда |
около 10 с |
около 1 с |
Совпадение данных с прежней системой во время теневого прогона |
не поддавалось измерению |
99,9% за две недели |
Отдельный счёт за дашборд влияния сократился с более чем 20 000 $ до примерно 1 000 $ в месяц, когда дашборд перестал сканировать логи и начал читать заранее агрегированное хранилище.
Итоги обнаружения, месяц за месяцем
Каждый месяц мы разбираем все крупные инциденты и для каждого определяем, входит ли он в охват автоматического обнаружения — затронул ли experience, для которого настроен сбор телеметрии. Если входит, проверяем, обнаружила его система или пропустила.
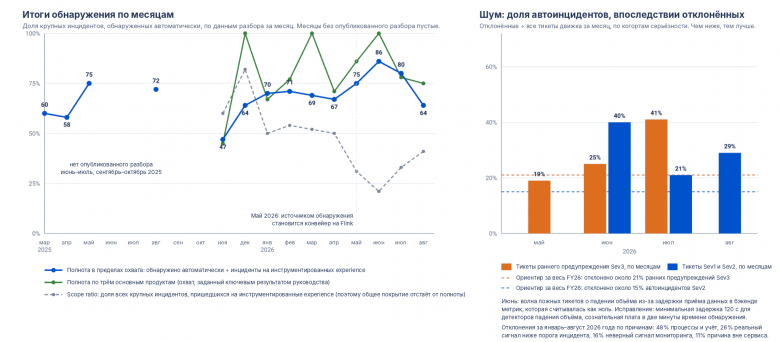
Полнота в пределах охвата, полнота по основным продуктам и scope ratio — доля всех крупных инцидентов, пришедшихся на experience с настроенным сбором телеметрии, — по месяцам с марта 2025 по август 2026 года, а также доля автоматически созданных инцидентов, впоследствии отклонённых, по группам серьёзности в середине 2026 года. Слева: полнота в пределах охвата (синий), полнота по трём основным продуктам (зелёный) и scope ratio (пунктир). Справа: доля автоматически созданных инцидентов, впоследствии отклонённых, по группам серьёзности и месяцам в сравнении с показателями за весь год.
Выделяются три момента.
Полнота в пределах охвата улучшилась, но неравномерно. Она выросла с 60% в марте 2025 года до 86% в июне 2026 года, составила 80% в июле, а в августе опустилась до 64%. По трём основным продуктам она достигала 100% в трёх разных месяцах. Рост связан с конкретными инженерными изменениями: подавлением кратковременных отклонений (blip) и тикетами раннего предупреждения Sev3 в конце 2025 года, переходом на Flink и обнаружением падения объёма телеметрии в мае 2026 года, обнаружением ошибок 4xx для крупнейшего продукта в апреле.
Общее покрытие не выросло, и именно этот показатель важен. За девять месяцев с ноября 2025 по июль 2026 года произошло 263 крупных инцидента. Из них 117 (44,5%) пришлись на experience с настроенным сбором телеметрии; мы обнаружили 80 из этих инцидентов (68,4% в пределах охвата), то есть 30,4% всех крупных инцидентов. Scope ratio упал примерно с 60% до 21–33%, поскольку среди инцидентов появлялись новые продукты и причины, не связанные с надёжностью. Полнота характеризует работу детектора, а покрытие — то, для чего вы решили собирать телеметрию. Мы отчитывались о росте полноты, но воспринимали его как рост покрытия.
Точность нельзя описать одним числом. В пределах охвата основных продуктов она держится около 90%. По всем автоматически созданным тикетам, включая ранние предупреждения невысокой серьёзности, она составляла 79% в феврале 2026 года и 68% в марте. В середине 2026 года доля отклонённых тикетов составляла от 19% до 41% для ранних предупреждений невысокой серьёзности и от 21% до 40% для тикетов Sev1 и Sev2, тогда как за весь год — примерно 21% и 15% соответственно. Среди тикетов, отклонённых с января по август 2026 года, 48% были связаны с процессами и учётом: устаревшие тикеты, дубликаты или тикеты без указанной причины отклонения. В 26% случаев сигнал был реальным, но не достигал порога инцидента, в 16% ошибался мониторинг, а в 11% причина находилась вне сервиса. Июньский всплеск на графике вызвала волна ложных тикетов о падении объёма телеметрии: задержка поступления данных в бэкенд метрик интерпретировалась как нулевой объём. Мы исправили это, введя минимальную задержку в 120 секунд для детекторов падения объёма и сознательно увеличив время обнаружения на две минуты ради точности.
За весь финансовый год около 85% инцидентов Sev2, созданных нами автоматически, оказались реальными. Ранние предупреждения меньшей серьёзности оказывались верными в 70–79% случаев, а подавление blip сократило число отклонённых тикетов о таких отклонениях примерно на 80%. Для инцидентов Sev1 и Sev2 середины 2026 года, по которым есть данные о времени обнаружения, медианное время от начала влияния до обнаружения составляло от одной до восьми минут. В одном инциденте Sev1 автоматический тикет появился на девять минут раньше тикета, созданного человеком; в другом медленно нараставший сбой входа в систему десять дней оставался незамеченным.
Что не сработало
Тишина по-прежнему выглядит как исправная работа. За этот период мы пропустили два особенно серьёзных случая. В первом шард базы данных стал полностью недоступен: страницы не загружались, события не поступали. Во втором остановился наш собственный конвейер, поставляющий события, и детектор остался без данных. Оба случая оказались невидимы для архитектуры, которая ищет только признаки сбоев. Исправления: детекторы падения объёма телеметрии (в мае 2026 года они обнаружили Sev1, а в июне дали ложные срабатывания), проверки свежести телеметрии в самом конвейере и сигналы, не зависящие от клиентской телеметрии, например доля ответов 5xx на edge и синтетические проверки.
Количественная оценка отставала от обнаружения. В одном инциденте Sev1 тикет создали рано, но оценка влияния показывала около двух тысяч пользователей, хотя на деле их было больше восьмидесяти тысяч: хранилище, по которому выполняется подсчёт, содержит только пары «тенант, минута», в которых были сбои. Во время реагирования инцидент считался Sev2, а по итогам разбора получил Sev1. Обнаружение и количественная оценка решают разные задачи и требуют разных данных.
Агрегация при чтении не выдержала параллельной нагрузки. Impact API объединяет минутные скетчи при каждом запросе, без предварительных агрегатов и общего кэша. Во время инцидента его вывела из строя примерно сотня пользователей, одновременно открывших дашборды. Исправление: суточный агрегат, который записывает Flink, и кэш с коротким TTL. Урок: за возможность вычислить любую группировку при чтении приходится платить в самый тяжёлый момент.
Входные данные для обнаружения привязаны к одному региону. Движок работает в режиме active-active, но шлюз событий, подписка на шине и задание Flink находятся в одном регионе. Во время регионального сбоя облака вычисления работали исправно, а система обнаружения осталась без данных. Главная предстоящая работа по повышению надёжности — перевести конвейер в мультирегиональный режим.
Учёт причин отклонения: проблема качества данных. Почти у половины отклонённых тикетов не была указана причина. Теперь мы требуем её указывать и отделяем категории «восстановилось само» и «окно обслуживания» от «ложного срабатывания». Если смешивать эти категории, настройка детекторов по таким данным приводит к неверным корректировкам.
Что мы сказали бы другой команде
Фильтруйте на шине, а не в задании. Благодаря фильтрам подписки, описанным в коде, топик оставался небольшим, задание — простым, а стоимость росла линейно с числом нужных нам событий.
Проектируйте ключи синка до топологии. Именно идемпотентные ключи (partition, sort) превращают повторное чтение из Kafka в инструмент восстановления, устраняя риск двойного подсчёта.
Используйте скетчи вместо идентификаторов. Для подсчёта уникальных значений, которые нужно объединять по разным измерениям, используйте HyperLogLog. Примите зависимость от формата и проверяйте совместимость тестами.
Относитесь к UID операторов и настройкам автоскейлера как к конфигурации продакшена. Большую часть ранних проблем с Flink мы создали себе сами повторными развёртываниями и шквалом изменений параллелизма.
Сообщайте о полноте и покрытии раздельно. Полнота показывает качество детектора, а покрытие отражает то, для чего вы решили собирать телеметрию. Если смешивать эти показатели, реальные пробелы остаются незаметными.
Инструментируйте детектор так же тщательно, как продукт. OpenTelemetry для всех языков, синтетическая сквозная проверка и SLO по результатам обработки позволяют подтвердить работоспособность системы, вместо того чтобы полагаться на впечатление, что дашборды выглядят нормально.
Не принимайте тишину за признак исправности. Клиентская телеметрия отлично сигнализирует о деградации, но бесполезна при полной недоступности. Дополняйте её источником, который подаёт сигнал, когда всё остальное молчит.
Что дальше
Мы переносим обнаружение на хранилище временных рядов, которое получает данные из OpenTelemetry, и включаем ветку детектора, построенную на нативных средствах Flink. Это сократит путь от события до алерта на два звена. Переводим конвейер в режим active-active между регионами, с дедупликацией внутри задания и именем задания в ключе хранилища. Добавляем суточный агрегат и кэш перед Impact API. Для каждого продукта задаём SLO покрытия телеметрией, чтобы scope ratio стал управляемым показателем и его изменения не оказывались неожиданностью. Цель — полнота выше 90% и точность выше 90% в пределах охвата телеметрией при 90-м перцентиле времени обнаружения инцидентов Sev3 менее 90 минут. Когда достигнем этой цели, опубликуем такие же ежемесячные показатели, в том числе за месяцы, когда результаты ухудшатся.
stackshortlist
Сильный результат по времени обнаружения. Интересно, как вы решали вопрос с поздно приходящими событиями во Flink: какой водяной знак выбрали и не появилось ли из за него ложных срабатываний при всплесках задержки в Kafka? На практике именно этот баланс между скоростью и точностью обычно съедает выигрыш.