

Высокая доступность приложений помогает выполнять договорные обязательства и соответствовать ожиданиям пользователей. Для этого многие платформенные команды развёртывают кластеры Kubernetes в локальных и облачных окружениях, распределяя их между зонами доступности, регионами и даже провайдерами. Сбой возможен на любом уровне этой инфраструктуры, поэтому нужно заранее проверить, как сервисная сетка поведёт себя при масштабной аварии. Команда VK Tech перевела статью о том, как протестировать аварийное восстановление мультикластерной конфигурации Linkerd и подготовить сервисную сетку к таким сбоям.
Статья адресована организациям, которые уже используют или планируют использовать сервисную сетку в мультикластерной конфигурации. Если вы только знакомитесь с этим подходом, начните с руководства по поддержке мультикластерности в Linkerd, изучите преимущества и недостатки мультикластерного Kubernetes и разберитесь в трёх типах мультикластерных архитектур, которые поддерживает Linkerd. Другие полезные материалы перечислены в конце статьи.
Авторы моделируют реалистичную мультикластерную конфигурацию с открытой версией Linkerd и Buoyant Enterprise for Linkerd (BEL) и разбирают сценарии аварийного восстановления сервисной сетки. Они показывают, от чего зависит восстановление, как воспроизвести сбои в своих кластерах и какие действия помогут устранить выявленные проблемы. Даже если вы не будете запускать демонстрационную конфигурацию самостоятельно, метрики и результаты экспериментов помогут повысить устойчивость сетки и разобраться в роли Buoyant High Availability Zonal Load Balancing (HAZL) — механизма балансировки нагрузки с учётом зон доступности.
Обо всём по порядку: начнём с основ
Аварийное восстановление (DR) охватывает разные задачи. Здесь мы сосредоточимся на устойчивости сервисов, которые зависят от сервисной сетки: передают трафик через прокси и используют mTLS — взаимную аутентификацию клиента и сервера по TLS‑сертификатам. Разберём, как сервисная сетка может снизить доступность во время сбоя и что с этим делать.
Зонами доступности, в зависимости от провайдера, называют изолированные домены отказа (failure domains) внутри региона. Домен отказа — часть инфраструктуры, которую одна неисправность может вывести из строя целиком, не затронув остальные части. Каждая зона включает один или несколько независимых дата‑центров, поэтому пожар в одной зоне не должен выводить из строя другие.
Регионы — географически разнесённые территории, обычно удалённые друг от друга на сотни километров и более. Каждый регион включает несколько зон доступности.
Во введении в мультикластерное взаимодействие Linkerd перечислено несколько причин использовать мультикластерную конфигурацию сервисной сетки. В этой статье мы рассмотрим разделение доменов отказа: если один кластер выходит из строя, остальные продолжают работать.
Кластеры связывают через общую сеть или шлюзы. Если трафик проходит через несколько облачных зон, расходы на передачу данных между ними могут оказаться неожиданно высокими. Ранее авторы разбирали проблемы topology‑aware routing в Kubernetes (TAR) — маршрутизации с учётом топологии, которая по возможности направляет трафик к эндпойнтам в той же зоне, где находится клиент. Они рассматривали стоимость межзонального трафика и то, как такой подход может снижать доступность. В следующей статье авторы представили Buoyant High Availability Zonal Load Balancing (HAZL), который решает обе проблемы: сохраняет доступность и удерживает расходы на межзональный трафик на низком уровне.
Доступность цепочки сервисов или компонентов A‑B–C зависит от связей между ними. Поскольку такие компоненты часто зависят друг от друга, топология приложения и инфраструктуры влияет на общую доступность в той же мере, что и время безотказной работы каждого сервиса. Поэтому нужно учитывать все зависимости сервисов, включая сервисную сетку.
Четыре сценария отказа
Рассмотрим четыре сценария отказа в мультикластерной конфигурации, где три кластера Kubernetes объединены общей сервисной сеткой Linkerd:
Отказ управляющего слоя сервисной сетки.
Отказ кластера.
Отказ зоны доступности.
Отказ региона.
Для каждого сценария разберём, как реагирует сервисная сетка, какие сбои возникают в её работе и какие меры помогут их предотвратить.
Ключевые выводы
Сервисная сетка редко отказывает так, что внезапно перестаёт пропускать трафик. Она отказывает, теряя способность адаптироваться, масштабироваться и оставаться управляемой.
Сервисная сетка добавляет новые точки отказа, которые нужно включить в учения по DR
Вам нужен новый набор алертов и плейбуков под топологию вашей сервисной сетки
Схема эксперимента
В экспериментах используются три кластера: WEST, CENTRAL и EAST. Они запущены в Docker с помощью k3d и подключены к общей сети Docker. Трафик генерирует k6 — инструмент нагрузочного тестирования с открытым исходным кодом от Grafana Labs, сценарии для которого пишут на JavaScript. Для моделирования сбоев мы останавливаем поды и контейнеры Docker, которые служат узлами кластера, нарушаем работу сети Docker или добавляем задержку с помощью Chaos Mesh — платформы хаос‑инжиниринга для Kubernetes.
С помощью Chaos Mesh или LitmusChaos эти локальные тесты можно воспроизвести в облачных окружениях, моделируя, например, сбои DNS, отказы узлов и нарушения сетевого взаимодействия.
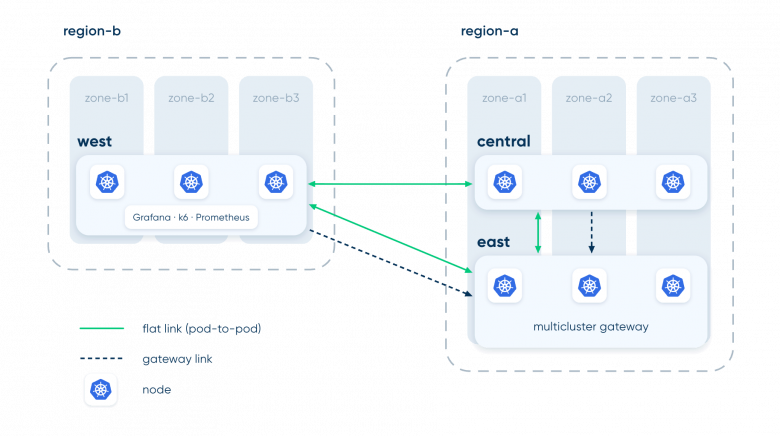
В каждом кластере 3 узла, расположенных в разных зонах доступности. CENTRAL и EAST развёрнуты в одном регионе, WEST — в другом. В WEST работают генератор нагрузки k6 и стек мониторинга Grafana + Prometheus. Сбои мы моделируем только в CENTRAL и EAST, чтобы сохранить сбор метрик.
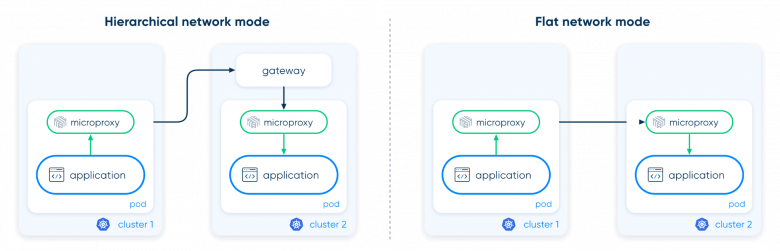
В кластерах развёрнуто простое приложение podinfo: по одной реплике на узел, всего девять реплик. Чтобы сравнить поведение приложения, мы публикуем его во всех трёх мультикластерных режимах Linkerd:
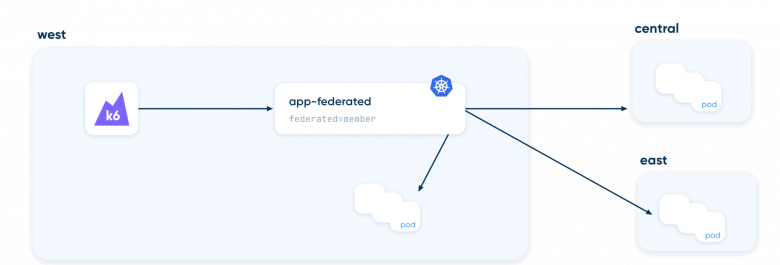
app-federatedapp-flat(pod‑to‑pod)app-gateway(иерархический)
Режим federated создаёт один логический сервис и разрешает эндпойнты для каждого кластера‑участника.
Режим flat mirror обнаруживает сервисы в удалённых кластерах. Какой из них использовать, выбирает клиент (k6); в нашем случае это EAST.
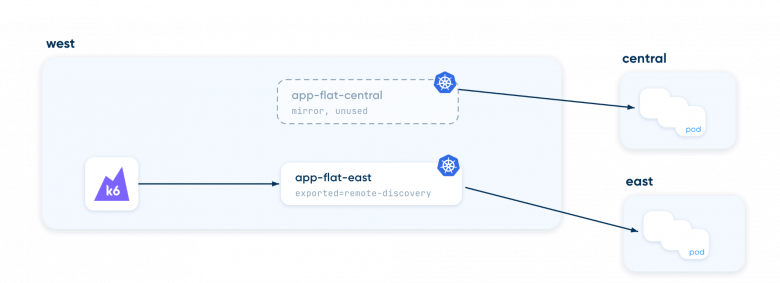
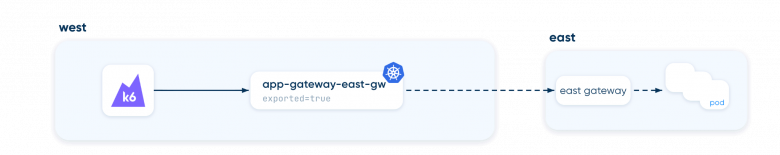
Режим gateway mirror создаёт в исходном кластере сервис, эндпойнтом которого служит шлюз, развёрнутый в целевом кластере. Трафик идёт через шлюз, а реальные поды разрешает уже целевой кластер.
За прогоном мы следим на собственном дашборде Grafana: аннотации на нём отмечают начало и окончание эксперимента, а алерты отслеживают симптомы и ошибки.
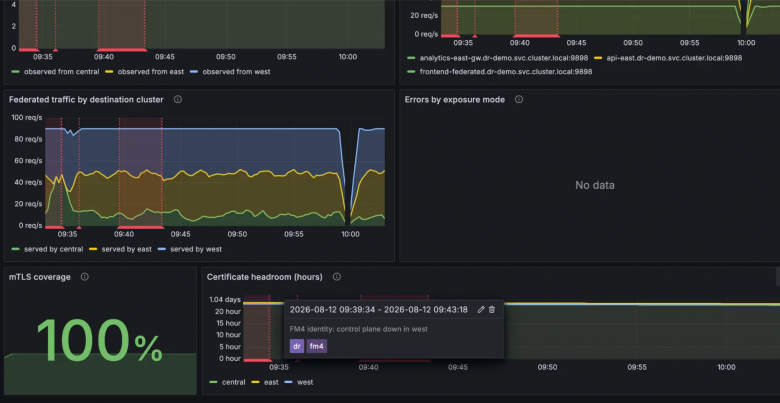
В каждом эксперименте мы отслеживаем метрики и настраиваем алерты на достижение пороговых значений:
Запросы без mTLS.
Число запросов, обрабатываемых в единицу времени.
Доля запросов с ошибками.
Число эндпойнтов в режиме federated.
Доступность шлюза.
Локальность трафика — доля трафика, направляемого в другую зону.
Код и результаты экспериментов доступны на GitHub. Для каждого прогона есть сводка и её наглядное представление. В инструкции описано, как импортировать дашборд Grafana и визуализировать данные эксперимента. Если что‑то не работает или вы хотите предложить другие тесты, создайте issue на GitHub.
Эксперименты
Базовый трафик во всех экспериментах одинаков: постоянная нагрузка 30 запросов в секунду на каждый режим публикации в каждом кластере, распределённая равномерно. Каждый эксперимент моделирует один сбой и измеряет его во всех трёх мультикластерных режимах.
Эксперимент 1: сбой управляющего слоя
В этом эксперименте мы моделируем сбой управляющего слоя сервисной сетки в кластере CENTRAL и проверяем, как он влияет на работу сетки и трафик между компонентами. Для теста уменьшаем число реплик Deployment приложения в EAST до 0. Назначение каждого сервиса управляющего слоя подробно описано в документации по архитектуре Linkerd.
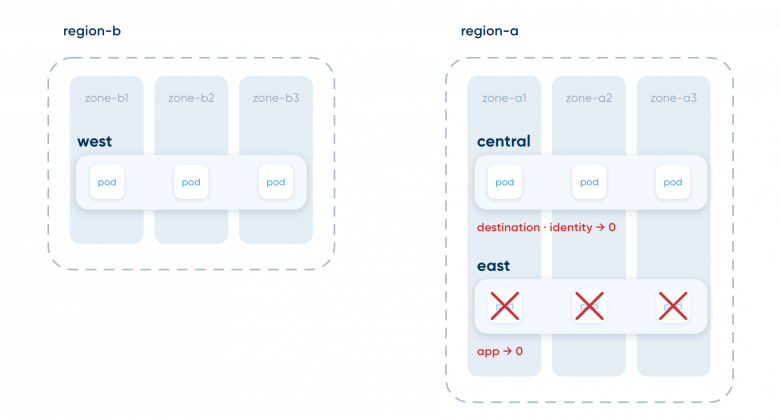
Эксперимент 1 a: сервис destination недоступен
Сервис destination отвечает за обнаружение эндпойнтов и работу контроллера политик Linkerd. Если он недоступен, информация об эндпойнтах перестаёт обновляться. Даже спустя 90 секунд CENTRAL продолжал сообщать, что все federated‑эндпойнты доступны, хотя подов в EAST уже не было. Сетка использовала устаревшие данные и не учитывала изменения в кластерах.
Эксперимент 1 b: сервис identity недоступен
Сервис identity выдаёт подам сертификаты. Если он недоступен, уже запущенные прокси продолжают обслуживать трафик с действующими сертификатами до истечения их срока — по умолчанию до 24 часов после последнего успешного обновления. Новые поды не могут получить сертификаты и присоединиться к сетке, поэтому увеличить число реплик приложений не получится.
Извлечённые уроки
Отслеживайте состояние управляющего слоя Linkerd на дашборде аварийного восстановления, например в Grafana. Настройте алерты на недоступность его сервисов и на поды, которые застряли на этапе инициализации и не могут присоединиться к сетке.
Проверки состояния подов и другие защитные механизмы могут временно скрыть проблемы сетки или защитить приложения от последствий её сбоя.
План аварийного переключения требует увеличения числа реплик, для которого нужен работоспособный управляющий слой. Процедура восстановления зависит от сетки, и во время инцидента она может стать узким местом. На её поведение при восстановлении влияют параметры установки, например webhookFailurePolicy.
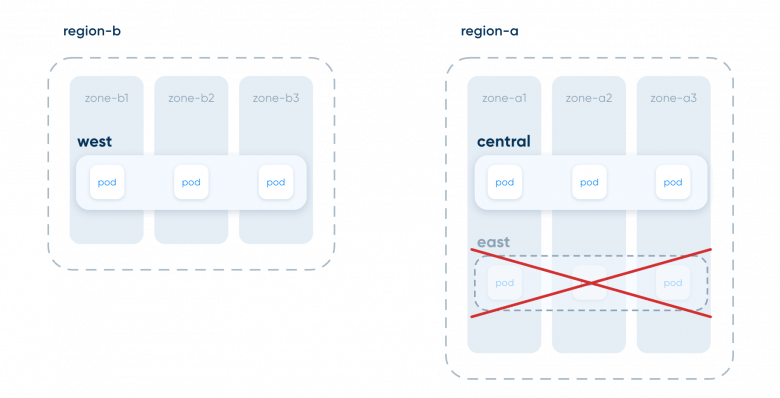
Эксперимент 2: кластер недоступен
В этом эксперименте мы останавливаем все три узла EAST. Затем повторяем эксперимент: удаляем сеть Docker, которая соединяет кластеры, и так моделируем полный сбой сети.
Извлечённые уроки
Мультикластерные режимы по‑разному реагируют на сбои: в одних отказ заметен сразу, в других его признаки менее очевидны. Разберитесь, как ваша конфигурация обнаруживает эндпойнты и находит бэкенды, а также где это происходит: в локальном кластере (federated или flat‑mirror) или в удалённом (gateway). От этого зависит поведение сетки при потере кластера.
Одного алерта на долю ошибок недостаточно. Если механизм обнаружения продолжает возвращать недоступные эндпойнты, запросы всё равно направляются к ним, а соединения зависают до истечения тайм‑аута клиента. Без тайм‑аутов метрики вроде request_total не растут. Тайм‑ауты и повторные попытки можно настроить в коде клиента или средствами Linkerd.
В тестах отдавайте предпочтение внезапным обрывам, а не корректному завершению работы (graceful shutdown), при котором сервис обрабатывает текущие запросы перед остановкой. Корректное завершение замечают и другие механизмы, например проверки состояния, а внезапный обрыв обнаруживается только после истечения тайм‑аутов обнаружения эндпойнтов. Такие тесты позволяют точнее оценить время обнаружения сбоя и восстановления.
Эксперимент 3: зона становится медленнее
В этом эксперименте мы добавляем задержку в одну зону кластеров EAST и CENTRAL. Поды при этом всё время оставались работоспособными.
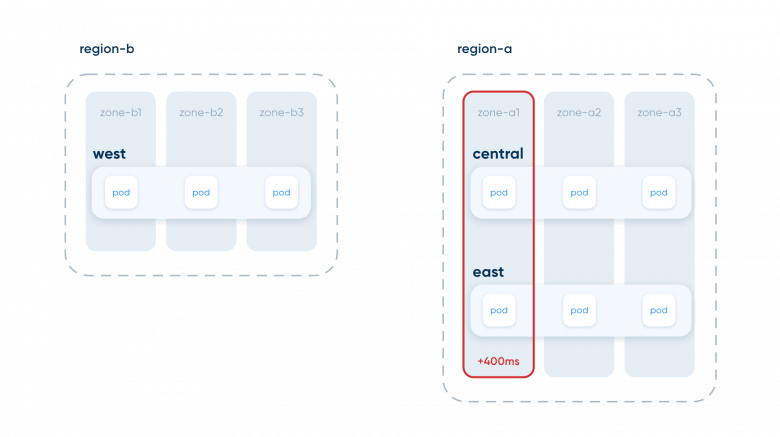
Схема топологии из двух регионов: зона zone‑a1 обведена красным, подпись +400 ms. В обведённой зоне находятся один под CENTRAL и один под EAST. Все поды по‑прежнему показаны работающими.
Извлечённые уроки
Маршрутизация на основе топологии не видит деградировавшую, но работоспособную зону, а HAZL адаптируется и переводит трафик на эндпойнты, которые работают лучше.
В штатном режиме HAZL удерживает трафик в своей зоне, даже когда он переходит из кластера в кластер. В open source‑версии Linkerd та же рабочая нагрузка распределяется без учёта зон, и в реальном счёте за трафик это оборачивается межзональным egress‑трафиком для большинства запросов.
Примечание: межкластерная зональная локальность HAZL сейчас требует мультикластерного режима pod‑to‑pod (flat) и в этом эксперименте не применяется к режиму gateway.
Эксперимент 4: регион выходит из строя
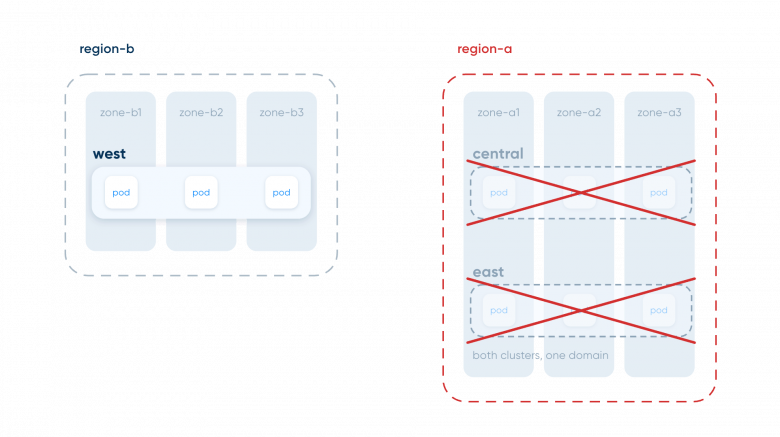
Оба кластера в region‑a отключены, в работе остаётся только WEST. Уцелевший регион принимает на себя весь трафик.
Извлечённый урок
Режим federated хорошо справляется с потерей региона: поды в WEST уже входят в пул federated‑сервиса. Он выдерживает такой сбой, если WEST может принять дополнительную нагрузку и масштабироваться вверх. Если нет, следите, чтобы сервисы принимали ровно столько запросов, сколько могут обработать, и применяйте ключевые методы: ограничение частоты запросов и circuit breaking10 (Linkerd их поддерживает). Два других режима отказывают, потому что их эндпойнты находились в отказавшем регионе. Так получилось из‑за того, как мы спроектировали архитектуру моделирования, а не из‑за ограничений Linkerd.
Три шага, которые повысят надёжность вашей сервисной сетки
1. Проверьте свою установку и разберитесь в ней
Этот шаг большинство пропускает. У Buoyant есть чек‑лист для промышленной эксплуатации, в котором собраны типичные проблемы и требования к установке.
Мультикластерное взаимодействие в Linkerd можно настроить несколькими способами. Эксперименты показывают, что каждая топология по‑своему реагирует на сбои, а возникающие ошибки могут быть явными или скрытыми. Разбор топологий и результаты их хаос‑тестирования приведены в статье «Федерация кластеров для Kubernetes без простоев».
Например, установка по руководству Buoyant для промышленной эксплуатации по умолчанию использует параметры высокой доступности (HA). При установке со значениями Helm‑чарта по умолчанию это не так. Без HA для proxy injector — компонента, который автоматически добавляет прокси в создаваемые поды, — задано webhookFailurePolicy=Ignore. Если этот компонент недоступен, поды могут запускаться без прокси и оставаться вне сетки. В режиме HA значение меняется на Fail. В обоих режимах параметр defaultInboundPolicy по умолчанию имеет значение all-unauthenticated, поэтому поды в сетке принимают трафик без mTLS, пока настройку не изменят глобально или для отдельного пространства имён. Во время инцидента эти параметры могут привести к неожиданному поведению сетки.
2. Доработайте алерты
Для многих точек отказа сетки нет стандартных алертов. Алерты на долю запросов с ошибками не выявляют проблемы управляющего слоя напрямую.
Отслеживайте следующие сигналы:
Работоспособность управляющего слоя сетки.
Истечение срока действия сертификатов прокси.
Поды, которые не могут присоединиться к сетке.
Трафик без mTLS между сервисами там, где его быть не должно.
Метрики описаны в статье о работе сервиса destination в Linkerd.
Смоделируйте аварийное переключение и проверьте, сработают ли алерты. Стандартные алерты могут выявить симптомы — ошибки, которые видят пользователи, — но не первопричину, например сбой управляющего слоя.
3. Тестируйте восстановление от начала до конца
Документируйте проблемы, включайте их в учения по аварийному восстановлению и регулярно повторяйте тесты. Готовые дашборды выявляют не все проблемы: поведение сетки зависит от топологии, параметров установки и мультикластерной конфигурации. Надёжно проверить, сможет ли сетка восстановиться, можно только в своём окружении.
Тест должен охватывать весь процесс: внесение сбоя, выявление его признаков и восстановление до исходного рабочего состояния. Например, проблемы с сервисом identity могут проявиться только при увеличении числа реплик приложений. В экспериментах такие проблемы возникали именно во время восстановления, поэтому убедитесь, что тесты охватывают и этот этап.
Выводы
Мы разобрали возможные сбои мультикластерной конфигурации Linkerd и меры, которые помогут доработать план аварийного восстановления сервисной сетки. Эксперименты показали следующее:
При сбое сервисная сетка редко сразу перестаёт пропускать трафик. Чаще она теряет способность адаптироваться к изменениям, масштабироваться и оставаться управляемой.
Сетка добавляет новые точки отказа, которые нужно учитывать в учениях по аварийному восстановлению.
Алерты и процедуры восстановления должны учитывать топологию вашей сетки.
Начните с одного сценария отказа, например роста задержки в регионе или выхода кластера из строя, и протестируйте его от начала до конца:
Зафиксируйте исходное состояние: сервисы работают, нагрузка стабильна.
Опишите ожидаемое поведение во время инцидента. Например, из‑за задержки запросы между кластерами завершаются по тайм‑ауту.
Внесите сбой и убедитесь, что алерты срабатывают.
Восстановите нормальную работу и проверьте, что алерты закрываются.
Выясните, какие компоненты отказали, устраните проблемы и повторите тест.
Другой вариант — остановить часть компонентов управляющего слоя Linkerd и изменить нагрузку на приложения так, чтобы запустилось масштабирование. Проверьте, выявят ли алерты проблему до того, как запросы начнут завершаться ошибками.
Удачного хаоса!
FAQ
Что происходит с трафиком Linkerd, когда управляющий слой выходит из строя?
Трафик продолжает идти, но сервисная сетка перестаёт адаптироваться к изменениям. Если недоступен сервис destination, информация об эндпойнтах перестаёт обновляться. Если недоступен сервис identity, уже запущенные прокси обслуживают трафик до истечения срока действия сертификатов — по умолчанию до 24 часов. Новые и перезапущенные поды не могут получить сертификаты и перейти в состояние готовности.
Какой мультикластерный режим Linkerd переживает сбой региона?
В наших тестах federated‑сервисы пережили потерю целого региона, поскольку логический сервис продолжал обнаруживать эндпойнты в уцелевшем кластере. Режимы pod‑to‑pod и gateway отказали: их эндпойнты находились в вышедшем из строя регионе.
Как HAZL ведёт себя по сравнению с topology‑aware routing, когда зона начинает работать медленно?
Topology‑aware routing не распознаёт замедление зоны, пока она остаётся работоспособной, и продолжает направлять в неё трафик. HAZL замечает рост нагрузки из‑за задержки и перенаправляет часть трафика на эндпойнты в других зонах. Для сохранения зональной локальности трафика между кластерами HAZL сейчас требует мультикластерного режима flat (pod‑to‑pod).
Почему алертов на долю ошибок недостаточно для мультикластерного аварийного восстановления?
Когда сервис теряет все эндпойнты, запросы встают в очередь в прокси вместо того, чтобы завершаться ошибкой. Доля ошибок остаётся низкой, а число обрабатываемых запросов резко падает. Настройте тайм‑ауты на уровне сетки, чтобы зависшие запросы завершались ошибками. Добавьте алерты на снижение числа обрабатываемых запросов относительно исходного уровня, сбои управляющего слоя, истечение срока действия сертификатов, поды, которые застряли на этапе инициализации прокси или работают без него, и неожиданный трафик без mTLS.
Как протестировать аварийное восстановление сервисной сетки в собственных кластерах?
Выберите один сценарий отказа, например выход кластера из строя, и протестируйте его от начала до конца. Зафиксируйте исходное состояние и ожидаемое поведение, внесите сбой и убедитесь, что алерты срабатывают. Затем восстановите нормальную работу и проверьте, что алерты закрываются. Chaos Mesh или LitmusChaos позволяют сделать такие тесты воспроизводимыми.