

Привет, Хабр!
Мы тонем в новостях: тут говорят одно, там — противоположное, а где правда — непонятно. Информации слишком много. Не хватает инструмента, который показывал бы, как риск меняется во времени: по открытым данным, а не по громкости заголовка. Такого инструмента я не нашёл. Пришлось собрать самому.
Получился Индекс Кассандры — еженедельный сервис про уровень и направление риска глобального конфликта. Без регистрации, трекеров и подписок. Код, методика, данные и тесты открыты на GitHub, сайт статический (GitHub Pages).
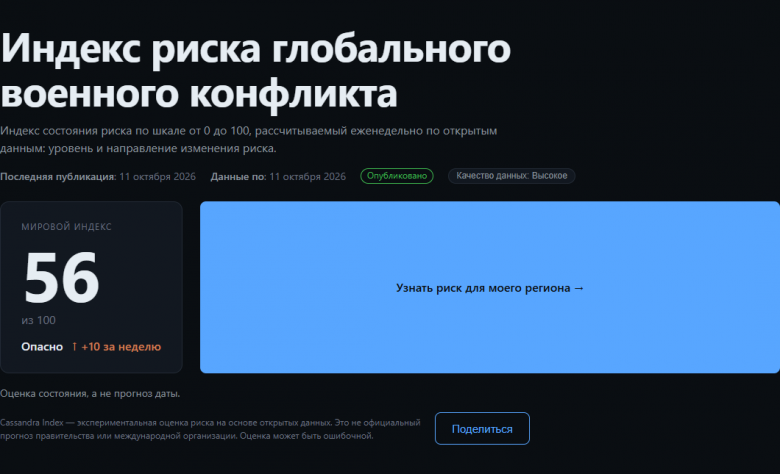
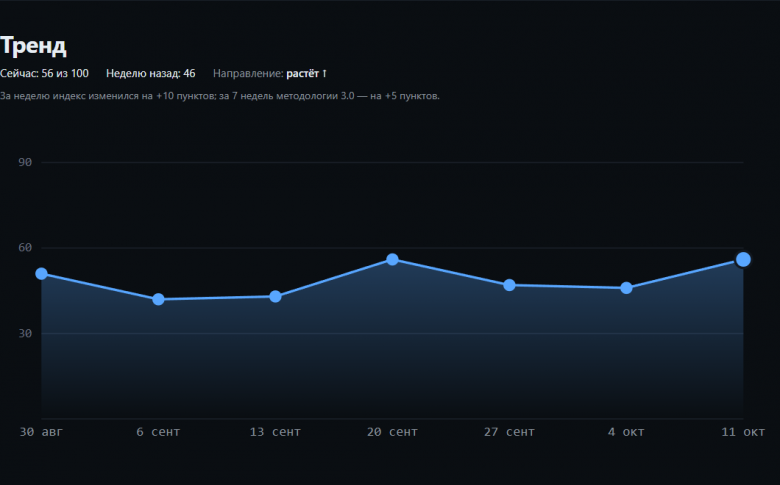
Свежая неделя (11 октября 2026): 56, +10 к предыдущей (46). Ниже — как получается это число и как в него вошла новая модель‑классификатор Jev.
Это рассказ об инженерной задаче: как устроен расчёт, как он проверяется и что даёт машинная классификация. Политических оценок и агитации нет — только измерение сигналов и метод.
Почему Кассандра
Кассандра получила дар предвидения — и проклятие: ей никто не верил. Она предупреждала о падении Трои и о троянском коне, но её не слушали. Ошибалась она? Нет. Просто у правды не было доказательств.
Этот проект — про то же самое. Вместо «поверьте мне» здесь сигналы, ссылки на источники и формула, по которой из них получается число. Предупреждение можно проверить. Поэтому индекс и назван в её честь. Знать мало — надо ещё показать, откуда ты это знаешь.
Про ИИ в этом проекте
Да, без ИИ не обошлось: модель помогала писать код, а сейчас классифицирует источники — об этом раздел ниже. Критерии, агрегация, обработка нехватки данных, калибровка параметра на исторических якорях и ворота целостности — решения человеческие. Числа ниже я сверил со снапшотами, утверждения — с источниками; ответственность за текст на мне.
Тест простой: откройте сайт. Если картина понятна человеку без технического бэкграунда — инструмент справляется.
Что отдаёт сервис
Раз в неделю — четыре вещи:
уровень риска — число;
направление — вверх, вниз или без изменений;
состояние — читаемое, без метафор «на грани»;
источники — ссылки на то, откуда взяты сигналы.
Плюс тренд по неделям, региональные разрезы и список критериев с расшифровкой. И блок качества данных: какую долю сигналов неделя реально покрыла, насколько ей можно доверять и на сколько пунктов индекс устойчив к смене источников. Для 11 октября — покрыто 7 из 9 драйверов, чувствительность нулевая.
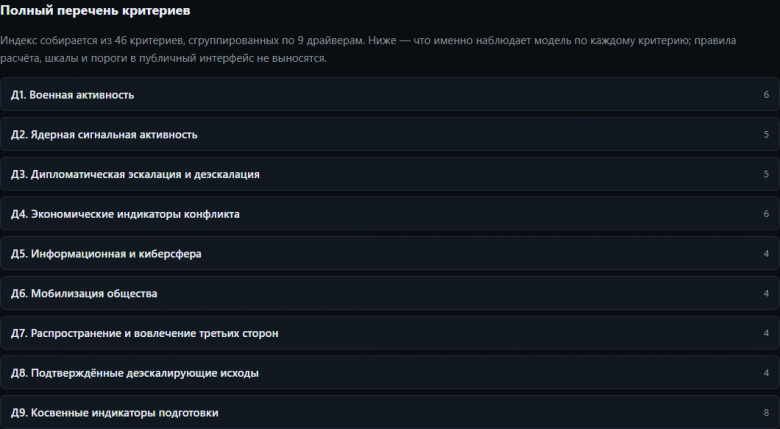
Что внутри: 9 драйверов, 46 критериев
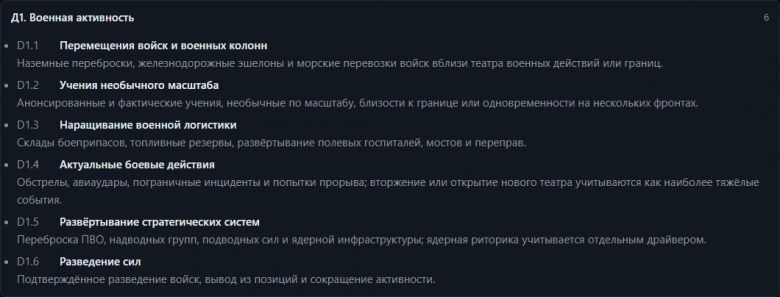
Риск складывается из 9 драйверов. В сумме они опираются на 46 критериев. Каждый критерий — сигнал своего типа: военный, экономический, дипломатический, внутренний.
Что фиксируется по критерию за неделю? Значение. Покрыт ли он источниками. Ссылки.
Оценка драйвера считается отдельно. Дальше результаты агрегируются по открытой методике. Никакого машинного обучения и «умных предсказаний» — детерминированный движок на чистых функциях.
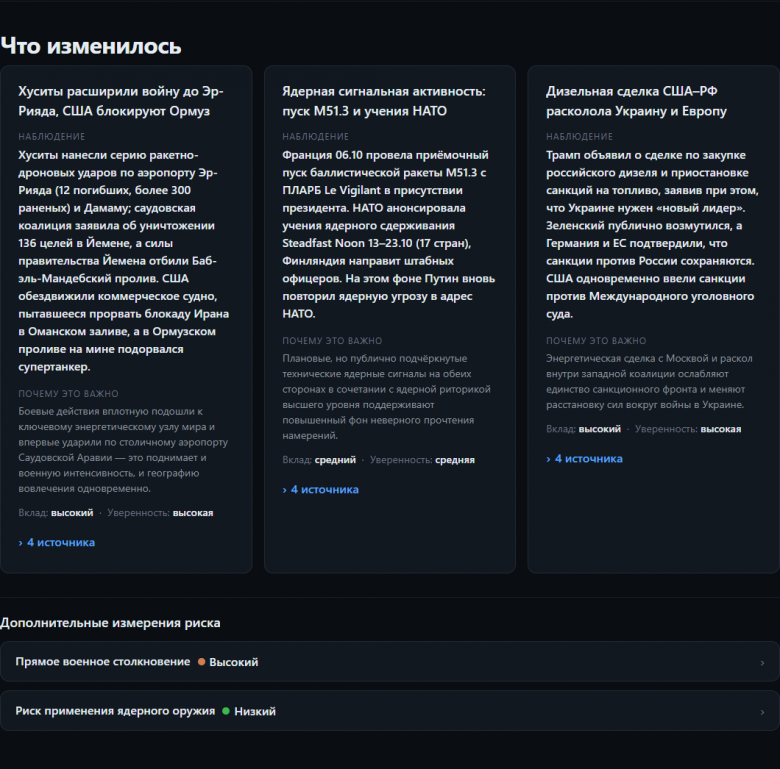
Что изменилось в методологии с первой версии статьи:
методология 3.0 и пересчитываемая цепочка. Демо‑недели ушли в архив, который не пересчитывается. Зато сплошным пересчётом считается вся цепочка — сейчас это семь недель подряд (с 30 августа), историю можно воспроизвести с начала;
параметр
k = 1.95. Больше не «на глаз»: калибровка на 10 якорных профилях (7 отборочных + 3 проверочных), проверка на устойчивость к изменению ±20%. Весь след — в журнале;классификация публикации по покрытию. Мало данных — неделя не уезжает в молчаливый «средний» индекс, а получает состояние
insufficient/reducedс причиной. Пороги — вcalc/params.js, код — вcalc/calc.js;through= дата самой недели. Окно сигналов — W−7…W включительно;региональная атрибуция и слепые регионы. Критерий может нести привязку к регионам. Регион с сигналами считается по ним; регион без сигналов сохраняет последнее отклонение от глобального фона, а сайт помечает его как фон («индекс отражает глобальный фон»), а не выдаёт глобальную дельту за региональную. Механизм уже задействован данными: недели 3.0 смешанные — часть регионов считается по своим сигналам, часть помечена как фон;
тренд — только по версии 3.0. Точки более ранней серии на график не попадают.
И два новых механизма, появившихся в октябре:
ворота независимости источников (с 11 октября). Каждый покрытый критерий недели обязан опираться минимум на два разных кластера источников или хотя бы на один первичный/OSINT‑источник. Правило шло в методологии, но в коде раньше не применялось — теперь это ворота перед расчётом. Введены вперёд, без пересчёта уже опубликованных недель;
метрика чувствительности недели. Автоматически проверяется, на сколько сдвинется индекс, если убрать по очереди самый влиятельный домен и целый кластер источников. Для недели 4 октября — 5,4 пункта (там был один домен‑монополист), для 11 октября — ноль. Если сдвиг превышает 5 пунктов, сайт помечает неделю.
Это ответ на частый упрёк к такому индексу: «источники выбираешь ты, значит, нарисовать можно что угодно». Теперь у критерия не может быть одного рупора, а субъективность выбора измеряется числом. Плюс есть ориентир по ядру (девять доменов из кластеров A/B/C/F) и red team‑чек‑лист из семи вопросов перед каждой публикацией — он advisory, но след остаётся в журнале аудита.
И ещё. Критерий может остаться непокрытым. Нет надёжных данных за неделю — он помечается «слепым» и считается отдельно от покрытых. Это лучше, чем тихо подставить ноль.
Отдельно про рыночный критерий. Теперь он введён: в методологии 3.0 появился 46-й критерий — стресс рынков (сырьевые биржи и рынки облигаций реагируют раньше остальных сигналов). Он ломает сопоставимость серии, поэтому принят не задним числом, а новой версией методики — с перекалибровкой k на десяти якорях (включая новый критерий) и версионным разрывом на тренде. Вся цепочка недель перевыпущена под 3.0. Сайт работает на 46 критериях.
Jev: модель‑классификатор, которая читает источники вместо вас
Самое узкое место такого индекса — сбор входа. 46 критериев, десятки статей, всё вручную. «LLM разметит за вас» обычно кончается галлюцинациями. Поэтому классификатор я подключал с одной целью: ускорить человека, а не заменить его решение.
Что такое Jev. Это модель‑классификатор из TypeSafe (System One). Длинных текстов она не пишет. Вместо этого выдаёт атомарные типизированные суждения: классификацию, оценку по шкале, вероятность, вердикт с доверием.
Подключается по MCP: jev_classify, jev_score, jev_check, jev_gate, jev_decide.
Почему это удобно? Такой ответ легко проверить кодом. На входе — состояние и вопросы со схемой, на выходе — типизированный результат, который можно сравнить с порогом.
Принцип разделения
Код владеет правилами, Jev даёт суждения:
Классификация (Jev). Текст раскладывается по критериям D1…D9. Релевантен ли он критерию? Какое поставить значение —
value, а для счётных критериев массивevents[]с весами? Это событие окна W−7…W или тянущийся фон? Не продублировано ли одно событие в нескольких критериях? Каждое значение больше нуля обязано нести дословную цитату и ссылку. Нет цитаты →not_found. Правило жёсткое. Полеcoveredклассификатор не выставляет вовсе: слепоту критерия решает только редактор.Верификация (человек). Редактор видит черновик: значение, цитата, ссылка. Подтверждает, правит или отбрасывает спорное. Решение о переносе критерия с прошлой недели — всегда за человеком.
Детерминированный расчёт (код). Дальше — только
calc/engine.js. Никакого ИИ в формулах. Jev не двигает индекс ни на пункт: он ускоряет подготовку входа, а считает чистая математика.
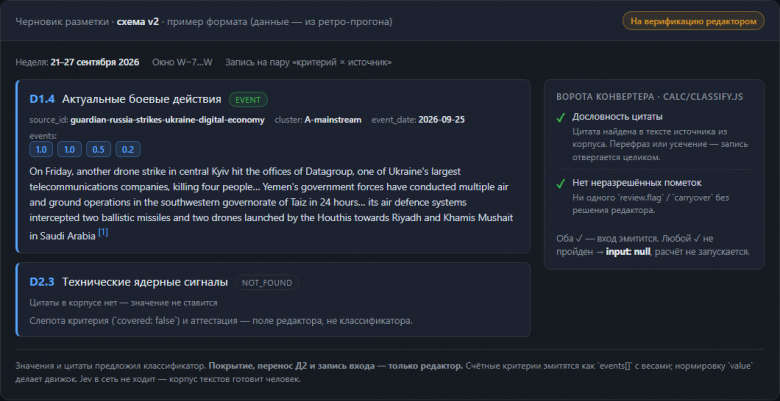
Механический шов вместо «поверьте на слово». Jev — внешний MCP, в репозитории по‑прежнему ноль зависимостей, поэтому модель из кода не вызывается. Между черновиком и расчётом стоит чистый конвертер calc/classify.js — без сети и без вызова Jev — с двумя жёсткими воротами:
дословность цитаты проверяется машинно. Конвертер ищет цитату в тексте источника из корпуса; нормализует пробелы, дефисы и кавычки, но перефраз или усечение не прощает — не нашёл, запись отвергается целиком, а не уходит «на ревью»;
неразрешённая пометка блокирует эмиссию. Пока в черновике есть хоть один флаг «на ревью» или незакрытый кандидат на перенос Д2, вход в расчёт вообще не собирается: спорное — долг редактора, а не значение.
Черновик перешёл на схему v2: запись на пару «критерий × источник», тип event / background / not_found, для счётных критериев — массив events[] с весами, а не свёрнутое значение (нормирует уже движок). И сам Jev в сеть не ходит: корпус текстов ему готовит человек. Так прогон воспроизводим, а «сколько статей машине реально дали» видно напрямую — нет текста, нет и значения.
Почему я этому доверяю
До подключения Jev я прогнал слепые ретро‑прогоны по уже опубликованным неделям (27 сентября и 20 сентября 2026 года). Классификатор не видел ни человеческого входа, ни результатов. Итоги оказались неприятными.
ноль выдуманных фактов на двух прогонах подряд — каждое значение > 0 с проверяемой цитатой, «лишних» покрытий не найдено ни одного;
система цитат работает, но слишком консервативна, когда статьи недоступны. Из 74 URL классификатор дотянулся примерно до трети. Блокер пилота — не классификация, а доставка текстов: Reuters отдаёт 401 ботам, часть сайтов закрыта Cloudflare;
расхождение итогового индекса с ручной разметкой — 6 и 17 пунктов. Оба раза причина в покрытии. Там, где текст был, оценки не расходились.
Статус на момент публикации: Jev подключён как классификатор. Схема гибридная. Недоступные новости докидывает человек. Дальше Jev классифицирует, человек верифицирует.
Схема черновика v2 и конвертер с двумя машинными воротами уже готовы. Форвард‑прогон описан заранее и пока не проведён: метрика ±2 (сырой черновик прогоняется без записи и сверяется с верифицированным входом той же недели) и посегментный хронометраж против контрольной ручной недели, одной и той же рукой. Цифры экономии и совпадения появятся после него — не раньше.
Критерии успеха зафиксированы заранее, в журнале пилота: индекс ±2 и тот же статус, экономия времени редактора ≥ 50%. Отчитаюсь по факту, а не по обещаниям.
Вся логика — в документах проекта; статья их пересказывает, а не наоборот. docs/jev‑classification.md (версия 0.2: роли, схема v2, правила, ворота § 6.1, статус пилота) и docs/adr/0018-jev‑source‑classification.md (почему выбран такой разделитель труда; дополнение от 11 октября — про конвертер). docs/governance.md § 10.1 — правила машинной разметки, обязательные для всех прогонов.
Чего Jev не делает. Не предсказывает будущее. Не «понимает геополитику». Не пишет тексты для сайта. Он классифицирует — и за каждое суждение отдаёт цитату и доверие, которые я могу отклонить.
Стек: ноль зависимостей — и пока без базы данных
Архитектура такая:
чистый HTML/CSS/JS, без фреймворков;
расчётный пайплайн — Node.js, только стандартная библиотека;
фронтенд собирается собственным мини‑бандлером в пару файлов;
данные лежат статическими снапшотами, которые браузер читает даже с
file://;Jev подключён снаружи по MCP — в репозитории по‑прежнему ноль npm‑зависимостей;
конвертер черновика (
calc/classify.js) — тоже чистый модуль: ни сети, ни вызовов модели, только проверка формата, дословности цитат и очереди ревью.
Отдельно про базу данных. Её нет, и пока не нужна.
Зачем хранилище одному еженедельному индексу, который целиком пересчитывается? Снапшоты на диске уже дают историю, версионирование и воспроизводимость.
Но на рост я рассчитывал. Появятся новые индексы — по регионам, отдельным типам риска, экономическим сценариям — вот тогда база для длинной истории, агрегаций и API станет нужна. А сейчас это ноль серверной логики и ноль зависимостей — так и задумано.
Как гарантируется целостность
Перед публикацией неделя проходит несколько ступеней проверки.
Ворота независимости источников. Каждый покрытый критерий — минимум два разных кластера или первичный/OSINT‑источник. Не прошёл — неделя не считается.
Проверка источников. Каждая ссылка реально обходится и классифицируется:
ok/blocked(401/403/406 — предупреждение, не отказ) /broken(404 и дальше — запись отклоняется). Битая ссылка до сайта не доедет.Контракт данных. Готовый снапшот валидируется схемой: ровно 12 точек тренда, ровно 3 драйвера в разборе, корректные состояния, флаг регионального фона и так далее. Провал любого ворота — диск не тронут.
Метрика чувствительности. Автоматический пересчёт без каждого домена и каждого кластера. Сдвиг больше 5 пунктов — публичная пометка недели.
Плюс 38 тест‑файлов на чистое ядро (359 проверок проходят без сети, на синтетических данных) и red team‑чек‑лист из семи вопросов перед каждой публикацией. Конвертер черновика тоже покрыт тестами — включая сквозной позитив: собранный из черновика вход проходит валидацию движка и мапится в 9 драйверов.
Все калибровки, пересчёты и ответы red team пишутся в журнал аудита (data/audit.jsonl, hash‑цепочка). У каждого числа — дата, причина и версия методологии.
Черновик Jev проходит те же ворота, что и ручной ввод: независимость источников, контракт и проверку ссылок. Никаких поблажек.
Любую неделю можно пересчитать из входа и сверить с опубликованным снапшотом.
Чего сервис намеренно НЕ делает
не предсказывает дату какого‑либо события;
не является вероятностью войны — это индекс уровня риска по открытым сигналам;
не заменяет профильную экспертизу;
не занимает политическую сторону и не агитирует: это измерение сигналов по открытым данным, а не оценка действий государств;
не отдаёт расчёт на откуп классификатору — Jev готовит черновик разметки, решение и математика остаются проверяемыми.
Задача — показать динамику в одном месте и дать вернуться к любому числу с вопросом «а откуда это взялось?»
Главное — обычные люди
Это не проект для аналитиков.
Он для человека, который открыл новости, растерялся и хочет понять, что происходит. Для моих родителей — они не обязаны разбираться в формулах. Для всех, кому нужна не «экспертиза на трёх страницах», а одна честная картина: где мы и куда движемся.
Поэтому здесь столько внимания прозрачности: техника — средство, а цель — чтобы обычный человек перестал зависеть от громкости заголовка.
Что мне нужно от вас
Техническому сообществу я верю больше, чем своим ощущениям. Поэтому вопросы конкретные:
Что вызывает недоверие в методологии — агрегация, выбор критериев, обработка слепых значений, калибровка
kна якорях, ворота независимости источников, метрика чувствительности?Что добавить, чтобы машинной разметке можно было доверять больше: кросс‑проверку вторым прогоном, обязательный второй кластер для Д9, публикацию черновика на ревью?
Чего не хватает в интерфейсе, чтобы этим можно было пользоваться раз в неделю?
Что поправить в методологии или интерфейсе — напишите в комментариях. Критика по делу полезнее одобрения.
Проект полностью открытый: код, методика, данные и тесты — в репозитории на GitHub. Работающий сервис — cassindex.ru.
Комментарии (26)

ii445888
16.10.2026 16:19тут говорят одно, там — противоположное, а где правда — непонятно
Так и где в итоге правда?

MikhailZas Автор
16.10.2026 16:19Думаю, правда в том, что индекс на каждый сигнал смотрит без предвзятости (как это заложено в методологии). ККонечно, в моменте индекс не рассудит - зато покажет, куда и насколько смещается риск от недели к неделе и далее уже каждый сам для себя решает, что делать.

UB3
16.10.2026 16:19Выскажу свое скромное имхо - делать прогноз на информационном пузыре во время мягко скажем войны дело не благодарное, везде идет деза высшей пробы - не отличишь от реальности, просто прими это к сведению и прогнозы возможно, станут качественнее.
Удачи!
MikhailZas Автор
16.10.2026 16:19Спасибо, согласен по существу. Заранее отличить сигнал от дезы нельзя, поэтому это и не прогноз, а измерение с честным состоянием "не знаю". Поэтому в методологию добавил ворота независимости (у критерия нет одного рупора), слепые критерии вместо нуля, обязательная дословная цитата и метрика чувствительности к снятию домена. Индекс не станет идеально качественным при неотличимой дезинфомации, а может лишь честно показывать, чего не видит, и насколько зависит от источников.
В идеале, конечно, хотелось бы поймать дезу-источник и проанализировать как сильно повлияет на расчет.

akuli
16.10.2026 16:19Инструмент показывает отклонение от фона, а не предсказывает прилеты. Как индикатор медийного давления он вполне работает
MikhailZas Автор
16.10.2026 16:19Полноценный справочник конечно не сложно добавить. Ключевой нюанс: текущий индекс рассчитывается на уровне региона, а не страны или города. Конкретный город -это лишь способ выбрать свой регион.
МОй промах, фокус в первую очередь был на методологии, а не на списке городов.
Добавлю справочник, а то отсутствие искомого значения только недоверие и вопросы вызывает.

tsrg
16.10.2026 16:19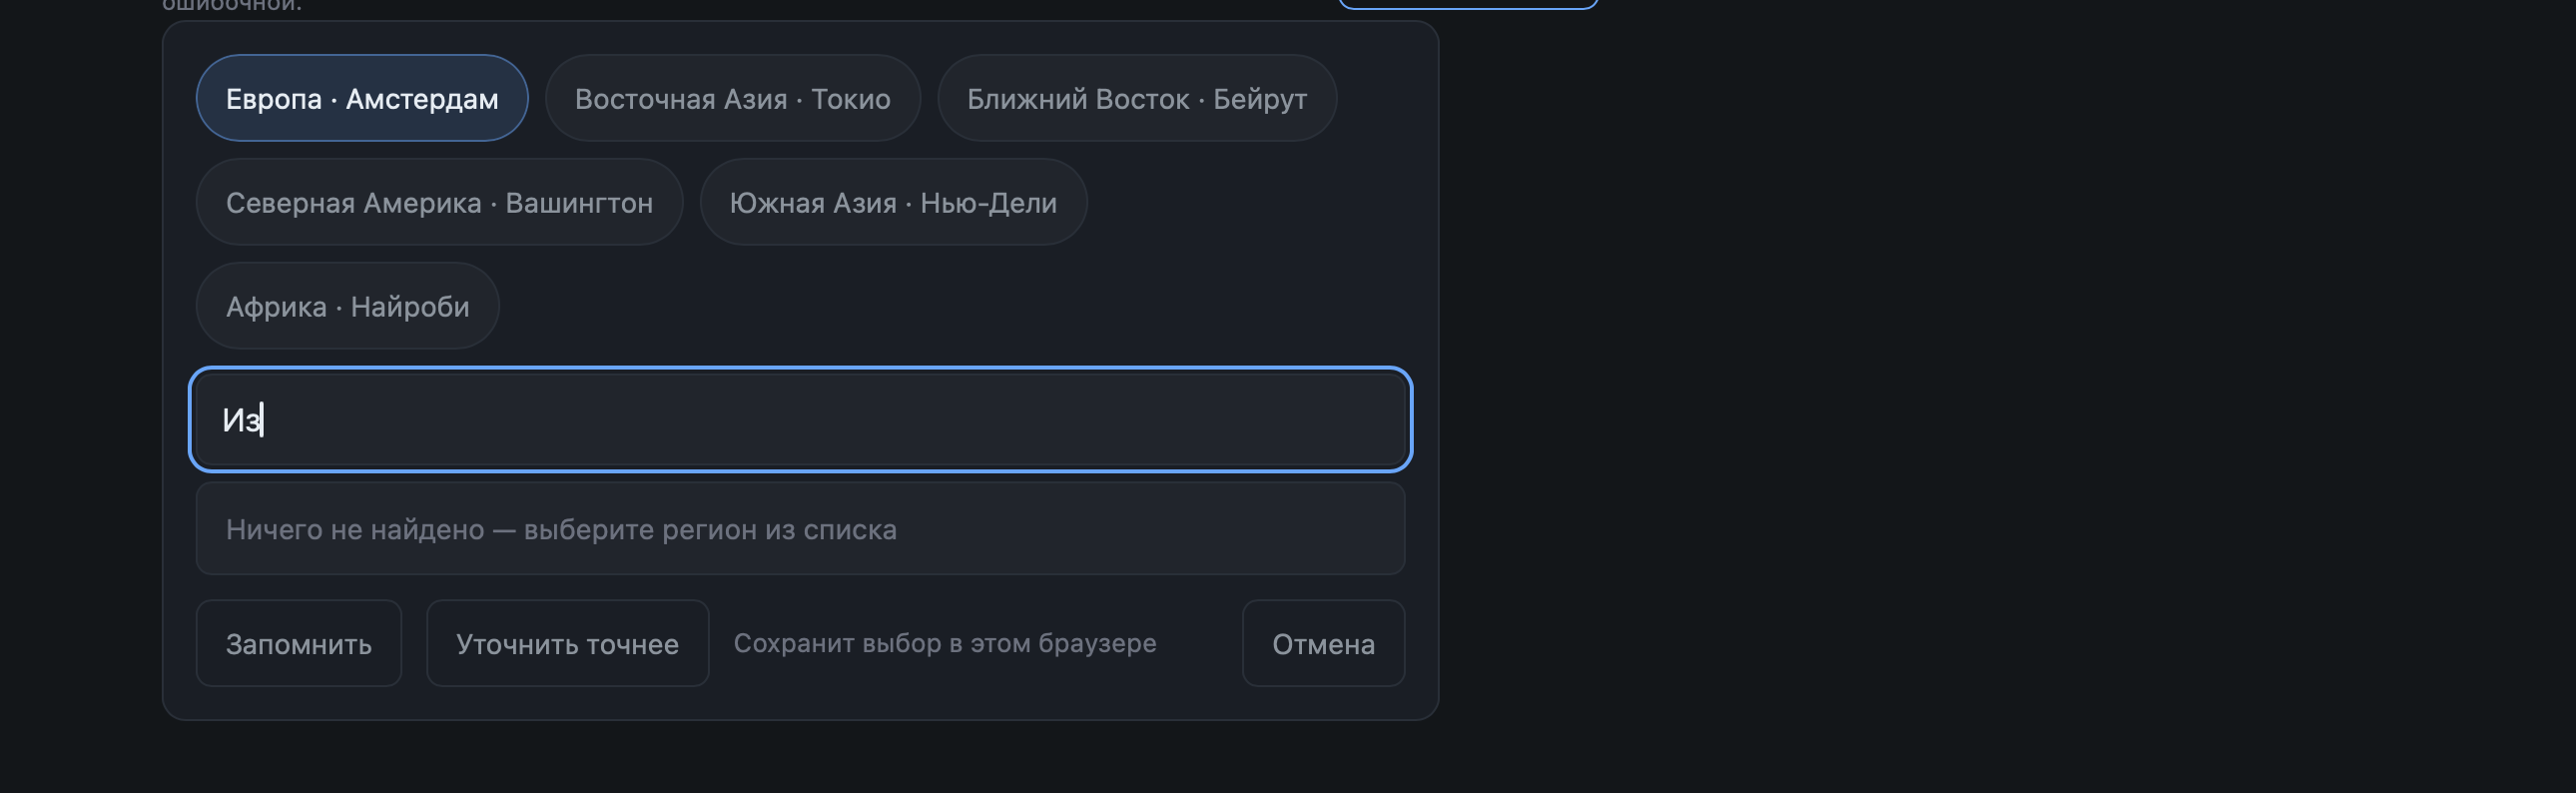
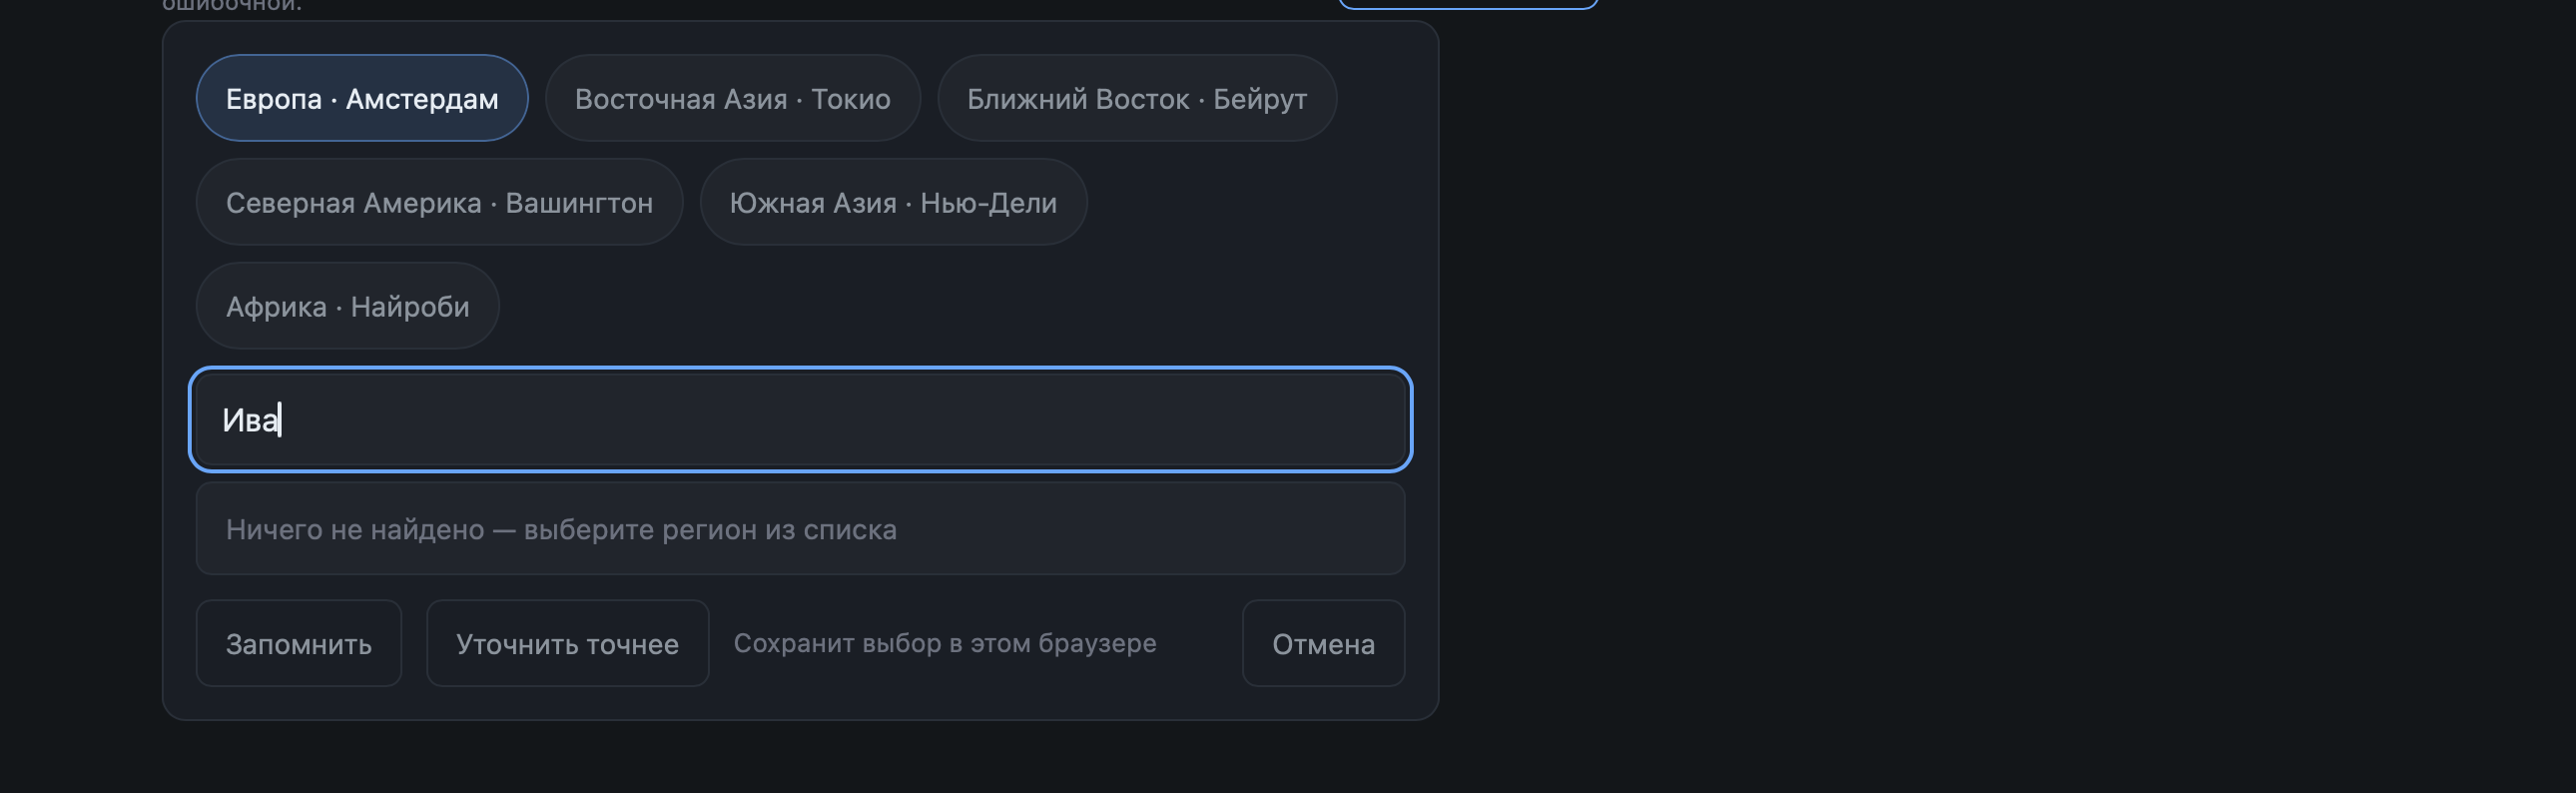
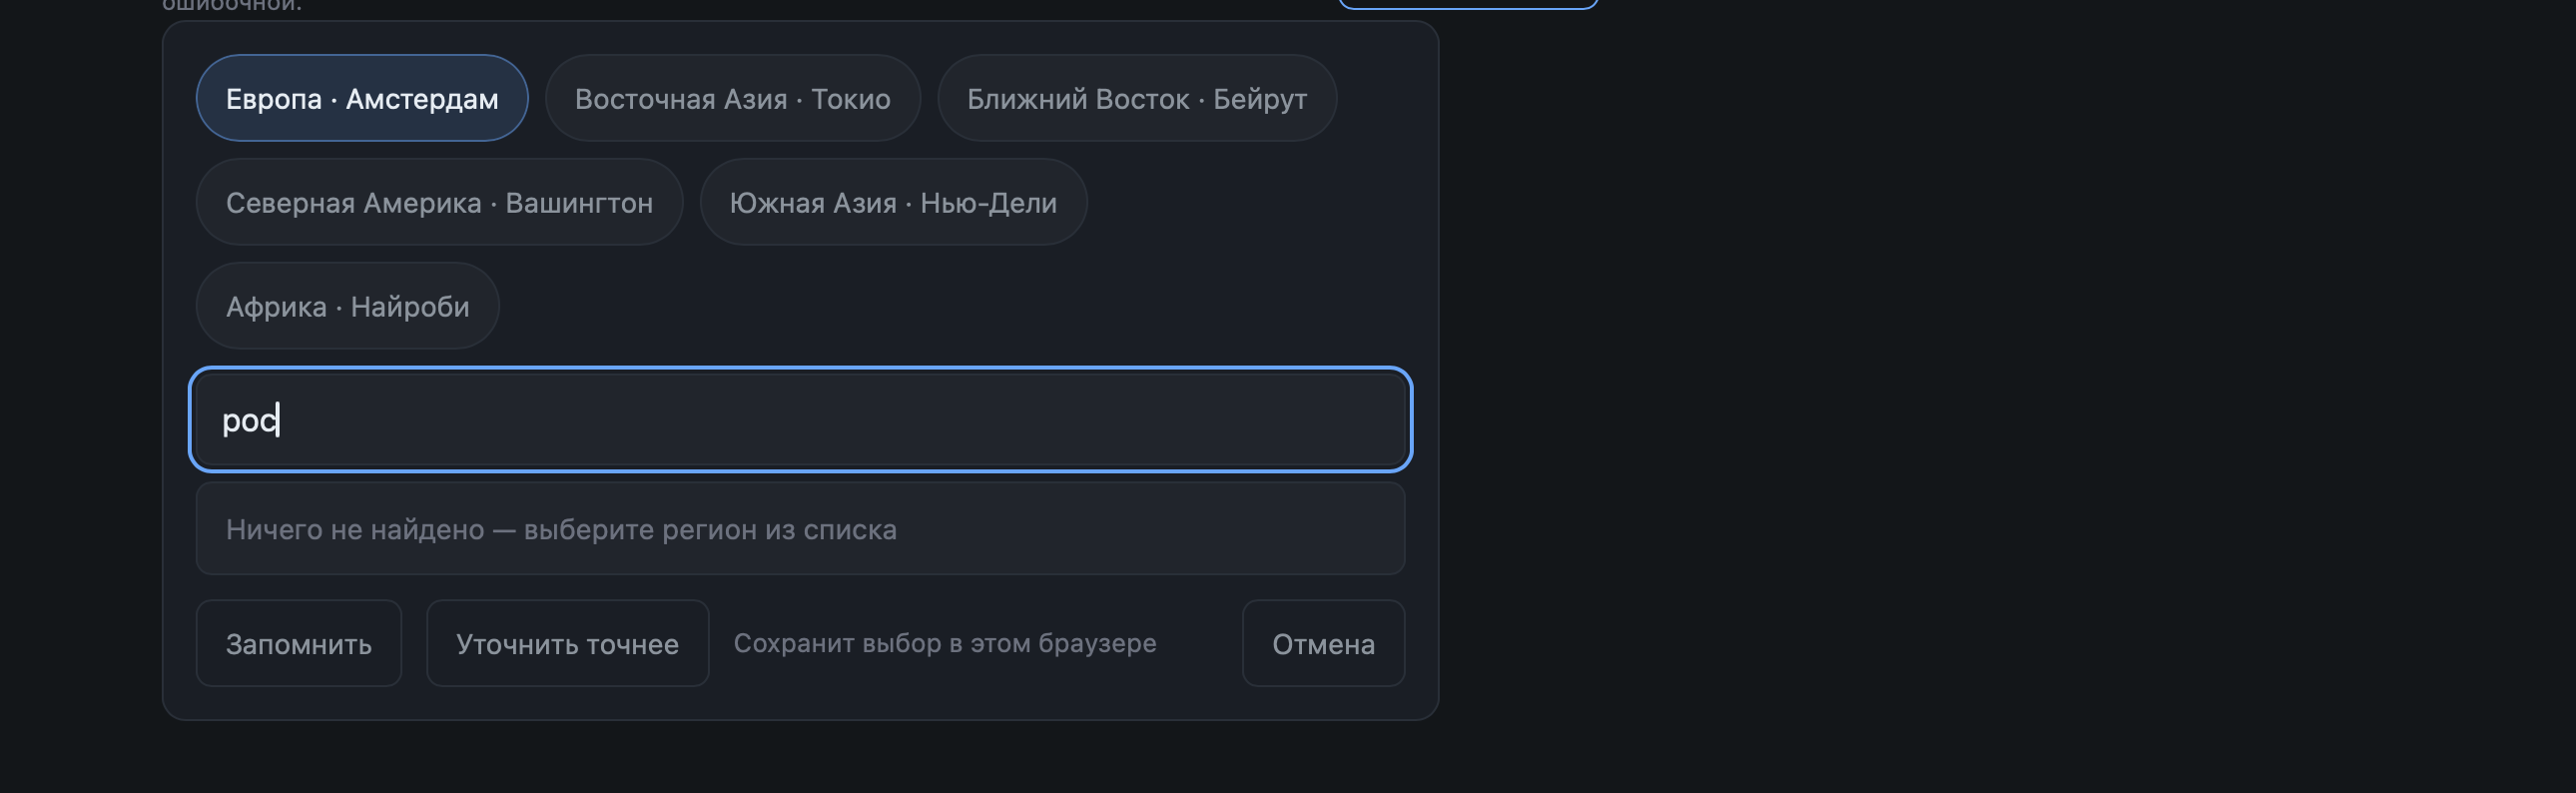
эмм, какие то проблемы с регионами?
вроде как справочник городов и стран прикрутить е=не так уж сложно..
а остальное реализовано на том же уровне?))MikhailZas Автор
16.10.2026 16:19Полноценный справочник конечно не сложно добавить. Ключевой нюанс: текущий индекс рассчитывается на уровне региона, а не страны или города. Конкретный город -это лишь способ выбрать свой регион.
МОй промах, фокус в первую очередь был на методологии, а не на списке городов/стран. Добавлю справочник, а то отсутствие искомого значения только недоверие и вопросы вызывает.
icon-of-sin
Типа ещё не пора заводить трактор? Ещё ж индекс не 255? )
icon-of-sin
Гулял год назад в парке по Бишкеку и подслушал разговор какого-то деда с внуками... по его мнению третья мировая уже тогда началась. Мощный дед, ещё до Ирана.
MikhailZas Автор
До 255 надо очень сильно постараться) — несмотря на то, что шкала от 0 до 100, да и кгонкретную дату индекс не покажет для запуска трактора. Как мне кажется, ценность в другом — не в точке, а в изменении, в динамике куда смещается риск от недели к неделе.
Если есть идеи как улучшить, с удовольствием выслушаю и дополню методологию. Спасибо
MikhailZas Автор
Пока я размышляю над практичной ценностью, нужны ли рекомендации или дополнительные какие-то меры и что делать, если анпример индекс повысится выше 75-80.