

После полевых испытаний карты проходимости, о которой шла речь в предыдущей статье, обнаружились баги: краши программы и проблемы визуализатора. Пока я их исправлял, на карте заметил странное поведение: на ровной поверхности периодически появлялись длинные цветные полосы, которые алгоритм интерпретировал как перепад высот.
Теоретически такой перепад мог возникнуть в трёх случаях:
Отсканированная поверхность действительно находится под наклоном.
В калибровке камеры есть ошибки, из-за чего сканы не стыкуются в одной плоскости.
Есть скачки одометрии.
Дорога на испытаниях действительно имела уклоны — квадроцикл легко катился под горку. Но главная причина оказалась в самой природе дискретной воксельной карты.
Почему воксели 10 см плохо дружат с уклонами
Воксель усредняет измерения и накапливает их внутри своего объёма. Пока наклон поверхности не превышает некоторый порог, карта хранит усреднённое значение. Как только порог пройден, происходит резкий скачок: поверхность на карте «подпрыгивает» на один куб вверх или вниз.
Для наземного робота это фундаментальная проблема. Воксель размером 10 см — это фактически куб 10×10×10 см. Такой куб ровер ещё может переехать на небольшой скорости. Но два куба подряд — это уже высота около половины радиуса колеса. Без достаточного разгона ровер просто отскочит от него.
В итоге планировщик получает всего три дискретных состояния:
ровно — можно ехать быстро;
неровно — нужно ехать медленно и аккуратно;
непроходимо — нужно объезжать.
На практике это сильно ограничивает планирование. Небольшие препятствия размером в один куб можно объехать или медленно переехать. Два куба в высоту уже разумно считать полностью непроходимыми: залетать на них на полном ходу — риск переворота и повреждения ровера.
Отдельный вопрос — наклонные поверхности. На них перепады почти неизбежны, потому что карта накапливает измерения внутри объёма вокселя и в какой-то момент делает резкий скачок на куб вверх или вниз. Если пытаться решить это только уменьшением размера вокселя, мы упираемся в другие ограничения.
Уменьшение разрешения с 10 см до 5 см и меньше даёт больше градаций: вместо трёх состояний появляется, условно, пять. Минимальный порог уклона становится 5 см, а всё, что выше, уже считается препятствием. Но плата за это велика:
карта требует в два раза больше памяти;
планировщик state lattice, взятый из ROS, увеличивает время планирования примерно в четыре раза;
уменьшается максимальный радиус поворота ровера, который и так ограничен 3,9 м при 24 направления движения.
Почему так? Примитивы state lattice должны точно сходиться в решётке генератора и их размер привязан к её сетке. Если уменьшить ячейку, они перестанут сходиться, генератор выдаст ошибку или уйдёт в бесконечный цикл. Поэтому для больших машин нужны большие ячейки на карте.
У гибридного A* таких жёстких ограничений нет: там можно задать любой радиус поворота даже на маленькой ячейке. Но платой становится резкий рост времени планирования, потому что в каждой ячейке раскрывается множество направлений движения, а не фиксированный набор примитивов. С увеличением числа ячеек количество направлений и время растёт в разы.
Получается, что уменьшение размера вокселя — палка о двух концах: с одной стороны, карта становится подробнее, с другой — растёт нагрузка на всю систему обхода препятствий.
Идея: хранить не занятость, а высоту
Более логичный путь — вспомнить, что воксельная карта в итоге конвертируется в карту высот. Кроме того, она стабилизирована в пространстве: её оси привязаны к системе координат земли и вектору гравитации.
Это значит, что мы можем увеличить разрешение карты до максимального, которое дают сенсоры не уменьшая размер сетки. Для этого нужно после перевода точек в систему координат карты записывать в ячейку не бинарное состояние 1/0, а точную высоту точки. Тогда карта перестанет быть дискретной по высоте и получит максимально возможное разрешение сенсора.
Для лидара заявленная точность — 1–2 см. Для RGB-D камеры точность зависит от расстояния: в пределах 1–1,5 м это около ±2 мм, на 5 м — уже ±10 см, дальше ещё хуже.
Если использовать сырые данные, как я делал раньше, рост разрешения проявит шум сенсора, в то-же время какие-то простые фильтры в движении на роботе не работают или не дают должного эффекта.
Тем не менее у новой карты есть и плюсы:
миллиметровое разрешение позволяет строить карту нормалей, нормали важны для моделей динамики MPPI и MPC: они позволяют точнее рассчитывать силы, действующие на колёса, учитывать подъёмы, спуски и влияние гравитации в момент их преодоления и всё такое;
проблема перепадов исчезает: небольшой уклон плавно размазывается по карте и тонет в шуме измерений;
оценка проходимости становится точнее и плавнее: робот может оценить реальную высоту препятствия и решить, объезжать его или переехать без лишнего снижения скорости.
Плюсы очевидно перевешивали минусы, и я приступил к очередному апгрейду карты.
Реализация: frustum, центроид и atomicMin
Первая проблема на пути от сенсора к карте — вокселизация. Мой старый код мне не нравился и раньше, но для грубой карты особых усложнений не требовалось. Если во внутренний объём вокселя попадала хотя бы одна точка, он считался занятым. Такой карте абсолютно всё равно какая это будет точка и потому она была иммунна к гонкам данных, все потоки писали одно и то же значение — 1.
__global__
void kernel_deproject_depth_cuda(uint16_t *ray_points, const rs2_intrinsics* intrin, const uint16_t * depth, float depth_scale, double w, double x, double y, double z)
{
    int i = blockDim.x * blockIdx.x + threadIdx.x;

    if (i >= (*intrin).height * (*intrin).width) {
        return;
    }

    int stride = blockDim.x * gridDim.x;
    int a, b;

    const float ww = w * w;
    const float xx = x * x;
    const float yy = y * y;
    const float zz = z * z;
    const float wx = w * x;
    const float wy = w * y;
    const float wz = w * z;
    const float xy = x * y;
    const float xz = x * z;
    const float yz = y * z;
    const float two = 2.0f;

    for (int j = i; j < (*intrin).height * (*intrin).width; j += stride) {
        b = j / (*intrin).width;
        a = j - b * (*intrin).width;
        const float pixel[] = { (float)a, (float)b };

        float point[3] = {0}; float point_s[3] = {0}; uint16_t points[3] = {0};

        deproject_pixel_to_point_cuda(point, intrin, pixel, depth_scale * depth[j]);

        point_s[0] = (Rotation_matrix[0] * point[0] + Rotation_matrix[3] * point[1] + Rotation_matrix[6] * point[2]);
        point_s[1] = (Rotation_matrix[1] * point[0] + Rotation_matrix[4] * point[1] + Rotation_matrix[7] * point[2]);
        point_s[2] = (Rotation_matrix[2] * point[0] + Rotation_matrix[5] * point[1] + Rotation_matrix[8] * point[2]);

        point_s[0] += Translation[0];
        point_s[1] += Translation[1];
        point_s[2] += Translation[2];

        point_s[0] *= Map_scale;
        point_s[1] *= Map_scale;
        point_s[2] *= Map_scale;

        points[0] = __float2int_rd(ww*point_s[0] + two*wy*point_s[2] - two*wz*point_s[1] + xx*point_s[0] + two*xy*point_s[1] + two*xz*point_s[2] - zz*point_s[0] - yy*point_s[0]) + Map_center_X;
        points[1] = __float2int_rd(two*xy*point_s[0] + yy*point_s[1] + two*yz*point_s[2] + two*wz*point_s[0] - zz*point_s[1] + ww*point_s[1] - two*wx*point_s[2] - xx*point_s[1]) + Map_center_Y;
        points[2] = __float2int_rd(two*xz*point_s[0] + two*yz*point_s[1] + zz*point_s[2] - two*wy*point_s[0] - yy*point_s[2] + two*wx*point_s[1] - xx*point_s[2] + ww*point_s[2]) + Map_center_Z;

        if((points[0] < Map_X) && (points[1] < Map_Y) && (points[2] < Map_Z) && (points[0] > 0) && (points[1] > 0) && (points[2] > 0)) {
            ray_points[j * 3] = points[0];
            ray_points[1 + j * 3] = points[1];
            ray_points[2 + j * 3] = points[2];
        }
        else {
            ray_points[j * 3] = 0;
            ray_points[1 + j * 3] = 0;
            ray_points[2 + j * 3] = 0;
        }
   }
}

__global__
void voxelization_cuda( uint8_t * voxels, const uint16_t * ray_points, const unsigned int counter)
{
    int i = blockDim.x * blockIdx.x + threadIdx.x;

    if (i >= counter) {
        return;
    }

    int stride = blockDim.x * gridDim.x;

    for (int j = i; j < counter; j += stride) {

        if((ray_points[j * 3] > 0) && (ray_points[1 + j * 3] > 0) && (ray_points[2 + j * 3] > 0)) {

            voxels[get_value(ray_points[j * 3], ray_points[1 + j * 3], ray_points[2 + j * 3])] = 1;
        }
    }
}
Теперь на вход идут данные о высоте точки. За один воксель могут конкурировать сотни пикселей: объём вокселя 10×10×10 см, а карта глубины имеет размер 848×480, то есть 407 040 точек при FOV камеры 90° по ширине и 58° по высоте.
Для сравнения: у лидара всего около 20 000 точек на 360° по ширине и 57° по высоте. Даже там LIO-пакеты используют вокселизацию или downsampling, не обрабатывая каждый раз все точки напрямую. Корреляторы на CPU этого не тянут и не укладываются в realtime.
Ещё одна проблема вокселизации на GPU — динамическая аллокация. Её не любят, потому что она снижает производительность и заставляет ядро в конце опрашивать всю память, чтобы собрать массивы по кусочкам. Чтобы избежать этого, я просто аллоцировал ray_points максимальным размером, который он мог принять: 407 040 точек.
Но в реальности столько не нужно: один пиксель далеко не всегда проецируется в отдельный воксель. Точный размер зависит от площади видимой поверхности. Чем она больше, тем по большему числу вокселей распределятся точки. На это влияют форма объектов и расстояние до них. Сложные формы увеличивают видимую площадь, а также дистанции, заставляет пиксели распредялятся по большей площади.
Как выбрать оптимальный размер ray_points, решить гонку данных и выбрать, высоту какого из сотен конкурирующих пикселей записать в ячейку?
Для этого я построил модель FOV камеры — frustum view. Это поле зрения камеры в виде усечённой пирамиды, расширяющейся в сторону взгляда. Если заполнить внутренний объём этой пирамиды вокселями 10×10×10 см, получим оптимальный размер массива ray_points.
Остаётся выбрать, какой пиксель туда запишется. Для каждого вокселя считается его геометрический центр — центроид. Затем выбирается точка, ближайшая к центроиду. Так в каждый воксель попадает высота только одного, самого близкого к центроиду пикселя. Это заодно частично фильтрует выбросы карты глубины: в пределах объёма одного вокселя выбирается наименее шумящая точка.
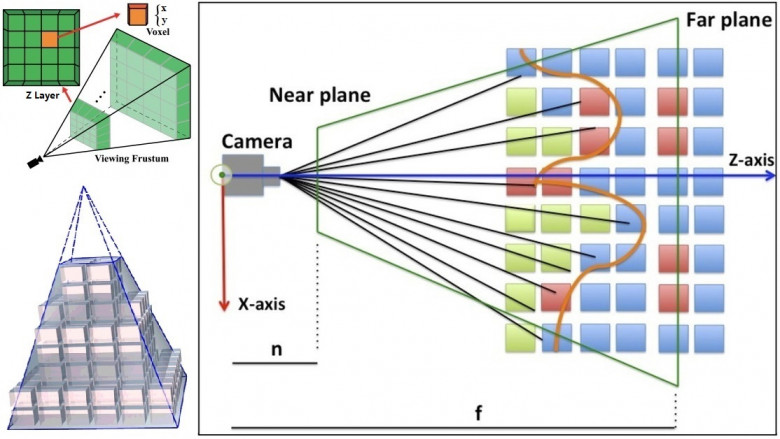
Чтобы избежать гонки данных, используются атомарные операции. Они дорогие, поэтому я сократил количество их вызовов: упаковал три координаты точки как младшие байты, а дистанцию — как старшие, чтобы сравнение шло в первую очередь по ней, в одну 64-битную переменную unsigned long long с помощью сдвигов. Это как раз четыре обычные 16-битные переменные.
__global__
void kernel_deproject_depth_cuda(unsigned long long *ray_points_cam,
                                 const rs2_intrinsics* intrin,
                                 const uint16_t * depth,
                                 float depth_scale)
{
    int i = blockDim.x * blockIdx.x + threadIdx.x;
    if (i >= (*intrin).height * (*intrin).width) return;
    int stride = blockDim.x * gridDim.x;

    for (int j = i; j < (*intrin).height * (*intrin).width; j += stride) {
        int b = j / (*intrin).width;
        int a = j - b * (*intrin).width;
        const float pixel[] = { (float)a, (float)b };

        float point[3] = {0};
        deproject_pixel_to_point_cuda(point, intrin, pixel, depth_scale * depth[j]);

        float xf = point[0] * 1000.0f;
        float yf = point[1] * 1000.0f;
        float zf = point[2] * 1000.0f;

        if (zf < c_cam_near_mm || zf >= c_cam_far_mm) continue;

        int iz = (int)((zf - c_cam_near_mm) / FRUSTUM_VOXEL_MM);
        if (iz < 0 || iz >= c_Nz) continue;

        float z_center = c_cam_near_mm + iz * FRUSTUM_VOXEL_MM + FRUSTUM_VOXEL_MM * 0.5f;
        float half_x = z_center * c_tan_half_h;
        float half_y = z_center * c_tan_half_v;

        if (xf < -half_x || xf >= half_x) continue;
        if (yf < -half_y || yf >= half_y) continue;

        int Nx = c_Nx_per_layer[iz];
        int Ny = c_Ny_per_layer[iz];

        int ix = (int)((xf + half_x) / FRUSTUM_VOXEL_MM);
        int iy = (int)((yf + half_y) / FRUSTUM_VOXEL_MM);
        if (ix < 0 || ix >= Nx) continue;
        if (iy < 0 || iy >= Ny) continue;

        int16_t x_mm = (int16_t)xf;
        int16_t y_mm = (int16_t)yf;
        int16_t z_mm = (int16_t)zf;

        // Центроид вокселя
        float cx = -half_x + (ix + 0.5f) * FRUSTUM_VOXEL_MM;
        float cy = -half_y + (iy + 0.5f) * FRUSTUM_VOXEL_MM;
        float cz = z_center;

        float dxn = xf - cx, dyn = yf - cy, dzn = zf - cz;
        uint32_t d_new = (uint32_t)(dxn*dxn + dyn*dyn + dzn*dzn);

        // Клампим dist² в 16 бит
        if (d_new > 0xFFFFu) d_new = 0xFFFFu;

        // Сдвигаем координаты в [0, 65535] (для беззнакового сравнения в atomicMin)
        uint64_t ux = (uint64_t)((int32_t)x_mm + 32768);
        uint64_t uy = (uint64_t)((int32_t)y_mm + 32768);
        uint64_t uz = (uint64_t)((int32_t)z_mm + 32768);

        // Упаковка: [63:48] dist² | [47:32] x | [31:16] y | [15:0] z
        unsigned long long packed = ((unsigned long long)d_new << 48)
                                  | ((unsigned long long)ux << 32)
                                  | ((unsigned long long)uy << 16)
                                  |  (unsigned long long)uz;

        uint32_t voxel_idx = get_value_frustum((uint16_t)iz, (uint16_t)iy, (uint16_t)ix);
        atomicMin(&ray_points_cam[voxel_idx], packed);
    }
}


__global__
void rotate_ray_points_to_world(const unsigned long long *ray_points_cam,
                                uint16_t *ray_points_world,
                                const unsigned int counter,
                                double w, double x, double y, double z)
{
    int i = blockDim.x * blockIdx.x + threadIdx.x;
    if (i >= counter) return;
    int stride = blockDim.x * gridDim.x;

    const float ww=w*w, xx=x*x, yy=y*y, zz=z*z;
    const float wx=w*x, wy=w*y, wz=w*z;
    const float xy=x*y, xz=x*z, yz=y*z;
    const float two = 2.0f;

    const unsigned long long MAX_PACKED = 0xFFFFFFFFFFFFFFFFULL;

       for (int j = i; j < counter; j += stride) {

       unsigned long long packed = ray_points_cam[j];

        // Если буфер не перезаписан — пусто
        if (packed == MAX_PACKED) {
            ray_points_world[j*3]     = 0;
            ray_points_world[1 + j*3] = 0;
            ray_points_world[2 + j*3] = 0;
            continue;
        }

        // Распаковка: [63:48] dist² | [47:32] x | [31:16] y | [15:0] z
        unsigned long long ux = (packed >> 32) & 0xFFFFULL;
        unsigned long long uy = (packed >> 16) & 0xFFFFULL;
        unsigned long long uz =  packed        & 0xFFFFULL;

        int16_t cx = (int16_t)((int32_t)ux - 32768);
        int16_t cy = (int16_t)((int32_t)uy - 32768);
        int16_t cz = (int16_t)((int32_t)uz - 32768);

        if (cz == 0) {
            ray_points_world[j*3]     = 0;
            ray_points_world[1 + j*3] = 0;
            ray_points_world[2 + j*3] = 0;
            continue;
        }

        // мм → м
        float px = cx * 0.001f;
        float py = cy * 0.001f;
        float pz = cz * 0.001f;

        // 1. Калибровка камеры
        float ps0 = Rotation_matrix[0]*px + Rotation_matrix[3]*py + Rotation_matrix[6]*pz;
        float ps1 = Rotation_matrix[1]*px + Rotation_matrix[4]*py + Rotation_matrix[7]*pz;
        float ps2 = Rotation_matrix[2]*px + Rotation_matrix[5]*py + Rotation_matrix[8]*pz;

        // 2. Offset камеры
        ps0 += Translation[0];
        ps1 += Translation[1];
        ps2 += Translation[2];

        // 3. Масштаб
        ps0 *= Map_scale;
        ps1 *= Map_scale;
        ps2 *= Map_scale;

        // 4. Поворот кватернионом
        float rs0 = ww*ps0 + two*wy*ps2 - two*wz*ps1 + xx*ps0 + two*xy*ps1 + two*xz*ps2 - zz*ps0 - yy*ps0;
        float rs1 = two*xy*ps0 + yy*ps1 + two*yz*ps2 + two*wz*ps0 - zz*ps1 + ww*ps1 - two*wx*ps2 - xx*ps1;
        float rs2 = two*xz*ps0 + two*yz*ps1 + zz*ps2 - two*wy*ps0 - yy*ps2 + two*wx*ps1 - xx*ps2 + ww*ps2;

        // 5. В индексы карты
        int imx = __float2int_rd(rs0 + Map_center_X);
        int imy = __float2int_rd(rs1 + Map_center_Y);
        int imz = __float2int_rd(rs2 + Map_center_Z);

        if (imx <= 0 || imx >= Map_X ||
            imy <= 0 || imy >= Map_Y ||
            imz <= 0 || imz >= Map_Z) {
            ray_points_world[j*3]     = 0;
            ray_points_world[1 + j*3] = 0;
            ray_points_world[2 + j*3] = 0;
            continue;
        }

        // 6. Y-высота в мировых мм
        float y_world_mm_f = (rs1 + (float)Map_center_Y) * 100.0f;
        int y_world_mm = __float2int_rd(y_world_mm_f);
        if (y_world_mm < 0) y_world_mm = 0;
        if (y_world_mm > Map_Y * 100 - 1) y_world_mm = Map_Y * 100 - 1;

        ray_points_world[j*3]     = (uint16_t)imx;
        ray_points_world[1 + j*3] = (uint16_t)(y_world_mm + 1);
        ray_points_world[2 + j*3] = (uint16_t)imz;
    }
}

__global__
void voxelization_cuda(uint16_t *voxels,
                       const uint16_t *ray_points_world,
                       const unsigned int counter)
{
    int i = blockDim.x * blockIdx.x + threadIdx.x;
    if (i >= counter) return;
    int stride = blockDim.x * gridDim.x;

    for (int j = i; j < counter; j += stride) {
        uint16_t imx   = ray_points_world[j*3];
        uint16_t y_mm1 = ray_points_world[1 + j*3];
        uint16_t imz   = ray_points_world[2 + j*3];
        if (y_mm1 == 0) continue;

        uint16_t iy = (uint16_t)((y_mm1 - 1) / 100);
        uint32_t idx = get_value(imx, iy, imz);
        voxels[idx] = y_mm1;
    }
}
Размер усечённой пирамиды вычисляется один раз на основе данных из SDK RealSense и параметров камеры, прошитых в её EEPROM при заводской калибровке.
// ============================================================================
// Frustum binning parameters
// ============================================================================
#define FRUSTUM_MAX_LAYERS 256

static const float CAM_NEAR_MM      = 500.0f;
static const float CAM_FAR_MM       = 5000.0f;
static const float FRUSTUM_VOXEL_MM = 100.0f;

__constant__ int   c_Nz;
__constant__ int   c_Nx_per_layer[FRUSTUM_MAX_LAYERS];
__constant__ int   c_Ny_per_layer[FRUSTUM_MAX_LAYERS];
__constant__ int   c_layer_offset[FRUSTUM_MAX_LAYERS];
__constant__ float c_tan_half_h;
__constant__ float c_tan_half_v;
__constant__ float c_cam_near_mm;
__constant__ float c_cam_far_mm;

extern "C" __host__
int init_frustum_cuda(const rs2_intrinsics &intrin)
{
    cudaError_t result;

    float fov[2];
    rs2_fov(&intrin, fov);   // градусы

    float fov_h_rad = fov[0] * (float)M_PI / 180.0f;
    float fov_v_rad = fov[1] * (float)M_PI / 180.0f;
    float tan_half_h = tanf(fov_h_rad / 2.0f);
    float tan_half_v = tanf(fov_v_rad / 2.0f);

    const float NEAR_MM = CAM_NEAR_MM;
    const float FAR_MM  = CAM_FAR_MM;
    const float VOX_MM  = FRUSTUM_VOXEL_MM;

    int Nz = (int)((FAR_MM - NEAR_MM) / VOX_MM);
    assert(Nz <= FRUSTUM_MAX_LAYERS && "frustum layers exceed FRUSTUM_MAX_LAYERS");

    int Nx_arr[FRUSTUM_MAX_LAYERS] = {0};
    int Ny_arr[FRUSTUM_MAX_LAYERS] = {0};
    int off_arr[FRUSTUM_MAX_LAYERS] = {0};

    int offset = 0;
    for (int iz = 0; iz < Nz; ++iz) {
        float z_center = NEAR_MM + iz * VOX_MM + VOX_MM * 0.5f;
        float half_x = z_center * tan_half_h;
        float half_y = z_center * tan_half_v;
        int Nx = (int)floorf(2.0f * half_x / VOX_MM);
        int Ny = (int)floorf(2.0f * half_y / VOX_MM);
        if (Nx < 1) Nx = 1;
        if (Ny < 1) Ny = 1;
        Nx_arr[iz] = Nx;
        Ny_arr[iz] = Ny;
        off_arr[iz] = offset;
        offset += Nx * Ny;
    }
    int total_voxels = offset;

    result = cudaMemcpyToSymbol(c_Nz, &Nz, sizeof(int)); assert(result == cudaSuccess);
    result = cudaMemcpyToSymbol(c_Nx_per_layer, Nx_arr, sizeof(int) * Nz); assert(result == cudaSuccess);
    result = cudaMemcpyToSymbol(c_Ny_per_layer, Ny_arr, sizeof(int) * Nz); assert(result == cudaSuccess);
    result = cudaMemcpyToSymbol(c_layer_offset, off_arr, sizeof(int) * Nz); assert(result == cudaSuccess);
    result = cudaMemcpyToSymbol(c_tan_half_h, &tan_half_h, sizeof(float)); assert(result == cudaSuccess);
    result = cudaMemcpyToSymbol(c_tan_half_v, &tan_half_v, sizeof(float)); assert(result == cudaSuccess);
    result = cudaMemcpyToSymbol(c_cam_near_mm, &NEAR_MM, sizeof(float)); assert(result == cudaSuccess);
    result = cudaMemcpyToSymbol(c_cam_far_mm, &FAR_MM, sizeof(float)); assert(result == cudaSuccess);

    std::cout << "[CUDA] init_frustum_cuda: Nz=" << Nz
              << " total_voxels=" << total_voxels
              << " fov_h=" << fov[0] << " fov_v=" << fov[1] << std::endl;

    return total_voxels;
}
Полные листинги, включая rotate_ray_points_to_world и финальную voxelization_cuda, лежат в репозитории.
Результаты: HD-карта и новая головная боль
После реализации можно перейти к тестам. Вот карта высот, построенная на основе дискретного воксельного представления:
А вот HD-карта высот с разрешением 1 мм. Меньше датчики всё равно не позволяют увидеть, так-что это и то с запасом:
Шума на карте действительно прибавилось. Если раньше на 2D-карте стоимости преобладали преимущественно ровные белые поверхности вокселей, то теперь карта постоянно мигает различными оттенками красного и синего.
Почему? Это минимальный уклон от 1 до 5 градусов по оценке уклонов на карте стоимости. Раньше в вокселях его не было видно, теперь он распределён равномерно по всей площади. Плюс шум глубины.
Если запустить штатный RealSense Viewer (что я и сделал в конце видео) и преобразовать глубину в облако точек, наложив текстуру от камеры, можно заметить, что асфальт идёт волнами и выглядит абсолютно кривым. Это шум глубины. На обычной 2D-цветной картинке с камеры его кривизны не видно (потому-что её нет, не на столько большой) — заметен только небольшой уклон.
Однако, решив проблему увеличения разрешения карты, сразу же получаю другую: скачки одометрии по высоте стали заметны ещё сильнее. В этой карте ось Y соответствует высоте, и скачки приводят к появлению на ровной поверхности непроходимых зон и артефактов с высокой стоимостью. Особенно хорошо это видно по краям frustum view: они теперь видны на карте как граница где часто обновляющиеся пиксели текущего скана соседствуют на фоне статичных пикселей карты.
Сам шум тоже не даёт ничего хорошего. С одной стороны, даже с ним видно более точную высоту препяствий т.к. шум обычно находится в примерно одном диапазоне случайного блуждания. С другой стороны, если оставить его как есть, планировщик будет совершать лишние манёвры, пытаясь объехать шум. Это неприемлемо.
Elevation Mapping cupy: готовое решение, но не для всех.
Решение обеих проблем — шума и скачков высоты — уже существует в готовом пакете Elevation Mapping cupy Он тоже работает на GPU, но написан не на CUDA, как можно догадаться а на CuPy — интерпретаторе, который переводит Python-код в CUDA-код для GPU.
В ключевых свойствах пакета указано:
компенсация дрейфа по высоте: устраняет ошибки оценки состояния, которые могут приводить к артефактам на карте;
очистка данных и удаление артефактов: raycasting и исключающие зоны позволяют убирать ложные артефакты и корректно интерпретировать нависающие препятствия;
фильтр проходимости на основе машинного обучения: оценивает проходимость с учётом локальной геометрии;
универсальные инструменты для перемещения: фильтры сглаживания и сегментация плоскостей;
Multi-Modal Elevation Map: интеграция геометрических, семантических и цветовых данных;
высокая производительность за счёт ускорения на GPU.
Некоторые из этих возможностей в моей карте уже есть: raycasting, удаление нависающих препятствий, GPU-ускорение. Но до остальных ещё далеко.
Можно было бы свернуть разработку и просто использовать Elevation Mapping cupy. Но есть проблемы.
Во-первых, Python-код пакета плохо интегрируется в мой C++/Qt-проект. ROS-разработчики сейчас, наверное, злорадствуют: у них ноды изолированы и могут запускать пакеты на разных языках. В случае с Qt придётся городить аналогичный механизм.
Во-вторых, пакет активно использует нейросети для сегментации изображения и расчёта карты проходимости. В отличие от моего пакета, где для расчёта уклонов использовался алгоритм МНК из Map-Conversion-3D-Voxel-Map-to-2D-Occupancy-Map, здесь применяется ML-фильтр проходимости.
В результате пакет не тянет на моей слабой видеокарте ровера — RTX 3050 Ti с 4 GB VRAM. Ему нужно минимум 6 GB VRAM, и рекомендуется RTX 4060. Это плохо, если мы хотим строить только лишь одну конкретную карту. Вот к чему приводит Python плюс нейросети.
А ведь ресурсы GPU неплохо было бы приберечь на будущее и для других задач, не этого конкретного но абстратного GPU будущего: для моделей распознавания, возможно, VLA или физического ИИ, который будет управлять роботом через планеры и низкоуровневые контроллеры. В конце концов, тот же MPPI у меня планировался на GPU. Но места на нём становится всё меньше. Если сейчас я стараюсь писать CUDA-код, чтобы хоть чем-то полезным занять GPU помимо визуализации, то в будущем его ресурсы вполне могут стать дефицитом.
Что дальше
Чтобы не бросать свой проект карты — он даёт полный контроль над разработкой и понимание всех процессов — и не втягиваться в гонку по апгрейду железа, я попробую взять только самое важное что-бы сделать карту более экономной по потреблению ресурсов GPU.
Планирую позаимствовать некоторые полезные решения из Elevation Mapping cupy:
одномерный фильтр Калмана для фильтрации шума;
компенсацию дрейфа и скачков по высоте;
заполнение пустот карты.
Поскольку я не знаю даже обычный Python, а тем более CuPy, полагаться в этом буду на LLM и нейросети: они помогут перевести код с CuPy на CUDA, после чего буду проверять ИИ код и дорабатывать им свою карту. В крайнем случае, если не получится, придётся просто купить больше NVIDIA, чтобы запускать Elevation Mapping cupy, где всё это уже сделано и работает на GPU.
Выводы
Дискретная воксельная карта с фиксированным разрешением — ограниченный инструмент. На уклонах она создаёт ложные перепады высот и загоняет планировщик в три жёстких состояния: ровно, неровно, непроходимо.
Переход к HD-карте высот с хранением точной высоты в ячейке даёт больше информации: появляются нормали, точнее оценивается проходимость, появляется возможность плавно учитывать уклоны. Но вместе с разрешением обнажаются шум сенсора и скачки одометрии по высоте.
Следующий шаг — фильтрация, компенсация дрейфа и заполнение пустот. Если получится сделать это на CUDA без нейросетей и Python-зависимостей, карта останется лёгкой и при этом станет заметно точнее.