

Управление GPU в Kubernetes переросло стадию, когда было достаточно простого проброса устройства в контейнер. Сегодня инфраструктура для ИИ-нагрузок требует такой же гибкости, как и для стандартных микросервисов: мы должны уметь делить ресурсы, масштабировать их и эффективно утилизировать каждый терафлопс, не переплачивая за простаивающее «железо».
В нашей предыдущей статье мы разбирали базовые подходы к интеграции GPU в Kubernetes: от резервирования видеокарт целиком до использования Time-Slicing и профилей MIG. Команда платформы dBrain.cloud прошла через множество итераций оптимизации этой инфраструктуры. На практике мы столкнулись с тем, что стандартные средства (в частности, NVIDIA Device Plugin) зачастую навязывают жесткие ограничения. Это вынуждает выбирать либо между низкой эффективностью из-за простоя оборудования, либо сложностью конфигурации при попытках плотной упаковки ресурсов.
Когда в одном кластере соседствуют задачи разных типов — от тяжелого обучения моделей до запуска легких сервисов — администратору требуется инструмент для более гибкого управления. Мы искали решение, которое позволило бы управлять ускорителями с той же степенью свободы, как мы привыкли работать с CPU или оперативной памятью. Этим решением стал HAMi (Heterogeneous Accelerator Middleware). Технически это дополнительный слой-шедулер, который встраивается между драйвером GPU и рабочей нагрузкой.
Принцип работы HAMi заключается в перехвате API-вызовов, исходящих из контейнера. Middleware подменяет их своими обертками и транслирует запросы непосредственно в драйвер. Это позволяет управлять ресурсами видеокарты не через жестко заданные профили, а через динамическое распределение мощностей. На схеме видно, как middleware убирает фрагментацию ресурсов, позволяя «упаковывать» больше задач на одном физическом узле без потери производительности.
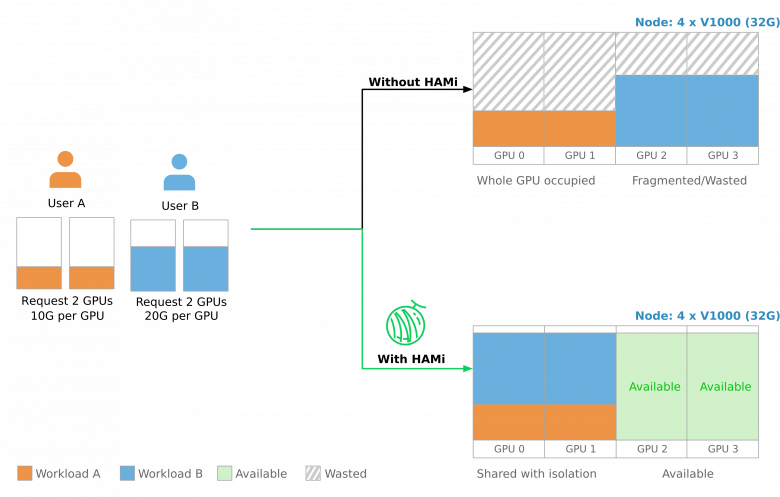
Это означает, что GPU теперь становится полноценным ресурсом, который можно «нарезать» на произвольные сегменты. В отличие от MIG, где вы ограничены фиксированными профилями, HAMi позволяет задавать лимиты по памяти и вычислительной мощности в соответствии с текущими нуждами задачи. Это дает возможность полноценной параллельной работы нескольких процессов на одной карте с корректной изоляцией, что ранее было крайне сложно реализовать при использовании обычного Time-Slicing.
Эксплуатация GPU-пулов
Использование HAMi дает нам возможность работать с GPU на нескольких уровнях абстракции. Мы можем презентовать конкретные видеокарты подам на одной физической ноде, сегментировать их для запуска нескольких задач или объединять ресурсы внутри хоста. Важно, что для администратора кластера этот процесс нивелируется до стандартных манифестов Kubernetes: мы используем привычные requests и limits, а планировщик HAMi самостоятельно определяет возможность размещения нагрузки с учетом реального состояния кластера.
Особый интерес представляет работа с большими языковыми моделями (LLM). Здесь важно разделять зоны ответственности: HAMi обеспечивает инфраструктурную гибкость внутри узла, но для распределенных вычислений на нескольких серверах мы полагаемся на специфику фреймворков, таких как Kubeflow, которые мы предоставляем пользователям «из коробки». При наличии высокоскоростной сети между узлами такие движки эффективно делят слои модели. Наша задача как инженеров — обеспечить среду, где эти ресурсы легко выделяются и масштабируются.
Такой подход решает классические конфликты в инфраструктуре. Раньше, при попытках комбинировать различные плагины, мы сталкивались со сложностями в изоляции и непредсказуемым поведением нагрузки. HAMi устраняет эту неопределенность: его собственный шедулер анализирует актуальные данные о занятости GPU. Это избавляет команду эксплуатации от необходимости ручного контроля, позволяя системе автоматически определять, можно ли разместить новый под на текущей ноде, основываясь на свободных мощностях.
Мы видим, что это актуально для широкого круга заказчиков: от IT-провайдеров, которым нужно предоставлять изолированные ресурсы разным клиентам, до банковских систем и e-commerce, работающих с высокой интенсивностью ML-сервисов. Мы уходим от модели «одна задача — одна видеокарта», которая для большинства современных проектов является экономически неоправданной, в пользу динамического GPU-шеринга. Мы можем реализовать сценарии, где одна физическая нода с несколькими GPU превращается в гибкий пул, который эффективно делится между проектами.
dBrain Console: визуализация и управление GPU-ресурсами
Мы убеждены, что современные инфраструктурные технологии должны быть доступны не только через ручное редактирование YAML-манифестов. Сложные GPU-конфигурации требуют визуализации, поэтому мы интегрировали управление ресурсами непосредственно в интерфейс dBrain Console (напомним, это панель управления платформой контейнеризации). Наша цель — дать администратору возможность контролировать кластер, не погружаясь в низкоуровневые настройки при каждой итерации, сохраняя при этом полный контроль над инфраструктурой.
Сейчас в консоли реализованы базовые операции, закрывающие большинство потребностей при эксплуатации GPU:
Мониторинг GPU-нод и нагрузок: в списках Nodes и Pods — колонка GPU с графиком потребления (тот же паттерн, что CPU и Memory); фильтр нод с доступной емкостью; на карточке ноды — GPU capacity и usage (емкость, allocated, доля). На контейнере потребление GPU видно рядом с CPU и памятью.
Выделение GPU существующему workload: на карточке Deployment, StatefulSet или DaemonSet — вкладка GPU. Нет ресурсов — Allocate; ресурсы уже есть — просмотр и Edit. Пользователь задает число GPU-/vGPU-слотов (nvidia.com/gpu); если кластер работает в режиме HAMi — опционально память и долю ядер. Планировщик платформы сам сажает поды на GPU-ноду: жесткой привязки к серверу из консоли нет.
Прозрачность утилизации: фактическое потребление берется из мониторинга, а не только из requests в шаблоне. Это дает оценку загрузки оборудования по тем же экранам, где уже смотрят CPU и RAM.
Мы продолжаем развивать функционал консоли dBrain.cloud, чтобы работа с GPU стала такой же рутинной задачей, как изменение лимитов CPU или оперативной памяти для обычного микросервиса. Это значительно ускоряет развертывание ML-проектов и повышает общую прозрачность управления инфраструктурой. Наша задача — сделать так, чтобы все преимущества HAMi (от динамического слайсинга до полноценной изоляции) были доступны пользователю в несколько кликов.
Использование HAMi в сочетании с доработками в dBrain Console — это логичный шаг в сторону более зрелой нфраструктуры. Мы ушли от модели «одна задача — одна видеокарта» к динамическому шерингу, что позволяет нашим заказчикам извлекать максимум из инвестиций в аппаратное обеспечение. Но мы продолжаем развивать наши инструменты, опираясь на реальные кейсы использования и требования индустрии.
Нам интересно узнать ваш опыт работы с GPU-шерингом в Kubernetes. Сталкивались ли вы с проблемами изоляции процессов при использовании стандартных плагинов? Какие подходы к распределению ресурсов вы считаете наиболее эффективными в условиях жестких требований к производительности? Делитесь своими примерами в комментариях.