

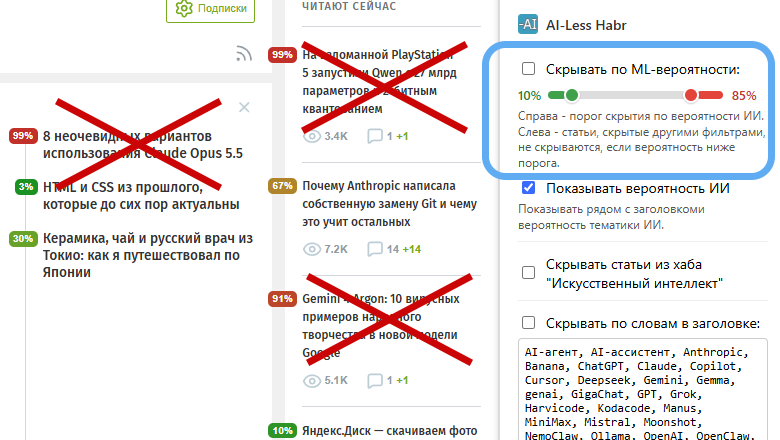
Несколько месяцев назад я выложил расширение AI‑Less Habr, скрывающее на Хабре нескончаемые статьи про ИИ бенчмарки и тому подобное (см. пост: Расширение AI‑Less Habr — Чистим Хабр от ИИ). Оно достаточно хорошо работало, но был существенный недостаток: оно полагалось на добросовестность авторов и модераторов (простите). В реальности скрыть хаб «Искусственный интеллект» недостаточно, так как очень часто он не указывается там, где должен. А дополнительный фильтр по словам довольно несовершенен. С другой стороны, ложноположительные срабатывания были довольно частым явлением, а обижать такие статьи тоже очень не хотелось.
Уже тогда была идея отдать определение тематики ИИ на откуп какой‑то модельке. И вот дошли руки это сделать, и оно даже работает и доступно всем желающим: Chrome Web Store, GitHub.
В этой статье расскажу о нюансах реализации, а ваша задача меня поругать, так как это мой первый опыт с ML, а значит явно многое можно сделать лучше.
Забавно, что те счастливчики‑хабровчане, которые уже пользуются расширением, скорее всего не увидят эту статью в ленте, так как расширение ее скроет.
Выбор реализации
До этого я вообще никогда не занимался ML, и из общих соображений рассматривал такие варианты реализации:
Поднять готовую локальную модель у себя на сервере, и гонять заголовки/тексты через API;
Встроить в расширение готовую компактную модель;
Использовать встроенный ai в chrome;
Обучить свою модель.
Коротко о выборе среди этих кандидатов:
Модель на сервере + API.
Было бы интересно и качественно (можно поднять хорошую готовую модель), но смущало, что пользователям может не понравиться передача их данных о просмотрах на сторонний сервер.Готовая компактная модель.
Казалось, что более‑менее подходящие модели или слишком тяжелые, или медленные, или некачественные, поэтому этот вариант отмел. Хотя в дальнейшем всё‑таки протестировал rubert‑tiny2 и в целом этот вариант можно было бы использовать, хотя есть нюансы (например, больше оперативной памяти на вкладку).Встроенный ai в chrome.
Тут мы ограничиваем пользователей строго браузером chrome и флагами настроек, а ведь кто‑то пользуется совместимыми браузерами (opera, vivaldi…), где нет встроенного ai.Обучить свою модель.
Никогда такого не делал, но в эпоху вайбкодинга это должно быть быстро, а если получится, то существенных недостатков быть не должно. Останавливаемся на этом варианте.
Первая модель и первые выводы
Итак, пробуем делать свою модель на классическом ML. Архитектура и вообще вся разработка была через GLM-5.3 (иногда сверялся с Gemini), так что процесс не особо интересен.
Немного архитектурных деталей
Модель на TF‑IDF‑признаках на n‑граммах (по словам и по символам) + логистическая регрессия + калибровка температуры. Анализируются: заголовок, хабы, теги и начало статьи. Для изначальной разметки был собран датасет из ~5000 статей из разных лент и хабов. Изначальные оценки вероятности ИИ тематики ставились полноценной GLM-5.3 (сначала бинарные 0/1, но я перевел на произвольные значения вероятности). На этих оценках тренировалась ML‑модель, разбивая тексты на n‑граммы по n символов/слов. GLM выбрал для сравнения такие варианты:
"base": {"word_ngrams": (1, 2), "char_ngrams": (3, 5)},
"wide": {"word_ngrams": (1, 3), "char_ngrams": (2, 5)},
В скобках минимальное/максимальное число n в n‑граммах. То есть, например, в модели base от 1 до двух слов в словосочетаниях и от 3 до 5 символов в буквосочетаниях. Всегда побеждала модель wide, что казалось логичным.
На выходе получаем 5 MB модель в.js (1.5 MB в сжатом виде), которая весьма неплохо справляется с задачей. Настолько неплохо, что я уже тогда решил, что включу этот фильтр по умолчанию.
Метрики первой модели wide (train 4 487 + holdout 919 = 5 406 статей):
Признаков |
AUC (holdout) |
Brier |
prec / recall / FPR @0.50 |
prec / recall / FPR @0.75 |
prec / recall / FPR @0.85 |
|---|---|---|---|---|---|
127 958 |
0.9741 |
0.0608 |
0.9415 / 86.8% / 3.65% |
0.9745 / 72.2% / 1.28% |
0.9915 / 63.1% / 0.36% |
Метрики в таблицах здесь и далее:
train— статьи, на которых модель тренировалась (~83% от датасета).holdout— статьи, которые модель не видела в тренировке (~17% от датасета).Признаков— количество элементов в словаре моделиAUC (holdout)— вероятность, что случайная ИИ‑статья получит от модели более высокий балл, чем случайная обычная. Считается на holdout. 1.0 — идеально, 0.5 — случайно.brier— среднеквадратичная погрешность предсказания вероятности. Иными словами, насколько проценты ползунка показывают реальный процент. Чем ближе к нулю, тем точнее.prec(precision) — точность: какая доля скрытых статей действительно про ИИ.recall— доля ИИ‑статей, которые фильтр нашел.FPR— False‑Positive‑Rate, доля статей не про ИИ, которые модель спрятала по ошибке.@0.50..@0.85— порог вероятности оценки модели (ползунка вероятности в расширении).
Оптимизация файла модели
Всё хорошо, но 5 MB... Мелочь, но для меня 5 MB для ~5000 статей интуитивно казалось многовато. Посмотрел файл модели, попинал GLM, и по итогу для уменьшения веса модели сделано:
Массив весов изначально хранился компактно в base64, но перевел веса с float64 во float32 (изначально GLM сделала суперизбыточный float64, что на мой взгляд очень странно, учитывая, что сейчас чуть ли не int4 используют много где).
Дополнительно занулил 13 бит мантиссы в float32 весах, чтобы архив весил меньше. float32 всё равно на мой взгляд слишком много, а так получается точность float16. Здесь меня обманула GLM, сказав, что поддержка родного Float16Array слишком свежая для ее использования — я удивился, но поверил (а зря — поддержка Float16Array есть с апреля 2025, что я проверил уже после релиза).
Убрана JSON‑обёртка словаря. В файле был массив значений вида
"w:openai anthropic","w:openai api",...— кавычки, запятые и вот это вот всё json‑овское — это лишние байты на каждое значение словаря, коих тогда было ~130 k. Делаем вместо json одну сплошную строку со \n‑разделителем. Это еще и парсится быстрее, чем json.Еще GLM подсказала идею front‑coding: кодируем каждую запись, как длина_общего_префикса + хвост. Например:
слово,слон→0:слово,3:н(первый элемент —слово, второй — 3 буквы отслово=сло+н=слон)
По итогу этих оптимизаций файл модели из 5.2 MB (1.5 MB в zip) стал весить 2.5 MB (730 kB в zip) — выигрыш в 2 раза.
ℹ️ Уже после выкладки текущей версии расширения в стор, из front‑coding убрано двоеточие, а число общих символов стало кодироваться одним символом — файлы моделей уменьшились еще на 10%.
Ищем оптимальные параметры модели
Подбираем диапазон длин n‑грамм
Раз модель wide всегда побеждает base, пришла идея протестировать варианты еще шире (более длинные n‑граммы символов и слов).
ℹ️ Здесь и далее будем использовать короткую запись параметров/названий моделей:
w1-3_c2-5вместо{"word_ngrams": (1, 3), "char_ngrams": (2, 5)}.
Были протестированы сочетания вплоть до w1-5_c2-7, но это не дало бонусов, становилось только хуже. Странно, что мы так сразу угадали оптимум, что и короткий base хуже, и более длинные варианты хуже... Смотрим внимательнее и замечаем, что wide в плане char_ngrams шире не в сторону увеличения длины, а в сторону уменьшения: wide — это w1-3_c2-5, а base был w1-2_c3-5, а комбинированные варианты не проверялись. Может дело в нижнем пороге c2? И проверка вариантов w1-2_c2-5 и w1-2_c2-4 это подтвердила — w1-2_c2-4 лучше по всем метрикам!
Теперь идем дальше и проверяем все короткие варианты. И внезапно лучшей оказалась модель w1-2_c2-2, то есть сочетания слов от 1 до 2, а n‑граммы символов всегда всего лишь двухсимвольные. Это можно объяснить тем, что при нескольких длинах n‑грамм получается слишком большое число вариантов, и мы получаем много шума, среди которого труднее выделить полезный сигнал. Хотя модели w1-3_c2-2, w1-2_c2-3 тоже оказались неплохи, так что они остаются в тестах, как и изначальный локальный оптимум w1-3_c2-5 (wide) для ориентира. Бонусом w1-2_c2-2 получается еще и самой компактной. К этому моменту на подросшем до 7 000 статей датасете она занимала 1.3 MB в сыром.js (еще в два раза меньше, чем модель wide после оптимизаций формата, плюс лучше по основным метрикам).
lead_max_chars=300
При изначальной разработке сразу было заложено брать для анализа только первые 300 символов статьи, ведь основная тема озвучивается вначале, и нет смысла добавлять весь текст — это будет лишний шум для модели. Тут ничего интересного — мы сразу угадали оптимальное значение 300. Проверялось как на изначальном датасете, так и на значительно возросшем к моменту релиза (проверено от 100 до 600).
“min_df”: 2?
Далее, разбираемся, что за константа "min_df": 2, которую GLM передает во все тренируемые модели. minimum document frequency — минимальное число статей, в которых должна встретиться n‑грамма, чтобы попасть в словарь. То есть при значении 2, если сочетание встречается только в одной статье — игнорируем, если в 2 и больше — добавляем в словарь. Пробуем значения больше 2. Появился скрытый чемпион w1-2_c2-2_df3 (w1-2_c2-2 с "min_df": 3) — от 4 и выше портятся метрики, а для 3 метрики снизились очень незначительно, но зато словарь еще в 2 раза меньше. Оставляем варианты с 3 и 4 для дальнейших тестов, ведь в планах расширение датасета, а там большее значение может оказаться более разумным выбором даже в плане качества, не говоря уж о размере модели.
Расширяем датасет
Компактность моделей теперь более чем устраивает, можно значительно расширить датасет. Собираем некоторые хабы за весь 2 026 год — теперь в датасете более 22 тыс. статей (~3800 holdout).
На этом датасете df3 и df4 модели выходят в лидеры и очень близки по метрикам — по разным критериям можно выбрать любую из них. Для релиза выбираем просто по размеру w1-2_c2-2_df4 как самую компактную из лидеров по качеству.
Метрики некоторых текущих моделей в тестах:
Модель |
Признаков |
Размер, МБ |
AUC (holdout) |
Brier |
Precision @0.85 |
Recall @0.85 |
FPR @0.85 |
|---|---|---|---|---|---|---|---|
w1-2_c2-2_df4 * |
54 594 |
1.0 |
0.9898 |
0.0427 |
0.9937 |
73.3% |
0.47% |
w1-2_c2-2_df3 |
79 111 |
1.5 |
0.9899 |
0.0428 |
0.9951 |
73.1% |
0.37% |
w1-2_c2-2 |
160 090 |
3.2 |
0.9895 |
0.0443 |
0.9950 |
71.5% |
0.37% |
w1-3_c2-5_df4 |
135 458 |
2.2 |
0.9871 |
0.0472 |
0.9943 |
71.9% |
0.42% |
w1-3_c2-5 * |
345 372 |
6.3 |
0.9871 |
0.0474 |
0.9958 |
72.3% |
0.32% |
* w1-2_c2-2_df4 — текущий релиз;
* w1-3_c2-5 — изначально выбранная wide, но обученная на полном датасете.
Динамика размера моделей в зависимости от объема датасета:
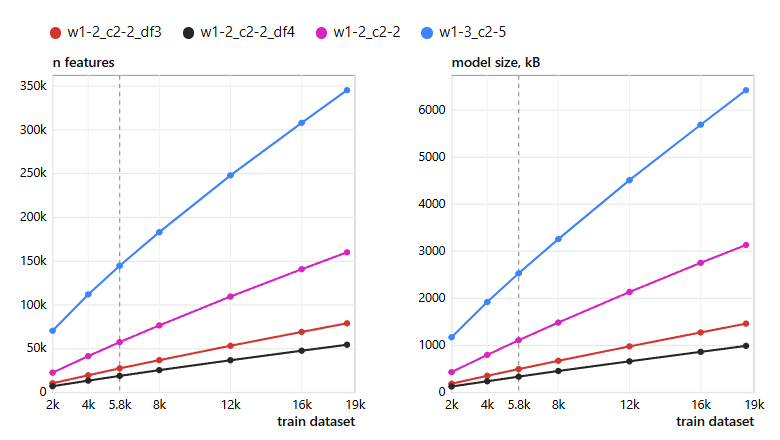
*Отметим, что если бы мы оставили исходный формат хранения (до оптимизаций) и исходную модель wide (но обученную на новом датасете), то она была бы хуже по общим метрикам, а весила бы в 15 раз больше, чем релиз.
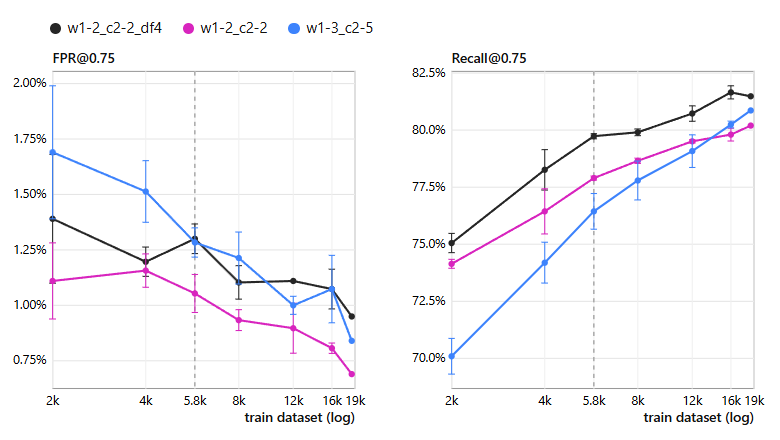
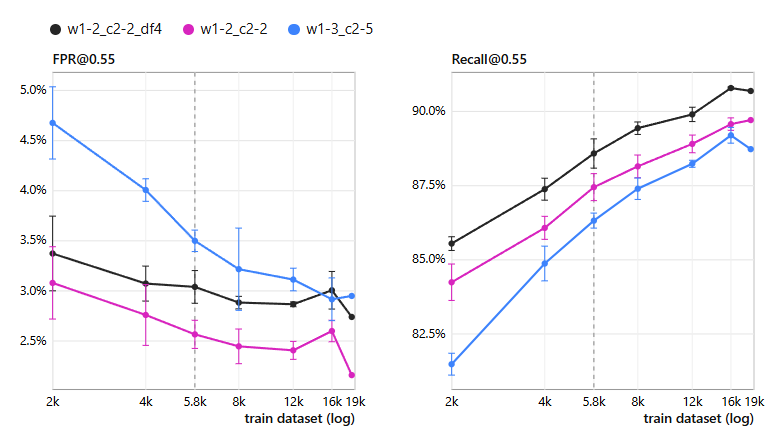
Кривая обучения на разном объеме train статей
Проводим симуляции, тренируя модели на подмножествах train статей разного объема, чтобы оценить динамику:
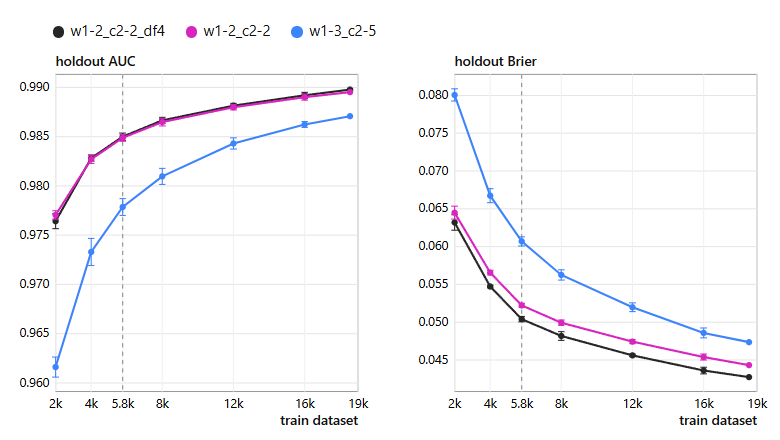
Как видим «короткие» модели близки, а w1-3_c2-5 заметно отстает. С ростом датасета все модели улучшаются, предел еще не достигнут.
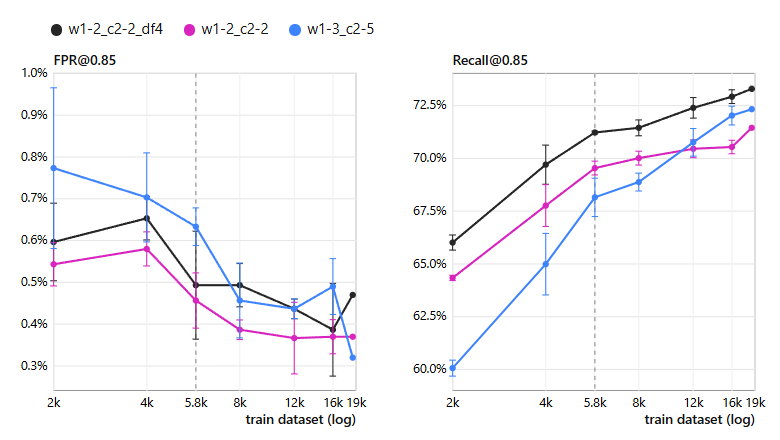
Для особо интересующихся, дополнительные графики полноты и false‑positive для разных значений вероятности:
Графики полноты (recall) и false‑positive
Вероятность @85%
Вероятность @75%
Вероятность @55%
Зачем это всё?
А теперь главное про обновление расширения. Сравним со старым поведением до ML фильтра: скрытием по хабу «Искусственный интеллект» и плюс по словам в заголовках и тегам.
Метрики на holdout (3840 статей, 1 944 ИИ):
Модель |
AUC (holdout) |
Brier |
Precision |
Recall |
FPR |
|---|---|---|---|---|---|
Хаб ИИ |
0.8880 |
0.1117 |
0.8756 |
90.8% |
13.24% |
Хаб + теги + слова |
0.8996 |
0.1000 |
0.8757 |
93.5% |
13.61% |
ML w1-2_c2-2_df4 @0.50 |
0.9898 |
0.0427 |
0.9646 |
92.4% |
3.48% |
ML w1-2_c2-2_df4 @0.55 |
0.9898 |
0.0427 |
0.9713 |
90.7% |
2.74% |
ML w1-2_c2-2_df4 @0.85 |
0.9898 |
0.0427 |
0.9937 |
73.3% |
0.47% |
Видим, что общие метрики качества старого метода сильно уступают ML модели. И что выбранный по умолчанию порог 0.85 очень консервативен по сравнению со старым поведением, когда скрытие по хабу скрывало ~90% ИИ статей. Но такой порог ML‑фильтра по умолчанию выбран, чтобы минимизировать число ложноположительных срабатываний (FPR). Было более 13%, теперь менее 0.5%, то есть скрываем в 25–30 раз меньше статей не про ИИ! При желании вы можете выкрутить ползунок ближе к 50–55%, и доля скрытых статей станет примерно как при старом поведении расширения, а ложноположительных срабатываний в разы меньше.
Посмотрим на это на графике зависимости полноты (recall) от false‑positive:
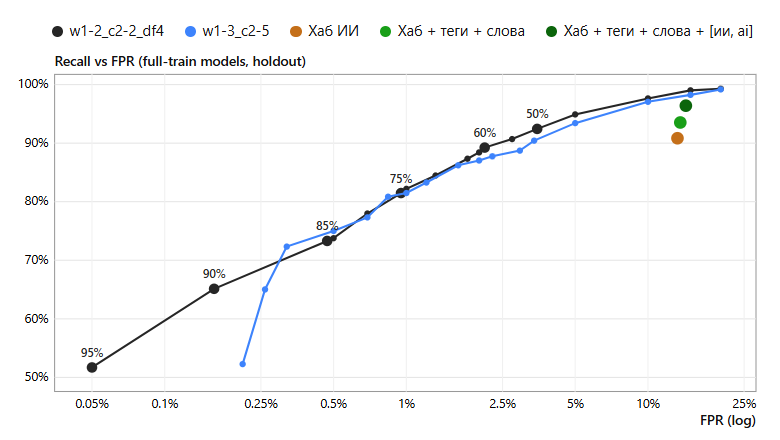
ℹ️ На графике выделены точки 50%..95% — значения ползунка вероятности в расширении, соответствующие этим параметрам.
Чем выше или/и левее линия, тем лучше (больше правильных скрытий, меньше ложных срабатываний). Точки старых настроек сильно выбиваются в худшую сторону, и наглядно видно, что ML моделью можно сделать лучше и по правильным скрытиям, и по ложным срабатываниям, причем одновременно.
Но этот тест на самом деле несколько искажен, так как для датасета целенаправленно собиралось много хабов, в которых значительная доля статей про ИИ, и в итоге половина датасета — ИИ‑статьи. Взглянем на результаты, если исключить хаб ИИ из выборки.
Срез holdout без хаба ИИ (1823 статьи, 178 ИИ):
Модель |
AUC (holdout) |
Brier |
Precision |
Recall |
FPR |
|---|---|---|---|---|---|
Хаб ИИ |
— |
— |
— |
0.0% |
— |
Хаб + теги + слова |
0.6439 |
0.0730 |
0.8814 |
29.2% |
0.43% |
ML w1-2_c2-2_df4 @0.50 |
0.9843 |
0.0248 |
0.9420 |
73.0% |
0.49% |
ML w1-2_c2-2_df4 @0.55 |
0.9843 |
0.0248 |
0.9474 |
70.8% |
0.43% |
ML w1-2_c2-2_df4 @0.85 |
0.9843 |
0.0248 |
0.9759 |
45.5% |
0.12% |
Старое расширение тут почти беспомощно: даже если поставить все галочки, то скрывается всего 29% нужного (благо false‑positive всего 0.43%), а ML модель даже на пороге 85% скрывает больше: 45% (а при том же 0.43% false‑positive — больше 70%).
Наглядно:
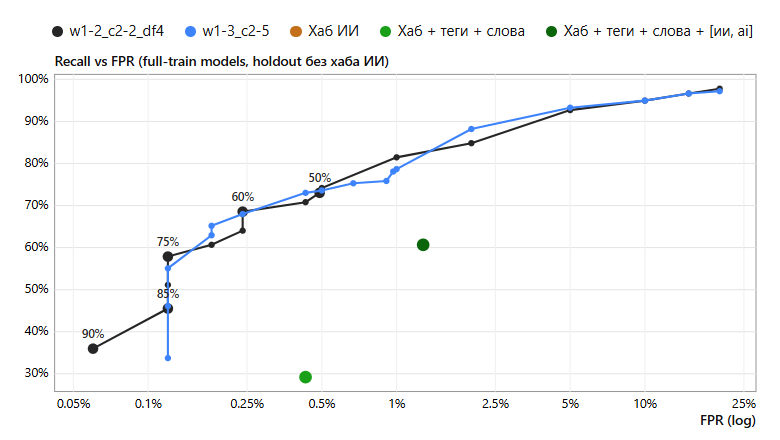
Думаю для большинства истина где‑то посередине, и оптимальный порог ползунка находится между 55% и 85%.
Право вето
В расширении есть возможность не скрывать статью, если она попадает под другие фильтры, но по ML вероятность низкая (право вето). Вы можете продолжать использовать старые фильтры, но настроить, чтобы при низкой ML вероятности статья всё равно показывалась (защита от ложноположительных срабатываний). Даже дефолтный порог 15% позволяет значительно снизить число ложноположительных срабатываний от фильтра по хабу ИИ, а можно поднять порог выше.
Особенности релиза
В расширении теперь есть возможность настраивать порог ML вероятности, от которого скрывать статью — включено по умолчанию со значением 85%.
Также есть возможность показывать статью при низкой ML вероятности, даже если статья должна скрываться по признакам других фильтров — включено по умолчанию со значением 15%.
Можно рядом с заголовками статей включить отображение ML‑вероятности. Можете включить на время подбора оптимальных для вас порогов.
При выпуске расширения с ML функциональностью я не меняю другие имеющиеся настройки у старых пользователей, только добавляю включенные ML пороги. Но рекомендуется отключить остальные фильтры, чтобы снизить число ложноположительных срабатываний. А если надо будет скрыть больше, то сначала просто попробуйте снизить порог скрываемой вероятности. По всем метрикам это гораздо лучше, чем старое поведение.
Возможные планы
Повысить качество разметки.
Ручная проверка оценок разметки выявила, что я во многом не согласен. В основном количественно (условно, GLM дает 70%, я 80%), но иногда и качественно (GLM — 90%, я 10% или наоборот). Думаю это основное пространство для улучшения.Всё переделать после шквала вашей критики.
Сделать то же самое для LinkedIn.
Хотя там можно просто скрыть вообще все посты — это уже будет весьма хорошая модель с False‑Positive в единицы процентов, которую будет непросто перебить.
s-a-u-r-o-n
Было бы здорово вместо одного ползунка в следующей версии сделать три:
Статьи, написанные LLM, а не человеком. Могут быть про ИИ, а могут и нет.
Статьи об ИИ - то, что скрывает AI-less habr.
Вайбохвальство - статьи о программах, созданных путём ввода двух-трёх промптов в Claude Code. Само приложение может и иметь полезность, а длинный текст о нём - чаще нет.