

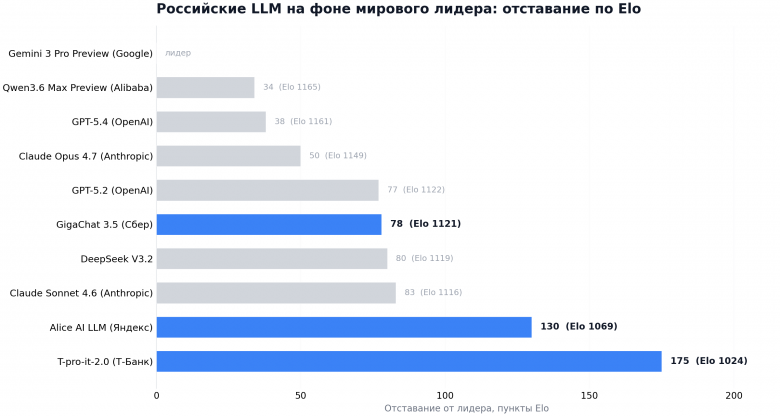
18 ноября на деловом саммите АТЭС в Шэньчжэне Владимир Путин заявил: «Россия находится в авангарде цифровой трансформации. Наши две флагманские языковые модели входят в число лучших в мире» (по сообщению агентства «Прайм»). Фраза мгновенно разошлась по новостям, но самое интересное в ней не пафос, а проверяемость: в России четыре больших семейства языковых моделей, и почти все они участвуют в открытых рейтингах, где место определяется голосами живых пользователей, а не пресс‑релизом.
Я не ML‑инженер и не претендую на роль судьи: мой максимум — навайбкодить лабораторные в вузе, а от нейросети мне важно, чтобы она отвечала на русском и не требовала VPN. Поэтому вместо споров о «лучших в мире» я заглянул в открытый краудсорсинговый рейтинг llmarena.ru, собрал данные по всем четырём семействам и сверил их характеристики с заявлениями разработчиков. Спойлер: одна российская модель действительно сидит в мировом топ-10 — но общая картина сложнее, чем заголовок новости.
Что значит «в числе лучших»: как устроен открытый рейтинг
LLM Arena (llmarena.ru) — краудсорсинговая площадка для сравнения больших языковых моделей на русском языке. Механика простая: пользователь задаёт вопрос, на него анонимно отвечают две случайные модели, человек голосует за лучший ответ и только после голосования видит название модели. Из миллионов таких парных дуэлей по модели Брэдли‑Терри — той же математике, что стоит за шахматным рейтингом Эло, — считается итоговый балл: чем чаще модель выигрывает, тем выше её Elo.
На момент подготовки материала в рейтинге 112 моделей, а голоса собираются непрерывно; в моём срезе учтены данные вплоть до 9 ноября 2026 года. Важно понимать ограничение метода: Elo здесь измеряет «чей ответ людям понравился чаще», а не «какая модель решит олимпиадную задачу». Зато это единственная метрика, где сравнение идёт вслепую и без участия разработчиков.
Кто эти «две флагманские»: четыре российских семейства
В России четыре больших семейства LLM: GigaChat у Сбера, Alice AI LLM у Яндекса, T‑Pro и T‑Lite у Т‑Технологий и Cotype у MWS (экосистема МТС). Развиваются они быстро, поэтому начну с коротких справок в актуальном состоянии.
GigaChat — флагман с открытыми весами
GigaChat Сбера развивается с апреля 2023 года и вырос из экспериментального чата в мультимодальную платформу: помимо текста, семейство работает с документами, аудио и изображениями — в стеке собственные ruGPT-3.5 и FRED‑T5, ruCLIP для связи текста с картинкой и Kandinsky для генерации изображений. Текущий флагман — GigaChat 3.5 Ultra, выпущенный в июле 2026 года: архитектура MoE, 432 млрд общих параметров (28 млрд активных), контекст 262 тысячи токенов, а генерация длинных текстов, по данным Сбера, ускорилась до четырёх раз по сравнению с прошлым поколением. Главная особенность — открытые веса: модель выложена на Hugging Face под лицензией MIT, то есть её можно скачать, дообучить и крутить на своём железе. Подробности — в разборе на Хабре.
Alice AI LLM — ассистент, вросший в экосистему
Яндекс в октябре 2025 года перевёл «Алису» с YandexGPT на новое семейство Alice AI LLM: флагман построен на архитектуре MoE, включает 235 млрд параметров и обучен с нуля на русскоязычных текстах и данных экосистемы. Модель закрытая, но её сила — не в весах, а в интеграции: она отвечает в поиске, браузере и колонках, а через API в Yandex AI Studio и агентные сценарии доводит дела до конца — бронирует столик, собирает корзину, оформляет заказ в «Яндекс Такси» и «Еде». 21 сентября 2026 года Яндекс выложил в открытый доступ претрейн‑версию Alice AI Foundation на 80 млрд параметров (3 млрд активных), разрешив коммерческое использование; технические детали — в публикации на Хабре.
T‑Pro и T‑Lite — банковский путь через дообучение
Т‑Технологии (Т‑Банк) представили семейство Gen‑T в декабре 2024 года. Первые модели строились на базе Qwen 2.5 и проходили глубокое дообучение на русскоязычном корпусе — по словам разработчика, такой подход сократил расходы примерно на 90% по сравнению с обучением с нуля. Актуальные версии T‑pro‑it-2.0 и 2.1 переехали уже на Qwen 3: 32 млрд параметров, упор на следование инструкциям и вызов инструментов. Веса открыты под Apache 2.0 (карточка модели на Hugging Face), лёгкая T‑Lite на 7 млрд параметров рассчитана на быстрых чат‑ботов и стандартное железо.
Cotype — не ассистент, а офисный инструмент
MWS из экосистемы МТС пошла другим путём: вместо универсального чата — модели для бизнеса, обученные на деловой переписке и корпоративных документах. Линейка разложена по задачам: Pro 3 на 27 млрд параметров держит контекст в 262 тысячи токенов — примерно годовой отчёт целиком; Light 3 на 9 млрд — для типовых процессов; мультимодальная VL на 32 млрд читает рукописный текст со сканов; открытая Nano на 1,5 млрд годится для черновиков. В независимом бенчмарке MERA Pro 3 заняла третье место, уступив только моделям в несколько раз большего размера (обзор MWS AI на Хабре).
Таблица 1. Четыре российских семейства LLM (по данным разработчиков)
Семейство |
Параметры |
Контекст |
Веса |
Фокус |
GigaChat 3.5 Ultra (Сбер) |
432 млрд, MoE (28 млрд активных) |
262 тыс. токенов |
Открытые, MIT лицензия |
Универсальная модель: текст, код, документы |
Alice AI LLM 1.0 (Яндекс) |
235 млрд, MoE |
н/д |
Закрытые; открыта претрейн‑версия Foundation 80B |
Ассистент и агенты в экосистеме Яндекса |
T‑pro‑it-2.1, T‑Lite (Т‑Технологии) |
32/ 7 млрд |
н/д |
Открытые, Apache 2.0 |
Русский язык, tool calling, агенты |
Cotype Pro 3, Light 3, VL, Nano (MWS) |
27/ 9 / 32 / 1,5 млрд |
до 262 тыс. (Pro 3) |
Открыта Nano |
B2B: договоры, документы, сканы |
н/д — не раскрыто в открытых источниках. Характеристики меняются от версии к версии;
Место в мировом рейтинге: сверяем заявление с цифрами
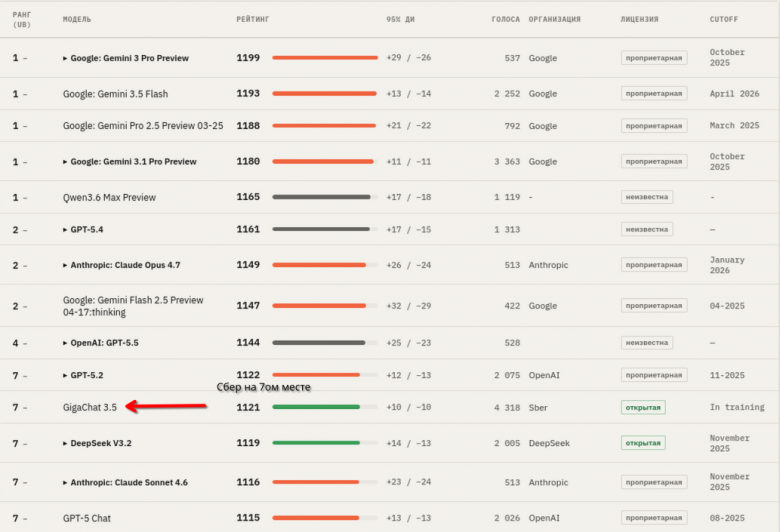
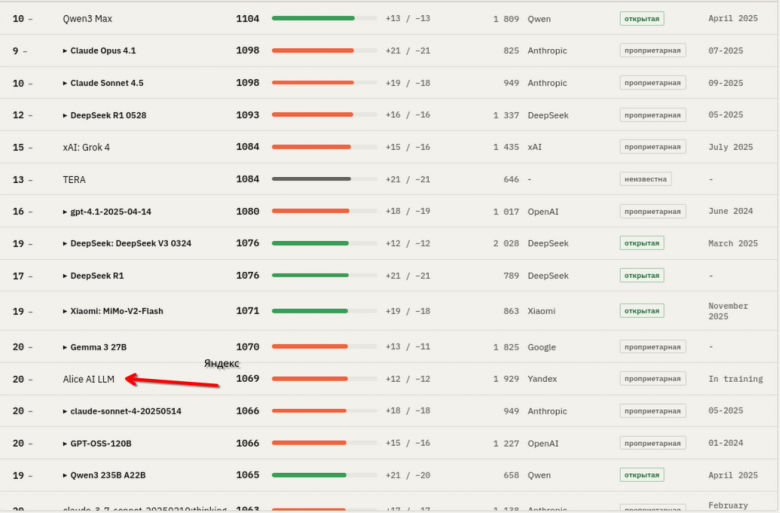
Президент сказал «две». Если мерить открытым рейтингом, две сильнейшие российские модели очевидны. На срезе llmarena.ru середины ноября 2026 года GigaChat 3.5 занимает седьмое место в мире с Elo 1121 — рядом GPT-5.2 (1122) и DeepSeek V3.2 (1119), а лицензия у него в таблице помечена как открытая. Alice AI LLM — двадцатое место и 1069 очков, по соседству с Gemma 3 27B и Claude Sonnet 4.
С преследователями честнее быть осторожным: T‑pro‑it-2.0 по срезу сентября 2026 года — 36-е место с Elo 1024, а модели Cotype в публичном лидерборде не представлены вовсе — MWS пока позиционирует их как B2B‑продукт.
Для масштаба — мировая шеренга того же среза: Gemini 3 Pro Preview — 1199, Qwen3.6 Max — 1165, GPT-5.4 — 1161, Claude Opus 4.7 — 1149. Отставание GigaChat от лидера — 78 пунктов Elo, у Alice — 130, у T‑pro — 175 (диаграмма в начале статьи показывает этот разрыв наглядно). Поскольку рейтинг живой, места меняются: в сентябрьском срезе Alice, например, была девятнадцатой при тех же 1069 очках — поэтому рядом с любой цифрой из этой статьи стоит держать дату среза.
Второй эшелон: где наши сильны, а где нет
Честный ответ на вопрос заголовка: обе модели относятся ко второму эшелону мирового рейтинга, и стыдиться этого не нужно. Проигрыш мировым лидерам концентрируется там, где нужны длинные агентные цепочки, сложный многоступенчатый код и строгая многошаговая логика: в этих дисциплинах голоса пользователей стабильно уходят Gemini, GPT и Claude, а китайские открытые DeepSeek и Qwen тоже стоят выше.
Зато на своём поле наши модели выглядят убедительно. Рейтинг собирается на русскоязычных запросах — и GigaChat в общем зачёте обгоняет GPT-5.2, то есть для задач на русском языке он в мировом топ-10. Добавьте сюда цену и доступность, открытые веса GigaChat, T‑Pro и Alice Foundation (западные флагманы такого не дают в принципе) и интеграцию в реальные сервисы — банк, поиск, такси, маркетплейсы. Для типовых офисных задач — письмо, перевод, резюме документа — разрыв с мировыми лидерами на практике малозаметен.
Что в итоге
В мире наши обе модели относятся ко второму эшелону, они проигрывают мировым лидерам (Gemini 4, Claude 5.5, GPT-6 и ряду китайских моделей) в сложном программировании, многошаговых агентных сценариях и логических задачах. Но мы должны понимать, что регионально и на русском языке эти модели действительно могут показать достойный уровень качества ответов, входя в топ-20 рейтинга на русском языке.
Комментарии (23)

proxy3d
21.11.2026 21:02Надеюсь авторы понимают, что подобный банчмарк очень субъективный и низкий. "Чей ответ людям понравился чаще" говорит не о качестве ответа, а о восприятии его человеком. Например, если обучить модель больше с упором на литературный стиль, который будет нравиться большинству, это не значит что в остальном этот ответ качественный.
Например, если надо написать сложный код, то модель может красиво расписать решение и сделать плохую реализацию или не справиться. Но при этом - человеку, который не является специалистом в данной области ее ответ покажется отличным, а в реальности это может оказаться просто галлюцинация.
Например, в свое время я попросил нейронки написать код на Python, который строить CGH голограмму, чтобы записать ее на подложку. Сетки выдали мне код - я был удивлен, что он такой простой и даже написал об этом знакомым. В тот момент, я бы указал, что мне понравился ответ. В реальности не один из вариантов не работал. Модель выдумала несуществующие фреймворки.


InsiderCrush
21.11.2026 21:02Видимо автор метается между "хочу быть объективным" и "хочу что бы думали что в моей стране есть сильные ЛЛМ". Я тоже был бы счастлив, если бы наши ллм были в топе мировом. Но говоря откровенно - пока что я несчастлив.
Все кто реально в теме, понимают как российские вендоры делают отчеты о своих моделях и где притягивают за уши результаты тестов. Любому мало-мальски разбирающемуся человеку всё понятно и так.

vadimr
21.11.2026 21:02Ну они в мировом топе. Другой вопрос – на каком месте. А преимущество китайских и американских моделей ЛЛМ, вроде, никто не отрицает.
Путин это говорил как раз в контексте институционализации тройки мировых лидеров.

Dekartio
21.11.2026 21:02Первым делом хочу отметить превосходный стиль изложения материала в статье. Для студента, который использует нейросети, чтобы навайбкодить (читай - списать) лабы, лишь бы на русском и без ВПН - уровень почти запредельный, тут браво! Кстати, в рекламе ГигаЧата по ТВ фигурирует ровно такой же типаж студента, так что пафоса здесь действительно быть не может.
Но я бы куда охотнее поверил, что текст писал профессиональный пиарщик или маркетолог одной из упомянутых компаний (либо самих авторов рейтинга). Уж больно выверенная структура: зайти с международной повестки и цитаты президента (тут не поспоришь), подтянуть сторонний рейтинг, аккуратно разложить по полочкам характеристики всех отечественных игроков, никого не обидев, а в самом финале внезапно сослаться на отсутствующие в рейтинге GPT-6, Gemini 4 и Claude 5.5 в качестве опоры для второго эшелона.
В любом случае желаю автору успехов в выбранной карьерной траектории. Оценки и комментарии хабровчан всё расставят по местам - и правильно сделают: никому не нравятся притянутые за уши заголовки и выводы. Хотя лично мне всё равно приятнее читать профессионально составленный маркетинговый материал, чем бездумный нейросетевой шлак, которым нынче завален Хабр. Аффтар, пеши исчо!

svl87
21.11.2026 21:02ну хз, вряд ли бы пиарщик стал говорить что модели идут во втором эшелоне и в топ-10 входят только по каким-то непонятным задачам на русском языке. фактически, это ситуация как в суверенном автопроме. машины в принципе ездят, а с задачей проехать на дачу по дороге, которую не ремонтировали 30 лет, Нива входит в топ-10
Dekartio
21.11.2026 21:02Речь президента 18 ноября на деловом саммите АТЭС в Шэньчжэне - сильный инфоповод. Если его не использовать вовремя, то инфоповод "протухнет".
Принцип "Нива и бездорожье" сейчас основной, чтобы сохранять флёр объективности и эксплуатировать заголовки. Ну и в статье шесть активных ссылок на сайт рейтинга. Кто бы это ни был, маркетинг ему не чужд, поэтому смотрим, что напишет дальше.

Popadanec
21.11.2026 21:02Совсем то гнать пургу тоже смысла нет. Народ её и так давно наелся и реакция будет однозначной. А если создать видимость независимости, то часть читателей поведётся. И это видно по оценкам.

Andreas_Fogel
21.11.2026 21:02Если эти модели будут продавать за копейки или предоставлять бесплатно, то применений масса. А так как все находятся в условии у кого лопат больше тот и царь, то мы проигрываем в сухую. Ну не купит у нас государство столько серверных видюх, чтобы хоть какуюто конкуренцию составить. Просто запретят зарубежные нейросетии и сделают налог за не использование ИИ в рабочей и интернет деятельности.

TVD2100
21.11.2026 21:02У Deepseek актуальные модели v4-pro и v4.1-flash, не вижу смысла сравнивать с прошлогодней моделью 3.2
Dekartio
21.11.2026 21:02А с учётом того, что новые версии стали запредельно осторожными и делают кучу оговорок о том, что чем не является, пользователям-тестерам на запрос "Как приготовить оливье на новый год" их ответ будет нравиться ещё меньше

house2008
21.11.2026 21:02Россия находится в авангарде ...
Первый канал не иначе, если новость начинается с этих строчек, значит там или вранье или притянутая за уши информация - пока ни разу не подводило.

artden111
21.11.2026 21:02Мой недавний опыт общения с гигачатом:
- Сколько в России стоил такой-то комп год назад?
- В 2024 году он стоил столько-то
- А ты знаешь, какой сейчас год?
- 2026
Закрыл его и больше не открывал ))
glorden
21.11.2026 21:02а меня алиса послала после пары невинных вопросов как сделать доступ на сайт по ipv6.
запрещенная к распространению информация по всей видимости. закрыл и больше не открывал.

Mintavrus
21.11.2026 21:02Автор, а где в этом топе Claude Fable 5.2, Opus 5.5, GPT-6.2 Astra/Sol, Gemini 4 Neon/Carbon, Kimi K3.1, Qwen 4 Max, DeepSeek V4.1Flash, GLM 5.3, MiniMax M3.1 и еще куча других нейросетей?

fenrir1121
21.11.2026 21:02Подозреваю автор статьи одновременно является автором сайта на который идут ссылки. В противном случае не представляю как можно не обратить внимание на слона в комнате: актуальные ру модели сравниваются с моделями 2-3 поколений давности, большая часть которых уже депрекейтнуты.
kutase
Выглядит крайне сомнительно. Почему сравнивается со старьем типа Gemini 3.1 Pro на каком-то непонятном российском сайте? По настоящему флагманские модели идут сейчас на триллионы параметров, даже посредственные по качеству типа Kimi K3 (2,8 трлн параметров). GigaChat 3.5 Ultra - 432 млрд, Alice AI 235 млрд (по другим данным вообще 80 млрд). Это неконкурентоспособно.
Ka463
Вы не уловили суть, модели лидируют да, но в русском языке, то-есть это тоже самое что если бы обучили модель играть на балалайке и потом орали на весь мир что мы первые, это как в анекдоте с неуловимым Джо.
— Билл?
— Да, Гарри?
— Что это было, Билл?
— Это был Неуловимый Джо, Гарри.
— А почему его зовут Неуловимым Джо, Билл?
— Потому что его никто ещё не поймал, Гарри.
— А почему его никто ещё не поймал, Билл?
— Потому что он нафиг никому не нужен, этот Неуловимый Джо.
FSS1989
Неуловимы значит что его не могут поймать, а если не могут значит пробовали поймать. В анекдоте правильней его было бы назвать неловимый джо исходя из того, что его никто не ловил.
Okloks
80 млрд у Яндекса - это foundation модель. Не путайте
Popadanec
Это как Ту-114 и его 32 мировых рекорда. Только большая часть рекордов получены крайне специфично.
FSS1989
И чем он от конкорда отличается? А я вам скажу, в катастрофе конкорда погибло 113 человек за одну катастрофу, а Ту-144 16 человек за две.
Ox2A
Ха, я выпал уже от 1й картинки автора поста))) В мире ИИ, когда каждый месяц меняет все, модели сравнивают с конкурентами почти годовалой давности и даже им "импортозамещенные" модели сильно проигрывают. Кстати, в аннотации к статье засейфилась немного другая картинка на которой "отрицательное лидирование" более правильно на схеме показано.