

Как перестать запускать всё подряд и начать понимать, за что мы платим
Антон: Добрый день, меня зовут Антон, и у меня 132 тысячи тестов.
Ведущий: Добрый день, Антон.
Антон: Из них семь иногда падают.
Ведущий: Ты уже знаешь какие?
Антон: Конечно. Сегодня другие.
Ведущий кивает. Откровенность очень важна. Ещё важнее помнить пять шагов:
Шаг 1. Написать тест, чтобы спокойно менять код.
Шаг 2. Написать ещё тестов, потому что это так весело.
Шаг 3. Добиться, чтобы CI работал хотя бы десять минут. Иначе несерьёзно.
Шаг 4. Включить шардинг. Теперь несерьёзно стоит денег.
Шаг 5. Понять, что где-то что-то пошло не так. Найти наш кружок.
Встречи по четвергам. Если CI успеет закончиться.
Слово предоставляется участникам
Сосед: У нас хорошая ситуация. Мы ускорили тесты в четыре раза.
Антон: Как?
Сосед: Запускаем на восьми машинах.
Антон: А платим?
Сосед: Это в суппорт-группу по средам.
Сосед: Мы же инженеры. Что мы любим? Смотреть, как красные галочки превращаются в зелёные.
Шёпот из угла: А я слышал, в Китае красное — хорошо, зелёное — плохо.
Ведущий: Это вы ещё не знаете, что в Болгарии происходит.
У окна: А у нас coverage 84%.
Антон: Это хорошо?
У окна: До конца квартала надо 85.
Антон: А какой баг перестанет проходить на 85?
Ведущий: Антон, мы здесь не осуждаем.
Антон: А где Михаил?
Ведущий: Миша? Начитался этих интернетов. Там теперь тесты удалять советуют. Ну и вот.
Антон: Что «вот»?
Ведущий: Удалился.
Антон: Из общества?
Ведущий: С волчьим билетом.
Антон: Но кто-нибудь вообще знает, зачем нам нужны все эти тесты?
Ведущий: ЧТО? Простите, у меня избирательная глухота.
В кругу стало тихо. Человек возле розетки, на самом краю круга, на всякий случай закрыл ноутбук.
Сосед: Кстати, кстати. Я тут Кента Бека читал. В Facebook недетерминированные тесты просто удаляли. И ему эта политика нравилась. Идиоты.
Ведущий: Идиоты. Таким не место в нашем обществе.
Антон: Кенту Беку?
Ведущий: Не отвлекайся.
Антон: Но вообще наводит на мысли. Зачем всё это нужно?
Сосед: Весь мир театр.
У окна: И мы все актёры.
Антон: А CI?
Ведущий: Антракт. На сорок минут.
Мы посмеялись. Потом посмотрели на пустой стул Миши. Вопрос-то остался.
Весь мир театр. А тесты зачем?
Смысл истории проще: тесты — не продукт, который нужно беречь ради него самого. Они нужны, чтобы выпускать работающий код и спокойно его менять. Нужную проверку Бек предлагает переписать надёжно, изменив дизайн. А тесты, которые не отличают рабочий код от сломанного, называет расходами без пользы. Сохранять количество тестов — другая задача. Нашему обществу она понятнее.
На заседании мы распределили роли. Разработчик пишет тесты. CI их запускает. Тестировщик находит то, что всё равно сломали. Все заняты. Все немного устали. Только в какой момент из этого должна получиться уверенность, что изменение можно выпускать?
Прежде чем кого-нибудь удалять вслед за Мишей, неплохо бы разобраться: а что мы вообще узнали от всех этих зелёных галочек?
Разговоры о полезности тестов идут десятилетиями. Ещё в 1970 году Дейкстра писал, что тестированием можно показать наличие ошибок, но не их отсутствие. Зелёная галка ✅ не доказывает, что система работает во всех ситуациях. Она сообщает более скромную вещь: в этих запусках проверенные утверждения сошлись с наблюдавшимися результатами.
В знакомом red — green — refactor мы сначала наблюдаем отказ: нужного поведения ещё нет или в нём есть ошибка. Потом меняем реализацию и видим, что та же проверка проходит. Важен и первый результат: тест действительно отреагировал на то, что мы собирались исправить. Разумеется, упасть он должен по ожидаемой причине.
Антон: А если оно уже работало?
Сосед: Тогда тест сразу зелёный.
Антон: А откуда мы знаем, что он вообще умеет краснеть?
Скептик: Я тебя сейчас стукну — ты вообще фиолетовым станешь.
Ведущий: Друг, есть вопросы, ответы на которые ты не хочешь знать. Не задавай их.
Может, поведение уже реализовано. А может, assertion проверяет не то, mock заранее вернул нужный ответ или до проверки вообще не дошло. По одному зелёному результату эти случаи не различить. Тест на существующее поведение вполне может быть полезным — просто его способность заметить поломку пока не проверена.
Можно временно внести конкретную ошибку: убрать скидку, перевернуть условие, испортить результат. Упадёт ли тест? Это идея mutation testing. Для выбранной поломки появляется дополнительное свидетельство: проверка отличила её от исходного поведения. Доказательства на все случаи жизни по-прежнему нет.
Антон: И все 132 тысячи надо проверить?
У окна: А ты смелый парень. Угадай, сколько вариантов поломки придётся перебрать, чтобы хоть что-то доказать.
Что мы знаем о своих тестах
Тест однажды поймал баг. Отлично. Значит ли это, что он нужен после каждой правки? Двадцать тестов проходят через одну функцию. Они проверяют двадцать разных обещаний или двадцать раз поднимают одну и ту же fixture? Полчаса CI — это цена проверки или в основном цена подготовки к ней?
Здесь легко смешать три вопроса. Выполнял ли тест этот код? Проверял ли результат его работы? Замечает ли конкретную ошибку в нём? Для каждого нужны свои свидетельства. Начнём с первого: он хотя бы позволяет выяснить, куда уходит работа и какие проверки связаны с изменением.
Что мы считаем сейчас |
Что ещё нужно узнать |
|---|---|
132 тысячи тестов |
Какие из них выполняли изменённый код? |
Десять минут CI |
Сколько ушло на загрузку, а сколько на сами случаи? |
84% coverage |
Какие тесты прошли через конкретную ветку? |
Правую колонку наш кружок пока заполнить не мог. Зато слева всё было в порядке: тестов много, минуты идут, coverage растёт. Постановка имела успех.
Антон: А если сначала ничего не удалять? Просто посмотреть, что каждый тест выполняет.
Сосед: У нас для этого coverage.
Антон: Тогда почему мы всё ещё не знаем ответа?
84% чего именно?
Обычный coverage отвечает: какие части кода выполнялись хотя бы раз. Для выбора тестов этого мало. Нужна связь в обратную сторону: какие именно тесты выполняли этот участок.
Представим функцию расчёта цены. Один тест проверяет обычную покупку, другой — скидку, третий — ошибку оплаты. Все импортируют один модуль. Это ещё не значит, что они ходят по одним веткам.
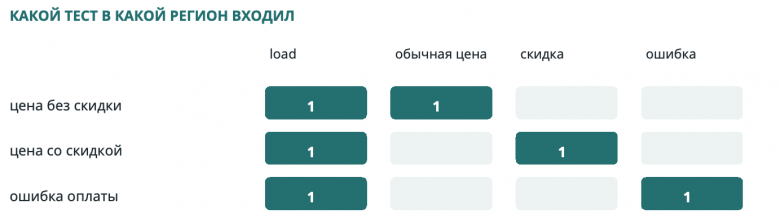
Если поменялась ветка скидки, у второго теста есть непосредственная причина запуститься. Если поменялось то, что модуль делает при загрузке, причина есть у всех трёх. Уровень детализации меняет ответ.
Но у этой таблицы есть принципиальное ограничение: выполнять код и проверять его поведение — разные вещи. Тест может пройти через расчёт скидки и проверить только заголовок страницы. Тест вообще без assertions оставит след исполнения.
Поэтому к региону полезно привязать имена случаев и вид suite: unit, integration, e2e. Если расчёт денег выполняется только по дороге к проверке заголовка страницы, это хороший повод посмотреть, кто проверяет сумму. Из самого вида suite такой вывод автоматически не следует.
Попутно выясняется, куда уходит время
У теста есть ещё одна жизнь: всё, что он загружает до полезной работы. Barrel export может привезти половину библиотеки на проверку одного хука. Хотелось бы различать модули, которые тест загрузил, и функции, в которые он действительно вошёл.
По такой записи можно было бы искать кандидатов на разбор: убрать ненужный импорт, попробовать явный mock или сузить fixture. Побочный эффект загрузки может быть нужен тесту, поэтому замену придётся подтвердить запуском. Само отсутствие вызовов ещё не разрешает отрезать модуль.
Про цену barrel-файлов уже писал Marvin Hagemeister. Для CommonJS-трансформации есть и готовый рычаг — lazy imports в SWC: отложить загрузку до первого использования. Это меняет момент выполнения побочных эффектов, поэтому проверять результат всё равно придётся.
Какие тесты запускать после diff
Граф зависимостей показывает, куда изменение может добраться: nx affected — на уровне пакетов, импорты — на уровне файлов. Но он не говорит, какую ветку выполнял конкретный тест.
Coverage-based test selection добавляет наблюдение: при прогоне записываем пары «тест — исполненный регион». После правки выбираем тех, кто заходил в изменённые регионы. Это давно известная область — regression test selection. Например:
Работа |
Как выбирает |
|---|---|
Записывает динамические зависимости тестов от файлов. |
|
Строит статический граф зависимостей классов. |
|
Сочетает зависимости на уровне методов и файлов. |
Все три работы — про Java, не плагины для Jest. В замерах Ekstazi более грубые зависимости окупались лучше подробных: меньше выбранных тестов ещё не означает меньше общего времени.
Упрощённая модель наблюдения выглядит так:
E(t) = регионы, исполненные тестом t
Δ = регионы, затронутые изменением
E(t) ∩ Δ ≠ ∅ → у теста есть причина запуститься
Это объяснение принципа, не полный алгоритм. Ещё нужно учесть изменение значений, инициализацию модулей, конфигурацию suite и качество самой записи.
Ну, помечтать-то можно
Антон: И чтобы я мог ткнуть в функцию и увидеть имена тестов, которые в неё входили.
У окна: А лучше в конкретную ветку.
Сосед: И отдельно unit, integration, e2e. А то вдруг моя скидка покрыта только тестом заголовка страницы.
Антон: И чтобы после правки запускались те, у кого есть причина. А причину можно было прочитать.
Ведущий: И чтобы у нового теста отсутствие записи не означало «можно не запускать».
Скептик: Ну да. В идеальном мире.
Антон: В идеальном мире у нас ещё и CI в пять минут укладывается.
Ведущий: Хватит летать в облаках. Давайте будем реалистами. Мы тут работаем с Jest, Vitest, Rstest. Ну или Mocha…
Шёпот: Покойся с миром.
Ведущий: В общем, читаем доки и следим за обновлениями. Пока это всё мечты.
Новенький
Человек с края круга поднял голову. Тот самый, который закрыл ноутбук.
Новенький: А что, если нет?
Ведущий: А ты кто? Новенький?
Новенький: Я как раз решил.
Антон: И как?
Новенький: Сначала разобрался, куда уходит время. Потом — какие тесты вообще надо запускать.
Ведущий: А понадобилось-то зачем?
Новенький: Жена однажды спросила, за какой такой СИ мы платим вместо её маникюра. И добавила, что уж лучше бы я в танчики играл.
Шёпот: Он ещё легко отделался.
Сосед: Ага. Мне машину продать пришлось. До сих пор дошираком питаюсь.
Самый неудобный вопрос на review: «А за что мы платим?»
Новенький: Пришлось смотреть правде в лицо. Я пытался объяснить про тесты, качество и надёжность. Но жена спрашивала про деньги: почему мы снова платим за проверку того, что вчера уже проверили? Я мог показать, сколько тестов запустилось. Объяснить, зачем понадобился каждый, уже не мог.
Ведущий: И что, помогло?
Новенький: Пришлось разбираться. Оказалось, до нас уже много чего накопали.
Ведущий пока отложил брошюру.
Я инженер. Я люблю мерить.
Новенький: Мы же инженеры. Что мы любим? Докапываться до сути. Вы говорите: десять минут CI. А вы вообще знаете, где ваши тесты проводят эти десять минут? В самой проверке? В setup? В teardown? В очередной загрузке того, что уже загружали тысячу раз?
Сосед: В отчёте написано: тесты — десять минут.
Новенький: Я инженер. Я люблю вещи измерять. Давайте вспомним Linear. Они разрешили подходящим файлам делить модули через isolate: false. Суммарное время API-шардов упало с 32,8 до 22 runner-минут за прогон. Не assertions переписали. Перестали заново собирать один и тот же мир.
Скептик: А состояние между тестами?
Новенький: Сняли изоляцию выборочно, добавили очистку. Что не смогли безопасно разделить — оставили изолированным. Они разобрались, за что платят.
Новенький: А Rstest упаковал сам jsdom в один ESM-бандл. На стенде со 100 файлами и 1000 тестами: с 16,99 до 10,57 секунды, минус 37,8%. Те же тесты. Дешевле до них добраться.
Сосед: В Playwright каждому тесту по умолчанию дают свежий browser context и страницу. Чтобы состояние не протекало, тесты друг друга не роняли.
Новенький: Дополнительные колёсики. Держит нас за ручку, чтобы мы не упали и тест не уронили. Но мы же взрослые люди. Мы же инженеры.
Скептик: И поэтому можно не убирать за собой?
Новенький: Наоборот. Почему наше окружение такое хрупкое? Откуда в нём побочные эффекты? Пробовали их почикать, сделать окружение железобетонным — или сразу решили всё каждый раз пересоздавать?
Ведущий: То есть отключаем изоляцию?
Новенький: То есть сначала меряем. Браузер уже разделяется между тестами. Но новый context, новая страница, повторная загрузка приложения, подготовка данных — колёсики крутятся на каждом тесте, а счётчик денег вместе с ними. Сколько стоит весь этот круг? Сколько после него остаётся на саму проверку?
Шёпот из угла: Так идея-то в воздухе носится. Linear уже разрешил подходящим тестовым файлам делить загруженные модули. А в следующем Vitest Browser Mode модули будут брать из кэша браузера, без повторной проверки каждого у сервера. На трёх реальных проектах — минус 13–27% времени.
Новенький: Вот. Вчерашнюю работу можно не делать заново.
Новенький: Не можешь измерить — для твоего отчёта этого не существует. Там просто «десять минут тестов». И ты идёшь ускорять тесты, хотя половину времени они ещё даже не начались.
Антон: А движок этого не знает?
Новенький: Одни движки не отдают всей картины. Другие отдают, но их об этом никто не спрашивает. Я взял и спросил.
Ведущий: А ты, парниша, что здесь вообще забыл среди нас?
Новенький: У меня с тестами проблем нет. Я здесь требования собираю. У тех, у кого проблемы есть.
Новенький: Дальше — вопрос жены. Один push — прогон. Ещё push — ещё прогон. Исправил замечание на review — опять. Мы уже разобрались, сколько стоит один запуск. А зачем каждый раз повторять всё?
Сосед: Мы для этого шардинг включили.
Новенький: Я тоже. Ждать стал меньше. Жена — задавать больше вопросов.
Ведущий: Шаг четвёртый.
Новенький: В общем, вы сейчас почти по пунктам перечислили, чего мне тогда не хватало. Что загрузилось? Что действительно выполнилось? Что из этого связано с моей правкой? Я стал собирать такую запись прямо во время обычного прогона.
За что мы платим второй раз
Новенький: Когда запись появилась, можно было открыть конкретную функцию и посмотреть, какие тесты в неё заходили. Потом — сопоставить её с правкой.
Сосед: Ты отдельные тесты выбираешь или файлы целиком?
Новенький: Для запуска — файлы. Выбрал файл — раннер выполнит все тесты внутри.
У окна: А посмотреть, какой именно тест заходил в функцию?
Новенький: Тоже можно. Просто для выбора файлов в CI такая подробность не нужна. За её запись считаем отдельно.
Антон: И ты сразу поверил, что всё работает?
Новенький: На своём проекте легко убедить себя в чём угодно. Хотелось проверить на чужом коде, с чужими тестами. Причём там, где CI уже оптимизировали, иначе сравнение получилось бы слишком удобным.
Новенький: Взял TanStack Query. У него уже есть Nx, который выбирает затронутые задачи. Я взял 60 последовательных коммитов: на родителе каждого записывал полный прогон, затем переходил к самому коммиту и спрашивал, какие тесты теперь нужны.
Скептик: То есть ради выборки ты шестьдесят раз прогнал всё?
Новенький: Для эксперимента. В обычном CI main публикует запись своего полного прогона, а ветка читает её и сравнивает со своей правкой. Полный прогон ради каждой выборки заново не нужен.
Он открыл ноутбук и повернул экран к кругу.
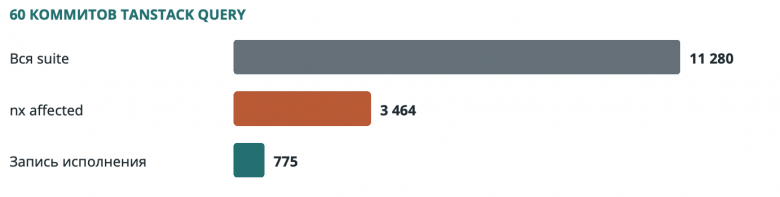
Запуски тестовых файлов, суммарно по 60 коммитам. Один файл, выбранный на пяти коммитах, считается пять раз. Источник: опубликованный replay TanStack Query.
Новенький: Без выборки за эти коммиты получилось бы 11 280 запусков тестовых файлов. Nx оставил 3 464. Запись исполнения выбрала 775. Nx уже сэкономил большую часть работы, а внутри оставшихся задач нашлось ещё что не запускать.
У окна: И маникюр стал на 78% дешевле?
Новенький: На 78% меньше запусков файлов относительно Nx. Время и деньги надо считать отдельно: файлы стоят по-разному, а сборка и подготовка окружения никуда не делись.
Ведущий: И когда ты это написал?
Новенький: Ну, месяца три назад.
Ведущий: И почему ты раньше не сказал?
Новенький: А вы бы мне поверили?
Скептик: Подожди. Ты записал, куда тесты заходили, потом код поменялся. Как ты вообще понимаешь, что к чему относится?
Почему нельзя просто хранить строки
Новенький: По одним номерам строк как раз не поймёшь. В понедельник ветка скидки была на строке 42. Во вторник над ней добавили импорт и две функции. Если хранить только «строка 42», запись уже указывает не туда. Хотя сама ветка могла остаться прежней.
Новенький: Я ставлю probes на регионы исполнения: функции, ветки, тела циклов, обработчики. Регион связан со структурой модуля; диапазон строк нужен, чтобы показать его человеку. Запись связывается с исходным текстом, по которому тест действительно выполнялся.
Новенький: После правки я сравниваю старый и новый код. Вопрос ведь не «файл поменялся?», а «что в нём стало работать иначе?».
Антон: Опечатку в комментарии исправил.
Новенький: Ты сейчас как diff рассуждаешь: была строка, стала другая. А я смотрю, что изменилось в самом коде. Через AST — дерево его структуры. У функции поменялось тело? У условия — ветки? Или только комментарий поправили?
Сосед: То есть перестать смотреть на код как на текстовый файл?
Новенький: Именно. Тогда вопрос «а что делать с комментариями?» отпадает сам. Комментарий изменился, исполняемый код — нет. Тесты отдыхают.
Антон: А если поменял расчёт скидки внутри функции?
Новенький: Тогда нужны тесты, которые заходили в изменённый участок. Соседняя функция в том же файле сама по себе ни при чём.
Скептик: А если я ставку скидки поменял? Её же в других местах читают.
Новенький: Поэтому смотрим и на тех, кто читает изменённое значение, и на тех, кто исполнял изменённый участок.
У окна: А если модуль при загрузке регистрирует обработчик и я поменял эту регистрацию?
Новенький: Тогда запускаем всех, кто загружал модуль. Они получили другое окружение ещё до вызова наших функций.
Сосед: То есть файл поменялся — запускаем всех, кто его загружал?
Новенький: В TanStack Query таких 149 тестовых файлов. Но в изменённую функцию заходили 83.
У окна: И можно запустить только их?
Новенький: Да. Но обычно ведь меняют не всю функцию. Одну ветку. В нашей правке в неё заходили девять тестовых файлов.
Ведущий: Остальные свободны.
У окна: А unit, integration и e2e?
Новенький: У каждой suite своя запись и заданный тобой вид. Видно, кто исполнял скидку. За смыслом проверки всё равно идём в сам тест.
Прогон закончился. Запись продолжает работать
Обычный прогон заканчивается зелёной галочкой. Здесь после него остаётся ещё и карта: какой тест куда заходил. В CI она помогает выбрать проверки для следующей правки. В редакторе — найти тесты конкретной функции или ветки. Один и тот же результат работает и на следующий push, и на review, и на вопрос «кто вообще это проверяет?».
Запись тоже стоит времени — ниже посмотрим сколько на Material UI. Но полный прогон ради каждого следующего вопроса уже не нужен. Тесты отработали. Пусть теперь поработают их результаты.
А если селектор ошибся?
Антон: А если ты нужный тест пропустил?
Новенький: В смысле «если»?
Антон: Ладно, умник. У нас в обществе знают: тесты живут своей жизнью. Тут каждый пытался быть хитрее и запускать только нужное. По импортам, по папкам, по тегам, по особо хитрым условиям в Bazel или Turborepo. Все возвращались с красным CI. Все.
Новенький: Знаю. Сначала moduleNameMapper, потом какие-то странные побочные эффекты. Потом обкладываешь всё исключениями, пишешь регламент и начинаешь ходить на собрания анонимных тестировщиков.
Ведущий: По четвергам.
Новенький: Поэтому, хотя рассказ звучит сложно, в основе всё проще. Я записываю, что тест действительно исполнял. Не что ему положено исполнять по нашим представлениям о проекте. Вот код, вот тест, вот он сюда заходил. Дальше смотрю, что в этом коде изменилось.
У окна: И получаешь список тех, кого запускать?
Новенький: Наоборот — список тех, кого можно пропустить. Для каждого есть запись: он успешно отработал и в изменённые участки не заходил. Остальных запускаем.
Сосед: Новый тест. Ты его ещё не видел.
Новенький: Запускаем.
У окна: Старый, но в прошлый раз упал. Или вообще не закончил работу.
Новенький: Запускаем.
Сосед: Запись вообще потерялась.
Новенький: Запускаем всё.
Ведущий: Какой-то ты недостаточно экономный.
Новенький: Чтобы тест пропустить, нужно основание. Отсутствие записи — не основание.
Скептик: А если я поменял общий setup? На нём все тесты поднимаются.
Новенький: Объявляешь его общей зависимостью — и при его изменении запускается вся suite.
У окна: А файл, про который ни в записи, ни в графе ничего нет?
Новенький: Сам по себе он тестов не выберет. Селектор назовёт этот файл. Если тесты от него зависят — нужно указать как.
Не всякий неизвестный файл — повод запускать всё. Иначе любой README запускал бы всю suite. Но и fixture, которую тест читает с диска, сама о себе не расскажет. Эту зависимость нужно объявить.
У записи есть и другие слепые зоны: вычисляемый импорт без ребра в графе, ответ внешнего сервиса, общее состояние между тестами, результат из кэша, для которого функция в этом случае вообще не исполнилась. Изменение условия может открыть путь, которого в прошлой записи не было. История исполнения не является доказательством всех будущих путей.
Поэтому внедрение начинается с проверки зависимостей и сравнений с полным прогоном.
Сосед: А откуда в CI берётся запись?
Новенький: На main прогоняем всё и сохраняем результат. Ветка берёт эту запись и смотрит, что изменилось.
Скептик: А если выборка всё-таки пропустила нужный тест?
Новенький: Полный прогон на main может это поймать. Но уже после слияния.
Скептик: Поздновато.
Новенький: Если это случается раз в сто лет, я лучше разберусь тогда, чем буду на каждом push платить временем и деньгами за полный прогон.
Скептик: Раз в сто лет, блин. Четыре раза каждый день.
Новенький: Никто не идеален. Пора это признать и принять.
Антон: А семь падающих?
Новенький: Файлы с упавшими тестами снова пойдут в запуск.
Антон: То есть эти семь ты не вылечил?
Новенький: Нет.
Ведущий: С Мишей-то что делать?
Новенький: Позвать обратно. Запись за нас тесты не удалит. Зато покажет, у кого спросить: ты эту скидку проверяешь или просто мимо проходил?
На нормальном проекте это развалится
Скептик: Ох уж эта молодёжь. Навайбкодят себе фигни разной, а ты потом разбирай.
У окна: А сколько стоит саму запись снять?
Новенький: На TanStack — примерно две секунды сверху на весь прогон.
Скептик: Так они до e2e ещё не доросли. Все тесты за десять секунд. Я бы это настоящей тестовой suite не назвал.
Антон: Да. У нас настоящие тестовые suite хотя бы пять минут идут. А лучше десять. Минут.
Скептик: Вот на таком проекте и попробуй. Особенно подробное покрытие для каждого теста. Дорого и долго!
Новенький: Конечно, я проверил это на всём, до чего дотянулся. У меня это уже работает на всех моих проектах. Но мои проекты тебе ни о чём не говорят. Поэтому взял ещё TanStack Query, Material UI, Zod — их исходники доступны и тебе, можешь повторить замеры на тех же тестах. На Kibana отдельно проверил индекс исходников.
Новенький развернул ноутбук к скептику.
Новенький: Ну раз мы заговорили про coverage, кто мне объяснит, какие данные нам нужны?
Скептик: Счётчики выполнения. Строк, функций, ветвей — Istanbul всё это умеет.
Новенький: А сколько данных необходимо и достойно хранить о функции, чтобы ответить, вызвал ли её этот тест? Одну строчку — факт её вызова.
Скептик: И неважно, один раз или миллион?
Новенький: Для этого вопроса — неважно. Для ветки — своя отметка, для загрузки модуля — своя. Всё остальное здесь уже perfect is the enemy of good.
Новенький: Давайте прекратим забивать гвозди микроскопом и возьмём ну хотя бы Mac mini.
Скептик: Но он дороже!
Новенький: Нет, он крепче.
Для выбора тестов нам нужен факт посещения и связь с конкретным тестом. Число повторений пригодится для других вопросов. Номера строк и структура исходника остаются нужны, чтобы сопоставить правку с регионом. Но хранить счётчик на каждую строку для этого не требуется.
Собирать ровно нужное — тоже не новая идея. В DeFlaker, ICSE 2018 собирали покрытие только изменённого кода для поиска flaky-тестов. Задача другая, инженерный принцип тот же: не оплачивать полный отчёт, если нужен конкретный ответ.
Новенький: Мы же инженеры. Что мы любим? Разбирать всё на кусочки. Здесь тоже не одна большая задача: записать исполнение, сохранить связь тестов с кодом, потом прочитать нужную часть. Меряем каждую, разбираемся с ценой каждой. Вот и вся инженерия.
У окна: А обычный coverage нельзя спросить, кто сюда заходил?
Новенький: В общем отчёте уже всё сложили вместе. Видно, что функция работала. Кто её вызвал — потерялось.
Сосед: А ты не складываешь?
Новенький: Я сохраняю связь: этот тест был в этой функции, в этой ветке. Для выбора тестов достаточно знать, что он там был. Миллион вызовов считать незачем.
У окна: А если снимать обычное покрытие после каждого теста?
Новенький: Можно. Но на измеренной jsdom-suite чтение счётчиков между тестами растянуло прогон в 2,1–2,7 раза. Поэтому я ставлю в код короткие отметки — probes. Тест дошёл до участка — отметили, какой. Вместе с остальными отметками сохранили после прогона.
Новенький: Десять секунд, говоришь? Тогда вот та же проверка цены на suite Material UI. Два workers, больше полутора минут на обычный прогон. Здесь тоже записываем, какой тестовый файл входил в регион. Запись отдельных случаев в эти цифры не входит.
Material UI, два workers |
Медиана прогона |
Добавилось |
|---|---|---|
Без записи |
91,56 с |
— |
С записью для селектора |
93,69 с |
2,13 с |
С V8 coverage |
110,86 с |
19,30 с |
Опубликованный замер: M4 Max, 64 GB, Node 26; прогрев отброшен, кэши очищались между прогонами. Измерена запись связей с тестовыми файлами.
Скептик: А две секунды — это не просто шум?
Новенький: Я тоже сначала переспросил. Поэтому мерили с двух сторон: обычный прогон, с записью, снова обычный. Смотрели, насколько гуляет само время запуска. Методика есть рядом с замером — можно повторить.
Ведущий: И что ты купил за эти две секунды?
Новенький: Карту исполнения всей этой suite. Чтобы на следующей правке знать, какие файлы запускать, а какие могут подождать. Здесь обычный coverage добавил девятнадцать секунд, запись для селектора — чуть больше двух. И запись остаётся: её можно спрашивать снова.
Скептик: Ладно, со временем допустим. А матрица? Тесты на регионы на двести тысяч модулей. Ты её куда складывать собрался?
Двести тысяч модулей
Новенький: Если хранить каждую пару отдельно, получатся гигабайты. Но у множества регионов совпадает набор тестов, которые их исполняли. Особенно под barrel exports.
Сосед: То есть, условно, у тысячи функций один и тот же список тестов?
Новенький: Бывает.
Сосед: И ты тысячу раз этот список записываешь?
Новенький: Один раз. У функций оставляю ссылку на него.
Скептик: Звучит как магия.
Новенький: То есть PNG, JPEG, видео в 4K — нормально. А упаковать куда меньший объём данных о покрытии — уже колдовство? Мы же инженеры. Что мы любим? Фокусы, у которых есть научное объяснение. Здесь фокус простой: одинаковое не хранить по тысяче раз.
Новенький: А чтобы проверить запас по размеру, собрал синтетический стенд: 200 тысяч модулей, 2 тысячи тестовых файлов. Число регионов в модулях и их размеры взял из записи Material UI.
У окна: И сколько места попросило это хозяйство?
Новенький: 77 мегабайт на диске. А для конкретной правки даже их целиком читать не нужно: достаём только нужную часть записи.
Скептик: А что именно ты сгенерировал?
Новенький: Какие тесты ходят в какие модули. Настоящие проекты уже проверил, теперь хотелось нагрузить сам формат: сколько съест памяти, сколько запишет, сколько прочитает. А сколько тестов удастся пропустить у тебя — посмотрим на твоём проекте.
Скептик: А если у меня все наборы разные? Твой фокус не сработает.
Новенький: Такой стенд тоже сделал. Ничего общего между наборами, 1,6 миллиона регионов — пик памяти около половины гигабайта. Это результат того стенда, не обещание на любой размер. Просто хотелось проверить и случай, где делиться списками уже не получается.
Новенький: И приёмы здесь вполне знакомые. В ClickHouse повторяющиеся значения заменяют ссылками на словарь; в Lucene инвертированный индекс находит документы по терму. Здесь те же приёмы: общие наборы и доступ от региона к тестам.
Скептик: Ты про запись рассказал. А сам репозиторий сначала прочитать? Я про индексы уже читал. Поиск медленный. Индекс медленный. Всё медленное.
Новенький: Если честно, индекс для чего-то вроде Kibana у меня строится примерно за четыре секунды. Сто с лишним тысяч модулей. Читаю, где что объявлено, кто кого импортирует.
Скептик: И после каждой правки ещё четыре?
Новенький: Около секунды на переиндексацию. Сохранённый индекс переиспользуется, изменённые файлы разбираю заново.
У окна: А сами тесты?
Новенький: Отдельная работа. Сейчас мы только про чтение исходников.
Скептик: То есть на моём проекте всё равно может не окупиться?
Новенький: Может. Если большинство правок трогает общий hub, выборка будет широкой. Если время уходит на install, build и старт контейнеров, пропуск тестовых файлов мало изменит. Размер записи, цена её получения и полезность выборки — три разных измерения.
Антон: А если и так быстро?
Сосед: Мы же инженеры. Что мы любим? Оптимизировать без явной причины.
Новенький: Вот это уже тема для отдельного кружка.
А собрать это вместе?
Антон: Ладно. Экстази, графы, счётчики, индексы. Мне теперь всё это собирать самому?
Новенький: Можно взять отдельный приём и остановиться на нём. Я собрал нужное мне в Variance Authority: запись исполнения, выборку после diff и ответы о том, какие тесты входили в функцию или ветку.
Скептик: Ну прям никто никогда не мог, а тут ты такой в плаще и на коне.
Новенький: Буду честен: не я это всё придумал. Поищи пару статей на тему — найдёшь тонны. Столкнулся с проблемой — спроси Claude, кто её решал. Всё придумали до нас. Я здесь собиратель. Исходники открыты, а список предшествующих работ длиннее нашей встречи. Там есть и результаты, с которыми мне неудобно соглашаться.
Антон: А на моих 132 тысячах тестов работать будет?
Новенький: Само число тестов этого не решает. Надо проверить раннер, зависимости и цену записи. А потом сравнить выборку с полными прогонами.
Антон: А что делать надо?
Новенький: Попроси агента интегрировать инструмент. Получи первую запись, проверь зависимости и правила пропуска и посмотри, за что вы платите на следующем push.
Антон: А можно личный вопрос? У тебя самого сколько тестов?
Новенький: Пятнадцать тысяч.
Ведущий: Молодой человек ещё на втором шаге.
Антон: Слабак.