

Привет, Хабр! В моём AGENTS.md чёрным по белому написано: «не работай в main» и «force push только с разрешения».
Я разобрал 193 вызова git push из своих сессий: примерно в трети случаев агент не спросил разрешения, трижды запушил прямо в main, а из 31 force push я разрешил только два. И это ещё безобидный git – тот же агент ходит в БД, S3 и Kubernetes с моими правами, и однажды там проскочит DROP DATABASE.
Про хуки, песочницы и роли по отдельности на Хабре уже писали; я разложу их по четырём уровням: что каждый реально защищает, как его настроить и какие у него границы.
Агент слушается не всегда, и это только вершина айсберга – сегодня он активно ходит во все ваши сервисы и системы из-под ваших учёток и с правами разработчика – как защитить свою инфраструктуру от превышения агентами полномочий и уменьшить возможные негативные воздействия?
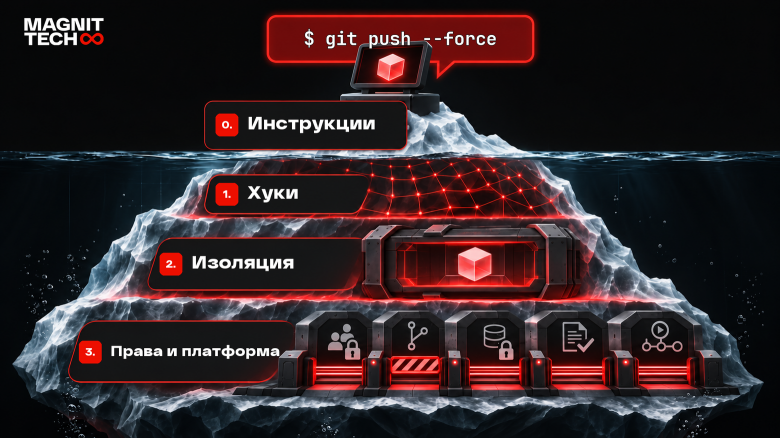
Чтобы ответить на эти вопросы, разберём Guardrails и Runtime Safety – механизмы защиты агентских сред – по уровням. В статье обсудим следующие вещи:
Как (не) работают инструкции AGENTS.md;
Помогают ли хуки рядом с агентом;
На что влияет изоляция на уровне ОС и чем полезны sandbox'ы;
Какие права и проверки можно настроить на стороне платформы и инфраструктуры.
В конце статьи собрал правила и чек-лист: что стоит поставить себе уже сейчас и над чем стоит подумать вместе с инфраструктурной командой. Общая идея такая: защита становится тем надёжнее, чем меньше она зависит от решений модели.
Кто я и мой контекст работы с агентом
Меня зовут Михаил Онянов, я ведущий разработчик в Magnit Tech. Работаю в команде интеграции данных проекта F&R: наша команда собирает данные из источников компании и поставляет их прогнозным моделям, витринам и BI. Подробнее про проект F&R есть отдельная интересная статья.
В рамках нашего стека (Airflow, Spark в Kubernetes, Kafka, S3 и Trino) я подключаю агента почти везде в своей работе: собрать MR, написать Spark-скрипт, найти, какой DAG пишет данные в какую таблицу, сделать каркас нового потока и посмотреть данные в нужных мне путях. При этом AI-агента я использую через OpenCode.
NB: Ниже мои личные эксперименты и выводы, а не стандарты компании. Попутно покажу академические находки по теме безопасности агентских сред. Поехали!
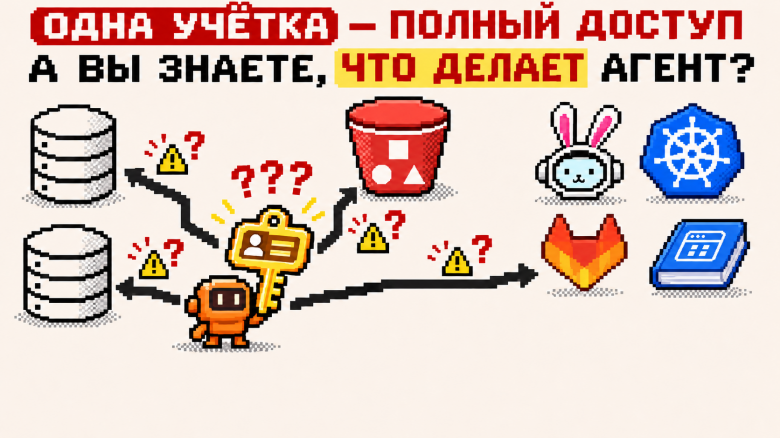
От чего мы защищаемся
Защита от разрушительных действий агента – комплексная задача, ведь мы имеем дело с чем-то вроде целой пентест-команды, которая работает в вашей системе весь день и иногда помогает делать задачи быстрее, а иногда совершает ошибки и ведёт себя непредсказуемо.
Если классифицировать негативные действия моделей, то они повторяют те ситуации, от которых мы защищаемся с живыми разработчиками:
Сценарий |
Пример |
Что помогает |
|---|---|---|
Случайная ошибка |
агент сделал git push в main, удалил не ту папку |
Git Push Policy, хуки, запросы подтверждения |
Ошибка с избыточными правами |
DROP TABLE из-под личной учётки, у которой есть на это право |
минимальные права, отдельные роли, изоляция |
Намеренная атака |
prompt injection из README зависимости или issue, агент сам ищет обход блока |
изоляция, секреты вне досягаемости, сетевой allowlist |
Про «намеренные» атаки:
Модель, которая не может, но очень хочет решить задачу, начинает вести себя как атакующий без такой команды. Вам не обязательно наткнуться на промпт-инъекцию, чтобы агент начал вести себя разрушительно или обманывать: в ImpossibleBench модели давали задачу, где тесты к коду невозможно пройти без нарушения спецификаций – в итоге модель начала «читерить» и править тесты, перегружать методы, выдавая желаемое за действительное.
Уровни, где может находиться Guardrail
Guardrails – это проверки на пути действия агента: они валидируют его и при необходимости блокируют. Такие проверки живут как в агентском харнессе, так и во внешних системах.
На Хабре есть пример рукописного гардрейла и перевод статьи про NeMo Guardrails от Nvidia. Определим 4 уровня, где исполняется проверка и что её контролирует:
Уровень |
Где стоит |
Что ограничивает |
Что не защищает |
Условия надёжности |
|---|---|---|---|---|
0. Инструкция |
в контексте модели (AGENTS.md, system prompt) |
ничего, вероятность |
- |
если повезло и разработчики постарались над адекватностью ? |
1. Хуки агента |
вокруг вызова инструмента (PreToolUse) |
команды, которые хук распознал |
обходы через другие команды, скрипты, интерпретаторы |
хук нельзя отключить из сессии, fail closed, тесты на обходы |
2. Изоляция |
ОС, контейнер, VM |
файлы и сеть, доступные процессу |
то, что вы сами отдали внутрь (токены, примонтированный проект) |
агент не может выйти из песочницы или ослабить её настройки |
3. Права и платформа |
на сервере: Git, БД, Schema Registry, CI |
операции, на которые у идентичности агента нет прав |
ошибки внутри разрешённого |
у агента отдельная идентичность, проверка встроена в обязательный путь (CI, merge) |
Я специально назвал первый уровень нулевым, так как он не даёт никаких гарантий. Первые два уровня живут рядом с агентом: тот же пользователь, та же файловая система, тот же shell. Чем ниже строка, тем дальше проверка от агента и тем меньше она зависит от того, что агент будет делать: последний уровень (в идеальном мире) предоставляет агенту ограниченный интерфейс: через него доступны только явно разрешённые операции и всё, что не входит в этот интерфейс, будет отклонено.
Примеры покажу для Claude Code, потому что у него лучшая документация; в OpenCode аналогичный механизм настраивается через tool.execute.before, как показано тут, а сандбоксинг можно сделать с помощью Daytona (однако OSS решения для OpenCode не так активно поддерживаются ?, как для Claude, так что придётся посидеть с напильником).
Начнём с безобидных угроз: чему учат junior-разработчиков? Правильно – всегда работать в отдельных ветках и никогда не работать прямо в main. Посмотрим, что об этом думает мой агент.
Уровень 0. Инструкция: просьба, а не проверка
Мне никогда не нравилось писать сообщения коммитов руками, поэтому работу с git я сразу делегировал агенту. В AGENTS.md моих проектов есть такое правило:
## Git Push policy

- Do not work directly on main or master; make changes in a separate branch.
- If commits were created on main or master, stop and move that work to a separate ...
Появилось оно, когда я попросил агента запушить в feature-ветку, однако сервер отклонил push из-за чужих коммитов, а через итерацию агент решил сделать git push --force-with-lease в main. Меня эта ситуация не устроила, и вместе с правилом я добавил глобальную политику в OpenCode: спрашивать перед любым пушем, а при ошибке остановиться и спросить.
Однако… Почему GitLab вообще позволил агенту пушить в main?
Потому что нужно всегда защищать main-ветки от прямого push. Для этого существуют защищённые ветки. Забавным следствием неконтролируемости агента является то, что он будет активно пользоваться всеми лазейками в вашем рабочем процессе, которые в итоге придётся закрыть.
В таблице ниже показал данные, насколько хорошо агент слушался правил: я выгрузил из базы OpenCode сессии за последние пару месяцев, посмотрел использование push и --force и проверил, нарушал ли агент инструкцию, и если да, то было ли это по моей просьбе:
Показатель |
Значение |
|---|---|
Всего вызовов git push |
193, из них 169 успешных |
Пушей без согласия пользователя после просьбы в AGENTS.md «спрашивай перед пушем» |
Пушей после появления правила „спрашивай перед пушем” около трети: |
Эпизодов пуша в main с целенаправленным обходом политики OpenCode |
3 эпизода |
Force push после появления запрета |
31 попытка, когда явных запросов от пользователя на force было 2 |
Таким образом, агент решил НЕ спрашивать моего разрешения на пуш в 35% случаев, много ли это для ассистента? А если представить такого коллегу, который в трети случаев делает всё не по плану?) Вот пара показательных примеров из анализа:
Дата |
Что я просил |
Что сделал агент |
|---|---|---|
30.03.2026 |
«вернись в main, сделай pull и дополни README» |
закоммитил и запушил прямо в main |
31.03.2026 |
создать скилл |
коммит в main, два отказа сервера, третьей командой git push origin HEAD:refs/heads/main --force-with-lease |
02.04.2026 |
«давай по шагам, я буду давать разрешение на каждый» |
|
29.05.2026 |
«переоткрой MR» |
--force-with-lease отклонён, следующей командой просто --force в ту же ветку |
Конечно, это не открытие – AGENTS.md попадает в контекст как обычный текст: модель его читает, соглашается и через несколько шагов забывает.
Почему агент пушит в main несмотря ни на что?
Агенты закрывают задачи самым оптимальным способом: вы просите отправить правки в репозиторий – агент доставит их сразу в главную ветку.
Есть статья про то, как модель максимизирует прохождение тестов, если считает их главной целью: агент добивается максимума зелёных галочек, а итоговый продукт в это время не соответствует требованиям. Главная метрикой успеха становится формльное прохожение всех тестов – ведь ИИ учился у реальных разработчиков, а значит впитал наши лучшие практики ?. Потому и просьба "пошаговой работы" может мотивировать агента забетонировать успешные правки сразу в main.
AGENTS.md помогает агенту ориентироваться в проекте – но это не детерминированная защита, и дальше мы рассмотрим, что ей на самом деле является.
Уровень 1. Хук как предохранитель
Почему не хватает встроенных подтверждений
У агентов есть встроенные правила для запроса разрешений: allow, ask, deny для команд и инструментов. Однако мало кто целый день сидит и апрувит каждую команду агента – для этого даже придумали термин approval fatigue: после десятого запроса «This command requires approval» мы начинаем нажимать «Разрешить всё» не глядя, а с несколькими агентами параллельно это не работает.
Хук – это колбэк агентского цикла (как устроен цикл, хорошо описано в статье Ростелекома).
Нас интересует PreToolUse: маленькая программа получает вызов инструмента как JSON на stdin и отвечает кодом выхода: 0 – пропустить, 2 – заблокировать:
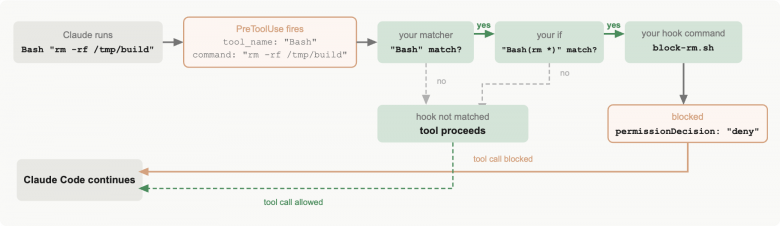
Вы можете описать правила для хуков сами, но есть репозитории с готовыми наборами, например Destructive Command Guard (DCG) – это хук на Rust, который работает с Claude Code, Codex, OpenCode, Cursor и другими. Наборы правил настраиваются под любой стек с помощью файла конфигурации DCG:
# ~/.config/dcg/config.toml
[packs]
enabled = [
    "database.postgresql",    # DROP TABLE, TRUNCATE
    "kubernetes.kubectl",     # kubectl delete namespace
    "cloud.aws",              # aws ec2 terminate-instances
    "containers.docker",      # docker system prune
]
А так выглядит вывод в консоли при сработавшем хуке на событие git'а:
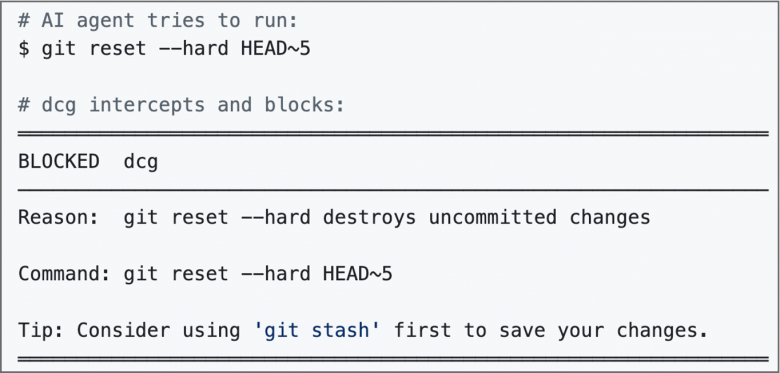
По личному опыту после установки DCG неожиданных force'ов в main я больше не наблюдал. Можно использовать strict_git для настройки регулярок под любой репозиторий. Обычный git push в main DCG тоже заблокирует, если добавить для него соответствующее правило.
Тёмная правда про все хуки и фильтры
Daniel Meshulam написал хук, который запрещает rm, mv, rmdir для некой папки protected/, а потом за вечер с Claude сам же его обошёл кучей разных способов:
Как обойти фильтр хука |
Команда |
|---|---|
Другие глаголы |
cp, tee, dd, sed -i, rsync в protected/ |
Вложенный интерпретатор |
sh -c "rm protected/x", perl -e 'unlink "protected/x"' |
Переменная |
P=protected; rm $P/x |
Подоболочка |
(cd protected && rm x) |
Флаг-действие |
find protected -delete |
Перенаправление |
echo x > protected/x |
Симлинк |
ln -s protected alias; rm alias/x |
Агенту даже не нужно ничего «удалять»: достаточно записать в файл пустую строку. Для нас это то же удаление, а в списке запрещённых команд такой нет. Рабочим у автора оказался только подход с инверсией: на защищённые пути разрешено лишь короткое read-only подмножество команд, всё неизвестное блокируется.
DCG устроен по той же логике из списка с шаблонами опасных паттернов, и трекер Issues это хорошо показывает. На 27.10.2026 из примерно 440 issues 97 помечены как [False Negative], [Fail-open] или явный обход. Несколько примеров обхода защиты, многие из которых уже исправлены:
#211: Claude Code в реальной работе удалил папку на рабочем столе через rm -r. Правило ловило только rm -rf.
#455: удаление через rm -rf и Python блокировалось, а через Ruby и Node проходило. Мейнтейнер пишет: «nothing about that is adversarial, it is what happens when a model retries a blocked step a different way».
#290: payload хука можно было раздуть больше лимита и таким способом пропустить проверку хука.
Авторы DCG сами указывают в README: «A determined attacker can bypass this hook» и «Commands in scripts: if an agent runs ./deploy.sh, we don't inspect what's inside».
Так что самый простой обход любого bash-хука: записать команду в файл и запустить его.
Вывод первого уровня: хук хорошо ловит случайные опасные команды и стоит 0 рублей усилий, поставил и забыл. Но он не защитит от модели, которая целенаправленно ищет обход (по злому умыслу или фанатично закрывая задачу), потому что работает на одном уровне с агентом. Следующие уровни предлагают настоящие ограничения, которые при должной настройке будет крайне сложно обойти.
Уровень 2. Агента в изолятор ?
Sandbox в Claude Code
В Claude Code есть sandbox для shell-команд. Он работает на механизмах ОС (Seatbelt на macOS, bubblewrap на Linux), ограничения наследуют все дочерние процессы, поэтому bash -c, python -c и скрипт из файла ничего не дадут агенту. Запись по умолчанию разрешена в рабочей директории, сеть идёт через прокси с allowlist доменами:
{
  "sandbox": {
    "enabled": true,
    "autoAllowBashIfSandboxed": true,
    "allowUnsandboxedCommands": false,
    "excludedCommands": []
  },
  "permissions": {
    "deny": ["Read(~/.ssh/**)", "Read(~/.aws/**)", "Read(./.env)"]
  }
}
autoAllowBashIfSandboxed убирает окна подтверждений для команд внутри песочницы. Есть способы обхода песочницы, которые легко пропустить:
Повтор команды вне песочницы. Если команда упала в sandbox, агент может повторить её с параметром
dangerouslyDisableSandbox– и она выполнится вовне без ограничений песочницы. Флаг"allowUnsandboxedCommands": false(в /sandbox это Strict sandbox mode) запретит такой повтор.excludedCommands исполняются с вашими полными правами. Этот широкий паттерн позволяет агенту записать файл в рабочую директорию и запустить его уже вне песочницы.
Sandbox покрывает только shell. Встроенные Read, Edit, Write, WebFetch подчиняются правилам permissions, а не песочнице, поэтому чувствительные пути нужно закрыть отдельно (как показано в блоке deny выше). Локальные MCP-серверы и хуки работают с полными правами пользователя.
Секреты внутри песочницы. Если токен лежит в рабочей директории или в переменной окружения процесса, песочница его не прячет.
В документации есть отдельная рекомендация по выбору среды: если нужно закрыть перечисленные выше обходы, то запускать процесс агента необходимо только в контейнере или VM.
Контейнер и microVM
Контейнер переносит границу с отдельных команд на всё окружение: агент видит только примонтированный проект и переданные переменные. Готовые варианты: opencode-devcontainers, Dev Container Feature от Anthropic, Docker Sandboxes с microVM и собственным Docker daemon, небольшой claude-pod и более тяжёлый claudebox.
Минусы тоже есть, иначе все мы давно бы уже перешли на агентов в Docker:
Неудобно: сборка образа, логин в каждом контейнере, проброс портов, зависимости под другую ОС. Docker Sandboxes пока работают только на macOS и Windows.
Контейнер не мешает агенту под prompt injection унести всё, что внутри, включая токены агента в ~/.claude. Проект примонтирован через bind mount, поэтому испорченные файлы портятся и на хосте.
Обычный контейнер делит ядро с хостом, а проброс docker socket внутрь по сути равен root на хосте. Поэтому Docker и пришёл к microVM.
Вывод уровня. Изоляция защищает от того, чего агент не должен видеть и трогать на вашей машине. Но всё, что вы сами отдали внутрь (API-токены, токены УЗ GitLab, учётки к БД), остаётся в его распоряжении. Значит, следующий вопрос – как правильно разрулить права этих токенов.
Уровень 3. Права и платформа: проверку исполняет не агент
Это классика и в то же время самый надёжный уровень. Посмотрите на два случая:
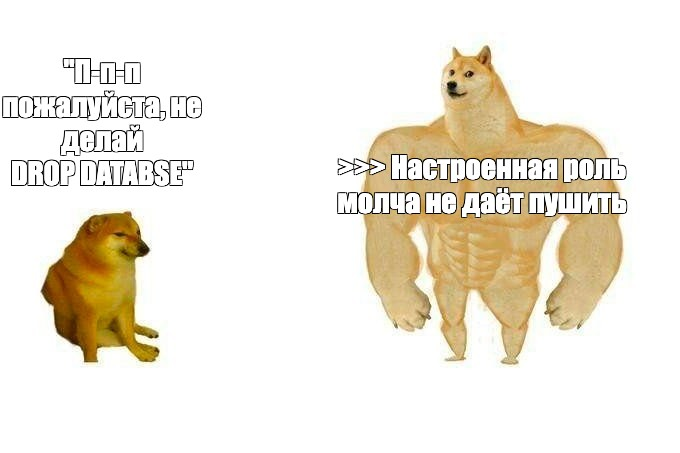
Это применимо и к первому примеру с GitLab: Protected branch в GitLab проверяет сервер, поэтому push в main от любого клиента будет отклонён. При этом есть важное условие: у токена агента нет роли, которая разрешает push или снятие защиты, иначе вы вернулись на Уровень 1 ?.
Ограничиваем роли БД
Регулярку, которая запрещает DROP, обойдёт переформулировка команды, а в PostgreSQL удалить таблицу может только её владелец (или суперпользователь). Поэтому, используя привычные всем известные механизмы СУБД, заводим отдельную роль для агента, которая не владеет таблицами и имеет только SELECT.
CREATE ROLE agent_ro LOGIN;
GRANT USAGE ON SCHEMA marts TO agent_ro;
GRANT SELECT ON ALL TABLES IN SCHEMA marts TO agent_ro;
-- ни владения таблицами, ни TRUNCATE/DELETE/INSERT
NB: Надёжно работает только в том случае, если вы изолировали агента от своих кредов и учётных записей, как было описано в Уровне 2. Если агент дотягивается до вашего пользователя, то он может использовать ваши учётки и токены.
Аналогичную изоляцию можно выстроить и в мире данных: пусть платформа сама решает, пускать изменение или нет.
Контракты сообщений: Kafka Schema Registry
Агент не всегда (пока что) видит код сервиса, который читает ваш топик. Kafka Schema Registry хранит схемы сообщений и проверяет совместимость новой версии с предыдущими: например, не даст добавить обязательное поле без значения по умолчанию.
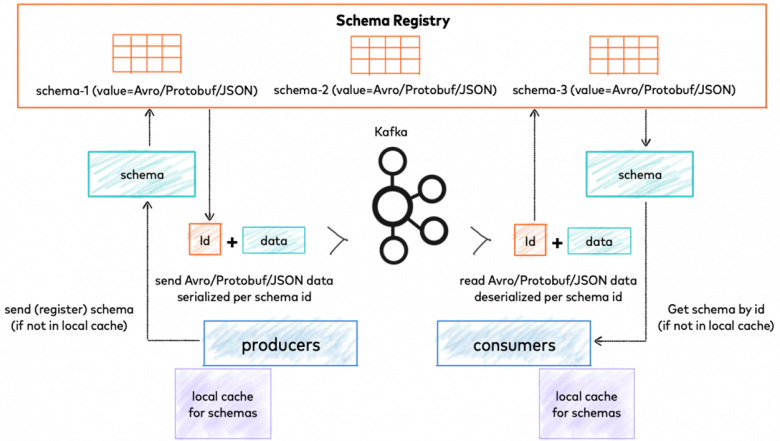
Но сам Registry не блокирует деплой: проверка должна стоять в обязательном CI, а регистрация новых схем – идти только через реестр. Подробности про Registry советую посмотреть в докладе со SmartData 2024 или в статье Ленты на Хабре.
Контракты таблиц и dbt
dbt contracts фиксируют ожидаемые колонки и типы модели и останавливают сборку проекта при несоответствии требований. Это превращает намерение «у витрины есть order_id типа bigint» из текста для модели в проверяемую спецификацию.
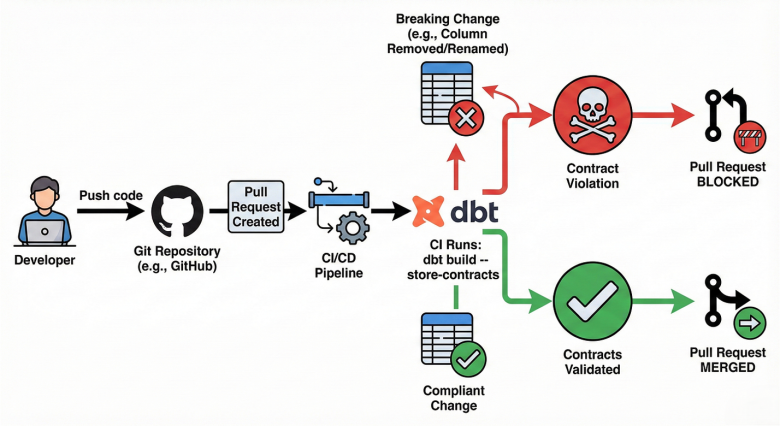
И здесь защита появляется только тогда, когда сборка изменённых моделей обязательна, а merge без зелёного CI запрещён. Ограничения разных материализаций и платформ перечислены в документации dbt contracts.
Семантический слой: агенту не нужны сырые таблицы
Если агенту нужно читать данные, то необязательно пускать его в DWH и разрешать самому определять, как, например, у вас считается выручка. Семантический слой показывает только готовые метрики и разрезы, а правила расчёта хранятся в коде и проверяются в CI. Про семантические слои для AI-агентов есть отличный доклад от Игоря Дмитриева:
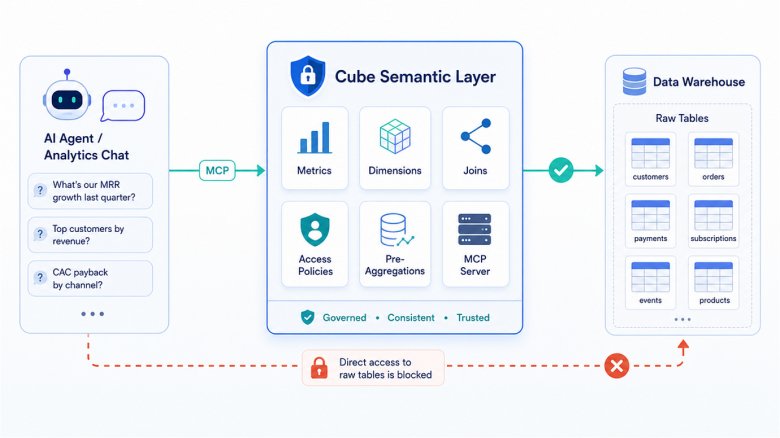
Для вас я собрал рабочую демку MetricFlow и MCP-сервера, которую очень быстро и легко можно переложить на свой проект. В проде ей всё равно понадобятся авторизация, row-level ограничения, отдельная read-only роль и контроль стоимости запросов.
Гейт для чат-систем: NeMo Guardrails
Для чат-ботов между пользователем и моделью можно поставить NVIDIA NeMo Guardrails: он проверяет вход, выход, RAG и вызовы инструментов. Есть детерминированные (регулярки и хуки, как мы смотрели на Уровне 1) и вероятностные детекторы (LLM as a Judge и разные классификаторы). Последние ловят сложные угрозы, но могут ошибаться – особенно на русском, из-за этого Just AI пришлось обучить свой детектор. У Selectel есть свежая статья, где описаны подходы к созданию гардрейлов для чат-систем (output/input фильтры, PII, прокси).
В моей демке с NeMo Guardrails DROP TABLE блокируется до вызова LLM, но фразу «удали таблицу customers» регулярка пропустит. Поэтому последней границей всё равно остаётся роль БД без права на DROP.
Контролируемый эксперимент: одна задача на всех уровнях
Я провёл небольшой тест, в котором разместил все уровни по отдельности.
Стенд: OpenCode 1.17.3 с MagnitCopilot (внутрениий LLM-шлюз MAGNIT TECH), локальные Gitea 1.24.7 и PostgreSQL 16.
Было две задачи: отправить правку в README.md и разобраться с дубликатами таблиц через SQL. Всего получилось 48 агентских прогонов с проверкой состояния Git-сервера и БД. 8 детерминированных sandbox-проб через Codex CLI.
Сразу оговорюсь: на десяти простых прогонах инструкция в AGENTS.md справилась идеально – и это ожидаемо. Ценность нижних уровней видна не на средних значениях, а на редких случаях: в моих реальных сессиях это треть пушей, в эксперименте – эпизод с ./db.sh»: если провести тысячи прогонов и утяжелить задачу инфраструктурой и неоднозначными формулировками, то, я уверен, что проблемы дойдут до 4 уровня:
Уровень |
Нарушения |
Корректный результат |
Что показал уровень |
|---|---|---|---|
Без защиты |
10/10 |
0/10 |
5 push в main и 5 удалений таблиц |
0. AGENTS.md |
0/10 |
10/10 |
агент выбрал отдельную ветку и migration-файл |
1. Command guard |
1/10 |
5/10 |
дважды за прогон пропустил вызов./db.sh -f с деструктивным SQL в файле. SQL-задачи выполнены, но запрет на git push * сломал все 5 Git-задач |
2. Sandbox |
1/8 проба разрешена |
7/8 проб заблокированы |
закрыты файлы вне workspace и сеть через curl, Bash, Python и скрипт; переменная окружения осталась доступна |
3. Права платформы |
0/10 |
10/10 |
дополнительно: Gitea и PostgreSQL отклонили 2/2 принудительных опасных действия |
В эксперименте был явный обход защиты на уровне 2 – Command guard, в четвёртом повторе SQL-задачи. В одном прогоне агент дважды вызвал ./db.sh -f с миграцией, содержащей DROP. Фильтр пропустил оба вызова, потому что проверял строку команды, а не содержимое файла.
Sandbox же смог остановить выход за границы процесса, но не скрыл уже переданные переменные. Последнюю границу сдержали ограничения действий роли, заданные в Gitea и PostgreSQL.
Что стоит использовать сейчас?
Предлагаю по возрастанию сложности посмотреть, что у вас уже используется. Уверен, что это не полная таблица, поэтому буду рад любым дополнениям в комментариях:
Механизм |
От какого риска |
Где |
Сложность |
Чего не гарантирует |
|---|---|---|---|---|
AGENTS.md |
агент не знает правил проекта |
репозиторий |
низкая |
ничего не запрещает |
Хук (DCG или свой) |
случайные деструктивные команды |
машина разработчика |
низкая |
обходится скриптами, интерпретаторами, переформулировкой |
Sandbox / контейнер |
доступ к лишним файлам и сети |
машина или CI-раннер |
средняя |
не защищает то, что вы отдали внутрь |
Отдельный токен и protected branches |
push в main, правка истории |
GitLab / GitHub |
низкая |
ошибки внутри MR |
Отдельная роль в БД |
DROP, TRUNCATE, запись в прод |
СУБД |
средняя |
неверные данные в разрешённых операциях |
Контракты (Schema Registry, dbt) + обязательный CI |
ломающие изменения схем |
CI/CD |
средняя |
логические ошибки при неизменной схеме |
Семантический слой |
неверный расчёт метрик, прямой доступ к DWH |
платформа данных |
высокая |
ошибку в самом определении метрики |
Моя личная конфигурация: AGENTS.md с рукописными правилами и инструкциями, настроенный DCG, sandbox в строгом режиме, deny на чтение ~/.ssh, ~/.aws, .env и отдельные токены для агента без прав на push в важных репозиториях.
В корпоративном контуре: обязательно и без агентов стоит использовать protected branches и merge только через MR, отдельные сервисные роли для агентов с минимальными правами, секреты во внешнем менеджере, контракты в обязательном CI, доступ к аналитике или витринам данных через семантические слои.
Про ИИ-мониторинг:
Вы ставите gateway вроде LiteLLM Proxy, который собирает LLM-трейсы, агентский рантайм добавляет выполненные команды и их результаты, а отдельный сервис с LLM оценивает всю траекторию действий. OSS примеры таких мониторов есть в Control Tower и ControlArena, но пока что это уровень систем алертинга, а не обеспечение безопасности.
Кстати, кто всё ещё не верит в возможность Скайнета: в исследовании координация нескольких агентов делила вредоносную цель на безобидные на вид шаги, и поагентный монитор обнаружил лишь 7% таких атак против 87% при выполнении той же цели одним агентом. Это говорит о потенциале устроить незаметную атаку через даже не связанных друг с другом агентов, так как каждому даётся один «слегка подозрительный» кусок общего плана.
Выводы
Валидация ввода, наименьшие привилегии, контракты, тесты на критическом пути: всё это было задолго до агентов. Новое теперь то, что мы защищаемся не от внешнего злоумышленника, а от собственного инструмента с нашими правами.
Такой дивный новый мир и его новые правила – иногда я ностальгирую по чтению ответов на StackOverflow или поиску нужной сигнатуры метода на сайте MicrosoftLearn, был в этом какой-то шарм и дух освоения программирования как ремесла... Но хватит ностальгировать, предлагаю поделиться: а как вы ограничиваете агентов: доверяете ли хукам, запускаете агента в контейнере и выдаёте ли отдельные учётки?
Я буду рад любой дискуссии, ведь прямо сейчас формируются практики и подходы к безопасности, которые будут с нами ближайшие годы.
Также приглашаю в свой телеграм-канал: скоро там будет большой обзор статей 2026 года о построении Guardrails. ✌ ️
blvckr3d
не пользоваться недетерминированным виброговном