

Часть 1. Введение
Добрый день, меня зовут Сергей Головкин.
Написать данную статью меня побудило осознание того, что очередной pet проект, возможно, будет полезен ИТ сообществу как решение или набор идей и реализаций, заложенных в него.
По роду деятельности мне на протяжении десятилетий приходилось сталкиваться со сложными интеграционными проектами, использовать десятки инструментов для их реализации и в какой то момент родилась мысль попробовать создать идеальный для меня инструмент, ориентированный на работу с данными, который исключал бы все то, что меня ранее раздражало в других решениях.
Так как ранее я имел опыт разработки языков программирования и визуальных средств проектирования, то оставалось собрать все знания и мысли в продукт и реализовать это.
В статье я хочу рассказать и показать то, что у меня получилось - Универсальный Язык Трансформаций (UTL) и интеграционная платформа, его реализующая.
Часть 2. Предпосылки
Почему именно специализированный, а не универсальный язык программирования
По моим наблюдениям, за последние 20 лет, на рынке труда в сфере ИТ произошло исчезновение такой квалификации сотрудника как «инженер». То есть если раньше вузы готовили инженеров, готовых решать любые задачи любыми имеющимися средствами, или же создавая эти средства, то теперь на рынке труда в ИТ прослеживается четкое разделение на аналитику и программирование.
В результате, в области решения интеграционных задач образовался вакуум. Аналитики, знающие системы, которые требуется интегрировать или же предметную область, очень слабо представляют себе реальное программирование во всяких модных средах и фреймворках, а программисты, прекрасно разбирающиеся в инструментарии программирования (языки, фреймворки) слабо представляют себе те процессы и документы, которые они автоматизируют.
Это становится очень заметно на этапе автоматизации взаимодействия нескольких слабо связанных систем, особенно, если требуется интеграция не внутри компании, а с внешней независимой компанией.
Создание же специализированного языка для реализации интеграционных процессов потенциально снижает порог входа для интеграционных аналитиков и позволяет сместить фокус с программирования на аналитику, что позволяет сосредоточиться именно на решении поставленной задачи, а не на разбор и изучение десятков файлов сгенерированных IDE для конкретного языка программирования.
Почему именно текстовой декларативный язык, а не визуальная low-code среда
Поделюсь своим мнение о визуальных low-code системах. Да они прекрасны, если требуется описать 10-20 «шагов-квадратиков» и если все существующие элементы, предоставляемые этим визуальным дизайнером, подходят вам. Но в большинстве случаев, если требуется реализовать более чем 10-15 «кубиков на экране» пользоваться визуальным редактором становится практически невозможно. Как пример, представьте себе количество стрелочек, если надо сопоставить два формата включающих более чем 100, а порой и 1000 атрибутов сложных вложенных документов требующих логики преобразований. И это я не говорю про ситуации, когда требуемого «кубика в палитре инструментов» нет, а это практически всегда. И тут low-code плавно превращается в «кубик» в котором подключается внешний модуль, написанный на одном из универсальных языков программирования.
В тоже время, языковые среды разработки (IDE) очень сильно продвинулись в части реализации различных подсказок, генерации шаблонов, что позволяет снизить порог входа в любой язык программирования, не заставляя новичка запоминать все названия и имена объектов и полей. Ну и конечно же появление AI в средах разработки, очень бы хотелось иметь возможность просто написать фразу «хочу код по конвертации из формата данных X в формат Y без смс и регистрации».
Часть 3. Пример задачи
Стоит задача реализовать подписание документа системы из Х через сервис «Госключ».
Документ уже передается в какую либо интеграционную платформу для последующей обработки и хранится в отдельном файловом хранилище.
Документ имеет свой уникальный бизнес формат, требуется организовать процесс подписания в «Госключе» и сохранение подписи в файловом хранилище вместе с оригинальным документом.
Интеграция с «Госключем» может быть реализована либо через непосредственный вызов API «Госключа» либо через СМЭВ по формату «Госключа» в СМЭВ.
Для того, что бы реализовать задачу надо осуществить не очень сложную, на первый взгляд, трансформацию данных из формата системы Х в формат СМЭВ и из формата СМЭВ в формат системы Х и формат API файлового хранилища, что бы сохранить подпись.
Пример реальный, из него только убрана вся специфика конкретного проекта и системы, в рамках которого осуществлялась реализация интеграции и так как компания уже давно обменивается документами через СМЭВ, то выбран этот подход реализации.
Кажется задача достаточно простая, берется описание с сайта СМЭВ, берется описание формата системы Х, описание API файлового хранилища и …..
Вот тут и начинается, что формат СМЭВ это XML и для него есть XSD схема, формат системы Х вообще описан только в конфлюенсе в табличном виде колонок – название поля, тип поля, комментарий, формат API – это REST и есть только swagger генерируемый онлайн микросервисом файлового хранилища.
Часть 4. Решение задачи
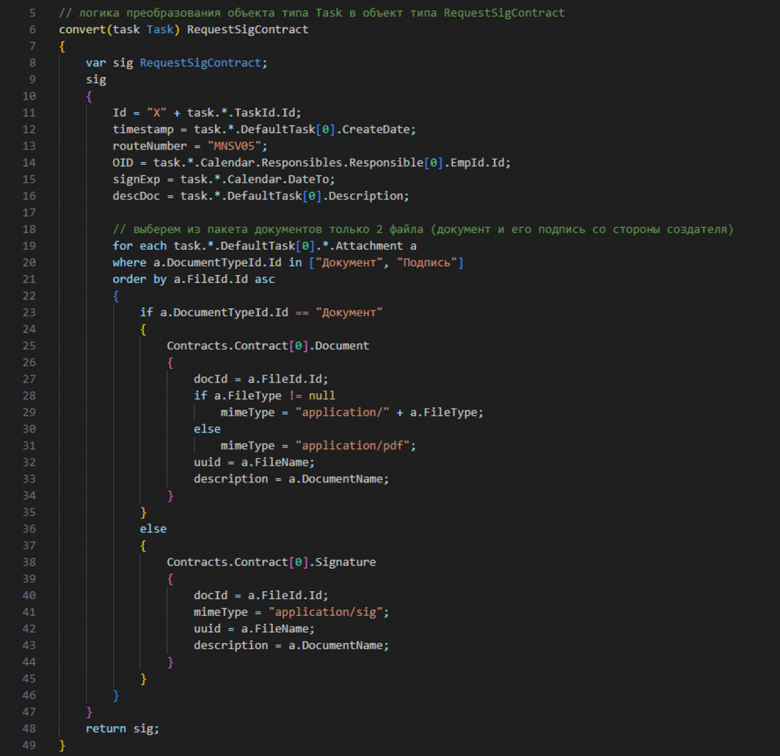
В случае создания нового формата взаимодействия между системами аналитик может на языке UTL описать требуемые объекты.
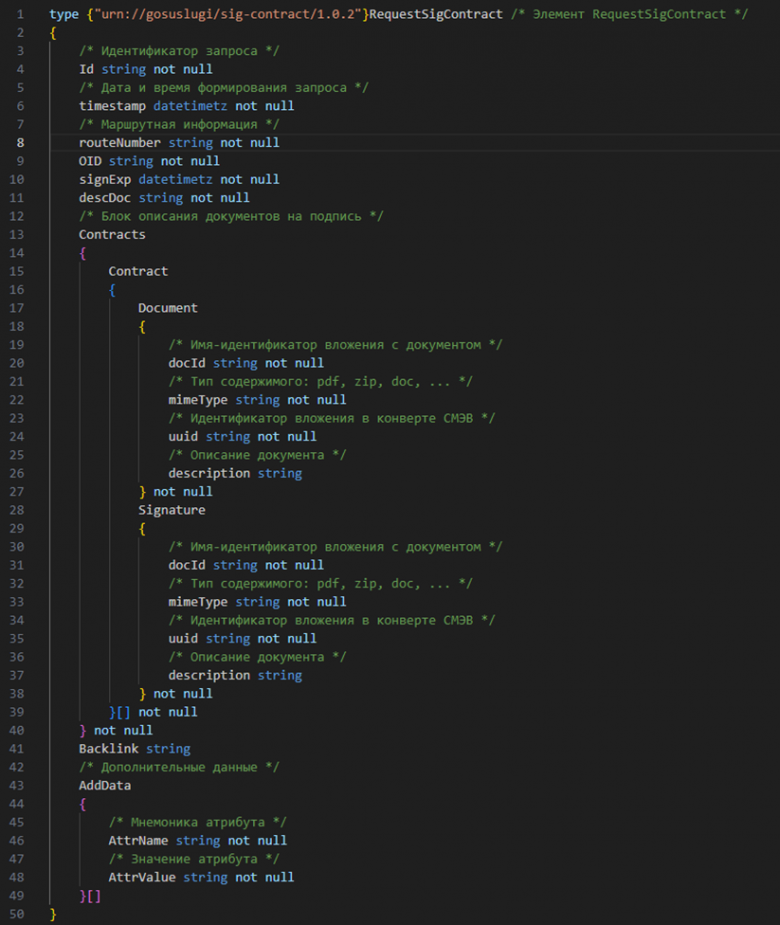
Но в большинстве случаев, разработка взаимодействия между системами осуществляется в момент, когда и система-источник и система-приемник уже имеют описания API или форматов выгрузки и загрузки данных и требуется всего лишь их использовать.

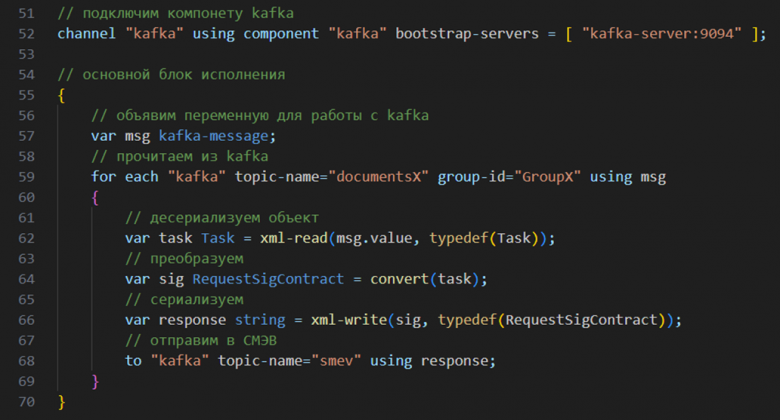
Данные как правило получаются из каких либо систем источников, а возвращаются в системы приемники.
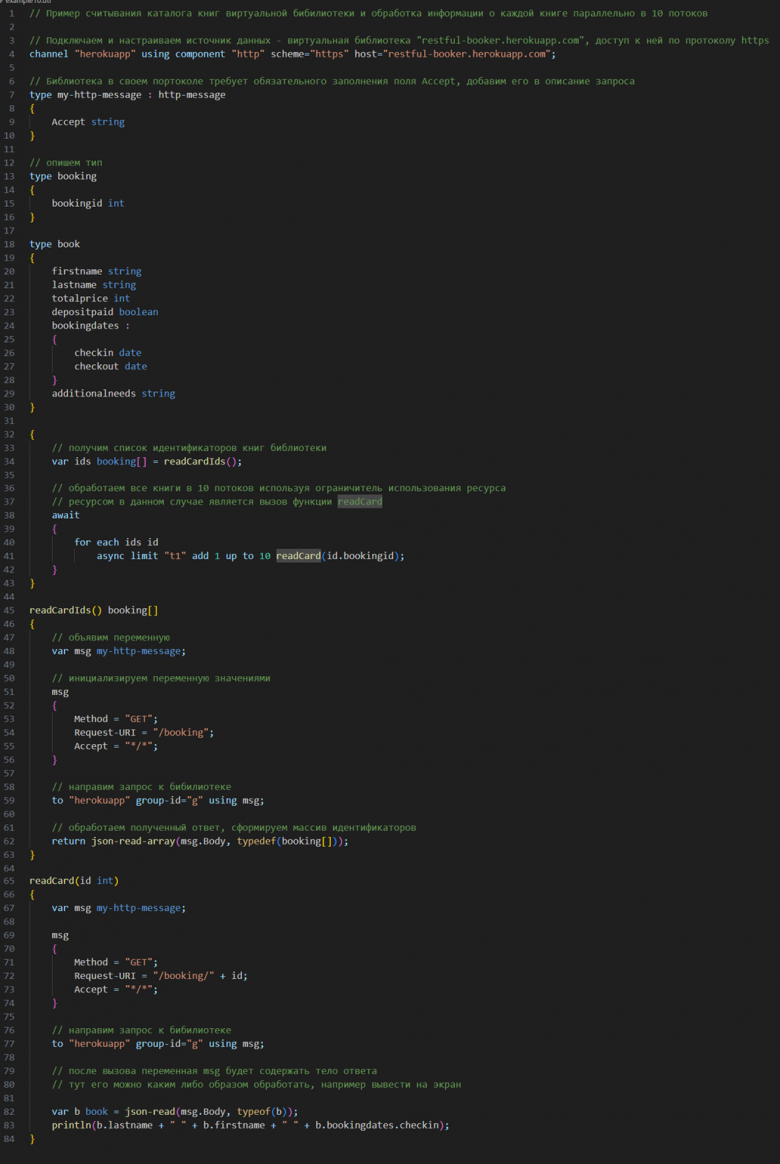
Если требуется обрабатывать большой поток документов, то можно обработку оформить как функцию и вызвать ее исполнение параллельно
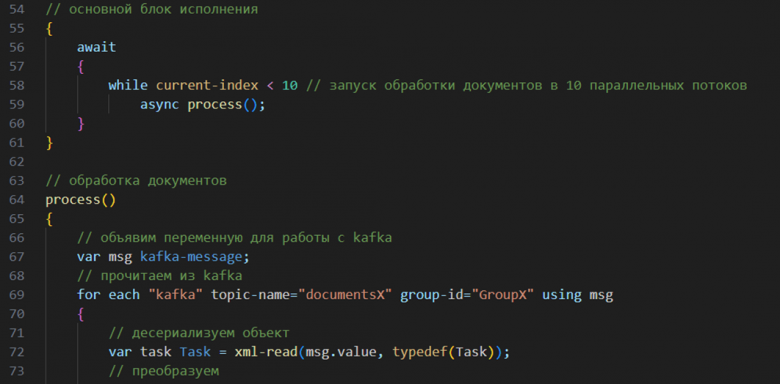
Еще один, полный, пример многопоточной обработки списка книг виртуальной библиотеки, он полностью работоспособен, можете попробовать реализовать его в вашем любимом инструментарии.
Часть 5. Общее описание интеграционной платформы UTL
Разработана интеграционная платформа UTL, которая полностью реализует весь синтаксис декларативного языка UTL, а так же предоставляет среду разработки, отладки и исполнения.
Одним из модулей интеграционной платформы UTL является расширение для среды VS CODE, реализующее языковый сервер со следующим функционалом:
подсветка синтаксиса.
-
синтаксический и семантический контроль правильности с подсветкой ошибок.
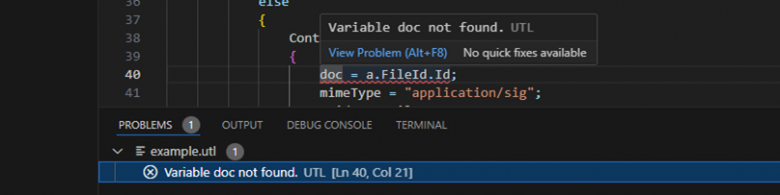
-
подсказки для конструкций языка и описанных или импортируемых объектов и переменных.
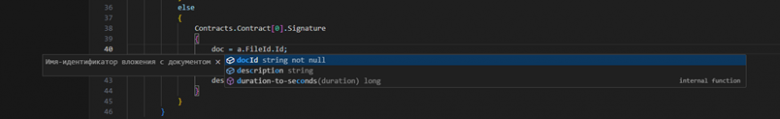
-
переходы по элементам языка, переменным, функциям и полям комплексных типов.
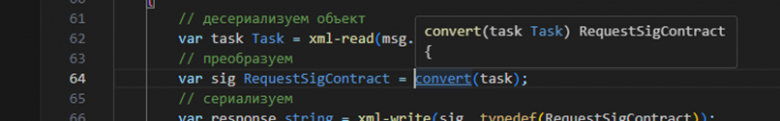
-
отображение использования переменных, функций и полей комплексных типов.
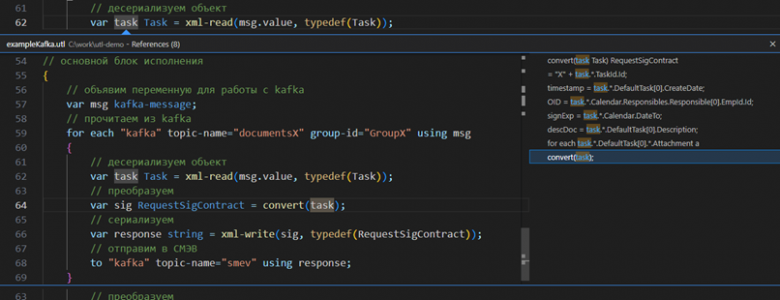
В настоящее время в интеграционной платформе UTL реализована загрузка описания комплексных типов из следующих форматов – XSD, JSON-schema, скомпилированных классов JAXB, AVRO-schema, (GraphQL-schema, PROTOBUF-schema – в процессе), а так же сериализация и десериализация объектов в/из указанных форматов.
Написание полноценных описаний невозможно без проверки, одним из модулей интеграционной платформы UTL является расширение для среды VS CODE, реализующее отладчик со следующим функционалом:
полноценный отладчик с пошаговой отладкой, включая многопоточные скрипты.
поддержка точек остановки всех видов.
просмотр переменных простого и комплексного типов.
исполнение динамических выражений в окне отладки.
-
подсказки в окне отладки, аналогичные языковому серверу
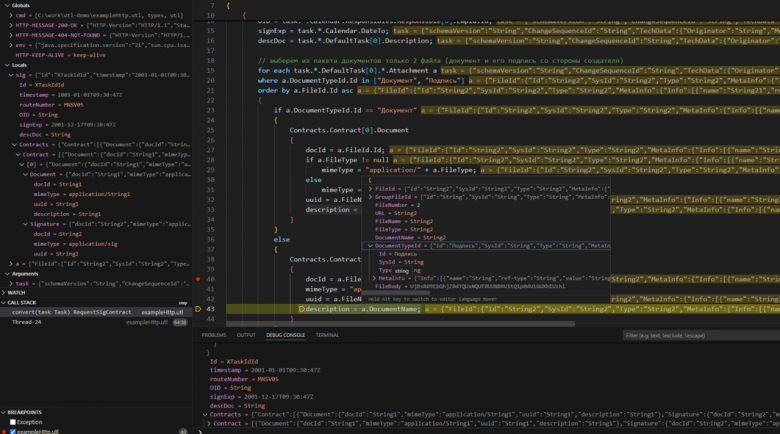
Так же реализована полноценная среда исполнения скриптов на языке UTL с открытой архитектурой, позволяющей независимым разработчикам писать компоненты для нее или встраивать ее в свои решения.
в виде JAR библиотеки для встраивания.
в виде самостоятельного приложения.
Заключение
Синтаксис языка разработан более трех лет назад и сейчас достаточно стабилен.
Среда разработки, отладки и исполнения тоже в определенной мере стабилизированы.
В языке и платформе UTL реализованы такие механизмы как:
sql подобные запросы для работы с массивами, возможность работать сразу с несколькими массивами. (for each)
поддержка работы с динамическими массивами и map
разделение скриптов на модули, наличие команды include для подключения модулей.
конфигурация как код и возможность настраивать скрипты через переменные окружения и параметры командной строки на этапе компиляции.
вызов функций из внешних JAVA модулей. (function from)
наличие открытого API реализации подключаемых компонент. (channel from), сейчас полностью реализованы компоненты работы с RabbitMQ, Kafka, HTTP/S, файлами формата Excel (xslx) и другие.
встроенная в язык и среду исполнения система логирования. (log)
встроенная в язык и среду исполнения система формирование метрик производительности и ошибок в JMX и Prometheus. (metrics)
обработка ситуаций, когда код исполняется медленнее, чем указанно в параметрах назначения или указанного перцентиля (on perf alert)
указание недопустимых условий исполнения (assert)
обработка ошибок и исключительных ситуаций. (throw, on error finally)
возможность повторного исполнения или пропуска блоков кода или конкретной команды, в случае ошибочных ситуаций в момент исполнения. (retry block, retry statement, skip block, skip statement)
асинхронное многопоточное программирование, наличие системы блокировок, включая распределенные блокировки между несколькими запущенными экземплярами среды исполнения интеграционной платформы UTL. (await all, await any, async, lock, unlock)
возможность ограничения работы блока кода ожидаемым временем исполнения (await timeout)
поддержка транзакций для компонент их поддерживающих. (tx)
возможность управления доступом к ограниченным ресурсам. (limit)
-
возможность присваивания «похожих» объектов (оператор присваивания ≈)
и многое другое …
Более детальный обучающий курс обо всех особенностях использования интеграционной платформы UTL можно посмотреть на RuTube канале UTLang. Смотрите видео онлайн, бесплатно
В планах – расширение количества компонент для работы с различными источниками данных.
Если статья вызовет определенный положительный интерес, то возможно создание цикла статей с описанием всех особенностей реализации интеграционной платформы UTL с примерами использования.
akardapolov
Все-таки это тяжело - работать с текстовым представлением pipeline-ов. Мне например (да и многим) нужна визуализация. В этом направлении, например, идут разработчики Apache Camel (стандарт для интеграции разнородных источников данных, не смотрели его?) - Camel Caravan.
Sergey_Golovkin Автор
да, я в курсе практически всех средств интеграции.
apache camel и его сопроекты использовал более 14 лет, так же аналоги pentaho, бизталковых серверов итд
и мой опыт показывает , что после некоторого уровня сложности разработчик начинает тратить больше времени борясь с такими визуальными средами, а не занимаясь бизнес задачами
VitaminND
" после некоторого уровня сложности " - как часто встречается такой уровень сложности, что визуальная low-code среда начинает путать?
Было бы здорово, наверное, предусмотреть разные варианты:
90% - визуальное построение, так как пайплайн простой
10% - язык для сложных случаев
Sergey_Golovkin Автор
а зачем что тот"рисовать", если сейчам проще агенту дать отписание словами и он сгенерил намного быстрее чем это отрисуется мышкой.
ведь все, что есть в лоукоде должны запрограммировать другие, а язык всегда будет более гибок
VitaminND
Вчера написал SQL на 2,5 тыс строк.
Насколько проще и быстрее было бы это сделать на SAP Hana CalcView, где выборки и обработки графически делаются...
Sergey_Golovkin Автор
а что заняло большую часть строк? перечисление полей?
Sergey_Golovkin Автор
сейчас же среды разработки легко подсказывают и таблицы и колонки в них, то же самое в языках с объектами - можно просто начинать писать имя поля, а полный путь среда покажет и подставит.
ведь среда разработки уже давно не notepad.
сам ораклист с 90х, все время toad использовал, нормальные подсказки и форматирование - вот ключ.
зато, можно прекрасно отслеживать различия в разных версиях запросов
Sergey_Golovkin Автор
вдогонку, ранее ведь redhat выпускала fuse и там были плагины для эклипса с визуалтным построением маршрутизации, но что то все это не прижилось.
akardapolov
AI меняет весь IT ландшафт просто какими-то невообразимыми темпами. Для меня это очевидно.Примеров тому масса и тут и на других ресурсах.
Какие-то нишевые решения останутся, которые являются де-факто стандартами и поверх них накрутят разных интеллектуальных ассисентов (если чего-то нет) и все - задача решена. Ну, там делать по большому счету нечего - двигаться надо дальше (отдельная и большая тема - куда).
Значит кривое было и неудобное для использования и в далеком прошлом (по меркам IT). Вот и весь сказ. Такого полно, в части визуальной работы с pipeline-ами (и не только) мало действительно удобных приложений. Но сейчас время другое, удобно и функционально с помощью AI можно сделать достаточно быстро и не тратить годы и месяцы на разработку (если что - опыт в этом деле в наличии).
Sergey_Golovkin Автор
поэтому я и выбрал именно язык, а не визуальную нотацию, так как прикрутить к языку ai сейчас не является проблемой.
имхо проблемой на ближайшие годы останутся галлюцинации ai в виде тысяч строк на изучение которых надо потом потратить сотни часов, если разговор не про примеры, а реальные большие проекты.