

Отказоустойчивый PostgreSQL — задача с неожиданно большим количеством инфраструктурных зависимостей. Patroni требует внешнего DCS, Stolon строит кластер вокруг keeper/sentinel/proxy и тоже опирается на внешнее хранилище, CloudNativePG ориентирован на Kubernetes, а repmgr оставляет часть задач обеспечения HA на стороне пользователя.
Мне хотелось другое: один бинарник на узел, который сам управляет PostgreSQL, сам обеспечивает консенсус и одинаково работает на обычных серверах, виртуальных машинах и в Kubernetes. Готового решения с такими свойствами я не нашёл — и написал tembo, HA-агент для PostgreSQL на Go со встроенным Raft и локальным хранилищем на bbolt.
В статье разберу, как устроены архитектура, fencing, failover и switchover, как это проверено тестами и — не менее важно — где проходят границы гарантий, которые нужно понимать до того, как доверить системе production.
Предыстория: как я выбирал и почему не подошло ничего
Требование было простое: единый механизм запуска и управления PostgreSQL — и на хостах/ВМ, и в Kubernetes. Список кандидатов: Patroni, repmgr, CloudNativePG, Stolon.
repmgr: просто, но без настоящего консенсуса
repmgr — набор утилит плюс демон repmgrd; внешнего хранилища не требует, и это поначалу привлекало. Но решения о failover standby’и принимают по факту взаимной видимости, а защита от split-brain — опциональный witness, который ещё надо правильно разместить. Маршрутизации клиентов нет: VIP, DNS или прокси вы переключаете своими скриптами. И, по моему впечатлению, релизный цикл выглядит довольно медленным: последний опубликованный релиз — 5.5.0 от ноября 2024 года (по состоянию на ноябрь 2026-го). Кандидат отпал.
CloudNativePG: отлично, но это Kubernetes-оператор
CloudNativePG — отличное решение для куба: оператор сам управляет failover через Kubernetes API, без прослойки вроде Patroni. Но он предназначен для эксплуатации PostgreSQL именно в Kubernetes, и не везде его получится использовать. При требовании “и на хосты, и в куб” кандидат отпал.
Stolon: хорошая идея, грустная реальность
Со Stolon знаком давно, и мне он нравился: Go, чёткое разделение ролей, декларативное описание кластера. Но жить с ним не вышло по двум причинам.
Первая — проект выглядит заброшенным: последний релиз 0.17.0 вышел в сентябре 2021 года, и с тех пор активность в репозитории практически отсутствует.
Здравый вариант напрашивался сам: форкнуть Stolon и продолжить развитие самостоятельно — код на Go, лицензия позволяет. Я всерьёз рассматривал этот путь и отказался: для моих требований архитектура оказалась неудобной — я не хотел ни внешнего store, ни разделения управляющей логики на несколько типов процессов, а форком это не вылечить, только вырезать вместе с фундаментом.
Stolon состоит из трёх ролей: keeper (управляет PostgreSQL), sentinel (детектирует отказы и выбирает новый master) и proxy (точка входа клиентов; роли описаны в документации Stolon). Состояние целиком живёт во внешнем хранилище — etcd или Consul, то есть поверх узлов PostgreSQL нужен ещё один отказоустойчивый кластер со своей эксплуатацией и бэкапами. Sentinel’ы принимают решения о failover по данным, которые keepers записали в хранилище, — сама база консенсуса не достигает. Риск, который меня не устраивает (оговорюсь: это риск по чтению архитектуры, а не воспроизведённый сбой): связность keeper’а master’а с хранилищем деградирует, sentinel’ы инициируют failover, клиенты stolon-proxy защищены — но keeper, не сумевший прочитать новое решение, оставляет свой PostgreSQL master’ом для всех, кто подключён к нему напрямую, мимо proxy. Независимой гарантии, что такой keeper остановит PostgreSQL, я в этой схеме не нашёл.
С Kubernetes в качестве хранилища есть ещё одна проблема: clusterdata живёт в ConfigMap, и его надо бэкапить отдельно от данных. Сценарий, с которым я сталкивался: потерял ConfigMap — потерял состояние кластера, а повторный init заставляет keeper’ы заново инициализировать PostgreSQL поверх существующих данных. «Лёгкий» вариант без etcd превращается в вариант, где бэкап ConfigMap критичнее бэкапа WAL.
Patroni: тащит полмира за собой
Patroni — решение зрелое и проверенное, с огромным количеством production-инсталляций; к его логике failover у меня вопросов нет. Внешний DCS — осознанный архитектурный выбор, а не дефект. Мои вопросы — к поставке и эксплуатации:
Python-стек. Драйвер PostgreSQL, библиотеки для REST и YAML, клиенты поддерживаемых DCS — конкретный состав зависит от компонентов, но базовый список немаленький, а каждая зависимость — потенциальная CVE и пересборка образа. В организациях с требованиями ИБ к supply chain это отдельный процесс.
Внешний DCS обязателен. etcd, ZooKeeper, Consul или Kubernetes API — ещё одна распределённая система в критичном пути.
Особенности запуска в Kubernetes. Kubernetes API как DCS — это RBAC-манифесты, тонкости с ServiceAccount и зависимость отказоустойчивости базы от отказоустойчивости apiserver, плюс зоопарк Spilo-образов, операторов и чужих Helm-чартов.
Мне хотелось проще: один бинарник, статически собранный, с минимальным деревом зависимостей, который сам решает консенсус и сам управляет PostgreSQL. Такого не нашлось — пришлось написать. У такого решения есть и обратная сторона: корректность критичного протокола теперь — ответственность проекта, а экосистема и боевая проверка tembo несопоставимо моложе патрониевской. Подробнее — в разделе про тесты.
Что такое tembo
tembo — HA-агент для PostgreSQL на Go. Ключевые свойства:
Нет внешнего DCS. Консенсус — встроенная минимальная реализация Raft поверх HTTP, персистентность — один файл базы bbolt на узел. Состояние кластера (кто primary, конфигурация, история событий) — реплицированное key/value-пространство в том же файле.
Один управляющий процесс на узел. Агент запускает и супервизит локальный PostgreSQL, участвует в выборах, обслуживает API и два клиентских прокси. Не нужны отдельные keeper/sentinel/proxy.
Один бинарник — и демон, и CLI.
tembo runзапускает узел, остальные команды (status,switchover,members, …) — HTTP-клиенты к API любого узла; запросы, меняющие состояние, сами редиректятся на лидера Raft (HTTP 307).Малое дерево зависимостей.
Архитектура
Кластер — нечётное число узлов, на каждом один и тот же бинарник:
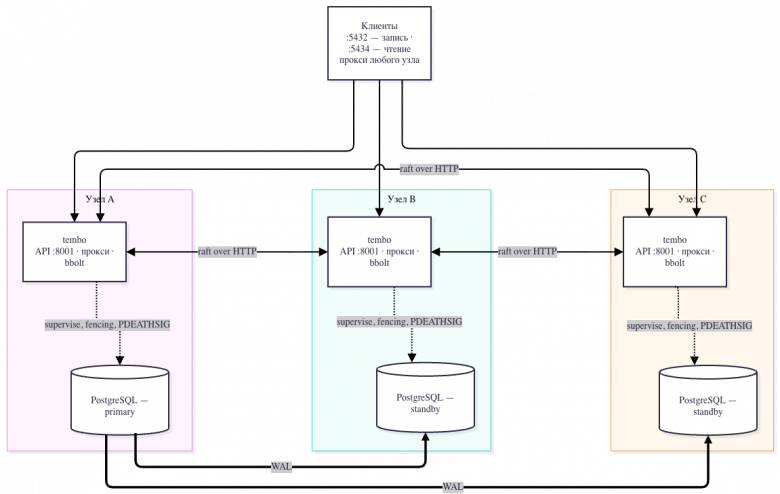
Узел — это API-порт (raft RPC, CLI, метрики), два прокси (запись на primary, чтение по standby), локальный bbolt с raft-логом и реплицированным состоянием, и PostgreSQL, которым агент управляет end to end. Внутри агента — несколько независимых циклов с периодом в секунду: Watch на лидере опрашивает узлы и проводит failover/switchover, reconcile приводит локальный PostgreSQL к состоянию кластера (останавливает, промоутит, чинит — но никогда не запускает), supervise перезапускает упавший PostgreSQL, route направляет прокси. Общаются они только через реплицированное хранилище и опросы статусов, так что зависший цикл не блокирует остальные.
Для координации используется встроенный Raft: каждый узел участвует в консенсусе, состояние кластера хранится в локальном bbolt — отдельный DCS вроде etcd или Consul не нужен. Реализация включает выборы лидера, репликацию лога, смену состава кластера через joint consensus (members add/remove на живом кластере, без рестартов — с обычной для Raft оговоркой про кворумы при партиции), компакцию и снапшоты. Я сознательно отказался от pre-vote, leader lease и батчинга: лог — это несколько ключей конфигурации, а не поток данных. Записи коммитятся на диск до реакции на них, применение к локальному состоянию атомарно (индекс и эффект в одной транзакции bbolt), а внешние эффекты в PostgreSQL идемпотентны: reconcile каждый тик сравнивает желаемое с фактическим и действует только на расхождение.
Высокая доступность
Правил мало, и все они построены на временных константах: опрос и reconcile раз в секунду, свежесть кворума — 5 секунд, замена молчащего primary — после 15 секунд, максимальная длительность switchover — 60 секунд.
Fencing
Главное свойство: primary, потерявший кворум, перестаёт принимать записи сам, без участия лидера. Узел считает, что кворум есть, если за последние 5 секунд он знал лидера Raft и получил ответы от большинства. Потерял — на следующем тике reconcile останавливает PostgreSQL в режиме immediate. Поверх этого два дополнительных яруса: postmaster привязан к агенту через Pdeathsig SIGQUIT (при смерти агента ядро пошлёт postmaster’у SIGQUIT — аварийный механизм, а не STONITH: сигнал привязан к потоку-создателю, и у него есть гонки при установке), и прокси отказывают клиентам, пока узел не видит кворум.
Почему остановку выполняет сам агент, а не внешний механизм блокировок: это следствие того же принципа «один процесс на узел» — STONITH через IPMI или отдельный watchdog означал бы ещё один компонент, который сам нужно эксплуатировать и тестировать. Поскольку 15 секунд значительно больше 5, в штатном сценарии изолированный primary уже остановлен к моменту, когда лидер промоутит замену. Дополнительно новый лидер обязан понаблюдать за кластером полный таймаут сам — что видел предыдущий лидер, не считается.
Автоматический failover
Через ~15 секунд молчания primary лидер выбирает кандидата среди работающих standby: не nofailover, отставание от последнего известного положения primary не больше max-lag-on-failover (по умолчанию 1 МБ WAL), дальше по приоритету --failover-priority, затем предпочтение бывшему синхронному standby, затем больше WAL. Ключ primary коммитится через Raft, победитель делает pg_ctl promote — и только если сам видит кворум.
Порог в 1 МБ — только критерий отбора кандидата. Реальные потери могут быть больше: primary мог принять WAL после последнего отчёта реплики, но ещё не успеть передать его standby. Если подходящего кандидата нет, лидер ждёт, а не промоутит кого попало.
С «нулём потерь» при синхронной репликации похожая картина: гарантия складывается из условий. Синхронный режим включён; synchronous_node_count покрывает весь синхронный набор (при ANY 2 (b, c) и ровно двух участниках каждый коммит ждут оба standby); промоутится узел, фактически получивший подтверждённый WAL; и транзакция действительно ждала подтверждения — приложение может выставить synchronous_commit = local или off и обойти ожидание. Имеет значение и уровень ожидания: для сохранности при отказе primary и последующем отказе подтвердившего standby нужен как минимум synchronous_commit = on (WAL сброшен на диск реплики); remote_write подтверждает лишь запись в ОС standby и не спасает при сбое питания. Само по себе включение synchronous_mode безусловного zero data loss не даёт.
Условия измерения для «15–20 секунд» тоже назову: отсчёт идёт от последнего «живого» отчёта primary; цифра справедлива, когда Raft-лидер жив, кворум есть и подходящий standby существует. Если отказал сам лидер — выборы плюс собственные 15 секунд наблюдения нового лидера, итого до ~30 секунд. Нет кандидата или кворума — failover не состоится вовсе.
Возвращение старого primary: pg_rewind
Вернувшийся старый primary сам проходит pg_rewind и встаёт в standby: wal_log_hints = on tembo ставит дефолтом, оставшийся postmaster агент останавливает перед rewind, WAL для доигрывания удерживают слот узла и wal_keep_size. При долгом простое или исчерпании лимитов rewind может не состояться — и это нормальный путь к fallback’у: после десяти неудач при достижимом primary каталог очищается и клонируется заново (после неудачного rewind каталог может быть непригоден — fallback обязателен, а не опция). Вручную то же самое делает tembo reinit.
Switchover без потерь
Плановое перемещение primary (tembo switchover b, есть отложенный вариант --at <RFC3339>): прокси перестают принимать клиентов, primary останавливается в режиме fast: активные транзакции откатываются, клиенты отключаются, PostgreSQL завершается штатно, с чекпоинтом. Агент фиксирует shutdown-LSN, и лидер промоутит цель, только когда та его достигла. Потери закоммиченных транзакций — ноль, недоступность — секунды; не уложились в 60 секунд — операция отменяется с записью в историю.
Репликация и слоты
synchronous_mode = off / quorum / strict; synchronous_standby_names пересчитывается primary раз в секунду по реально стримящим standby, так что standby, который подключился, но не стримит, не блокирует коммиты. На каждый узел primary держит физический слот, живущий ровно членство узла в кластере. Для PostgreSQL 17+ tembo выставляет свою часть условий failover-слотов (sync_replication_slots, hot_standby_feedback, primary_slot_name, dbname в conninfo); за оператором — слоты с failover = true, проверка synced перед failover и решение про synchronized_standby_slots (он закрывает окно «подписчик потребил WAL, которого нет на standby», ценой задержки декодирования). Есть каскадные реплики (--follow) и DR-копии чужого кластера (--standby-of).
Конфигурация, доступ, эксплуатация
Кластерный postgresql.conf — реплицированный ключ: tembo config set shared_buffers=256MB валидирует значения на живом PostgreSQL до коммита и раскатывает по одному узлу (standby, потом primary; понижение лимитов hot-standby — наоборот). Параметры, которыми управляет агент, и векторы исполнения кода (shared_preload_libraries, archive_command, …) заблокированы — плата за это: preload-расширения включаются вручную на каждом узле.
На каждом узле два TCP-прокси: :5432 на primary, :5434 по standby; при switchover или потере кворума прокси отказывают в соединении. Прокси пересылают сырой TCP: аутентификация и TLS остаются между клиентом и PostgreSQL.
Из операционного (всё есть в документации): reinit, логические dump/restore, физические backup/restore-backup (в т.ч. стримингом в S3), история failover’ов, метрики Prometheus (агент, Raft, совместимый с postgres_exporter набор pg_*), psql-сессия на узле через API (tembo shell, включая Kerberos-имперсонацию).
Для тестирования и CI это тоже удобно: дампы и бэкапы ходят через тот же CLI поверх API
# dump
~ tembo dump > dump.sql
~ tembo restore < dump.sql

# backup
~ tembo backup > base.tar
~ tembo --addr 10.0.0.3:8001 restore-backup < base.tar
На машине, откуда это запускается, не нужно ничего, кроме бинарника tembo: поток идёт по HTTP, а pg_dump/psql/pg_basebackup исполняются на узле. Поднять кластер, залить тестовый дамп, прогнать сценарий, пересоздать разъехавшийся standby (reinit) — всё из того же CLI, без SSH и установки клиентских инструментов PostgreSQL.
Безопасность: модель и её главное ограничение
Модель слоистая, и первый слой — сеть: TLS (опционально) → адресный allowlist → аутентификация (опционально) → обработчик. Allowlist общий для API и прокси: loopback, адреса членов кластера и адреса из host-строк pg_hba.conf — поэтому, открывая приложению доступ к PostgreSQL через settings set-hba, вы открываете ему и API, а при выключенной аутентификации это полный доступ, включая raft RPC. Аутентификация API — JWT (включая JWKS), Kerberos/SPNEGO, LDAP, mTLS; мутирующие запросы и отказы пишутся в аудит-лог. Пароль суперюзера общий на кластер и между ротациями лежит в открытом виде в bbolt-файле узлов — либо защищайте этот файл, как pgpass, либо используйте интеграцию с OpenBao, где пароль в файлы узлов не попадает вообще.
Самое серьёзное ограничение tembo на сегодня — здесь: API и raft-транспорт в текущей версии нельзя считать изолированными друг от друга. API-аутентификация не защищает /raft/* и /status; TLS с --tls-ca-file защищает транспорт и проверяет сертификаты CA, но сам по себе не привязывает сертификат к члену кластера — CA для межузлового TLS должна быть выделенной. Одного включения TLS и API-аутентификации для недоверенной сети недостаточно: API-порт следует считать доступным только из доверенного сегмента, а широкие пользовательские CIDR в pg_hba.conf недопустимы. Разделение allowlist’ов и строгая идентификация участников — в roadmap.
Kubernetes и Consul
В k8s tembo не оператор и не требует CRD: конфигурация читается из ConfigMap/Secret (--k8s cm://ns/name), узлы именуются по имени пода. Режим, когда DCS’ом служит Kubernetes API с его leases и RBAC, отсутствует как класс — консенсус свой, поэтому отказ apiserver не останавливает работающий кластер. Один и тот же бинарник запускается и на ВМ, и в кубе. Вместо статического --peers можно использовать discovery через Consul — но как источник адресов, не как хранилище состояния.
Сценарий: отказ primary, по шагам
Кластер из трёх узлов, A — primary. Рвём связность A с B и C:
A перестаёт получать ответы от большинства. Через 5 секунд у него протухает кворум, на следующем тике reconcile (до 1 с) его агент останавливает PostgreSQL в режиме
immediate.Для B и C отказ A виден даже раньше fencing’а: цикл route проверяет, что узел из ключа
primaryответил на последний опрос. A из ответов выпал — цель записи обнуляется, прокси отказывают новым клиентам и закрывают уже установленные соединения к убранной цели (речь про прокси на исполняющихся узлах; прокси на самом A при зависшем агенте заморожен вместе с ним). Запись недоступна с момента, когда опрос обнаружил недоступность A; чтение со standby продолжает работать.Через 15 секунд молчания A лидер выбирает кандидата (скажем, B — он был синхронным standby), коммитит
primary = Bчерез Raft.B на следующем тике делает
pg_ctl promote. Прокси на всех узлах перенастраиваются на B. Запись вернулась: суммарно ~15–20 секунд недоступности.Связность восстановлена. A узнаёт из кластерного состояния, что primary теперь B, проходит
pg_rewindи встаёт standby. Событие лежит вtembo history.
Воспроизводится локально: docker compose up --build поднимает три узла, дальше — docker network disconnect tembo_tembo-a для сценария партиции выше. Отдельный вариант — docker compose pause tembo-a: он замораживает все процессы контейнера, включая PostgreSQL, так что это демонстрация «узел завис целиком»; после unpause агент A просыпается, видит, что primary уже B, и уводит свой PostgreSQL в standby.
Границы этой демонстрации: она показывает партицию при работающем агенте. Опасный режим из раздела про fencing — заморожен только процесс агента, а PostgreSQL жив — она не проверяет; для этого нужен отдельный тест с SIGSTOP именно агенту, он в roadmap.
Быстрый старт
Репозиторий: github.com/ks-tool/tembo. Нужны Linux, Go для сборки (go build -o tembo .) и бинарники PostgreSQL в PATH (проверялось с 17 и 18 — дефолты вроде sync_replication_slots рассчитаны на 17+). Три узла, общий пароль в TEMBO_PG_PASSWORD:
TEMBO_PG_PASSWORD=... tembo run --id a \
    --peers a=10.0.0.1:8001,b=10.0.0.2:8001,c=10.0.0.3:8001 \
    --pg-data /var/lib/postgresql/a
# аналогично для b и c; первый узел делает initdb, остальные клонируют его
Порты: API/метрики — 8001, прокси записи — 5432, прокси чтения — 5434, PostgreSQL — 5433. Клиенты подключаются на прокси любого узла. Проверка, что кластер собрался: tembo --addr 10.0.0.1:8001 status покажет состояние Raft, primary кластера и локального PostgreSQL; tembo members list — состав. Локальный кластер в Docker: docker compose up --build. А если HA не нужен, узел без --peers работает standalone — без Raft, всегда primary.
Честные ограничения
Нет pre-vote в Raft. После разделения сети возможны короткие бури выборов; формальной верификации и Jepsen-прогона не было.
Программный fencing. Гарантии опираются на исполняющийся агент и на то, что приложения ходят через прокси; аппаратного STONITH нет (подробности — в «Границах гарантии fencing»).
Модель безопасности сегментная. Allowlist общий для API, прокси и raft RPC;
/raft/*и/statusосвобождены от API-аутентификации — API-порт должен находиться в доверенном сегменте.Один пароль на кластер в открытом виде в store-файле каждого узла — снимается интеграцией с OpenBao.
Целевая платформа — Linux из-за
Pdeathsig; на macOS fencing опирается только на перезапуск агента.Нет role-based health-эндпоинтов для внешних балансировщиков; есть
tembo health(«200, пока локальный PostgreSQL отвечает»).Нет lifecycle-хуков;
shared_preload_librariesчерез кластерную конфигурацию не задать.
Из вероятных следующих шагов: pre-vote, role-based health-эндпоинты, отдельный allowlist для raft-транспорта, хаос-тестирование длительных партиций — включая сценарий «заморожен только агент, PostgreSQL жив» (SIGSTOP процессу агента), который в этой статье разобран теоретически, но ещё не прогнан как тест.
Итоги
Таблица ниже — не оценка «кто лучше», а карта архитектурных различий: у каждого решения свой ответ на вопрос «где живёт правда о кластере и кто останавливает старый primary». Строку про защиту от старого primary читайте с оговоркой: механизмы не эквивалентны — решение о смене primary само по себе не останавливает PostgreSQL, его ещё должен исполнить агент на старом primary, так что программный fencing в том или ином виде есть у всех решений из таблицы.
repmgr |
Stolon |
Patroni |
CloudNativePG |
tembo |
|
|---|---|---|---|---|---|
Поставка |
C, утилиты + repmgrd |
Go, keeper/sentinel/proxy |
Python + зависимости |
Go, оператор |
Go, один бинарник |
Координация |
взаимная видимость; witness опционален |
внешний store (etcd/Consul) |
внешний DCS (etcd/ZK/Consul/k8s) |
Kubernetes API |
встроенный Raft + bbolt |
Защита от старого primary |
решение с witness; сам fencing — внешние средства/скрипты |
решение sentinel; proxy закрывает соединения со старым master, keeper приводит PostgreSQL к clusterview |
демоция агентом при потере блокировки в DCS |
роль и остановка через instance manager оператора |
локальный агент (программный fencing), прокси, Pdeathsig |
Где работает |
хосты/ВМ |
хосты/ВМ + k8s |
хосты/ВМ, k8s через k8s API |
Kubernetes, нужны CRD |
хосты/ВМ и k8s без CRD |
Изменение состава |
register/unregister |
через store |
через DCS |
оператор |
joint consensus, без рестартов |
Сравниваются типичные схемы развёртывания, а не все возможные конфигурации: тот же Patroni умеет работать и вне Kubernetes, и с разными DCS.
tembo моложе любого из них, и экосистемы у него пока нет. Взамен: автономность (нет внешнего DCS), компактная поставка (один бинарник, двенадцать прямых зависимостей), единый механизм для ВМ и Kubernetes и модель отказов, которую можно прочитать целиком в исходниках. Если вам, как и мне, ближе идея «консенсус — часть агента, а не отдельная распределённая система» — репозиторий открыт, документация покрывает архитектуру, консенсус и эксплуатацию, а обратная связь — то, ради чего статья и написана.
Комментарии (2)

Sleuthhound
12.11.2026 06:19Привет, не буду ковырятся в техничке и что-то критиковать, а пройдусь по верхам.
1) Всю статью говорили про 1 бинарь - и где же он? В репе его нет. Готовых пакетов под разные ОС для пакетных менеджеров тоже нет. Очень странный подход.
2) Название проекта tembo выбрано ИМХО явно неудачно, Вы бы хоть погуглили. Имя уже занято 100500 разными проектами, как большими и узнаваемыми, так и всякой мелочью.
3) Ни слова про реальный опыт эксплуатации. Это продакшен реди решение? Вы внедрили его у себя в компании? На скольких кластерах? Сколько дней/недель/месяцев удачной эксплуатации? Какие собраны баги/проблемы? Или это какой-то пет-проект для 1 заказчика?
polkiloo
Можно рассмотреть как альтернативу https://github.com/polkiloo/pacman - предлагаю объединить усилия !