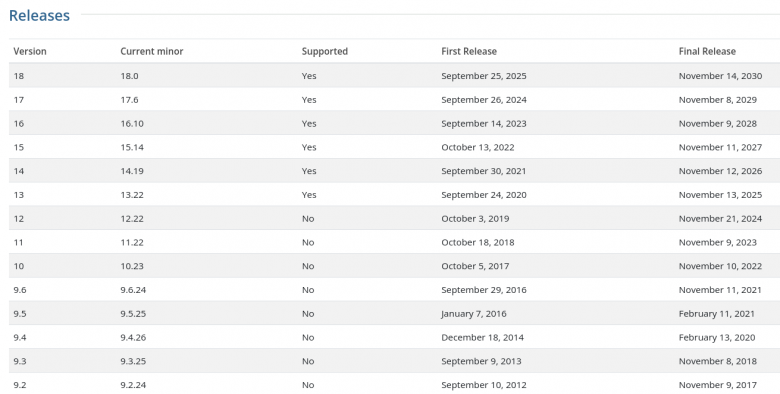
19 ноября 2026 года состоялся релиз стабильной версии СУБД PostgreSQL 19. Обновления для новой ветки будут выходить в течение пяти лет до ноября 2031 года. Подготовка к выпуску PostgreSQL 19 проходила в рамках годового цикла разработки проекта. Поддержка PostgreSQL 14.x, самой старой из поддерживаемых веток, была прекращена 12 ноября 2026 года.
По данным OpenNET, основные изменения и дополнения в PostgreSQL 19:
улучшена реализация подсистемы асинхронного ввода/вывода, позволяющей увеличить пропускную способность ввода/вывода и избавиться от задержек. В универсальной реализации AIO (io_method=worker) появилась возможность автоматического увеличения или уменьшения числа запущенных процессов‑обработчиков ввода/вывода в зависимости от нагрузки. Для определения минимального и максимального числа процессов‑обработчиков, а также таймута неактивности перед завершением и задержки перед запуском процессов, предложены параметры io_min_workers, io_max_workers, io_worker_idle_timeout и io_worker_launch_interval;
применяемый в AIO планировщик упреждающего чтения оптимизирован для повышения производительности запросов, требующих загрузки большого объёма данных с диска. Оптимизация реализована за счёт адаптивного определения допустимого числа операций упреждающего чтения в зависимости от характера и размера запроса (например, для операций сканирования крупных таблиц и индексов теперь заранее подгружается с диска больше данных). Для анализа выполнения операций ввода/вывода в асинхронном режиме в команду «EXPLAIN ANALYZE» добавлена опция «IO»;
добавлены расширения pg_plan_advice и pg_stash_advice для передачи планировщику запросов параметров‑подсказок на мини‑языке «plan advice», позволяющих влиять на выбор планов выполнения, фиксировать выбранные планы и экспериментировать с разными планами. Для получения списка параметров, выбранных планировщиком при выполнении запроса, в команду EXPLAIN добавлена опция «PLAN_ADVICE», а для выставления своих параметров перед выполнением запроса можно использовать выражение «SET pg_plan_advice.advice = 'строка со списком параметров'». Расширение pg_stash_advice дополняет pg_plan_advice возможностями для привязки параметров к идентификаторам запросов, чтобы не добавлять их перед каждым запросом;
в процесс автоматического запуска очистки (autovacuum) добавлена возможность параллельного использования нескольких обработчиков при выполнении чистки индексов. Число обработчиков настраивается через опцию autovacuum_max_parallel_workers. Также добавлены новые опции autovacuum_vacuum_score_weight, autovacuum_vacuum_insert_score_weight и autovacuum_analyze_score_weight для определения приоритета очистки таблиц;
реализована новая стратегия очистки, позволяющая сократить объём работы в будущем, благодаря обновлению карты видимости страниц во время сканирования таблиц при выполнения SELECT‑запросов, не дожидаясь запуска команды VACUUM;
добавлена новая SQL‑команда «REPACK» для перестроения таблиц с меньшими накладными расходами. Команда REPACK полностью перезаписывает всё содержимое таблицы в новый файл на диске, что позволяет вернуть операционной системе место на диске, которое занимают неиспользуемые блоки. В отличие от команды «VACUUM FULL», во время перезаписи выставляющей жёсткую блокировку, в команде REPACK имеется опция «CONCURRENTLY», при указании которой во время переупаковки допускается использование таблицы другими транзакциями. В отличие от расширения pg_repack, REPACK заметно быстрее, так как не прикрепляет к таблице дополнительные триггеры, но не поддерживает обработку целиком секционированных таблиц;
до двух раз повышена производительность операции INSERT для таблиц, в которых выполняется проверка записей по внешним ключам (Foreign Key). Ускорение достигнуто за счёт привлечения индекса для проверки внешнего ключа, что позволило обойтись без выполнения ресурсоёмкого внутреннего запроса к таблице;
в планировщике запросов обеспечено распознавание операций Anti‑Join (определение строк из первой таблицы, для которых отсутствуют совпадения во второй таблице) в сложных запросах с «LEFT JOIN» и запросах с выражениями «NOT IN» для задействования специфичных оптимизаций. Расширено применение инкрементальной сортировки. Добавлена оптимизация «eager aggregation», выносящая операции агрегирования на стадию до слияния таблиц для сокращения числа строк, обрабатываемых в процессе слияния. Ускорено параллельное выполнение операций последовательного сканирования (parallel seq scan). Реализовано сведение конструкций «IS DISTINCT FROM» и «IS NOT DISTINCT FROM» к выражением с операторами «<>» и «=», если оба операнда не могут принимать значение NULL;
повышена эффективность доставки уведомлений при помощи команды NOTIFY в конфигурациях с несколькими каналами уведомлений. В разделяемой памяти теперь сохраняется карта каналов, позволяющая адресно обращаться только к бэкендам, подписанным на заданный канал;
в команду INSERT добавлена поддержка выражения ON CONFLICT DO SELECT... RETURNING, возвращающего записи, в случае невозможности их добавления через «INSERT», в дополнение к выражениям «ON CONFLICT DO NOTHING/UPDATE», молча игнорирующих конфликты при вставке или выполняющих обновление вместо вставки;
в команду COPY добавлена поддержка вывода данных в формате JSON;
в язык SQL/JSON добавлены методы обработки строк lower(), upper(), replace(), split_part() и btrim();
в оконных функциях lead(), lag(), first_value(), last_value() и nth_value() добавлена поддержка выражения «IGNORE NULLS» для пропуска значений NULL;
добавлена команда «WAIT FOR LSN», которая при асинхронной репликации для предотвращения вывода устаревших данных позволяет приостановить SELECT‑запрос на реплицированном сервере до тех пор, пока не применятся изменения с основного сервера, соответствующие определённой LSN‑позиции (Log Sequence Number) в WAL‑логе;
в функцию random() добавлена поддержка типов date и timestamp для генерации случайных дат и времени в заданном диапазоне;
добавлена возможность создавать на языке PL/Python функции для триггеров событий (event trigger);
в принимающий сетевые соединения сервер добавлена поддержка TLS‑расширения SNI (Server Name Indication) для использования TLS‑сертификатов в привязке к именам хостов, к которым обращается клиент при установке шифрованного соединения по одному IP‑адресу;
в файл конфигурации postgresql.conf добавлен параметр password_expiration_warning_threshold, при помощи которого можно настроить вывод предупреждения о скором истечения времени действия пароля;
включён по умолчанию вывод предупреждений при использовании алгоритма MD5 при аутентификации, который объявлен устаревшим. Для отключения подобных предупреждений добавлен параметр md5_password_warnings;
добавлены представления: «pg_stat_lock» для просмотра накопленной статистики о блокировках в привязке к типам блокировок; «pg_stat_recovery» для получения информации о состоянии операций восстановления; «pg_stat_autovacuum_scores» для определения приоритета обработки таблиц в autovacuum. Во многие системные представления добавлен столбец «stats_reset», в котором отражено последнее время очистки счётчиков. В представления «pg_stat_progress_vacuum» и «pg_stat_progress_analyze» добавлен столбец «started_by», в котором показывается инициатор операции. В представление pg_stat_progress_vacuum добавлен столбец «mode», отражающий применяемый режим чистки;
добавлена возможность указания минимальных уровней информативности логов (log_min_messages) в привязке к типам процессов;
в статистику, показываемую после операций VACUUM и ANALYZE, а также в представление «pg_stat_wal», добавлены сведения о размере записанных в WAL‑лог полных страниц, что упрощает разбор причин излишнего разрастания WAL‑лога (можно понять связан ли рост с использованием параметра full_page_writes);
в механизме логической репликации реализована поддержка реплицирования значений последовательностей (SEQUENCE), которые можно публиковать командой «CREATE PUBLICATION» при помощи выражения «FOR ALL SEQUENCES»;
добавлен синтаксис «CREATE PUBLICATION... EXCEPT» для репликации всех таблиц за исключением явно указанных;
добавлено выражение «CREATE SUBSCRIPTION... SERVER», позволяющее создавать подписки логической репликации, получая настройки подключения от стороннего сервера;
добавлена возможность включения логической репликации на лету без перезапуска сервера, даже если параметр «wal_level» выставлен в значение «replica» вместо «logical». Для определения реально действующего уровня журналирования, не привязанного к настройке wal_level в файле конфигурации, добавлен параметр «effective_wal_level»;
в механизме подключения внешних таблиц Foreign Data Wrapper (postgres_fdw) реализованы возможности для проброса операций с массивами на удалённый сервер и добавлена опция import_stats для импорта статистики для таблиц из внешнего сервера при выполнении команды ANALYZE для повышения эффективности локального планирования выполнения запросов;
по умолчанию отключена JIT‑компиляция так как заметный выигрыш в производительности она даёт в основном для тяжёлых аналитических запросов, а в обычных OLTP‑нагрузках может приводить к провалам в производительности из‑за ошибок при предсказании ресурсов, необходимых для выполнения запросов;
для повышения производительности сжатия и распаковки TOAST‑таблиц параметр «default_toast_compression» выставлен в значение «lz4»;
удалена поддержка аутентификации с использованием протокола RADIUS;
в команде «vacuumdb ‑analyze‑only» по умолчанию включён анализ секционированных таблиц.