

Всем привет! Пока прошлая статья про онлайн-шутер, разработанный с помощью ИИ, еще не остыла, пришло время поговорить про то, как вообще мы можем добиться хорошего результата, когда не пишем код самостоятельно. Для начала рекомендую прочитать про то, что же за проект получилось реализовать в прошлый раз.
Так же напомню, что статья пишется руками, без генераций, и хочется верить, что такой формат еще живой и мы не будем подтверждать теорию мертвого интернета... Кстати, на прошлой статье все мои дефисы (-) автоматом стали длинными тире.
1. О том, что такое harness
Не буду сильно углубляться в различные определения харнеса, на одном только хабре есть около 40 страниц статей на эту тему, обойдемся "обывательским" уровнем, чтобы это было понятно широкой аудитории.
Есть у нас LLM - на вход текст, на выход текст. Уже хорошо. В самом начале оно так и работало и этим даже можно было пользоваться, вспомнить те же первые релизы ChatGPT. Но всё же хочется иметь что-то посерьезнее. Здесь у нас появляются tools от openai для моделей, ими обвешивают пайплайны LLM и на этот этапе получаем первое зарождение harness-а (хотя само определение появилось в начале 2026 года).
Выглядело это примерно следующим образом (и все это я собирал руками года 3 назад):
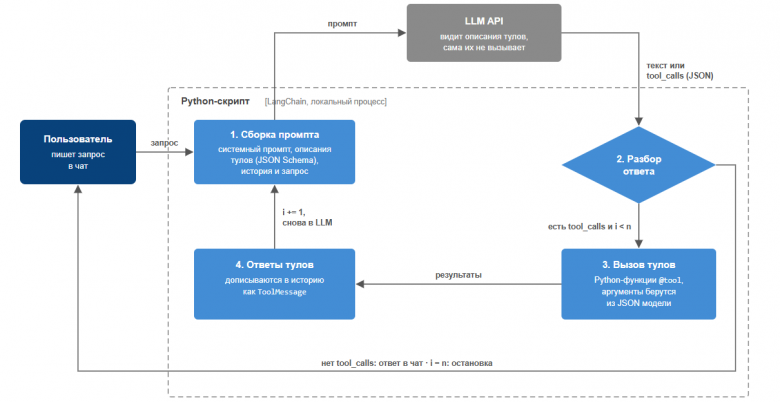
Затем устоялось определение "агент", появились мультиагентные системы, которые трактуются везде по-разному. Самое главное здесь, для проектов необходим глоссарий, который позволит всем быть в одном контексте.
В общем, были "голые" LLM, потом появились тулы, агенты и различные обвязки вокруг. Как раз-таки эти обвязки стали фундаментом для осознанного harness-а.
Agent = LLM + Harness
Модель умеет рассуждать, харнесс делает всё остальное... Крутит наш цикл, запускает инструменты, хранит память, кэш, проверяет результат и т.д.
Термин закрепился в начале 2026 года после текстов Митчелла Хашимото (HashiCorp), отчета OpenAI о Codex и статей LangChain.
Основные его компоненты следующие:
Цикл - вызывает модель, пока не выполнит задачу или не упрется в лимит
Инструменты - обрабатывает tool_call от модели, вызывает код инструмента
Контекст - сборка промпта для модели с учетом всех обвязок
Ограничения - роелвая модель, бюджеты токенов и т.п.
Проверки - прогон LLM as judge, guardrails
2. Стандартный harness
Фактически, все крупные игроки имеют свой харнесс. Anthropic - Claude Code, OpenAI - Codex и так далее. В любом чате уже по умолчанию доступны тысячи различных возможностей для автоматизации своей рутины. Например, такая "базовая" вещь, как загрузка файла в чат под собой может содержать множество логики, ведь файл надо куда-то загрузить, прочитать, распознать текст через OCR / Vision LLM, сохранить на S3-хранилище для доступа к нему как в истории, проверить, помещается ли он в контекст и еще множесто других аспектов.
На текущем этапе развития - стандартные процессы в рамках Claude Code и ему подобных могут с завидным качеством выполняться через one-shot промпт. Но что делать, если нам необходимо выстроить свой процесс, который будет удобен для конкретного продукта, чтобы агент всегда знал, как можно этим пользоваться и какой пайплайн действий ему надо выполнить?
3. Кастомизация процессов под проект
Самое первое, что можно сделать - создать claude.md / agents.md или как где этот файл называется. В нем содержатся инструкции для агента, которые он будет добавлять в свой промпт каждый раз, когда мы ему пишем. Здесь мы можем задавать все базовые инструкции для агентов, чтобы они их почти никогда не забывали.
Claude.md -> "Всегда начинай ответ с `!`"
___
User: Привет
Agent: !Привет, чем могу помочь?
Далее, нам необходмо настроить наш пайплайн по постановке задач. Можно использовать различные фреймворки в духе openspec, хранить их в отдельном репозитории рядом с остальными сервисами. Но для одного проекта в монорепозитории можно обойтись сабдиректорией /docs и хранить всю структуру внутри так, как будет удобно. В Claude.md мы кладем инструкцию, что необходимо начинать задачу с прочтения основного файла в папке docs, где будут лежать кросс-ссылки по другим md-документам (`"фича 1 - не реализовано - лежит тут "ссылка", архитектура - тут "ссылка"`). Так мы можем хранить небольшие файлы с конкретной задачей, чтобы отсрочить переполнение контекста. По опыту работы с LLM-моделями - после 60% контекста внимание моделей начинает теряться и необходимо либо открыть новый чат, либо вызывать скиллы compact для конткеста диалога.
Выглядеть это может все так (в упрощенном виде):
docs
|_ general.md
|_ tasks
|_ _ feature_1.md
|_ _ feature_N.md
|_ arhitechture.md
Остальной процесс пайплайна - на вкус и цвет, единственно верного подхода не существует, для каждой задачи стараемся брать наиболее удобный пайплайн. Где-то можно сделать жертву по скорости работы агентов для прохождения дополнительных проверок кода/тестов, где-то необходимо сделать прототип как можно быстрее и не смотреть на качество кода и так до бесконечности.
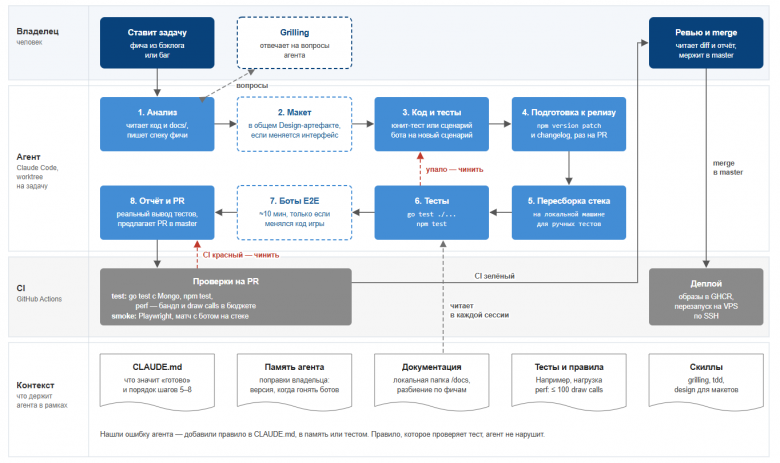
Что же было сделано для моего проекта. Схема работы над фичами достаточно простая, потому что большая часть пайплайна - линейная. Давайте посмотрим, как же оно работает:
Текстовое описание пайплайна
Я ставлю задачу через чат, провожу grilling-сессию (спасибо, Matt Pocock за его удобный плагин со скиллами)
-
Работа агента
Агент читает задачу, при необходимости вызывает скиллы
system-designи ему подобные (дефолтные от anthropic)Собирает макет через `claude design`
Пишет код, пишет тесты
Подготавливает системные файлы к релизу, поднимает версию пакета, пишет ченджлог
Собирает локальный стек и поднимает его (docker-образы)
Прогоняет все статические тесты
При изменении кода сервера, касающегося игровых механик прогоняет e2e-тесты (создаются реальные сессии на локальном стеке, туда запускаются боты, у которых есть определенные сценарии)
При успешном прохождени всех шагов, создает PR в github на master ветку
На github проходят линтеры ещё раз
Только человек (я) нажимает кнопку мерджа веток, после которой происходит деплой
Все на стенде, все счастливы
И более наглядно на схеме:
Подведём итоги
Итак, подходя к концу, можно сделать несколько выводов, которые, хоть и касаются одного конкретного проекта, но будут полезны во всех остальных:
Когда агент говорит "готово" - можно просто согласиться, а можно иметь слой проверок, которые это могут доказать (unit-тесты, e2e-тесты, статические анализаторы в духе sonarqube и т.п.). Агент может нарушить правила из инструкций, но упавший или переписанный для прохождения пайплайна тест будет заметен.
Harness растет по мере проекта. Полная аналогия с развитием архитектуры проекта - нельзя придумать всё так, как это будет выглядеть в итоговой реализации. Так же, как код не пишется без багов, мы не сможем предусмотреть сразу все нюансы. Например, в моем проекте было правило на e2e тесты - они проходят около 12 минут по длительности матча. Если я менял только frontend / backend - логика игры не трогалась и e2e-тесты были не нужны -> добавляем правило в наш в harness.
Чем меньше лишнего контекста задается модели - тем больше шанс, что получится более качественное решение, не будет лишнего дрифта по данным и не будет лишний итераций фиксов. Для этого мы можем вести спецификации или добавить папку с документацией в репозиторий. Это особенно актуально, когда мы используем low-tier подписки и хотим оптимизировать количество затраченных токенов на фичу.
Как всегда, приграшаю в комментарии подискутировать и порассуждать, как вы настраиваете свой harness, и вообще, считаете ли его чем-то полезным в повседневной работе.