

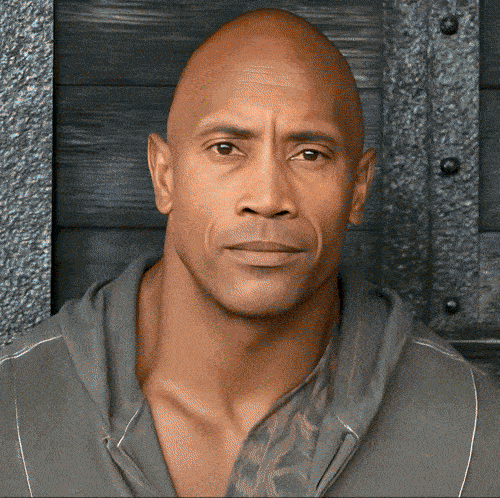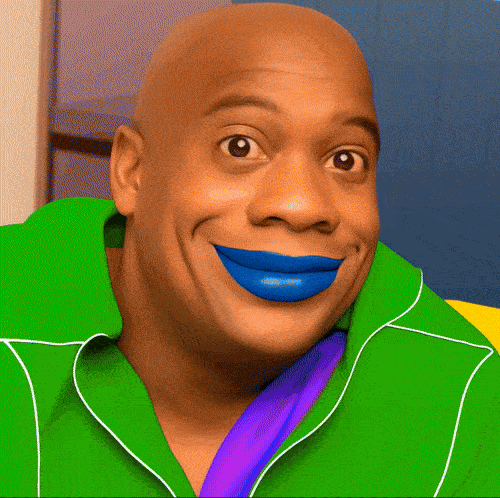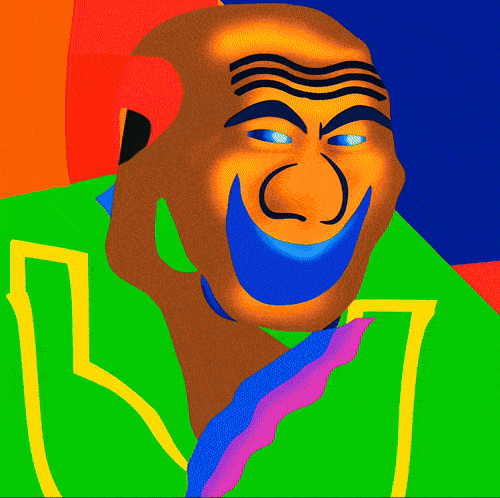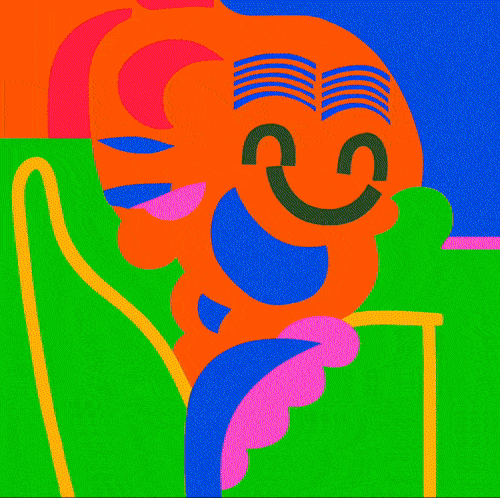
Человек попросил ChatGPT сделать точную копию картинки и ничего не менять. Дал настоящую фотографию Дуэйна Джонсона. С каждой итерацией фотография менялась до неузнаваемости, пока не превратилась в мультяшное месиво. На каждом шаге он просил ничего не менять.
С кодом то же самое. Ты сказал ИИ, какие шрифты использовать, и он использует один и тот же шрифт. Но размеры летают: на каждой страницы размеры шрифта свои. От этого теряется общая стилистика сайта.
Это архитектурный дрифт. Даю пример с фронтенда как самый простой для восприятия, но принцип распространяется и на все другие зоны разработки. Основная проблема в том, что разъезжается source of truth.
Код я не читаю вообще. Я контролирую только спеки. Ниже, как пофиксить дрифт в агентной разработке.
Архитектурный дрифт лечится тремя принципами. Правдой является не код, а документация (спеки).
Single source of truth задаётся спеками.
ИИ обязан сначала прочитать спеки, ассоциированные с выполняемой задачей, перед её исполнением.
Спек‑тесты детерминированным способом проверяют код на соответствие документации.
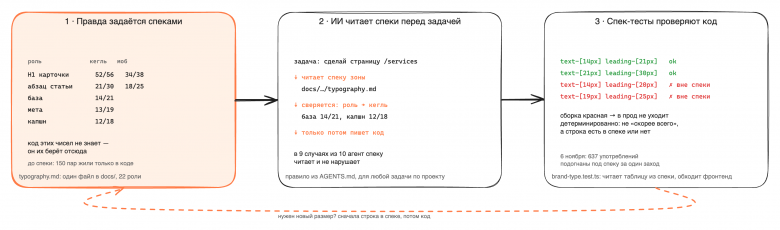
1. Single source of truth задаётся спеками
Истина не в коде
Как мы решаем проблему дрифта? С помощью принципа single source of truth. Истина находится в одном месте. И эта истина находится не в коде, а в документации.
Почему истина именно в спеке, а не в коде? Здесь работает архитектурный принцип: спека выступает в качестве чертежа, а код это деталь, которую вытачивают по заранее готовому чертежу. Деталь сверяется с чертежом, а не с другой деталью. Если в проекте два источника правды, это приводит к хаосу и к плохому коду.
7 тысяч документов, и это не свалка
Вся документация лежит в одной папке docs в корне проекта. Сейчас там более 7 тысяч документов, и каждый лежит на своём месте. Это не свалка, а структурированная папка с десятью уровнями вложенности, где в каждой папке в 90% случаев не более 7 файлов. Я структурирую по правилу 7 плюс‑минус 2: по ключевым сущностям в каждой папке не более 9 объектов. Поэтому я понимаю, где что находится.
папка docs на 5 ноября 2026 |
|
|---|---|
файлов.md |
7 478 |
уровней вложенности под docs |
11 |
папок, где не больше 7 файлов |
95,3% |
папок, где не больше 9 файлов |
97,4% |
Сама спека это просто.md файл, в котором прописано, что есть что. Спеку пишут агенты. Читают её тоже агенты. Я как пользователь читаю админку: у каждой спеки есть своя страница в админке, в которой прописано всё то же самое, но в более удобном для человека виде.
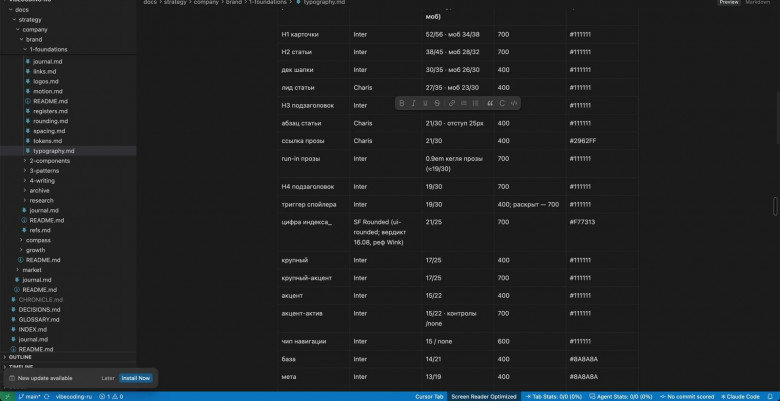
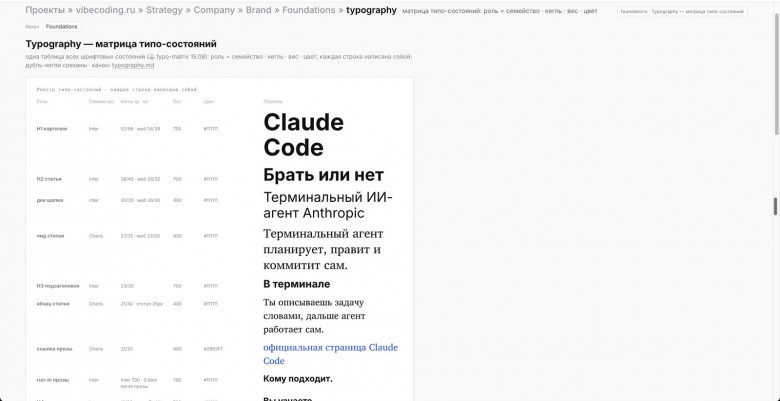
Один файл typography.md
На примере шрифтов. У меня все правила по типографике лежат в одном файле typography.md: все шрифты, размеры и цвета, как они выглядят на сайте.
Кусок реестра из typography.md, в полной таблице 22 роли:
роль |
семейство |
кегль (десктоп · моб) |
вес |
цвет |
|---|---|---|---|---|
H1 карточки |
Inter |
52/56 · моб 34/38 |
700 |
#111111 |
H2 статьи |
Inter |
38/45 · моб 28/32 |
700 |
#111111 |
лид статьи |
Charis |
27/35 · моб 23/30 |
400 |
#111111 |
абзац статьи |
Charis |
21/30 · отступ 25 px |
400 |
#111111 |
база |
Inter |
14/21 |
400 |
#8A8A8A |
мета |
Inter |
13/19 |
400 |
#8A8A8A |
капшн |
Inter |
12/18 |
400 |
#8A8A8A |
Два семейства на весь сайт: Charis для длинного чтения, Inter для всего остального. Веса только 400 и 700. (Из той же спеки: «состояний вне реестра не бывает: новая связка = новая строка по вердикту».)
Когда агент работает с каким‑то куском проблемы, у него есть конкретная папка, в которой находится нужная документация. Из‑за того, что каждый док на своём месте, агенту легко убедиться, что внутри папки ничто не противоречит задумке. Агент следит за тем, чтобы спеки находились в единообразном виде и ничто в них друг другу не противоречило.
2. ИИ читает спеки перед задачей
Его нужно заставить прочитать нужный док, и это прописано в базовом документе AGENTS.md. Там прописаны правила: он должен читать доки, которые соответствуют задаче. Когда мне нужно сделать изменение на сайте, агент сперва всегда прочитает папку с исходной документацией, и в 9 случаях из 10 не нарушит правила.
Например, я вижу, что улетели облачные расходы, и ставлю задачу провести аудит, разобраться, что можно подрезать. Агент должен пойти и прочитать всю документацию по облакам. Он увидит, что там есть отдельная папка прямо под это, увидит все облачные провайдеры и проанализирует их.
Из AGENTS.md, как есть:
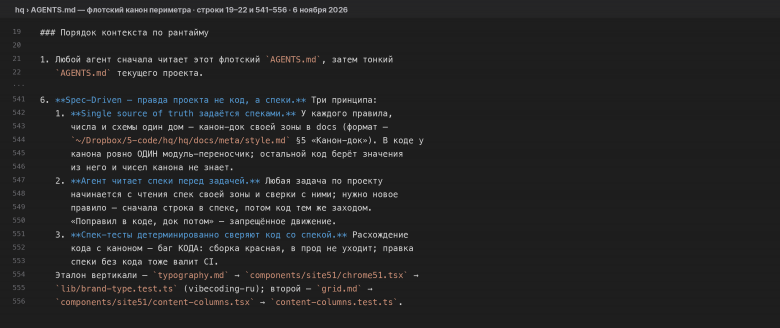
3. Спек‑тесты проверяют код
Спеки и админка находятся в недетерминированной плоскости: есть вероятность, что агент последует примерам или не последует. На десятый случай у нас есть спек‑тесты. Мы пишем тест на базе спеки. В спеке написаны допустимые размеры шрифтов, а спек‑тест смотрит, что на сайт не проходят другие размеры. Если мы выпускаем на сайт что‑то, что не проходит спек‑тест, оно не проходит.
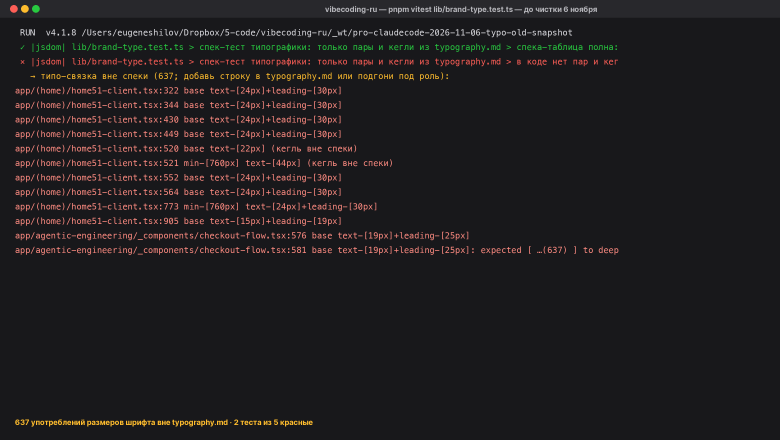
Тест читает две таблицы typography.md, собирает из колонки «кегль» разрешённые пары и обходит весь фронтенд. Пара или кегль, которых нет в спеке, валит сборку с именем файла и строкой:
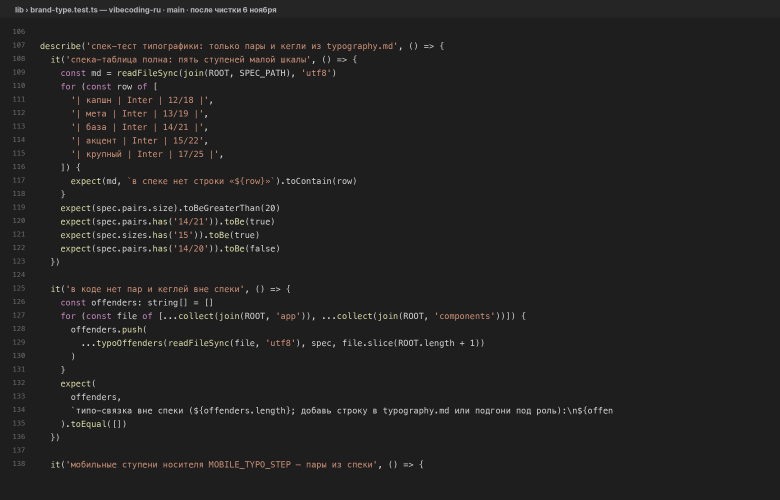
До 6 ноября этот тест был чёрным списком из девяти вытесненных пар. Когда я готовил эту статью, выяснилось, что в коде около 150 пар вне спеки. За один заход агент подогнал 637 употреблений под спеку, добавил в неё 4 недостающие строки и переписал тест в белый список.
когда |
что пришло от агента |
что сделал тест |
чем кончилось |
|---|---|---|---|
1 октября 2026 |
карточки цен на странице услуг с парами 14/20 и 12/16 |
сборка красная: «вытесненная типо‑пара» |
пары заменены на 14/21 и 12/18 из спеки, коммит 1797f67 |
Когда док и код разошлись
Когда док и код расходятся, в действие вступают три вещи. Первое, этап тестирования, который должен выловить проблему. Второе, self‑heal, который выловит проблему уже на проде. Про него будет отдельная статья. А если первое и второе не сработали, вступаю я как человек. Моя задача не выловить проблему, а понять, почему этот косяк прошёл, и сделать так, чтобы в следующий раз он уже не прошёл.
Постоянно бывает, что спека была, а агент сделал по‑своему. Зачастую это связано с тем, что агент не прочитал нужную спеку. Для этого у нас жёсткие правила, чтобы он читал. Но иногда приходится прямо ткнуть его в нужную спеку.
Коротко
Одна из основных целей всего подхода: иметь один single source of truth. И то, как мы это инфорсим спек‑тестами, это и есть то, как мы решаем проблему архитектурного дрифта.
Слово не новое: пару architectural drift / architectural erosion ввели Перри и Вульф в 1992 году в статье Foundations for the Study of Software Architecture. С агентами оно ожило снова: The Spec Growth Engine, октябрь 2026. На Хабре: «Что делать с архитектурным дрифтом в эпоху ИИ?», апрель 2026.
А где у вас находится source of truth: в коде, в доках или в головах? Напишите в комментариях, что у вас разъехалось первым.
Комментарии (7)

Dhwtj
06.11.2026 08:31Ну, если изменения не ревьювить то правда уже не в коде. А вот где она тогда это большой вопрос
Правда в самой системе (прод и пользователи).
Её слегка упрощенное отражение в ментальной модели в виде набора абстракций, удобных для понимания и изменения системы. А вот документирована ли она как "концептуальная модель" и поддерживается ли её актуальность? Этот этап уже делается реже, грубее, с ошибками.
Спеки уже сами по себе архитектурный дрифт.

shilovtech Автор
06.11.2026 08:31Согласен с первой половиной: правда в самой системе, в проде и у пользователей. И да, обычная документация дрифтует еще быстрее кода, птоому что ее пишут один раз для людей и потом не трогают.
Dhwtj
06.11.2026 08:31Та документация что для людей дрифтует медленно. А вот спеки уже быстро
shilovtech Автор
06.11.2026 08:31Быстро, если ее никто не читает. У меня спека не концептуальаня модель, написанная однажды. Это рабочий файл, который агент читает перед каждой задачей и правит в том же заходе что и код. Чтобы она не уехала, ее держит машина с двух сторон. До мержа спек-тест: читает правило из .md и валит сборку, если код с ним разошелся, а в части спек и наоборот, поравил спеку без кода - красный. После мержа селф-хил: 78 проверок раз в полчаса смотрят на живом сайте, что задачи, поставленные перед кодом, реально выполняются. Пример из августа: лента ноовостей у меня встала на три дня из-за пропущенного await. Ревью этого не видит, тесты не ловят, а проверка на проде поймала. Так что ревью не исчезло, оно переехало: я ревьюю спеку, а код проверяет машина, причем дважды.
astec
Формулировка „правда не в коде, а в спеке, а спек-тест валит сборку с файлом и строкой“ мне очень близка — особенно кейс с 637 употреблениями. Вопрос про цену: сколько таких детерминированных спек-тестов у вас сейчас, и кто их пишет чаще — вы или агент по шаблону? И как решаете, что уходит в жёсткий тест, а что остаётся „мягким“ правилом в AGENTS.md? Я делаю SpecScore.md как раз чтобы требования в репозитории можно было линтить и привязывать к проверкам, а не только читать.
shilovtech Автор
Спасибо. На сегодня: 6 570 тестов, из них 1 079 читают .md спек и сверяют с кодом. Пишут их агенты сами где считают нужным, по правилу из канона тестов, на который ссыалется AGENTS.md. Оно дословно такое:
shilovtech Автор
…«Спека с числом, списком или таблицей — спек-тест тем же заходом, что и спека. Кегли, палитра, сетка, маршруты, формулы денег, реестры инвариантов, пути файлов: все, что в спеке записано так, что машина может сверить». И про мягкое: «UI, контент, страницы, доки по смыслу — новые тесты не пишем. Голос текста, порядок разделов, как писать карточку — мягкое правило в каноне, его ловят глазами». Граница простая: если правило в спеке можно проверить машиной, его прроверяет машина. Где точно граница, нащупываю до сих пор. SpecScore посмортел, идея линтить спеку до того как ее читает агент, очень интересная. Подумаю как это можно внедрить у нас. Ну и 57 тыс контрибьюшенов за год на гитхабе - впечатлюящий результат :)