

Говорят, идут тёмные времена, железячное изобилие подходит к концу, производители процессоров и видеокарт переходят на производство серверного железа, забыв про обычных пользователей. А большие разработчики и поставщики ИИ-мощностей не умеют дебет с кредитом сводить… И всякие интернет-пророки говорят: «Готовьтесь, идёт закат АйТи времён...». Вот как при таких делах оставаться в рассудительном и спокойном состоянии? Никак :) По этой причине я задумался над созданием домашнего ковчега нейро-вычислителя.
Заметка предназначена для тех, кто ещё не погружался в этот удивительный мир домашних нейронок, а посему делюсь с ними набитыми шишками.
Моё железо на тот момент: Xeon E5-2698 v4 на двадцать ядер, 64 гигабайта DDR4 ECC и материнка JGINYUE X99 Titanium D4 (типичная китайская X99-плата на остатках серверных платформ). Дёшево и сердито.
С чего всё началось
Однажды вечером, начитавшись умных (апокалиптических) статей и наслушавшись коллег с сотоварищами, я подумал: а не построить ли мне домашний ИИ-сервер? Ну конечно построить — это же самое актуальное, что может быть на данный момент, особенно во времена обрушения рынков и прочей турбулентности.
Недолго думая, я пришёл к выводу, что мне срочно нужно обновить видеокарту. И обязательно чтобы на ней красовалась гордая надпись — Tesla! Все ведь только о них и пишут. Эти ускорители впервые появились в продаже ещё в 2007 году, поэтому выбор на вторичном рынке огромен. Каждое поколение имеет буквенно-числовое обозначение. На Авито можно встретить: Nvidia Tesla M40 12GB, Nvidia Tesla V100 32GB PCI, Tesla K80 24GB, Tesla M60 16GB, Nvidia Tesla V100 SXM2, Tesla P100 16GB PCI-e...
Видеопамять — количество не всегда переходит в качество
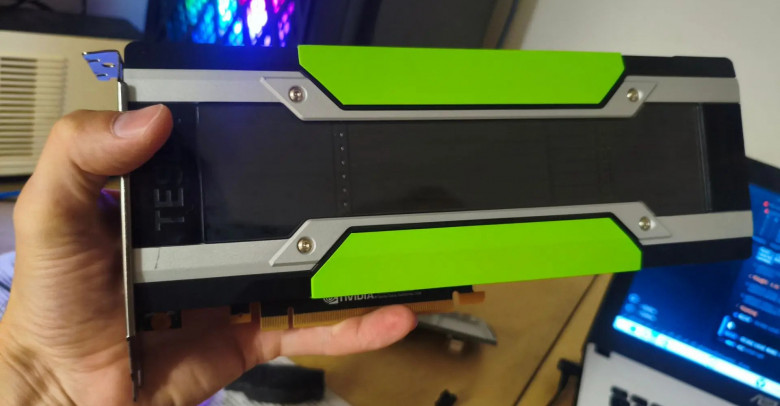
На этом этапе очень просто ошибиться новичку, особенно если денег мало, а амбиций хоть отбавляй. Любая, современная и не очень, рекламная брошюра кричит, что чем больше памяти, тем лучше. Но не всё так просто: память бывает разная. Поэтому условно разделим все ускорители Tesla на две группы — с GDDR и с HBM2/3. Изначально все модели компоновались памятью стандарта GDDR (сначала версии 3, а потом дошли даже до 6-й). В какой-то момент появилась память нового стандарта HBM2, которая показывала на порядок большую пропускную способность (при более низких частотах работы).
Например, если сравнить Nvidia Quadro GP100 16 ГБ HBM2 и Nvidia Quadro P6000 GDDR5X 24 ГБ, то пропускная способность будет 717 ГБ/с против 384 ГБ/с — в пользу HBM2. В нейросетях пропускная способность играет огромную роль.
В идеале домашний ИИ-сервер надо строить на карточках не ниже уровня Tesla V100, а это в наше время штука не копеечная. Карта на 16 гигабайт стоит от 25 т.р.(и цена на них растёт каждый день, буквально). Для современных нейросетей рекомендуют минимум 32 гигабайта, поэтому если брать V100, то две. Есть вариант Tesla V100 и на 32 гигабайта, но это сразу от 65 т.р. Суммы не космические, но мне же только для домашнего использования.
Почитав умные статьи, я решил, что P100 тоже сгодится. На вторичном рынке Tesla P100 16GB можно взять от 10 т.р., а за две отдать всего 20 т.р. Не теряя времени, заказал две в Китае и стал ждать посылку. Также пришлось взять новый блок питания на 1200 ватт — из-за прожорливости карточек: одна карта в максимальном режиме потребляет 250 ватт.
Две P100, или День провала
Через месяц ожиданий я получил заветные карты и сразу вставил их в свой системник. Получилось очень красиво, с общим кожухом обдува. И… ничего не заработало.
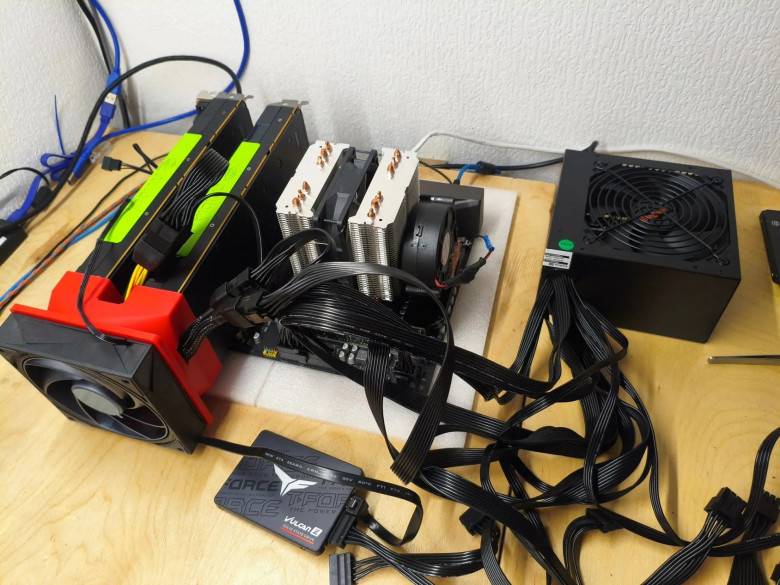
Это был провал. Перестановка карт в слотах PCI ничего не дала. Поставил две Tesla P100 и GT210 — не помогло. Поставил две Tesla P100 без GT210 — тот же результат. Поставил две Tesla P100 и GTX3060 12GB — опять ноль. Переставление карточек показало следующее: одна P100 прекрасно работала в паре с GT210 или GTX3060, две P100 не хотели работать совсем.
Питания хватало, охлаждение было более чем. DeepSeek подсказал, что всё дело в BIOS, который не поддерживает одновременную работу с несколькими картами. Уже потом я не раз натыкался на совет для подобных случаев: для работы нескольких современных карт в BIOS включают опции Above 4G Decoding и Resizable BAR. Но возиться с аскетичным BIOS китайской X99-платы мне не хотелось. Ну, не повезло, так не повезло — оставил одну Tesla P100 16GB в паре с GTX3060 12GB. Также был вариант приобретения новой материнки со списанного сервера, но опять ждать не хотелось, да и места слишком много занимает подобный текстолит.
Первые запуски: llama.cpp, MiniMax, Qwen
Ну хорошо, попробую работать на одной карте — уже можно поставить llama.cpp и запустить какую-нибудь раскрученную модель. Поставил MiniMax и приуныл. Моделька оказалась очень тупой и периодически уходила в цикл. Ради этого не стоило даже браться за создание домашней фермы…
Но потом мне на глаза попалась статья про новый стильный и хороший Qwen3.8 Flash Next. Недолго думая, начал его устанавливать и пробовать. Вот ради этого стоило заниматься созданием домашней нейронки.
Благодаря тому, что у меня 64 гигабайта оперативной памяти, получилось запустить Qwen3.8 Flash Next в кванте IQ3_S (рекомендован как раз для компьютеров с 64 гигами оперативки). Нейронка работает на движке Strata: он автоматически размещает экспертные слои не полностью в видеопамяти, а распределяет их между оперативной и видеопамятью. Такая архитектура позволила получить 30–60 токенов в секунду на моём железе. Это очень достойно для домашних экспериментов.
Запустив модель в OpenCode, я смог по-настоящему разрабатывать код у себя дома, на локальной системе.
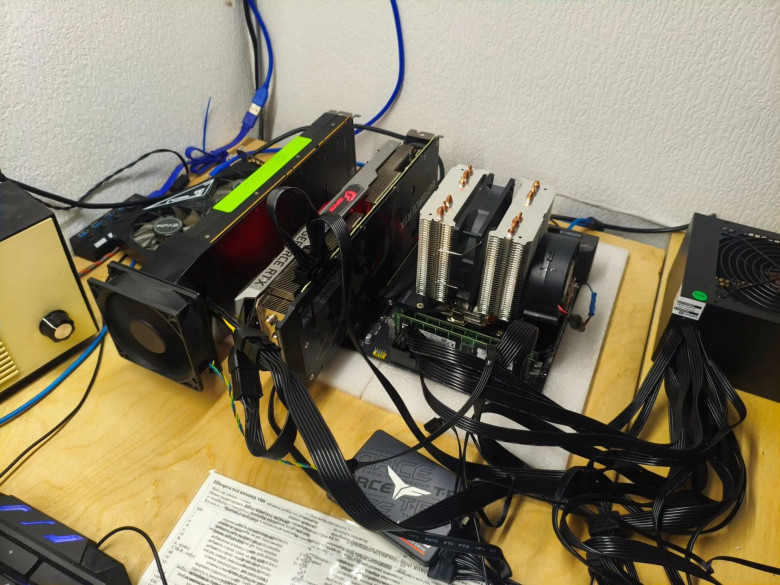
Как оказалось, Strata не умеет работать одновременно с картами разных поколений (Tesla P100 — это поколение Pascal, 2016 год; GTX3060 — Ampere, 2021 год). Поэтому использовать суммарные 28 гигабайт видеопамяти не удалось.
Tesla vs GeForce: сравнение, которого я не ожидал
Далее, ради эксперимента, я решил замерить производительность Strata на GTX3060 12GB. Моему удивлению не было предела: система выдавала 40–60 токенов в секунду! То есть специализированное серверное решение оказалось хуже потребительского. Объясняется это особенностями современных драйверов и отсутствием тензорных ядер у Tesla P100.
Итог: мини-сервер и доступ из любой точки
На следующий день я продал обе Tesla P100 (покупатели нашлись моментально) и приступил к настройке мини-сервера для удалённого доступа. Чтобы максимально упростить себе жизнь, настроил SSH-сервер с авторизацией по ключу. Теперь на всех своих остальных компьютерах я прокидываю SSH-туннель для дальнейшей работы OpenCode.
В итоге мне удалось достичь поставленной задачи: дома крутится ИИ-сервер, который можно использовать для удалённой работы где угодно, не думая о количестве потраченных токенов и о возможности отключения в результате обвалов западных рынков.
Выводы и советы новичкам
Набив шишки, хочу поделиться с вами своим выводами, на что обращать внимание при постройке первого домашнего ИИ сервера:
Сначала — плата и BIOS, потом — карты. Мои Tesla «не смогли» не из-за питания или охлаждения, а BIOS-а, который не осилил несколько-GPU. На дешёвых X99-платах опции вроде Above 4G Decoding и Resizable BAR — лотерея. Иногда разумнее доплатить за нормальную материнку.
Серверная карта — не всегда лучший выбор. Гордая надпись Tesla не гарантирует скорость: GTX 3060 оказалась быстрее Tesla P100. Виноваты отсутствие тензорных ядер у Pascal и особенности современных драйверов. До покупки проверяйте, как ваша будущая связка GPU ведёт себя в нужном движке — особенно если поколения разные: многие движки такое не переваривают.
Пропускная способность важнее объёма. 16 ГБ HBM2 (717 ГБ/с) в нейросетях живее, чем 24 ГБ GDDR5X (384 ГБ/с). Гонка за гигабайтами — типичная ошибка новичка: скорость ответа определяется шириной «конвейера» памяти, а не её объём про запас.
Оперативная память — тоже ресурс, и он дешевле видеопамяти. 64 ГБ DDR4 ECC для Xeon — стандарт для китайских X99-сборок, и именно это спасло всю затею: движок Strata распределяет экспертные слои MoE-моделей между ОЗУ и видеопамятью, поэтому крупные модели становится реальностью, когда не хватает быстрой видеопамяти. Мой вам совет, для начала, увеличьте оперативку, это дешевле.
Начинайте с бесплатного. llama.cpp, открытые модели, кванты — всё это можно установить и настроить за вечер. Пока не поймёте, зачем вам вообще домашняя нейронка, деньги лучше не тратить.
Удалённый доступ — с первого вечера. SSH с авторизацией по ключу, туннель на все рабочие машины — и простой домашний сервер в углу комнаты, становится вычислителем для любого удалённого компьютера, в любой точке мира.
Вот и вся история. Не бойтесь: локальная нейронка дома — уже не магия и не бюджеты дата-центров. Нужны лишь прямые руки и готовность набить пару шишек. Свои-то набиты и разложены по полочкам — берите, пользуйтесь :)
Комментарии (23)

Ka463
11.11.2026 12:53Хмм интересно, у меня тоже X99 и 2 х 2699 но в биосе есть Above 4G Decoding и Resizable BAR иначе мать вообще с двумя видеокартами не стартовала, и у меня та же связка была 3060+P100 и Strata видела 2 видеокарты нормально, была заморочка с драйверами что бы эти карты разных поколений заработали, но правда протестировал я эту связку только в Lm studio там скорость декодирования выросла 2х на moe 35b.

PACCKAT Автор
11.11.2026 12:53Скорее всего что у меня косячный BIOS на материнке, поэтому одновременно две P100 не взлетели.


SER_26
11.11.2026 12:53Спасибо. Полезная статья. Конкретная и без воды. Побольше бы таких.
Часть "удалённый доступ" выглядит несколько незащищённой. Не видит автор риска проблем?PACCKAT Автор
11.11.2026 12:53Про удалённый доступ я не стал сильно расписывать, доступ осуществляется по туннелю SSH, а авторизация исключительно по токену. Поэтому проблем особо не должно возникнуть. Авторизации по паролю нет.
SER_26
11.11.2026 12:53Спасибо. Просто Gemini пугал, что без VPN, firewall и защиты от брутфорса этот сервер атакуют сотни хакеров и ботов.

NeoCode2
11.11.2026 12:53У меня относительно старый (2020 года, как же быстро летит время) компьютер, хотя в его работе меня всё устраивает. GIGABYTE B450M H, AMD Ryzen 7 2700, 3200 MHz, 32 GB RAM, Zalman 600W 1x8pin. А видеокарты считайте что никакой нет (какая-то совсем древняя просто чтобы GUI выводить на монитор, т.к. в игры не играю потому в свое время сэкономил и тупо оставил от старого компа). Как думаете, стоит сейчас брать б/у RTX 2060 12 GB за 20 тыр ради ИИ? Собирать свой сервер это не для меня, возможно когда-нибудь в далеком будущем куплю готовую "коробочку" типа AI Max+ с кучей памяти, чтобы и с любым объемом кода работать, и видео генерить... но точно не сейчас:)
А вот прямо сейчас - или вообще забить, или стандартную 5060Ti 16Gb (почти за 100 тыр, но я вот сейчас уже не хочу, см. далее) или б/у с 12 гигами за 20. Плюсом лично для меня будет то что не нужно резко слезать с Win7, для каких-то задач будет дуалбут в Linux или Win11, что-то возможно и на семерке запустится.
Совсем недавно у меня была попытка запустить ASRock Intel Arc Pro B60 24Gb за 100тыр, формально это оптимальный вариант по соотношению цены за гигабайт, и с приличным объемом - но увы, на моем железе она не заработала. Как говорят чатботы, из-за этой самой функции Resizable BAR, которой у меня предсказуемо не оказалось((
PACCKAT Автор
11.11.2026 12:53На вашем месте, я бы купил Tesla P100 (V100) и ещё 32 гигабайта оперативки (чтобы получилось в сумме 64), и уже от этого шёл дальше. Современные ИИ модели очень требовательны к памяти, обойтись только видео памятью не получится. В любом случае придётся железо усиливать.
Покупать сейчас новую потребительскую видеокарту, не вариант, как по мне, так как ценники на них завышены неадекватно. Наверняка, цены упадут в 2-3 раза к лету. Поэтому если сейчас на чём то и экспериментировать, то точно не на новом железе из магазина.
Я не заострял внимание в статье, но основная моя операционка Linux. На компьютере установлено несколько ОС, и переходить между ними можно при загрузке компьютера. Главное, сделать из системника хостинг сервер, который будет выступать в качестве вычислителя для любого клиента извне (и внутри), независимо от ОС или среды разработки.
NeoCode2
11.11.2026 12:53Tesla P100 мне некуда вставлять. У меня материнка с единственым PCIe, и процессор без встроенной графики. Поэтому видеокарты без видеовыхода для меня это плюс материнская плата, блок питания, процессор, память и т.п. что выльется в круглую сумму. Покупать все это на пике цен не хочется. Я для себя решил - на ближайшие несколько лет хочется просто попробовать локальный ИИ за вообще минимально возможные деньги, а году в 2030 может куплю вообще все новое.
В 2..3 раза к лету цены точно не упадут:) Хорошо если останутся такими же на несколько лет.
PACCKAT Автор
11.11.2026 12:53Тогда, стоит начать с обновления материнской платы, они сейчас один из самых доступных компонентов всей системы :)

Verona90210
11.11.2026 12:53Strata реально неплохо спасает положение на MoE моделях за счет оффлоада неактивных экспертов в DDR4, ток главное ставить четырехканальную память с нормальными таймингами, иначе скорость вывода падает до пары токенов

CerberZS
11.11.2026 12:53Очень интересно...
Ryzen 7 5800x, 64Gb ddr4 3200, 5060ti 16Gb, Strata, Qwen 3.8 Flash Next
55-70t/s gen, 1200t/s prefill
Прекрасно работает для разработки, с учётом того, что я днём рисую задание вместе с той же нейронкой, а ночью она работает автономно и пишет код.
Из результатов, о которых можно хвастаться: рефакторинг монолитного приложения на 2400+ файлов, перевод на микросы, Rabbit в качестве МСВ транспорта. 2 дня планирования и 5 ночей кодинга.
Главное правило: никогда не давать создавать более одного субагента ибо префил в 1000т/с на контексте 192к это 192с перед началом работы, когда агентов больше одного, переключение контекста уничтожает работоспособность.
Сетап работает так: основной агент работает планировщиком/оркестратору, бьёт большую задачу на изолированные и запускает субагента (в среднем задачи на 20-30 мин), после идёт на следующий шаг и т.д.
PACCKAT Автор
11.11.2026 12:53А с помощью какого набора инструментов вы создали свой автономный (ночной) конвейер? Как организовали очередь задач (вообще важна ли очерёдность выполнения задач в вашем случае)?
InsiderCrush
Поздравляю! Теперь вопрос - а зачем? Ну вот реально, какие задачи Вы сейчас свой ИИ-станции поручите? Ну, разумеется первым делом ии-агент, а лучше рой. Ок! А для чего? Какие вы задачи поручите? Вот топ 3 мировых задач для агентов домашних: закуп продуктов в холодос, автоматическая покупка чего либо онлайн (если Вы очень смелый позволить такое) и закрывает этот топ - умный календарь-напоминальник. А дальше что? Будете вайбкодить? Гениальные приложения разрабатывать которые помогут вашему ИИ еще лучше вайбкодить? :D Если не сложно, накидайте идей чем Вы займете свой ии домашний! Очень хочется глянуть :D
John_Go
Такие модели на такой локальной сборке большего, чем вести список продуктов для покупок, к сожалению, не вытянут)) А агентная работа с контекстом 256к+ будет очень медленной, а для агентов даже 100-160 т/с так себе. Как чат и локальная "википедия" пойдет. Дешевле взять любую подписку и наслжадаться последними моделями. На крайний случай подкопить и взять макбук на чипе max со 128 гигабайтами памяти, там уже можно запускать на вменяемой скорости "средние" модели.
PACCKAT Автор
Соглашусь что после Claude, на локальных моделях очень грустно, в плане скорости. Поэтому сейчас собираю локальный конвейер, с локальным канбаном (kanboard). Система будет мониторить новые задачи, 24/7, и исполнять их в рамках проекта. Надеюсь что постоянная автономность сможет сгладить эффект медленной работы.
Ka463
Это с чего бы ? если агент нормально держит кеш, то все достаточно быстро, префила почти нет, читается мгновенно, любой размер контекста, облачные модели кстати тоже часто работают в пределах 100-150ткс, а в час пик и того меньше, они выигрывают только за счет того что меньше тратят шагов на понимание задачи.
PACCKAT Автор
Буду использовать для разработки своих личных проектов, так как не хочу использовать корпоративные возможности
NeoCode2
Ну это , давайте уж честно, ответ ни о чём:)
PACCKAT Автор
Дак идей то вагон и маленькая тележка, не хочу раньше времени воздух сотрясать :))
Но для начала, сделаю очередной проигрыватель музыки для Android, чтобы отладить инструментарий и протокол работы.
ymik
ну вот у меня, сейчас, к примеру, идёт генерация картинок и роликов по фотографиям на локальном компе, так что мне статья очень актуальна
Я, конечно, могу пожечь токены на облачном сервисе или арендовать на несколько часов машину в селектеле для инфренса, но с точки зрения денег если собрать тысяч за 60-80 рублей машинку, то она себя окупит примерно за месяц-полтора
Verona90210
Делать домашний сервер ради списка покупок это какой-то лютый оверинжиниринг, с такими вещами обычный текстовый блокнот в телефоне справляется в разы надежнее