

Хабр, привет! Меня зовут Никита, я Rust‑разработчик.
Статью «Вам не нужны bool и Option» я вообще не хотел выпускать. Казалось, все уже пишут код с ИИ, а я со своими советами про типы напоминаю людям пристегнуть ремень, когда они садятся в машину. Вроде всё правильно, но ощущение, что объясняешь очевидное.
К моему большому удивлению, статья нашла тёплый отклик. А у меня появилась ещё пара мыслей вдогонку, которыми хочется поделиться. На этот раз про примитивные типы и коллекции. Как и прошлая статья, эта имеет кликбейтный заголовок, тем не менее советы в ней полезные, хоть и очевидные.
Когда функция принимает обычное число, строку или коллекцию, по типу не всегда понятно, что это за данные и проверял ли их кто‑нибудь. Я хочу видеть это в сигнатуре, чтобы при чтении кода не приходилось каждый раз искать, где и что проверили.
Небольшой дисклеймер. Примеры здесь учебные и упрощённые. С постановкой задач и решениями можно поспорить, и в своём проекте вы вполне можете сделать иначе. Важны именно практические приёмы и выводы.
Коротко о типах
Примеры будут на Rust. Под примитивными типами здесь я понимаю базовые типы для отдельных значений, например чисел и строк. Они задают, какие значения можно хранить, но сами по себе не объясняют, что эти значения означают в нашей задаче.
String тоже включаю сюда с точки зрения бизнес‑логики. В Rust это структура стандартной библиотеки, которая гарантирует корректный UTF-8. Формат строки мы проверяем отдельно.
Сюда же отношу числовой Decimal из крейта rust_decimal.
Под коллекциями здесь понимаю контейнеры для набора значений: массивы, списки, словари, множества и другие структуры данных. В примере рассмотрим Vec<T>, который хранит последовательность элементов типа T.
Примитивные типы в аргументах
Когда у функции несколько аргументов одного типа, их можно перепутать местами. Компилятор пропустит такой вызов, потому что типы совпали.
Например, создаём лимитную заявку на бирже. Объём и цену представляем типом Decimal из rust_decimal. В нашем примере объём измеряется в акциях, а цена — в рублях за акцию. Хотим продать одну акцию по 1000 рублей:
use rust_decimal::Decimal;

enum OrderSide {
    BUY,
    SELL,
}

fn create_limit_order(price: Decimal, volume: Decimal, side: OrderSide) {
    /* отправка заявки */
}

let price = Decimal::ONE_THOUSAND;
let volume = Decimal::ONE;

create_limit_order(volume, price, OrderSide::SELL);
Объём и цену переставили. Получается заявка на продажу 1000 акций по рублю (вот у кого‑то праздник будет) вместо одной за 1000 рублей.
Допустим, появился язык Rust++, который поддерживает именованные аргументы:
create_limit_order(price=price, volume=volume, side=OrderSide::SELL)
Теперь порядок аргументов не важен. Но оба параметра всё ещё принимают Decimal, поэтому можно перепутать сами значения:
create_limit_order(price=volume, volume=price, side=OrderSide::SELL)
Сделаем Price и Volume отдельными типами:
struct Price(Decimal);
struct Volume(Decimal);

fn create_limit_order(price: Price, volume: Volume, side: OrderSide) {
    /* отправка заявки */
}

let price = Price(Decimal::ONE_THOUSAND);
let volume = Volume(Decimal::ONE);

create_limit_order(price, volume, OrderSide::SELL);
Теперь компилятор не даст передать Price вместо Volume, хотя внутри у обоих типов хранится Decimal.
Примитивный тип допускает лишние значения
В u8 помещается любое целое от 0 до 255, а в String любая строка в UTF-8. Требования задачи обычно строже: число должно попадать в диапазон, строка соответствовать формату. Имя параметра и комментарий эти требования не проверяют.
Если значение уже проверили, по u8 или String этого тоже не видно. В функции, которая получает такое значение, приходится снова его проверять или искать проверку в вызывающем коде.
1. Диапазон значений
Диапазон числового типа может быть шире, чем нам нужно.
Например, в нашем магазине скидку задают в целых процентах от 1 до 100 включительно (дробных скидок вроде 0,5% у нас нет, чтобы не усложнять пример). Скидку храним в поле discount: Option<DiscountPercent>. В прошлой статье я оставлял Option, когда смысл отсутствия значения однозначен. Здесь None означает «без скидки», так что Option подходит.
u8 вмещает нужные числа, но в него помещаются и ноль, и числа от 101 до 255. Со скидкой 150% магазин ещё и доплатит покупателю.
Возьмём NonZeroU8, чтобы исключить ноль. А числа больше 100 отсеем в конструкторе DiscountPercent. Поле с исходным числом сделаем приватным, чтобы нельзя было обойти проверку:
mod discount {
    use std::num::NonZeroU8;

    pub struct DiscountPercent(NonZeroU8);

    #[derive(Debug)]
    pub struct InvalidDiscount;

    impl DiscountPercent {
        pub fn new(value: u8) -> Result<Self, InvalidDiscount> {
            let percent = NonZeroU8::new(value)
                .filter(|value| value.get() <= 100)
                .ok_or(InvalidDiscount)?;

            Ok(Self(percent))
        }

        pub fn value(&self) -> u8 {
            self.0.get()
        }
    }
}
Конструктор принимает обычный u8. Из числа от 1 до 100 получится DiscountPercent, на остальных вернётся ошибка:
use discount::DiscountPercent;

let discount = DiscountPercent::new(12).unwrap();
assert_eq!(discount.value(), 12);

assert!(DiscountPercent::new(0).is_err());
assert!(DiscountPercent::new(150).is_err());
2. Формат значения
Если функция принимает String, вызывающий код может передать в неё строку, которая не подходит по формату.
Поле email: String выглядит понятно, пока не начинаешь разбираться, кто положил туда строку. Может, адрес уже проверили. А может, там "C++". С UTF-8 у C++ всё в порядке.
Синтаксис адреса описан в RFC 5322, и разбирать его вручную я не стану. В крейте email_address уже есть тип EmailAddress.
use email_address::EmailAddress;

fn send_receipt(to: &EmailAddress) {
    /* отправка письма */
}

let email: EmailAddress = "nikita@example.com".parse().unwrap();
send_receipt(&email);

assert!("C++".parse::<EmailAddress>().is_err());
Здесь parse() проверяет формат адреса, и send_receipt получает уже разобранный EmailAddress. Передать в неё строку "C++" компилятор не даст.
Тип элемента не задаёт ограничения коллекции
У коллекции могут быть ограничения на минимальное или максимальное число элементов. Их нужно проверять отдельно, даже если каждый элемент внутри уже проверен. В типе Vec<T> эти границы не указаны.
В нашем учебном магазине корзина может быть пустой: пользователь ещё выбирает товары или удалил последнюю позицию. Но для оформления заказа нужна хотя бы одна позиция. У позиции есть идентификатор товара, а количество хранится в NonZeroU32:
use std::num::NonZeroU32;

pub struct ProductId(u64);

pub struct OrderLine {
    product_id: ProductId,
    quantity: NonZeroU32,
}

fn place_order(items: Vec<OrderLine>) {
    /* оформление заказа */
}

place_order(Vec::new());
NonZeroU32 исключает нулевое количество товара в позиции. Сейчас в place_order можно передать пустой вектор, поэтому внутри функции понадобится отдельная проверка.
Проверку на пустоту добавим в конструктор OrderItems. В place_order будем принимать OrderItems вместо Vec<OrderLine>. Поле с вектором сделаем приватным и добавим метод as_slice() для чтения позиций:
mod order_items {
    use super::OrderLine;

    pub struct OrderItems(Vec<OrderLine>);

    #[derive(Debug)]
    pub struct EmptyOrder;

    impl OrderItems {
        pub fn new(items: Vec<OrderLine>) -> Result<Self, EmptyOrder> {
            if items.is_empty() {
                return Err(EmptyOrder);
            }
            Ok(Self(items))
        }

        pub fn as_slice(&self) -> &[OrderLine] {
            &self.0
        }
    }
}
use order_items::OrderItems;

fn place_order(items: OrderItems) {
    /* оформление заказа */
}
Теперь place_order(Vec::new()) не подходит по типу. При оформлении нужно сначала получить OrderItems. Если корзина пустая, конструктор вернёт ошибку, которую можно пробросить выше:
let empty_cart = Vec::new();
assert!(OrderItems::new(empty_cart).is_err());

let line = OrderLine {
    product_id: ProductId(1001),
    quantity: NonZeroU32::new(2).unwrap(),
};

let cart = vec![line];
let items = OrderItems::new(cart).unwrap();
place_order(items);
Внутри place_order проверять пустоту больше не нужно, потому что конструктор не создаёт OrderItems без позиций.
Где я оставляю примитивные типы и коллекции
Для индекса вектора мне подходит usize, а для локального вычисления может быть достаточно f64, если у числа нет дополнительных ограничений. Если длительность можно выразить через Duration, возьму готовый тип. Для ненулевого числа уже есть NonZeroU32.
Канал цвета в RGB принимает значения от 0 до 255, как и u8, поэтому здесь я оставляю u8. Но в вызове set_color(255, 128, 0) не сразу понятно, какое число к какому каналу относится. Тут бы пригодился Rust++ с именованными аргументами.
Список результатов поиска может быть пустым, поэтому здесь оставлю обычный Vec.
Если готовый тип подходит по смыслу и всем ограничениям задачи, я его и беру.
Комментарии (36)

Px2
17.11.2026 21:06Если в функцию с тремя аргументами вам сложно передать правильные значения, то может не стоит заниматься программированием?


roudakov
17.11.2026 21:06Все это было уже реализовано в Ada в производных типах. Идея конечно прекрасная, но бесполезная.
Что делать с перемножением скорости на массу? цены на количество? а если есть две скорости, одна в м/с другая в км/ч? А что если... и тут огромное количество вариантов которые не будут работать с таким подходом. Ну или вы просто потонете в огромном количестве приведения типов, которой дезавуирует все полезное что было в этой идее.
Что бы всем этим можно было пользоваться, нужен отдельный язык для описания приведения типов.

Starche
17.11.2026 21:06С этой точки зрения в расте всё удобно. Для сложения и умножения имплементируете трейты Add и Mul, для конвертации From
Да, комбинаций много, но это бойлерплейт библиотечного кода, который пишется один раз. И уже даже написан https://docs.rs/uom/latest/uom/ или https://docs.rs/quantities/latest/quantities/
roudakov
17.11.2026 21:06Это очень ограниченное решение и я не вижу ни одного применения, когда это реально бы упрощало программирование, а не добавляло новый источник ошибок.
Во-первых, кроме сложения и умножения, есть еще очень много математических операций. Надо прописывать для каждой операции? А если это не стандартная операция, а пользовательская функция? А если данные это матрицы или тензоры?
Во-вторых, а кто гарантирует, что значение введено именно в той размерности, что указана в коде? Если в коде будут переменные разной размерности это только добавит ошибок. Вот у тебе одна переменная в метрах, другая в километрах и раст приводит одну к другой, все работает. А потом вводные поменяли, все значение стали вводить в метрах, а раст так и пересчитывает, потому что в коде остались километры... И прощай Mars Climate Orbiter.
В третьих, километры, метры, миллиметры, нанометры... вы уверены что разрядности хватит для безболезненного перевода одного в другое? Или точности?
В четвертых, а как быть с валютами? Там курс меняется ежедневно. Такое ограничение просто не будет работать.
Да, как концепция - интересно. Но недоведено до ума и в текущем виде - малополезно. А то что оно добавляет уровень контроля полностью нивелируется необходимостью этот уровень контроля дополнительно контролировать, потому что ошибиться можно не только в формуле, но и в указании неверной размерности. При чем, такую ошибку можно и не увидеть. Переменная определена в одном месте, а автоматическое приведение работает в другом.

Kapsa-sa
17.11.2026 21:06Проще всего использовать такие обертки только для идентификаторов и простых ограничений вроде валидного email или непустой строки, без попыток реализовать через них математику, тогда и ошибок конвертации почти не возникает
roudakov
17.11.2026 21:06Да, можно. Но зачем?
Валидность email или идентификатор прекрасно проверяется на уровне библиотеки при вводе его пользователем или генерации. Зачем мне это контролировать на уровне языка программирования? Есть более простые и универсальные способы это реализовать.
Я просто не вижу ситуации в которой я бы сказал: хорошо, что эта возможность есть, без нее было бы хуже.

aleksandy
17.11.2026 21:06Но зачем?
Есть внешний НСИ. Ты его не контролируешь, но используешь. Для твоей бизнес-логики неважно какого типа там идентификатор, ты его используешь просто как какое-то значение, которое равно/не равно чему-то.
В начале разработки, этот идентификатор был одного типа целое/UUID/строка/etc. В какой-то момент, “концепция поменялась” (ц), и контракт НСИ сменился: тип этого идентификатора сменился на другой. И, получается, приходится перелопачивать всю логику, тупо для того, чтобы идентификатору сменить тип. И это ещё хорошо.
А если надо поддержать работу в переходный период? Тогда рядом с прежним идентификатором появляется идентификатор нового типа, и во всей логике появляется временный код, выбирающий с каким типом работать.
Да, даже типу необязательно меняться, просто кодификация справочника изменилась: была “АБВ”, а стала “ABC”.
А если таких НСИ несколько, то код раздувается на ровном месте. Хотя с точки зрения бизнеса ничего не поменялось: нужно просто проверить поле на равенство какому-то идентификатору НСИ.
И вот в такой ситуации заводим отдельный тип для идентификатора каждого справочника, вся работа по его сравниванию, поддержке нескольких значений на переходный период и т.п. выполняются внутри этого самого типа. В бизнес-логике изменений минимум, только в местах создания, которые легко находятся, потому что меняем конструктор, и всё ломается ещё на этапе компиляции. Ну, или в рантайме при прогоне тестов.
Описанный подход реален и использовался неоднократно.
roudakov
17.11.2026 21:06Это на столько плохо, что я даже в восхищении, что у вас это где-то работает и никого за это еще не уволили.
Во-первых, полагаться на внешний ID в своей системе - это такая себе лотерея. То есть, не используй внешний id для внутренней работы, проблема просто не возникла бы. Не говоря уж о том, что из-за системы которую вы не контролируете вам придется переписывать всю свою логику.
Во-вторых, поменять тип ID, это не просто заменить код в справочнике. Это надо перелопатить и изменить код во всех документах и смежных справочниках, где он использовался. А такое не то, что не поощряется, чаще всего это просто невозможно в силу закрытых периодов, большого объема базы и т.п.
В-третьих, такой подход оставляет не решенным множество других нюансов: А если у вас не один сторонний поставщик НСИ? А если искать надо не просто по коду, а по коду в конкретном каталоге? А если надо посмотреть архивные данные, каким код был раньше?
В-четвертых, зачем мне ошибки на этапе компиляции? Мне не нужны ошибки, мне нужна рабочая система без ошибок. А то что я буду неделю отлавливать все места где упоминается ID и не работает после смены типа, зачем это мне?
id который используется в бизнес-логика твоей системы это твой внутренний ID, каким ты захотел, таким и сделал. Все внешние коды задаются либо через реквизиты, либо через таблицы соответствий. И все проблемы, которые вы героически решаете через трейты раста, просто не возникают.

v_0ver
17.11.2026 21:06Что делать с перемножением скорости на массу?
Перемножать и создавать тип
импульс.цены на количество?
Перемножать и результат будет тип
деньги.а если есть две скорости, одна в м/с другая в км/ч?
Приводятся к системе СИ, это м/с и умножаются, делятся, складываются - нет проблем. Тем более в Rust эти приведения можно сделать в трейтe
From.огромное количество вариантов которые не будут работать с таким подходом
Всегда можно ввести алгебру(а вводя типы - мы вводим алгебру) в которой решение любой нужной нам задачи будет тривиальным. (Extension by Definition Theorem)
Ну или вы просто потонете в огромном количестве приведения типов, которой дезавуирует все полезное что было в этой идее.
Скил ишью. Если вводить алгебру более общую чем нужна для решения задачи, то это конечно не рационально, но зачастую проще решить множество изолированных проблем с конвертацией типов и их поведением, и потом собрать из них тривиальное решение задачи, чем пытаться сразу решать задачу влоб.
roudakov
17.11.2026 21:06Вот вы сами осознаете, что предлагаете? Из-за минимального уровня контроля, реализовывать целые алгебры... в реализации которых вы можете наделать куда больше ошибок, чем в формулах. И отследить их будет куда сложнее.
Перемножать и результат будет тип цена.
Ну вот вы уже создали проблему. Потому что цена идет за единицу товара (за штуку, метр, литр), а сумма это просто деньги. Сумму с суммой можно складывать. А цену с ценой - нет.
А если мы добавим в расчет еще и НДС, акциз, скидку, акцию... тут даже порядок применения важен и некоммутативен.
А это тривиальный пример. Представляю, что будет в более сложных вариантах.
v_0ver
17.11.2026 21:06Ну вот вы уже создали проблему. Потому что цена идет за единицу товара (за штуку, метр, литр), а сумма это просто деньги. Сумму с суммой можно складывать. А цену с ценой - нет.
Никакой ошибки нет
штуки * деньги/штуки = деньги. Естественно,метры * деньги/штукидаст ошибку типа при компиляции, если вы намеренно не определи такую операцию.А если мы добавим в расчет еще и НДС, акциз, скидку, акцию… тут даже порядок применения важен и некоммутативен.
Да, и всё это можно выразить в типах и убрать заранее невалидные варианты операций.
roudakov
17.11.2026 21:06То что вы не видите в этом проблему, говорит лишь о том, что вы плохо знакомы с предметной областью.
v_0ver
17.11.2026 21:06С какой предметной областью? С инженерными вычислениями, математикой, системой типов? Боюсь вас разочаровать, но это области моей профессиональной деятельности уже не первый десяток лет.
roudakov
17.11.2026 21:06Речь шла конкретно о финансовых расчетах и типах данных. Вы предлагаете запрещать смешение сущностей на уровне компилятора, но при этом сводите цену и сумму к одному типу. И даже после того, как вам на пальцах объяснили почему это разные сущности, вы заявляете, что не видите в этом проблемы.
Я вижу в таком подходе крайнюю непоследовательность и поверхностность.
Если по остальным, заявленным компетенциям, у вас такой же уровень аналитики...

Pand5461
17.11.2026 21:06Ну это решим, будут другие проблемы.
Вот, например, заводим тип “Симметричная матрица”. И надо для неё определить низкоранговое изменение вида
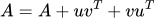 . Но первое изменение
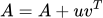 делает матрицу несимметричной, т.е. с точки зрения компилятора полное изменение не гарантирует симметричности в итоге, если, конечно, компилятор не научится доказывать теоремы линейной алгебры.
v_0ver
17.11.2026 21:06Эм, в чём проблема?
impl Matrix<Symmetric> {
// Теряем инвариант
    fn add_outer_product(
        self,
        u: &[f64],
        v: &[f64],
    ) -> Matrix<General> {
        // A += uv^T
    }
// Сохраняем инвариант
    fn add_outer_product_2(
        self,
        u: &[f64],
        v: &[f64],
    ) -> Matrix<Symmetric> {
        // A += uv^T + vu^T
    }
}
Симметрия же гарантируется при атомарности выполнения операции. Нет атомарности - нет инварианта.
Если прям очень хочется считать первую и вторую операцию в разное время и в разных местах программы и ещё в неизвестном порядке, то тут конечно без рантайм проверок не обойтись.
impl Matrix<Symmetric> {
    fn modify(
        mut self,
        f: impl FnOnce(&mut Matrix<General>),
    ) -> Result<Self, Error> {
        let mut general = Matrix::<General> {
            data: self.data,
            n: self.n,
            _state: std::marker::PhantomData,
        };

        f(&mut general);

        if !is_symmetric(&general) {
            return Err("Матрица говно! давай по новой.");
        }

        self.data = general.data;
        Ok(self)
    }
}
Pand5461
17.11.2026 21:06Так вы реализацию
add_outer_product_2напишите, чтобы симметричность результата проверялась компилятором. Если мы внутри просто меняем что угодно как хотим, а потом вешаем ярлык, что всё хорошо - так никакое сохранение инварианта не гарантируется.v_0ver
17.11.2026 21:06Ну как бы так устроенно всё в мире.
Мы доказали правило, что
A += uv^T + vu^Tне меняет симметрию, и дальше используем это свойство. Естественно если мы что-то меняем в этой формуле то это требует повторного доказательства/проверки.Естественно в системе типов пустой программы, нет никаких инвариантов, и вы либо описываете их сами, либо для вас их кто-то описал в библиотеке.
Pand5461
17.11.2026 21:06Ну как бы так устроенно всё в мире.
Так о том и речь. Вы вроде как начали агитировать за автора, что инварианты можно зафиксировать на уровне типов. А оказывается, чуть глубже копаем - и инвариант во многих случаях обеспечивается только каким-то свойством рантайм операций, на уровне компилятора не доказанным.
v_0ver
17.11.2026 21:06Ещё раз. Если вы выполнили
A += uv^T + vu^Tатомарно, то сохранили инвариант. Если не атомарно то инвариант вы сломали, и его нужно восстанавливать рантам проверкой.
v_0ver
17.11.2026 21:06Потому что
set_color(255, 128, 0)должен бытьset_color(color)гдеcolor = Color::new_rgb(255, 128, 0). Если следовать логике из статьи.
v_0ver
17.11.2026 21:06Я сам апологет такого подхода(или даже более жёсткого/алгебраического), особенно в вайб-кодинге, и названию его “code is a spec” в противовес SDD (Spec-Driven Development).
Kapsa-sa
17.11.2026 21:06На границах системы и в публичном апи такие обертки вроде Price и Volume спасают от кучи тупых багов с перепутанными аргументами, но тащить их глубоко внутрь бизнес-логики или в расчетные циклы порой такой гемор из бесконечных анврапов и трейтов преобразования. Главное вовремя остановиться чтоб код оставался читаемым)

Siemargl
17.11.2026 21:06В расте есть контракты. Они решают большую часть описанных проблем.
А вот с типами засада - раст слабоват, нет нормальных объектов и переопределения операторов. Так что этот подход неудобен.

Pand5461
С подобным подходом складывается такое ощущение, что в какой-то момент просто алгоритм решения задачи начинает записываться на языке типов, а не обычных значений. Какие-то доп. гарантии это, конечно, даст, но пространство для логических ошибок по-прежнему оставляет. А ловить их из-за неестественной записи алгоритма может даже стать сложнее. Плюс переделка алгоритма приводит к рефакторингу ядра программы - алгоритм же у нас не на рантайм-значениях работает, а на типах.
Ну т.е. всё хорошо в меру. Для фасада, интерфейсов и т.п. кастомные типы дают зримые преимущества, а внутренности может просто производительность заставить писать на голых системных типах, чтобы компилятор сам смог сделать SIMD-ификацию, например.
NikTimf Автор
Ну тут еще плюс раст и C++ в том, что у них абстракции с 0 стоимостью, поэтому, что вы Decimal передали, что обертку над Decimal, без разницы.
Koteukin
Да, я тоже подумал об этом. Во многих языках подобная обёртка может съесть немного производительности.
Да, незначительно, и во многих проектах чаще всего с этим можно смирится в пользу читаемости, но это всё равно надо понимать.
Pand5461
“Абстракции с нулевой стоимостью” не всегда гарантируют, что код оптимизируется так же хорошо, как и с примитивными типами.
SIMD, FMA инструкции, ещё какие-нибудь технически не входящие в стандарт, но допустимые как небезопасные оптимизации, могут не применяться к обёрткам.
Со внешними библиотеками точно будет, что не скастуете явно массив обёрток в указатель на
float/double- какая-нибудь линейная алгебра пойдёт через fallback-реализацию вместо передачи в оптимизированную функцию (ну это, конечно, в предположении, что в библиотеке вообще есть дженерики для линейной алгебры, если нет - придётся кастовать по-любому, чтобы просто скомпилировалось).В общем, повторюсь, идея правильная, но с фразой “Вам не нужны” в заголовке не согласен. Подобным типам место на границе взаимодействия разных частей программы, в ядре с ними какой-то оверхед всё равно будет.
anshdo
Пора ввести новый термин — оверархитектура, наряду с оверинженирингом.
Kapsa-sa
Он уже давно есть и называется энтерпрайз-паттерны на минималках) В любой непонятной ситуации пиши лишнюю обертку и называй это заботой о надежности)
Dhwtj
Вы просто не умеете их (кошек) готовить ©
Kapsa-sa
На хаскеле и скале люди этим уже двадцать лет развлекаются, теперь вот и в раст подвезли моду делать все через систему типов. Через пару лет мода откатится обратно к простым структурам)