

Kubernetes обеспечивает работу значительной части контейнеризованного ПО в мире благодаря разделению обязанностей между двумя циклами управления, которым прежде редко требовалось взаимодействовать. Планировщик размещает поды на существующих узлах, а автоскейлер добавляет узлы, когда поды негде разместить. Десять лет такая архитектура работала хорошо: вычислительные ресурсы были в основном взаимозаменяемыми, и каждый цикл мог действовать, почти ничего не зная о решениях другого. ИИ-нагрузки и ускорители, на которых они выполняются, изменили условия. Для большинства задач такое разделение по-прежнему подходит, но темпы развития ИИ заставляют пересмотреть его ограничения.
Проблема проявляется в ситуации, знакомой всем, кто работает с GPU: под не удаётся разместить, хотя доступные мощности кластера ещё не исчерпаны. Пока под ждёт, дорогостоящие ускорители могут простаивать. Первое предположение — в регионе закончились ресурсы, и иногда причина действительно в этом. Но бывает, что мощности доступны, а под всё равно остаётся в состоянии Pending: автоскейлер готов добавить узел, который планировщик не сможет использовать.
Автоскейлер отвечает на вопрос, для которого его создали: нужно ли добавить узел. Однако сначала нужно понять, подходит ли конфигурация этого узла для нагрузки. Команда VK Tech перевела статью о том, какую часть проблемы сообщество уже решило, как планирует справиться с остальным и как автоскейлер сможет лучше учитывать работу планировщика.
Сложные задачи и решения сообщества
Ускорители обострили несколько проблем, которые требуют согласованной работы обоих циклов. Не все эти проблемы новы или связаны исключительно с ИИ: часть давно знакома специалистам по высокопроизводительным и пакетным вычислениям. Распространение ускорителей сделало их актуальными для более широкого круга команд. Рассмотрим три примера, на которых виден прогресс в поиске общих решений.
Резервирование мощностей до появления нагрузки
Это наиболее знакомая задача. Предложение ограничено, а простой ускорителей обходится дорого, поэтому команды могут резервировать мощности заранее. Если при расширении кластера используются резервы, автоскейлер должен учитывать, будет ли новый узел использовать мощности, которые команда уже зарезервировала и оплачивает. Резервирование появилось задолго до автомасштабирования. Это устоявшаяся практика управления мощностями, которую автоскейлеру может потребоваться учитывать: узел можно запустить за счёт зарезервированных ресурсов, не полагаясь на доступность незарезервированных.
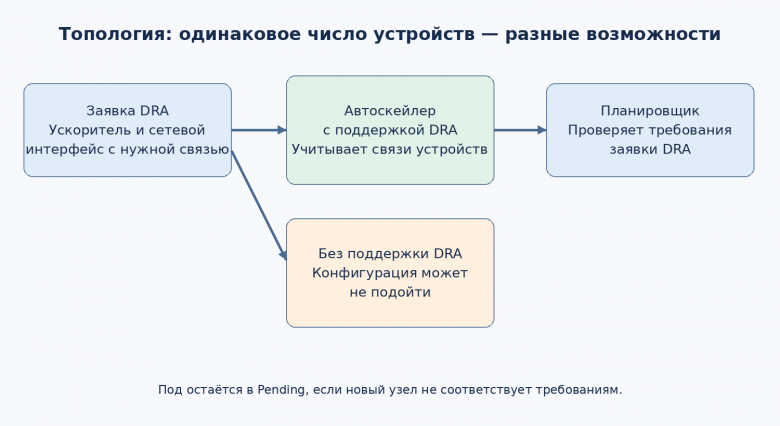
Топология: связи между устройствами
Топология описывает, как устройства соединены друг с другом, а не просто насколько далеко они расположены. Работа ускорителя зависит от CPU и памяти в его локальном домене NUMA, сетевого интерфейса на общем с ним пути PCIe и высокоскоростных каналов связи с другими ускорителями. Лучше всего он работает, когда эти компоненты топологически близки и трафику не приходится проходить через более медленное соединение.
Эта близость образует иерархию: устройства на одной шине внутри сервера, серверы в стойке, соединённые высокоскоростной сетью ускорителей, и стойки, связанные сетью дата-центра. Каждый следующий уровень медленнее предыдущего. Крупнейшие модели работают сразу на множестве серверов, поэтому требование размещать ресурсы рядом выходит далеко за пределы одного узла.
Исторически Kubernetes обычно представлял ресурсы ускорителей в виде количества устройств. Переносимого структурированного способа описать многие связи между ними не было: узел сообщал число устройств, под запрашивал нужное количество, а планировщик сопоставлял два целых числа. Dynamic Resource Allocation (DRA) восполняет этот пробел. Рабочая нагрузка создаёт структурированную заявку с описанием требований, включая связи между устройствами — например, ускорителем и обслуживающим его сетевым интерфейсом. Планировщик читает такие заявки напрямую. Автоскейлеры с поддержкой DRA также начинают учитывать их при моделировании мощностей, хотя поддержка пока зависит от реализации.
Совместное использование ресурсов устройства
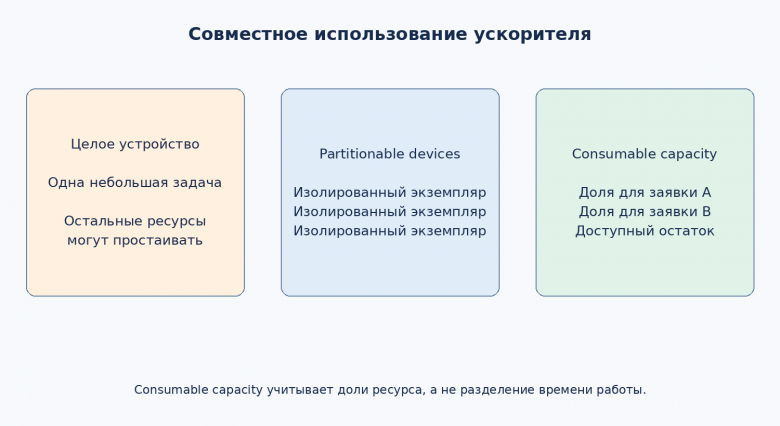
Современные ускорители настолько мощны, что небольшая задача, получив устройство целиком, оставит большую часть его ресурсов незадействованной. Одно устройство можно разделить на изолированные экземпляры, работающие одновременно. Некоторые среды выполнения также предоставляют задачам доступ к устройству по очереди, разделяя время его работы. Это отдельный механизм выполнения, который модель consumable capacity не описывает.
Механизм partitionable devices позволяет по запросу предоставлять части одного устройства. Consumable capacity даёт более детальный способ распределения: несколько рабочих нагрузок могут одновременно получать измеримые доли ресурса, и для удовлетворения запроса достаточно части устройства.
Планировщик напрямую отслеживает выделенные ресурсы. Автоскейлеры с поддержкой DRA начинают использовать ту же модель при оценке узла, который можно добавить, хотя поддержка различается. Более мелкое деление может приводить к фрагментации: часть ресурсов остаётся неиспользуемой. Разумно выбранные минимальный размер и шаг выделения помогают сократить такие потери по сравнению с выделением устройства целиком.
DRA и его расширения дают планировщику и автоскейлеру общий язык описания оборудования — как его топологии, так и совместного использования. Благодаря этому они гораздо реже расходятся в оценке того, какой узел подходит для нагрузки. Но согласованного описания ресурсов хватает не для всех задач.
Разворачивайте кластеры Kubernetes
с Managed Containers
Автоматизируйте деплой
и снижайте затраты
на инфраструктуру до 60%
Почему общего языка недостаточно
Общее описание ресурсов помогает двум циклам одинаково оценивать узлы, но не обеспечивает согласованных действий. Особенно хорошо это видно на примере gang scheduling — группового планирования по принципу «всё или ничего». Задача не нова, однако с распространением ИИ и дефицитом мощностей стала гораздо острее. Для крупного задания нужно разместить все его поды вместе либо не размещать ни одного. Одного общего представления о ресурсах здесь недостаточно.
Эту проблему уже решают, пока только в планировщике. Планирование с учётом рабочих нагрузок позволяет рассматривать группу подов как единое целое и применять принцип «всё или ничего». Соответствующие API Workload и PodGroup в основном проекте Kubernetes находятся в статусе бета и по умолчанию отключены. Планировщик откладывает размещение подов, пока не сможет разместить достаточное их количество вместе. Это предотвращает простой оборудования из-за частично размещённого задания. Автоскейлер эти изменения не затронули: он по-прежнему рассматривает поды по отдельности и может добавить один-два узла для нескольких ожидающих подов группы. Мощности будут выделены впустую, если само задание так и не запустится.
Пока связующим звеном служит механизм provisioning request. Он позволяет рабочей нагрузке запросить у автоскейлера мощности сразу для всей группы подов. Если настроена соответствующая проверка допуска, Kueue резервирует квоту, создаёт запрос, ждёт подтверждения готовности мощностей и затем допускает нагрузку к запуску.
Атомарное расширение кластера выполняется без гарантии успеха, в режиме best effort, и зависит от поддержки провайдера. Этот механизм по-прежнему остаётся надстройкой, связывающей два цикла. Он не даёт им общего понимания группового размещения и показывает более глубокую проблему.
Развитый автоскейлер уже отчасти выполняет работу планировщика: прогнозирует, куда тот разместил бы поды, чтобы понять, поможет ли добавление узла. Отсюда дублирование вычислений. Сначала автоскейлер моделирует размещение и выбирает узел для запуска, а после его появления планировщик заново принимает решение, во многом повторяя ту же работу.
Что сообщество разрабатывает дальше
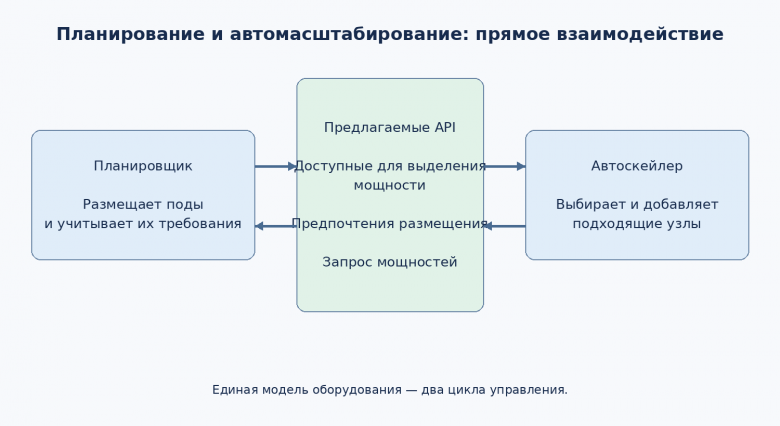
Два цикла по-прежнему выполняют разные задачи, но их всё чаще приходится проектировать совместно. Это сближение уже активно обсуждают. Участники инициативы по планированию с учётом рабочих нагрузок обозначили намерение со временем охватить и автомасштабирование. В SIG-Autoscaling опубликовано предложение об API интеграции, которые позволят двум циклам взаимодействовать напрямую.
Один из предлагаемых API позволит планировщику видеть мощности, которые можно выделить, а не только существующие узлы. Другой даст возможность задавать предпочтения размещения на этих мощностях, третий — явно запрашивать их.
Меняется и сам процесс разработки. Если автомасштабирование учитывают с самого начала, выделение ресурсов обсуждают ещё при проектировании нового механизма размещения. Тогда сообщество заранее прорабатывает взаимодействие двух циклов, а разработчикам автоскейлеров не приходится в спешке устранять несогласованность после каждого релиза.
Что стоит запомнить
Полезно представлять эту архитектуру как единую модель оборудования с двумя потребителями. Эффективность использования дефицитных ускорителей зависит от согласованности планирования и выделения ресурсов. Если какую-либо возможность учитывает только один из циклов, их решения могут разойтись, а дорогое оборудование — остаться без работы. Поэтому, если под остаётся в состоянии Pending, проверьте, одинаково ли планировщик и автоскейлер определяют подходящую конфигурацию узла, прежде чем делать вывод о нехватке мощностей.
Особенно остро вопрос стоит для инференса: всплески нагрузки при обслуживании запросов и работа агентных систем не оставляют времени ждать готовности нового узла. Интерфейсы взаимодействия сейчас открыто обсуждают в SIG-Autoscaling и SIG-Scheduling. Они формируются на уровне сообщества, а не продукта отдельного вендора. Команды, которые используют ускорители, заинтересованы в результате и могут повлиять на архитектуру, пока она не определена окончательно.