

Исследователи предложили способ сжать большую языковую модель почти вдвое и сохранить около 85% ее качества, не тратя ресурсы на обучение с полного нуля. Полученная модель на 2,27 млрд параметров прошла дистилляцию всего на 22 млрд токенов, но в среднем уже обходит Qwen3-1.7B, которую учили на 36 трлн токенов (то есть на объеме данных в 1 600 раз больше).
Метод назвали Concertina, от англ. «концертина» — вид небольшой гармошки, а не чего-то «конкретного». Способ подробно описали в статье «Folding Language Models into Themselves». Готовые веса уже выложены на Hugging Face под свободной лицензией Apache 2.0.
Что значит «свернуть» модель
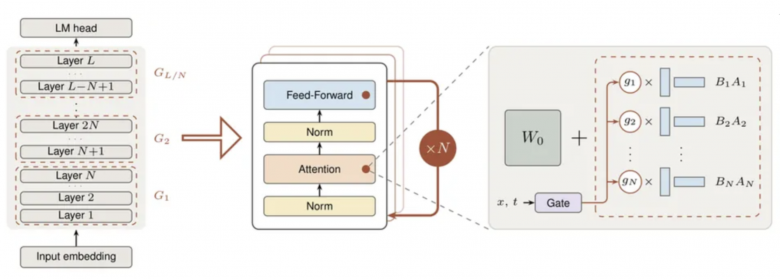
Обычно при сжатии нейросетей лишние слои просто выкидывают, но от этого модель «глупеет», так как теряет глубину рассуждений. Авторы Concertina пошли другим путем и буквально сложили соседние слои Qwen3-4B попарно, как меха гармошки.
Каждая пара соседних слоев Qwen3-4B заменяется одним общим блоком, который выполняется дважды. Общие линейные матрицы берутся из первого слоя пары. Второй проход получает поправку ранга 64, которую инициализируют усеченным SVD разности двух исходных слоев, а поток поправки масштабирует гейт для каждого токена. Нормализации RMSNorm у каждого прохода свои. После сборки студента дистиллируют из той же Qwen3-4B, потеряв при этом 43% параметров: 2,27B против 4,02B.
Сравнение с ближайшими альтернативами
Данные взяты из таблицы в пересказе карточки модели.
Qwen3-4B (учитель) |
Qwen3-1.7B |
Concertina-2.27B |
|
Параметры |
4,02B |
1,72B |
2,27B |
Токены обучения |
36T |
36T |
22B (дистилляция) |
base-7 (среднее) |
0,630 |
0,562 |
0,580 |
MMLU |
0,671 |
0,557 |
0,556 |
MMLU-Redux |
0,720 |
0,591 |
0,587 |
MMLU-Pro |
0,404 |
0,297 |
0,301 |
GPQA |
0,379 |
0,293 |
0,308 |
BBH |
0,505 |
0,363 |
0,400 |
GSM8K |
0,879 |
0,710 |
0,788 |
MATH |
0,566 |
0,460 |
0,498 |
Чтобы было проще ориентироваться в метриках: base-7 — это средний балл по семи базовым тестам на здравый смысл и понимание контекста, Redux и Pro — исправленная и усложненная версии бенчмарка MMLU, GPQA проверяет научные знания уровня аспирантуры, BBH — сложную логику, а GSM8K и MATH — математику.
Concertina выигрывает у Qwen3-1.7B по base-7, Pro, GPQA, BBH, GSM8K и MATH, а на MMLU (0,556 против 0,557) и Redux (0,587 против 0,591) уступает с минимальным отрывом. Учителя она не догоняет ни на одном тесте. По моему расчету из таблицы, средняя доля качества учителя равна 84%, как и заверяют авторы. Задачи на рассуждения держатся лучше всего, около 90% у base-7 и GSM8K, а знания и сложные вопросы теряют больше, Pro и BBH ближе к 75–80%.
Что экономится, а что нет
Вес в bf16 уменьшается с 8,0 до 4,5 ГБ. Эффективная глубина остается 36 слоев (18 уникальных блоков по два прохода), и KV-кэш такой же, как у Qwen3-4B. Вычислений на токен, вероятно, примерно столько же, потому что каждый общий блок исполняется дважды.
Замеров скорости и пропускной способности в карточке нет. Для устройств, где упираются в память весов, выигрыш виден сразу. Для серверного инференса, где решают скорость и кэш, его пока подтвердить нечем.
Как проверить
Код в репозитории короткий: функции fold_model и distill_loss, самотест на CPU. Лицензия Apache 2.0, как у исходной Qwen3-4B. В репозитории два коммита и единственный чекпоинт, других конфигураций (другой размер группы, другой ранг) нет.
Стоит проверить метод на модели другого семейства и измерить реальную скорость. Если она не вырастет, Concertina останется способом сделать модель компактнее исключительно по памяти, но не по скорости.
А как вам сама идея рекуррентного «сворачивания» слоев? Кто-нибудь уже успел прогнать чекпоинт у себя и замерить реальный tokens/sec на GPU по сравнению с обычной Qwen3-4B? Делитесь результатами в комментариях.

ИИ‑роутер — доступ к 400+ моделям из одной панели
Подключите OpenAI‑совместимый шлюз по единому API‑ключу. Настраивайте сквозную аналитику, отслеживайте лимиты и квотируйте ресурсы.
Комментарии (26)

rPman
17.11.2026 12:08в результате по их же сравнению 1,7B модель хуже полученной 2,27B модели на 1…3% (BBH GSM8K на 10%) при этом количество весов у нее меньше на 32% (еще про скорость не говорят, если там дважды вычисления, значит скорость работы как у исходной 4B)… т.е. получается идея не стоящая
p.s. проверять нужно было на модели с большим количеством весов, так как маленькие и так уже на грани качества держатся (если совсем не на заученных знаниях). маленькие модели обычно от любых попыток их оптимизировать ломаются заметно сильнее чем большие.

Eduard_Bocharov
17.11.2026 12:08По моему, тут смысл в снижении расходов на обучении моделей под свои требования. Количество токенов на обучение было взято на 3 порядка меньше

Wolf4D
17.11.2026 12:08Причём взяты веса bf16, что для такой модели - выбор крайне странный. Золотой стандарт - квант Q4_K_M, который на 4B занимает ~2.2 Гб на диске (и до 4.5 Гб VRAM). А указанными 4.5 Гб определённо можно распорядиться гораздо эффективнее.
rPman
17.11.2026 12:08скорее всего идея была в том что позже модель можно было бы еще и квантовать, ведь технология сжатия указанная в статье кардинально отличается от квантования и в теории будет возможно их совмещать.
дико интересно, можно ли такое совершить с моделями по сильнее и плоскими, например qwen3.8-27b


CitizenOfDreams
17.11.2026 12:08Concertina, от англ. «концертина» — вид небольшой гармошки, а не чего-то «конкретного».
Да мы тут люди мал-мала грамотные, не путаем concertino и con cretino...
Скрытый текст


JediPhilosopher
17.11.2026 12:08Объясните, для чего нужны такие мелкие модели вообще? Я пробовал qwen на 7b параметров и она была практически бесполезна во всем. Да, какой-то текст отвечать может. Но вызовы инструментов уже не может (формально там вроде есть поддержка, но на деле это слезы, постоянно ломает синтаксис вызова, цепочки вызовов уже не может сделать), галлюцинирует во всю, код писать уже тоже не умеет чтобы он работал... Зачем они вообще нужны, какой у них практический сценарий использования?

ksbes
17.11.2026 12:08Как раз для ответа текстом и используют - для всяких RAG, или просто искалку дают. Для конфедициальных документов - само то. Анализирует/суммаризирует не так уж и плохо.

rogoz
17.11.2026 12:08Ну да, вот по модели 2023 года только и оценивать практический сценарий использования.
ksbes
17.11.2026 12:08Ну давайте слои модели, как матрицу, ещё по JPEG “сожмём” - ещё ж эффективней будет! Нет?

WondeRu
17.11.2026 12:08Толерантность к ошибкам в IT за последние четыре года изменилась радикально. Раньше заказчик мог устроить скандал из-за запятой не на своём месте или неверного округления. Мы часами вычитывали код, гоняли тесты, правили мелочи, потому что качество было не опцией, а нормой.
Модель уменьшили вдвое, и теперь она ошибается в 25% случаев. Это подают как достижение.
"Ты лучше голодай, чем что попало есть" (с)

ZardoZAntony
17.11.2026 12:08Так вычитывать код после модели никто не отменял. Это же инструмент генерации черновика, а не чистовой продукт. В случаях, когда черновика достаточно (пилот, демка) никто и не парится. А для качества код-ревью обязательно.

balamutang
17.11.2026 12:08Это модель не для кода, это говорилка настольная типа умный поиск по документам и тд


SolidSnack
17.11.2026 12:08Сознание Хабра, подскажи мне, я правильно понял что у ИИ есть критическая масса ОБЯЗАТЕЛЬНОГО количественного минимума для обучения внятной и пригодной хоть для чего-то модели?
Получается, модель меньщая по объему заученных ею данны, чем у ребят из огромных корпораций, ближе к Т9 чем к AGI?
rPman
17.11.2026 12:08В зависимости от объема обучающих данных (условных знаний в них) и целевых задач, да, но как я понял оценка снизу постоянно сдвигается вниз. Самые первые исследования показывали (кажется это) что где то после 10^24 условных мат-операций, потраченых на обучение модель начинает проявлять признаки интеллекта.
'внятная и пригодная хоть для чего то' - расплывчатое понятие, например использование как классификатор, даже 0.5B модели могут что то, а 1B могут даже изображения разбирать и описывать. Например https://huggingface.co/LiquidAI/LFM2-VL-450M требуют меньше 1Gb памяти (помню там был даже вариант запуска в браузере с поддержкой webgl).
А вот качество и стабильность очень капризны, каждый следующий условный процент требует экспоненциально либо повышение затрат на обучение либо количество весов (требований к памяти) плюс лфайхаки типа включение размышления с высокими бюджетами или к примеру повторение одного и того же запроса с высокими значениями температуры (условно сделать 1024 запроса и статистически взять наиболее частый ответ) дают еще чуть чуть буста.
Про Т9 это вы по больше слушайте ботов в чатах (не понимаю экономического смысла в их существовании но они есть), которые с завидным постоянством твердят эту глупость. После определенного объема обучающей выборки от Т9 там ничего не осталось (переход от мегабайтов у Т9 к терабайтам).
p.s. между 'отвечать на короткие вопросы' и 'устойчиво решать агентские задачи' пропасть на пару порядков весов и затрат на обучение
SolidSnack
17.11.2026 12:08проявлять признаки интеллекта
Утверждение очень спорное, само определение интеллекта может быть темой для дискуссии, а вы уже такое заявлете)
После определенного объема обучающей выборки от Т9 там ничего не осталось (переход от мегабайтов у Т9 к терабайтам)
Этому есть научное подтверждения? Или из-за объема и сложности системы это персонофикация? (Если верить гуглу). По моему, свойство психики упрощать сложные системы, антропоморфировать их, давно известно человечеству, с чего вы взяли что не занимаетесь этим прямо сейчас?
Только потому что в алгоритм положили больше данных?
rPman
17.11.2026 12:08Этому есть научное подтверждения?
конечно, если бы не тролили вы бы просто погуглили бы и нашли. есть работы по исследованию.. качество моделей функция от данных, ресурсов на обучение и количества весов (описание одной из таких исследований, что нашел гугл а не сама статья, мне лень), так же были исследования показывающие что начиная с определенной сложности у модели появляются возможности которые в нее не закладывали через обучающую выборку.
я же осторожно сказал - 'проявляют признаки интеллекта' а не являются интеллектом, но вы упорно сводите диалог к этому. Все что у нас есть - это 'бенчмарки', экзамены, прохождение которых агентами на основе ИИ дают численную оценку, которая дает основание сравнивать модели и говорить 'эта умнее той', в т.ч. с людьми
p.s. современные модели, все еще не дотягивают универсально до человека, но областей, в которых это так становится все меньше, а во многих областях машина давно обошла обывателя и число этих областей растет.
SolidSnack
17.11.2026 12:08Погуглил что? Лично для меня, что-то погуглить, само по себе не имеет никакого веса. Вы вот нагуглили сайт aiblogly, вы вот сами как думаете, такой сайт заинтересован в продвижении ИИ? Учитывая что и сайт то у них навайбкоженный...
Что-то я пока только вижу как возможности ИИ растут с тем сколько всего в нее пытаются запихнуть, сама по себе она никаких выводов не делает и сама, по своей инициативе (как бы смешно это не звучало) ничего не учит.
Если для Т9 построили сотни дата-центров и запихали в нее все текста человечества, лично для меня это не делает алгоритм интеллектом или даже чем-то похожим)
Я то не свожу диалог к этому, к этому диалог сводят сами любители ИИ, заявляя что вот вот и AGI всех уволит с работы...
А я вот слышал мнение что в текущей реализации они со 100% точностью не до одной области человека не дотянутся, даже снимки вместо рентгенолога пока не могут смотреть, да ладно рентгены, вы знаете хоть 1 компанию где на тех поддержке стоит нормальный ИИ который решил хотя-бы 1 вопрос более менее нестандартный, на который у человека уйдет 3 минуты вместе с выслушиванием причины?)
Как-то так получается что в интернете если погуглить, да и вообще послушать людей, то ИИ уже проявляет признаки интеллекта.
Но если просто посмотреть по сторонам то никаким искуственным интеллектом не пахнет...
Только нейрослоп рекой льется, это да, это трудно не заметить

slavic-voronezh
17.11.2026 12:08ну ты сравнил бесконечный мир и набор транзисторов. Почитай на программу для андроида на странце где отзывы люди пишут к обновлениям вквидео, а им ИИ строчит одинаковые ответы на все их вопросы что в вк не удобно смотреть видео и для удобства разработана программа вквидео, в которой фоновое воспроизведение отключено как и в куче аналогичных программ, и доступно по подписке :) Поэтому вквидео смотрю только на телевизоре. ИИ - это супер перспективное направление, а вк - это супер пупер, как и вк видео.
" если просто посмотреть по сторонам то никаким " - зрение (*)(*) и нюх /()()\. В твоём тексте куча шаблонного - нелогичных связок слов - мусора, на котором обучают детей нелогическому мышлению, а дети - обучают взрослых, взрослые - обучают ИИ.
Просто посмотреть и посмотреть - это наверное идёт речь про беглый взгляд, учти что воображаемая вселенная перестраивается с частотой 1/25 сек и если ты сможешь моргать с такой частотой - то у тебя получится уже перестроенный на частоту моргания взгляд. Если ты смотришь неморгая то это может быть и простой взгляд а может быть усреднённый взгляд. А если смотреть неморгая и с частотой 25 раз в секунду закрывать и открывать шторки - это не то же самое что и моргать с частотой 25 раз в секунду через моргающие шторки с частотой 25 раз в секунду, особенно если ты при этом глядишь на экран, наример, телевизора на котором также пиксели перестраиваются с определённой частотой. Прикинь какая нужна производительность если глаза имеют свойство двигать зрачками непроизвольно и ты не замечаешь этого движения, поскольку у тебя изображение определяется положением и направлением головы, и куда не двигай глаза - в любую сторону, пока не повернёшь голову поле зрение не меняется и кто тут робот?
Есть ещё боковое зрение - и глядя боковым зрением на экран телевизора видны артефакты телекартинки.
Так каким зрением ты смотришь прямым боковым и как оно у тебя связано с нюхом.
В начале ты ощущаешь запах а потом смотришь или вначале смотришь а потом ощущаешь запах ИИ.
Mixael_sas
Примените нейросеть хотя бы на заголовке, смысл непонятен.