

Введение
Сегодня ИИ‑помощники позволяют значительно быстрее реализовывать новые требования к программному обеспечению. Особенно хорошо это заметно на уровне отдельных задач и небольших проектов. Однако если непосредственная реализация ускоряется в несколько раз, то другие процессы — архитектурное проектирование, согласование требований и верификация — далеко не всегда ускоряются пропорционально.
В результате возникает дисбаланс. Накопленная сложность и неконтролируемое поведение системы порой начинают создавать проблемы быстрее, чем разработчики успевают их обнаруживать и устранять.
Представим самолёт, на который установили значительно более мощный двигатель. Самолёт прекрасно летал прежде, его конструкция была надёжной и хорошо справлялась со своими задачами. Но проектировали его для других скоростей. Теперь, по мере разгона, нагрузки возрастают, отдельные элементы конструкции перестают их выдерживать, возникают проблемы с управляемостью. Пилот пытается удержать самолёт, но дело уже не в его мастерстве. Сама скорость создаёт условия, в которых прежние методы обеспечения устойчивости перестают работать. При дальнейшем ускорении самолёт может просто разрушиться.
Нечто похожее мы сегодня наблюдаем в разработке программного обеспечения с помощью ИИ. Мы получили гораздо более мощный двигатель, но продолжаем использовать прежние подходы к проектированию и контролю. В какой‑то момент проект может начать внезапно и стремительно терять управляемость и буквально разваливаться на части.
Это и есть наш звуковой барьер.
Но звуковой барьер оказался преодолим. Для этого авиационным инженерам пришлось пересмотреть подходы к проектированию самолётов, учитывая нагрузки и особенности полёта на новых скоростях. Аналогичная задача стоит теперь перед нами: необходимо развивать методы проектирования и контроля программного обеспечения, чтобы использовать новые возможности ускорения, не теряя устойчивости создаваемых систем.
В этой статье мы рассмотрим несколько проблем разработки и верификации программного обеспечения в условиях применения ИИ‑помощников. Сами по себе эти проблемы не новы: они существовали задолго до появления современных ИИ‑моделей. Но ускорение разработки сделало их проявления более заметными, а последствия — потенциально более серьёзными.
Главный вопрос, на который мы попробуем ответить: что необходимо изменить в наших подходах к разработке программного обеспечения, чтобы ускорение, которое дают ИИ‑модели, не приводило к потере контроля над создаваемыми системами?
Неопределённость требований
Рассмотрим проблему формулирования запросов и описания решений. Начнём с множества возможных поведений перед принятием решения:

Здесь одна точка квадрата — это один вариант поведения системы: например, конкретные тестовые данные на входе и поведение на выходе. Тёмно‑серый цвет означает, что поведение не определено спецификацией, поэтому реализация для такой точки может быть любой. Весь квадрат окрашен в этот цвет, потому что запроса ещё нет. То есть до постановки задачи ещё нет ограничений на поведение системы, поэтому любое поведение будет считаться корректным относительно этой спецификации.
Когда мы формулируем задачу, например «напиши клиента, который выполнит HTTP‑запрос по указанному URL и заберёт данные», то мы определяем желаемое поведение для определенных условий. В данном случае, если все хорошо и ничего не сломалось, то данные должны быть получены (A). Выглядит это так:
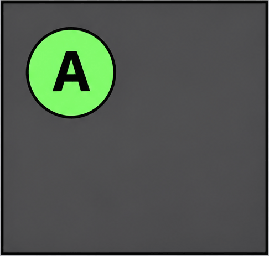
То есть для множества входных данных, при которых всё хорошо (A), мы задали поведение, показанное зелёным цветом. Но при этом существенная часть квадрата остаётся серой: в задании не определено поведение для этих случаев (например, при таймауте), а значит, в этой области разработчик — неважно, человек или ИИ, — может выбрать любую реализацию.
Далее добавим в требования «если получен ответ 500, то сделай повтор через 10 секунд» (B). В этом случае ситуация становится лучше, так как мы явно задаём поведение для части серой области, а главное — мы ставим это под контроль. В этом случае мы уже можем написать тесты, статический анализ получает основу для разбора, ревьювер может сказать, что не соответствует спецификации (про серое такое он сказать не может), и так далее. В то же время картинка меняется на такую:
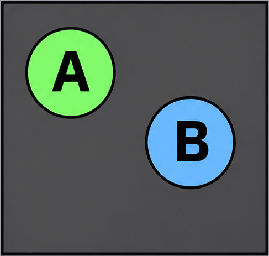
Мы определили, что делать, когда всё хорошо (A), и как реагировать на 500 (B). Но это не исключает всю серую зону. И если выдать такое задание в работу, то результат может выглядеть так:
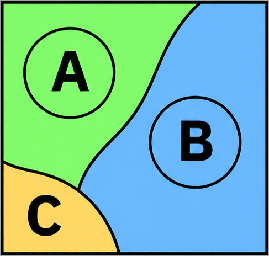
Разберём, что тут происходит. Разработчик выбирает какую‑то реализацию на своё усмотрение. Допустим, что он всё сделал правильно относительно A и B (хотя это не гарантировано: возможны ошибки). Реализация обладает конкретным поведением в каждом случае и не может быть серой. Она должна задавать конкретное поведение для каждой точки. Например, если делать повтор на любую ошибку, то это будет корректное поведение относительно запроса, так как для ошибки 500 это верно, а для других ошибок не определено. Но в то же время реализация может отправлять на повтор и ошибки >500, и тогда поведение B распространяется не только на ответ 500, но и на ответы с кодами >500.
На картинке показана область C — она может соответствовать поведению, которое не описано явно в запросе, например остановке приложения при выбрасывании исключения.
А что происходит со стороны разработчика? Один разработчик пойдет на Stack Overflow и скопирует оттуда пару строк. Другой может посмотреть примеры рядом в проекте. Третий уже сто раз так делал и сделает по‑своему. ИИ‑помощник не исключение: возможно, он постарается сэкономить токены, а возможно, проведёт какую‑то внутреннюю самопроверку. Но в любом случае мы получаем различный спектр решений. И если над этими решениями нет контроля, конечная реализация будет непредсказуемо варьироваться.
Таким образом, неопределённость требований означает, что мы не вполне контролируем то, что строим.
Накопление локальных решений
Если мы реагируем на поставленные требования так, что буквально их выполняем, то в ряде случаев это приводит к структурным проблемам. Как это выглядит?
Например, задание звучит как «напиши клиента, который выполнит HTTP‑запрос по указанному URL и заберет данные». В этом случае что человек, что ИИ‑помощник могут написать несколько строк кода, которые это выполнят:
const response = await fetch('https://api.example.com/data');
const data = await response.json();
(Примечание. Этот пример намеренно минимален: он буквально выполняет сформулированное требование, оставляя поведение при ошибках на усмотрение используемых средств. Он иллюстрирует неопределённость требований, рассмотренную выше. Этот и последующие примеры не привязаны к конкретному языку, платформе или ИИ‑модели.)
И к такому решению сложно придраться — оно буквально выполняет ровно то, что потребовалось. Однако в больших и сложных проектах это зачастую не совсем то, что нужно. В частности, оно не отвечает на вопрос, как поведёт себя система, если что‑то пойдёт не так — например, придёт ответ с кодом, отличным от 200, или произойдёт таймаут соединения. Такое решение не учитывает работающее окружение (корректность данных, доступность сервера, эксплуатационные возможности приложения и др.).
На практике более опытный инженер, увидев такое решение, может спросить разработчика, будь то человек или ИИ‑модель: «А как поведёт себя система, если произойдёт такая‑то проблема?» И тут в ответ может прозвучать «Ой!», и эта пара строк кода начнёт обрастать обработчиком указанной ошибочной ситуации.
Рассмотрим ту же ситуацию с другой стороны. В работающую систему пришло сообщение об ошибке. Как правило, это точечное сообщение вида «клиент делает X, получает Y, а ожидается Z». Это преобразуется в задачу вида «Если X, то надо сделать так, чтобы было Z». Как видим, это требование точечное, оно очень похоже на одиночный вопрос «а что, если…?», заданный выше.
Если используется такой подход, то, скорее всего, в моменте его негативные последствия не видны. Но на более длинной дистанции это можно проиллюстрировать следующим образом. Рассмотрим некую хорошо построенную систему, и она выглядит вот так:

Неровностей не видно, ошибок и проблем тоже. Но в какой‑то момент возникает новое требование или обнаруживается ошибка. Если правки вносятся методом, описанным выше, то это преобразование выглядит так:
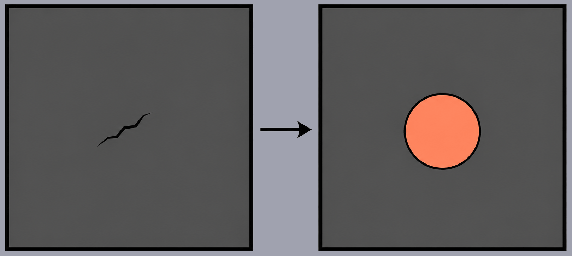
Мы поставили заплатку. И всё работает. Но в дальнейшем появляется новое требование, и еще одно, и еще одно. Как следствие, система начинает выглядеть вот так:
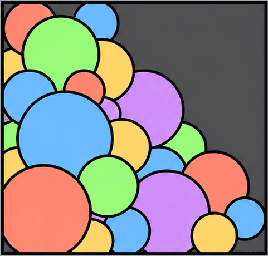
И наша хорошо построенная изначально система превращается вот в такую неровную мозаику.
Проблема, которая возникает из‑за мозаичности, подобна проблеме отсутствия структурного подхода при программировании или проектировании. На более низком уровне мы получаем спагетти‑код. На практике даже при хорошем покрытии тестами такой код сложно сопровождать — каждый новый запрос приводит к тому, что нужно проверять и контролировать множество зависимостей. Это известно еще со времен Дейкстры и Хоара — если не структурировать систему на более высоком уровне, то мы получаем как дополнительный источник ошибок, так и дополнительную сложность для отладки, анализа и верификации.
Чтобы решить эту проблему, нужна отдельная процедура, в рамках которой разработчик делает шаг назад или взлетает над системой для большего обзора, определяет обобщающие зависимости и строит модель более высокого уровня. На картинке это может выглядеть таким образом:
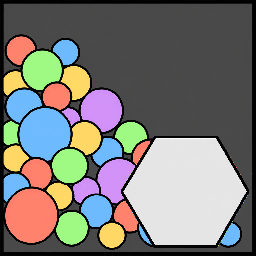
Таким образом, накопление локальных решений означает, что мы постепенно теряем контроль над тем, как это устроено.
Тут есть ряд вариантов решения проблемы, и они могут быть разного уровня и масштабности. Но общий подход — необходимо периодически осматривать происходящее и принудительно структурировать, в том числе с ИИ‑помощником. Для описанного случая можно рассмотреть такие принципиально разные варианты:
просто задать вопрос ИИ: «Проанализируй поведение, если возникла та или иная ошибка (4 xx, 5 xx, обрыв соединения и тому подобное), а также другие ошибочные ситуации (например, таймаут)»;
после того как, например, ИИ‑помощник найдёт множество случаев в проекте и добавит выбрасывание стандартных исключений, попросить его провести типизацию исключений и построить иерархию для удобной обработки ошибок;
задать вопрос: «Вот у нас три класса. Давай подумаем, что у них общего и можно ли что‑то вынести в базовый класс»;
описать предусловия, постусловия и инварианты.
Могут быть и другие более обобщающие архитектурные решения, о которых мы поговорим дальше.
Контроль проектных знаний
Представим программиста, который подключается к проекту и не имеет доступа к предыдущим разработчикам. Он не знает принятых ими соглашений, неявных договорённостей и допущений. Например, он видит набор директорий:
src/
  controllers/
  services/
  repositories/
Это может говорить о том, что использовалась трёхслойная архитектура Three‑Layer Architecture (3LA), но неясно, правда ли это, насколько широко она применялась и какие у неё границы. Помимо факта применения, остаются открытыми вопросы:
Где заканчивается ответственность контроллера и начинается ответственность сервиса?
Допустимо ли обращаться к репозиторию непосредственно из контроллера?
На каком уровне определяются границы транзакций?
Где выполняются авторизация, валидация и сериализация?
И даже если изучить существующий код, однозначного ответа может не быть. Например, если все существующие контроллеры вызывают сервисы, это может означать архитектурное правило. А может быть просто совпадением или привычкой предыдущих разработчиков. Другими словами, наблюдаемая упорядоченность ещё не является доказательством существования соглашения.
Разработчику же в этой ситуации приходится разбираться самому, и он начинает принимать решения исходя из собственного понимания и уровня подготовки. Один разработчик не распознает архитектурный подход и пойдёт по пути наименьшего сопротивления, другой осмотрится и будет делать что‑то похожее, третий распознает концепцию, но применит её исходя из собственных предпосылок, которые могут отличаться от предпосылок авторов проекта.
Особенность в том, что ИИ‑помощник находится в подобной ситуации. По сути, запуск агента с нуля похож на то, как если бы мы нанимали случайного программиста из всей индустрии, с его особенностями, и отправляли его в бой. И если его не проинструктировать, то он будет действовать по своему усмотрению. А если он видит только код, то мы получим соответствующие последствия. При этом даже одна и та же модель в разных сессиях может вести себя как несколько разработчиков с разными привычками. Один агент выбирает одну декомпозицию, другой — другую. Один следует существующим именованиям и соглашениям, другой привносит свои. Третий обнаруживает архитектурную закономерность, но трактует её иначе, чем предполагали авторы системы. Они все могут написать рабочий код, но без инструкций они выбирают различные варианты заполнения серой области, описанной в разделе «Неопределённость требований».
Если код лишён описаний того, как он сделан, то агент, как и программист, видящий его впервые, видит конкретную реализацию, но не видит условий, объясняющих, почему она устроена именно так.
Представьте, что на свете существует бесконечное число вселенных, в каждой из которых свои законы. Вас выбрасывает в произвольную из них, и вы наблюдаете кучу тел, которые как‑то движутся, светятся, взаимодействуют. Вам в этой обстановке нужно что‑то сделать. Чтобы не ошибиться, нужно по‑хорошему заново открыть все законы, и если этого не сделать, то для вас это будет темная материя. И здесь каждый раз, когда мы запускаем нового агента, не давая ему инструкций, он попадает в подобную ситуацию: чтобы понять, как всё устроено, ему нужно заново открыть законы Ньютона и многое другое. У него, конечно, есть библиотека всевозможных вселенных, но всё равно не факт, что он поймёт всё правильно.
Проблема не нова, и её решение тоже известно: необходимо документировать всё, что требуется для восстановления контекста. Наша же задача на новом витке развития программной индустрии — организовать процесс разработки таким образом, чтобы необходимые сведения не только документировались, но и предоставлялись ИИ‑помощникам в контексте выполняемой задачи. Иначе каждая новая сессия — это в некотором смысле новый сотрудник, которого отправили писать код без полноценного знакомства с проектом.
Другая формулировка этого же тезиса: проектные соглашения должны существовать не только в головах участников команды и не только в исходном коде, но и в форме, доступной каждому новому агенту с самого начала работы. Но ее мы впоследствии усилим: необходимо организовать процесс разработки так, чтобы каждый новый участник, включая ИИ‑агента, получал необходимые инструкции и не мог легко пройти мимо существенных ограничений.
Предоставление контекста
Рассмотрим способы предоставления контекста.
Какими свойствами должно обладать предоставление контекста? Звучит достаточно абстрактно. Очевидно, что информации должно быть достаточно для решения задачи. При этом она должна быть непротиворечивой, а лишней информацией агента по возможности не следует нагружать. Если же противоречия обнаруживаются, должен быть предоставлен путь их разрешения.
Если же противоречий много или есть серые области неоднозначности (см. раздел «Неопределённость требований»), то агент либо остановится и задаст вопрос, либо сделает так, как посчитает нужным. В первом случае мы теряем скорость нашего проекта, во втором создаём дополнительную нагрузку, рискуя в какой‑то момент развалить конструкцию самолёта.
Вместе с тем размер контекста конечен. И для борьбы со сложностью необходимо применять дополнительные методы, среди которых магистральный путь — борьба со сложностью через структуризацию проекта — систематическое выделение отдельных частей и сущностей, определение их границ и работа в соответствующем контексте. Как следствие, структуризация позволяет локализовать значительную часть сложности и рассматривать многие задачи без необходимости удерживать в контексте весь проект (см. раздел «Накопление локальных решений»).
Однако при работе с ИИ‑помощником возникают дополнительные особенности организационного процесса — необходимо предоставлять всё необходимое автоматически; любая дополнительная коммуникация снижает скорость и повышает издержки; если же источник истины плавает, то это также приводит к проблемам дрейфа и перепроектирования. Поэтому здесь требуется обеспечить формализацию и фиксацию доступа к описаниям сущностей и требований.
Подход вида «Если что‑то непонятно, спрашивай» работает, но медленно. Это не та конструкция, которая обеспечит преодоление звукового барьера. Чем меньше будет влияние этого фактора, тем быстрее мы сможем двигаться. Чем более формализован будет этот процесс и связан с причинами тех или иных решений, тем безопаснее будет полет.
Таким образом, для преодоления звукового барьера недостаточно сохранять проектные знания. Необходимо организовать процесс так, чтобы ИИ‑агент автоматически получал достаточный, непротиворечивый и актуальный контекст, а возникающие неопределённости разрешались контролируемым образом.
Организация процесса разработки может быть разной. Но здесь мы видим, что мы уже можем сформулировать требования, с помощью которых можно проверить, насколько рассматриваемый организационный процесс решает озвученные проблемы. Рассмотрим 5 таких требований.
1 Предоставление проектных знаний
Имеется ли механизм, предоставляющий полный контекст в момент решения задачи? Иными словами, как бы агент ни добрался до поставленной задачи, ему необходимо предоставить действующие для неё соглашения и ограничения.
Например, мы говорим агенту «исправь функцию X», а в корне проекта имеется Markdown‑файл с описанием общих правил работы с кодом. Если организационный процесс построен так, что агент может приступить к работе, не зная содержимого Markdown‑файла, значит, это требование нарушено.
2 Достаточность контекста
Предоставлены ли все данные для того, чтобы выполнить задачу? Может ли агент выполнить задачу без догадок о существенных свойствах системы?
Допустим, агент должен добавить новый API endpoint. Задача поставлена так, что он знает, какие данные нужно возвращать, но не знает, где должна выполняться авторизация. У него есть несколько вариантов: запросить уточнение, воспроизвести ближайший пример или применить известную ему архитектурную практику. Если правило проекта формализовано и доступно, неопределённость исчезает без дополнительного общения с человеком. Если же правила нет, то поведение агента может быть произвольным. В некоторых случаях это корректно (если в контексте задачи неважно, как будет выполнена авторизация, агент может выбрать любое поведение в пределах серой зоны, описанной в разделе «Неопределённость требований»). В других это может привести к снижению скорости или к ошибкам.
3 Прослеживаемость
Можно ли восстановить условия возникновения требований?
Если встречаются противоречивые требования, то можно ли проверить, насколько они актуальны в настоящее время? Можно ли перестроить логические цепочки из исходных требований так, чтобы противоречие было разрешено?
4 Разрешение конфликтов
Есть ли определённый порядок действий при неоднозначности и противоречиях?
Если в случае возникновения противоречий ИИ‑помощник сможет разрешить их самостоятельно, то это способствует преодолению звукового барьера. При этом проверить решения агента можно, если они основаны на известных правилах, а не просто на уверенности модели в выбранном варианте.
Рассмотрим пример для требований 3 и 4. Допустим, что в проекте существует правило, что все операции записи должны выполняться внутри транзакции. Но позднее появилось требование выполнять некоторые операции асинхронно. Агент видит конфликт. Если ему доступны только две инструкции, он не обязательно сможет выбрать правильную. Если же известны основания решений, можно выяснить, что первое правило вводилось ради атомарности конкретных бизнес‑операций, а второе связано с необходимостью вынести длительные процессы из HTTP‑запроса. Тогда появляется возможность не просто выбрать более новую инструкцию, а найти решение, сохраняющее существенные свойства обеих.
5 Структурная целостность
Происходит ли время от времени реструктуризация локальных решений на более высоком уровне абстракции?
Предположим, что в ходе развития проекта в нём накопилось множество клиентов для выполнения HTTP‑запросов. Каждый из них решает свою задачу, но в совокупности они усложняют сопровождение системы. Анализ повторяющихся решений может выявить общие закономерности и привести к выделению отдельного компонента для выполнения HTTP‑запросов, который, например, унифицирует процедуру обработки ошибок.
Таким образом, подобный подход показывает, как можно увеличить допустимую скорость разработки, не теряя контроля. Это происходит не потому, что человек быстрее проводит ревью (мастерство пилота), и не за счёт усовершенствования модели (мощности двигателя). Это происходит за счёт изменения самого процесса разработки: существенные ограничения становятся явными, информация подаётся в нужном контексте, типовые противоречия разрешаются по установленным правилам, а вмешательство человека требуется прежде всего там, где действительно необходимо новое решение.
Проектируем производственный процесс
1 Предоставление проектных знаний
Предположим, что у нас проект организован таким образом, что в корне проекта имеется файл ai.md со следующим содержимым:
Перед любыми действиями с файлами в подпапке:
1. определить целевой путь задачи
2. прочитать все `ai.md` от корня проекта до ближайшего к целевому пути
3. применять прочитанные правила
(ai.md — условное имя файла, выбранное без привязки к конкретной модели или провайдеру.)
Далее, если у нас возникают требования на соответствующем уровне, мы их на нем и внедряем. Например, в такой структуре:
src/
  controllers/
  services/
  repositories/
  ai.md
Здесь в ai.md мы можем записать вышеупомянутые требования к 3LA. Как видим, если агент применяет дословно описанные правила корневого ai.md, то при любой работе на уровне src и глубже он обязан прочитать требования 3LA. Если же он работает вне src, то этот ai.md в контексте не участвует, и это снижает объём контекста для работающих агентов.
Выполняется ли сейчас 1-е требование? Пока что нет, так как нам нужен механизм, обязывающий читать корневойai.md. Этот механизм может быть как программным (конфигурационным), так и организационным (обязанность каждого разработчика начинать работу с сообщения «прочитай корневой ai.md»). Варианты могут быть разными, мы указываем на необходимость обеспечить данное свойство.
2 Достаточность контекста
Второе условие не такое простое. Мы посмотрим на некоторые примеры и разберем ограничения.
Прежде всего, оно зависит от постановки задачи. Здесь мы можем потребовать, чтобы при её формулировке были определены критерии приёмки (AC, acceptance criteria), по которым можно проверить, выполнена ли задача. Такой подход даёт агенту основу для оценки результата и тестирования. Это не даёт абсолютного контроля, так как не всё можно протестировать для всех возможных входных данных, а у обобщающих методов есть свои ограничения. При этом не обязательно требовать, чтобы AC формулировал человек. Процесс можно организовать так, чтобы перед началом работы требовалось определить AC и/или проверить текущее состояние. Эти действия можно поручить агенту, чтобы он проводил соответствующие проверки в начале работы над задачей.
Например, постановка задачи может звучать так: «реализовать функцию divide(a, b), возвращающую результат деления»:
double divide(double a, double b);
Затем добавляем критерий приёмки:
Функция возвращает результат деления a на b.
Теперь можно использовать несколько тестовых случаев, чтобы проверить реализацию на соответствие этому критерию:
divide(10, 2) == 5
divide(0, 5) == 0
divide(-10, 2) == -5
Эти тесты позволяют проверить реализацию, но не доказывают, что критерий выполняется для всех возможных входных данных.
Помимо постановки задачи, достаточность контекста включает и состояние проекта: в каждый момент у него уже есть своя история, и он опирается на множество решений и соглашений. Чтобы повысить достаточность контекста, эти требования необходимо довести до агента. Есть несколько способов их представления; рассмотрим некоторые из них.
Например, нам необходимо описать предусловия и постусловия некоторой функции. Удобным вариантом может оказаться использование известных инструментов документирования (Doxygen, Javadoc и др.), когда в комментариях перед функцией или в подобном ее контексте описываются данные требования. В нашем примере это станет выглядеть так:
/**
 * @pre std::isfinite(a) && std::isfinite(b).
 * @pre b != 0.
 * @pre std::isfinite(a / b).
 * @post Returns a / b.
 */
double divide(double a, double b);
Аналогично, если мы хотим задать инвариант для объектов какого‑то класса, то мы можем описать его в файле этого класса непосредственно перед ним или внутри него в виде комментария. Удобство такого размещения основано на предпосылке, что весь файл будет прочитан — как человеком, так и машиной, — поэтому условия будет сложно пропустить. Однако следует иметь в виду, что эта предпосылка может перестать работать: например, если агент выполнит поиск по ключевым словам с помощью grep или пропустит комментарии каким‑то другим способом.
В случае применения более сложных моделей или общих требований может быть удобным их вынос в отдельное место и создание ссылок на них для тех или иных контекстов. Это касается протоколов передачи данных, правил работы с клиентами, общих архитектурных подходов для различных случаев, стратегии обеспечения безопасности и надёжности и др. Например, мы можем в одном месте описать, как в проекте идет работа с исключениями, оформить ссылку в базовом или контекстном ai.md и указать, что при любых преобразованиях, касающихся исключительных ситуаций необходимо подгружать и применять эти требования.
В нашем примере функции деления мы описываем в отдельном файле docs/error-handling.md:
# Error Handling

При нарушении предусловий публичных функций:
- выбрасывать std::invalid_argument;
- сообщать, какое условие нарушено;
- не возвращать специальные значения вместо ошибки.
и в ai.md:
При разработке или изменении публичных функций применять правила из docs/error-handling.md.
Следует отметить, что достаточность контекста нельзя гарантировать описанными способами, так как она упирается в проблему валидации: откуда мы знаем, что предоставленной информации действительно достаточно для корректного решения задачи? Иными словами, мы способны проверить наличие определённых знаний и соответствие реализации явно сформулированным требованиям, но не можем одной такой проверкой гарантировать, что все существенные требования вообще были сформулированы.
3 Прослеживаемость
Мы рассмотрели способы обеспечения первых двух требований. Перейдём к прослеживаемости. Выше мы не описали ни одного механизма, обеспечивающего прослеживаемость, поэтому это требование пока не выполняется. Посмотрим, что тут можно сделать.
Причины принятия решений могут быть самыми разными, но очевидно, что они находятся далеко от кода. Они могут быть озвучены при общении с заказчиком, зафиксированы в переписке, в системах управления проектом или отслеживания ошибок и так далее. И наша задача — сделать так, чтобы цепочку можно было восстановить до этих источников. Это важно для того, чтобы понимать причинно‑следственные связи в проекте. Не только для понимания взаимосвязей, но и потому, что обстоятельства со временем могут измениться. С точки зрения проектирования организационного процесса нужно сделать так, чтобы агент имел возможность ее выстроить.
Например, мы можем создать общий журнал учета всех решений (decisions.md). Это необязательно один файл, можно отдельно хранить список фактов, различные другие источники данных и др. Но здесь нужно обеспечить сохранение и контроль. Это может быть описано в виде:
- [decisions.md](decisions.md) — история принятия решений в прямом порядке времени;
отвечает на вопрос «Почему так, а не иначе?».

decisions.md хранит историю решений в прямом порядке принятия: новый раздел дописывается
в конец, прежние записи не редактируются и не удаляются. Новая запись содержит сквозной
номер, проверяемое решение, основание и дату. Пересмотр оформляется новой записью со
ссылкой на прежний номер. Прежние записи не удалять, не переписывать и не дополнять задним
числом отметками об отмене.
Далее для прослеживаемости необходима связка контекста изменения в проекте с решением. Для этого удобным инструментом может быть система контроля версий, позволяющая увидеть, что такие‑то изменения были внесены для решения такой‑то задачи на основании таких‑то решений. Здесь окажется важной связка тех или иных коммитов с определенной выполняемой задачей, так как без этого система контроля версий покажет историю изменений, но не причины этих изменений.
4 Разрешение конфликтов
Переходим к 4-му условию. На данный момент у нас нет ничего, что бы его обеспечивало, и для него необходимы дополнительные организационные действия.
Прежде всего, если мы возьмем вышеописанный пример корневого ai.md, то в нём возможны противоречия — например, если низкоуровневые утверждения противоречат тому, что продекларировано на более высоком уровне. Чтобы снять большинство из них, можно добавить, что более высокоуровневые утверждения более приоритетны, нежели низкоуровневые. Также можно добавить процедуру проверки решений, вносимых в ai.md, которые должны быть согласованы с более высокоуровневыми. Так существенная часть конфликтов может быть решена. Но это достаточно простой вариант, и не факт, что в таком виде он правильный. По‑хорошему, лучше описать процедуру разрешения. Например, она может выглядеть таким образом:
При обнаружении противоречия или существенной неоднозначности:
1. Определить конфликтующие требования и области их применения.
2. Проверить действующие правила, ограничения и код затронутых компонентов.
3. При необходимости восстановить основания решений через `decisions.md`,
   задачи и историю изменений.
4. Попытаться найти решение, совместимое со всеми применимыми ограничениями.
5. Если такое решение невозможно или требуется изменить действующее требование,
   запросить решение у пользователя.
6. Не заменять действующие правила собственными предположениями.
Применим этот алгоритм к примеру с транзакциями и асинхронной обработкой из подраздела «Разрешение конфликтов».
В проекте есть правило: запись бизнес‑операций производится внутри транзакции. Поступает новое требование: перенести длительную операцию в асинхронную обработку. Выглядит как противоречие: как сохранить транзакционность, если операция теперь должна выполняться асинхронно? Но если агент смотрит в историю решений, то он может понять, что транзакция необходима для атомарного изменения нескольких связанных записей. А асинхронность требуется, чтобы не держать открытым HTTP‑запрос во время длительной обработки. И не факт, что они обязательно противоречат друг другу. Можно найти вариант, когда HTTP‑запрос инициирует асинхронную обработку, а согласованное изменение данных выполняется в транзакции внутри обработчика. Как следствие, конфликт разрешён без дополнительного обращения к человеку. Это решение может быть записано как новое. При этом агент не отменил старое правило и не придумал новое бизнес‑требование, а нашёл способ удовлетворить оба.
А что если конфликт неразрешим? Допустим, поставлена задача отмены уже отправленного заказа, но действующее предметное правило запрещает это. Агент исследует decisions.md и понимает, что запрет напрямую прописан в договоре с партнёром. Здесь нельзя применить новое требование и нельзя самостоятельно отменить существующее ограничение. Процедура должна привести к внешнему запросу с конкретной информацией: «Требуется отменить отправленный заказ, но действующее правило DEC-014 запрещает это на основании договора с партнёром. Изменились ли условия, позволяющие пересмотреть запрет?» Такой запрос существенно отличается от общего «здесь что‑то непонятно».
Таким образом, мы рассмотрели возможный порядок действий при возникновении противоречий. В этом примере он позволяет агенту самостоятельно разрешать часть конфликтов на основании существующих знаний. При этом наличие процедуры не гарантирует обнаружения всех противоречий, но задаёт контролируемый способ работы с ними.
5 Структурная целостность
Если агент получает необходимый контекст, соблюдает действующие соглашения и корректно разрешает противоречия, то это не гарантирует, что последовательность изменений сохранит простоту и целостность архитектуры. Чтобы обеспечить последнее условие, необходимо, чтобы время от времени проводились анализ состояния проекта и поиск возможностей для обобщения. Например, можно организовать отдельную процедуру, в рамках которой ИИ‑помощник анализирует повторяющиеся обработки ошибок, специальные случаи и зависимости между компонентами, после чего предлагает варианты их объединения или структурной переработки.
Такая процедура может запускаться периодически или при обнаружении признаков накопления сложности. Важно, что она является самостоятельным этапом работы, а не предполагаемым побочным результатом выполнения очередной локальной задачи.
Заключение
ИИ‑помощники позволяют разрабатывать программное обеспечение с ранее недоступной скоростью, но такое ускорение обостряет множество ранее известных проблем. Мы рассмотрели некоторые из них и показали, как можно использовать известные инженерные методы для проектирования процесса производства, способного сохранять управляемость при ускорении разработки.
Разумеется, мы затронули лишь часть этой большой темы. За рамками статьи остались многие вопросы, такие как проверка эффективности самого производственного процесса и изменение роли инженера, который всё больше работает на более высоком уровне абстракции, организует разработку и отвечает за нее.
Исторически преодолеть звуковой барьер удалось не только благодаря более мощным двигателям или мастерству пилотов. Потребовалось изменить подходы к проектированию самолётов. Аналогичная задача сегодня стоит перед нами: не замедлять разработку до привычной скорости, а научиться организовывать процессы так, чтобы выдерживать новые скорости.
Комментарии (11)

Dhwtj
19.11.2026 16:05const response = await fetch('https://api.example.com/data');
const data = await response.json();
Язык говно. Поощряет спрятать все что может пойти не так
Вот так лучше, кратко (Rust)
use reqwest::Client;

#[derive(serde::Deserialize, Debug)]
struct Data {
    id: u64,
    name: String,
}

async fn fetch_data(client: &Client) -> Result<Data, reqwest::Error> {
    let response = client
        .get("https://api.example.com/data")
        .send()
        .await?
        .error_for_status()?; // 4xx/5xx -> Err

    response.json::<Data>().await
}

#[tokio::main]
async fn main() -> Result<(), reqwest::Error> {
    let client = Client::new();
    let data = fetch_data(&client).await?;
    println!("{data:?}");
    Ok(())
}
bsivko Автор
19.11.2026 16:05С вами тут не спорю, но в данном случае язык не имеет значения. Я специально выбрал один из самых коротких примеров, чтобы не перегружать статью деталями реализации.
Собственно, ваш пример как раз иллюстрирует обсуждаемую проблему: вы добавили обработку ошибок, хотя в исходном требовании она не была определена.
Вы как опытный разработчик решили пойти своим путём. Но ваш код также не определяет политику повторных попыток, например при таймауте. Он не различает, какие ошибки (4xx, 5xx, таймаут, ...) требуют повторения запроса, а какие нет. Он передаёт ошибки вызывающему коду, но не определяет, как нужно реагировать.
Мой этот комментарий не о том, что ваш код плохой и это ни разу не ревью вашего кода. Он о том, что статья о другом, и говорит о том, что даже при самой детальной проработке могут оставатся серые зоны неопределенности, и важно их понимать и контролировать.
Dhwtj
19.11.2026 16:05Так вот сигнатура функции должна показать все возможные варианты ответа.
Так умная библиотека покажет всё, что она уже знает о предметной области.
Но если вы не используете библиотеку которая уже знает всё о предметной области или знает, но явно не показывает, то да, вам придётся писать код - исследование. Баг - патч. Баг - патч. Когда знания накопятся (и лучше не падениями прода) вы создадите абстракцию, которая знает поведение достаточно хорошо. Абстракция поможет убрать патчи, поможет и понимать что происходит
bsivko Автор
19.11.2026 16:05Всё, что вы описываете, хорошо и правильно, и с этим я не спорю.
Но! Основной тезис статьи в другом: все что мы подняли и упомянули в этой ветке обсуждения, должны быть частью самого проекта, а не оставаться в голове конкретного разработчика и зависеть от его опыта и профессионализма.
То есть, код в две строчки HTTP-запроса можно сказать что намеренно написан максимально просто и без какой либо обработки ошибок. Он полагается на поведение по умолчанию, не определяя, насколько оно безопасно и надёжно для конкретного проекта. Это сделано как раз для иллюстрации что есть серая зона и даже неопытному разработчику при чтении это будет понятно.
Далее, смысл в том, что если в проекте принята определённая стратегия обработки ошибок, то это должно быть явно зафиксировано и доступно как разработчикам, так и ИИ-агентам. Чтобы ИИ-агент работал эффективно (надежно и безопасно), он должен получить эти инструкции явно.
И мы не можем полагаться на то, что провайдер заранее зашьет в модель наши профессиональные правила для нашего проекта, нам нужно документировать это явно и донести до контекста обработки.
Dhwtj
19.11.2026 16:05Он полагается на поведение по умолчанию,
Вот!
А если бы функция возвращала бы ошибку типа enum где явно были бы перечислены все возможные коды ошибок, то вы вынуждены были бы обработать каждый тип ошибок или группу типов ошибок потому что компилятор бы иначе не позволил.
Так библиотека, которая знает все возможные варианты поведения, и компилятор просто не дадут вам учесть один набор случаев (например, не нужен повторный запрос) и забыть другой набор (нужен повтор).
Я, видимо, не очень хороший код дал. Из него не видно.
Если предметная область известная и стабильная, то библиотеки умные. Умная библиотека плюс гарантии компилятора = вам не надо думать как не забыть хитрые частные случаи. Ваш квадратик уже раскрашен за вас
Если предметная область не имеет готовых развитых библиотек или хотя бы документации, то вам самим придётся её исследовать. И вот тогда по мере накопления знаний пойдут ваши патчи на патчи. А потом родится красивая абстракция, которая поглотит 90% частных случаев (что вы там нарисовали, не помню)
bsivko Автор
19.11.2026 16:05Проработка библиотеки дело хорошее и нужное.
Но обработка ошибок это прежде всего понимание поведения в случае ошибочной ситуации и ее контроль.
Другими словами, в одном проекте каком-то конкретном месте в случае ошибки нужно повторить запрос, в другом нужно остановить все, в третьем написать письмо администратору, в четвертом отлогировать и больше не пытаться, в пятом (почти) все вместе взятое.
Одна библиотека по своему поведению по умолчанию попадет в ваше ожидаемое, другая нет. И это (факт непопадания для всех случаев) не зависит от языка или библиотеки. Это определяется требованиями конкретного проекта или задачи.
И статья она не о том кто правильный. А во том, что эти требования должны стать явной и формализованной частью контекста, чтобы ИИ-агент это мог использовать и реализовать правильно.
Dhwtj
19.11.2026 16:05эти требования должны стать явной и формализованной частью контекста
Да, но нет)))
Мы снова возвращаемся к тому что у системы может быть сложное поведение, но на большую часть кейсов обычно можно положить болт.
Да, в постановке задачи нужно показать насколько система отличается от обычной, типовой. Например, высокая нагрузка, нестабильная сеть...
одном проекте каком-то конкретном месте в случае ошибки нужно повторить запрос, в другом нужно остановить все, в третьем написать письмо администратору, в четвертом отлогировать и больше не пытаться, в пятом (почти) все вместе взятое
Это просто обработчики известных событий. Их надо правильно реализовать. Если вас только это беспокоит...
bsivko Автор
19.11.2026 16:05Тут могут быть разные мнения. Но в случае болта я бы все таки явно указал в проекте что тут можно положить болт и вот эта категория ошибок может обрабатываться как угодно.Тогда ИИ-агент может выбрать по обстоятельствам.
Типичным случаем это выражается в стратегии обработки неизвестных ошибок. Т.е. например мы перехватили известные нам исключения, а для оставшихся готовим отдельный обработчик. Но опять же, лучше явно написать какое поведение мы хотим видеть в этом случае, ложить болт можно по-разному. В одном случае надо громко падать, в другом тихо логировать.
Их надо правильно реализовать
Все верно. Но что такое "правильно" на этот вопрос в каждом проекте свой ответ, и статья о том, что это лучше явно записывать в контекст ИИ-агенту чтобы он знал что делать в тех или иных обстоятельствах. Откуда меня например беспокоит чтобы он не начал придумывать решение на ходу.

powerman
19.11.2026 16:05Жуткое многабукофф чтобы сказать "пишите
AGENTS.md". Всю статьюможнонужно было ужать до пары абзацев. Но главная проблема в том, что никакого сверхзвука описанные меры не дают и не дадут. Всё, что они дают - много говнокода. Эти меры обеспечивают исключительно то, что ИИпишетговнокодит более-менее в нужную сторону, и всё. А чтобы получать при этом нормальные результаты нужна всего одна мелочь: ревью. И не ИИ, а человеком, который будет отвечать за этот результат (что не мешает перед этим прогнать несколько раундов ИИ-ревью, но это на суть не влияет). И вся сверхскорость моментально сдувается до скорости ревью, причём она запросто может быть даже меньше обычной - потому что кода больше обычного, лютой дичи в нём в разы больше обычного, а мотивация ниже обычного (потому что делая ревью коллеге ты знаешь, что он на этом обучается, и снова повторять те же ошибки не станет, а вот с ИИ это так не работает).Что до разрешения противоречивых требований по простой инструкции из пяти пунктов… Вот вам противоречивые требования многих проектов: "проект должен быть быстрым, безопасным и надёжным; а ещё удобным для пользователей и работать на дешёвом VPS; ну и когда набегает толпа в чёрную пятницу то держать нагрузку". Успехов написать инструкцию по разрешению конфликтов между этими требованиями.
bsivko Автор
19.11.2026 16:05потому что делая ревью коллеге ты знаешь, что он на этом обучается, и снова повторять те же ошибки не станет, а вот с ИИ это так не работает
В статье как раз идет речь о том чтобы сделать в том числе этот момент так, чтобы оно так работало (чтобы ИИ не повторял ошибки которые были разобраны).
проект должен быть быстрым, безопасным и надёжным...
Это не требования, а хотелки. Требования должны декомпозирвоаться в конкретные проверяемые утверждения и процедуры. А кто будет разрешать их - человек или ИИ-агент вопрос другой. Если они несовместимы, то их не разрулит ни тот и ни другой.
Статья же говорит о том, что подобные вещи нужно делать частью проекта и частью производственного процесса, в том числе чтобы они были в контексте и применялись не важно уже кем - ИИ-агентом или человеком.
konst90
del