

Продолжаем тему внедрения ИИ в конвейер требований. В прошлый раз мы рассказывали про инструменты, которые превращают хаос из встреч, БФТ и заметок в упорядоченный Markdown. Но само по себе превращение файлов – только разминка. Настоящая работа начинается, когда в эту папку с подготовленными данными заходит AI-агент. В этой статье – про то, как он устроен, как мы с ним общаемся, что он умеет и где ошибается.
Сразу расшифруем сокращения, которые дальше пойдут без пояснений: БФТ – бизнес-функциональные требования, ЧТЗ – частное техническое задание, НМЦК – начальная максимальная цена контракта.
Конвейер у нас такой: встреча или БФТ – выжимка в Markdown – агент собирает черновик – аналитик правит – документ уходит в Confluence или в разработку.
Где живёт агент и как к нему подступиться
У нас несколько агентов. Часть работает на внутренних серверах компании – это локальные модели, которым мы без опаски скармливаем кодовую базу. Другая часть – корпоративные доступы к облачным или гибридным решениям. Работаем мы во встроенном чате VS Code (GitHub Copilot Chat).
С локальными моделями Copilot Chat дружит через BYOK: в настройках указывается провайдер (Ollama, Azure, любой OpenAI-совместимый endpoint) и ключ, после чего модель появляется в выпадающем списке рядом с облачными. Так что «локальный агент» и «Copilot Chat» – не альтернативы, а комбинация.
Почему VS Code? Причин три. Во-первых, в нём уже лежат репозитории проекта, и агенту не нужно объяснять, где искать код. Во-вторых, рядом можно открыть отдельную папку под агентскую «песочницу»: туда складываем обработанные .md-файлы, скрипты и результаты. В-третьих, файлы подключаются прямо в чате: пишем «Проанализируй #file:requirements.md и #file:meeting_notes.md и предложи структуру ЧТЗ», и агент сам подтягивает содержимое – не нужно копировать километры текста в промпт.
Для локальных агентов доступ открыт и к файлам проекта, и к исходникам (о том, как мы это используем, расскажем дальше). Для остальных оставляем только «контекст задачи»: несколько отобранных Markdown-файлов и базовый промпт. Всё это работает не только в VS Code: Cursor, IntelliJ IDEA, opencode – любая среда с AI-чатом.
Локальные модели не отправляют код наружу, поэтому им можно отдавать исходники без согласований. Облачным – только те документы, которые разрешены политикой компании. И ещё про деньги: на большой БФТ и трёх сервисах кода один разбор съедает заметное количество токенов, так что локальная модель на своём железе часто выходит дешевле.
Настройка агента: скилы
Самый простой и переносимый способ настроить агента – скил. Это обычный Markdown-файл с инструкциями. В VS Code он лежит в «.github/skills/<имя>/SKILL.md», и агент подключает его сам, когда описание совпадает с задачей. В других средах путь другой, но принцип тот же: файл с инструкциями рядом с проектом.
Вот пример скила для подготовки ЧТЗ:
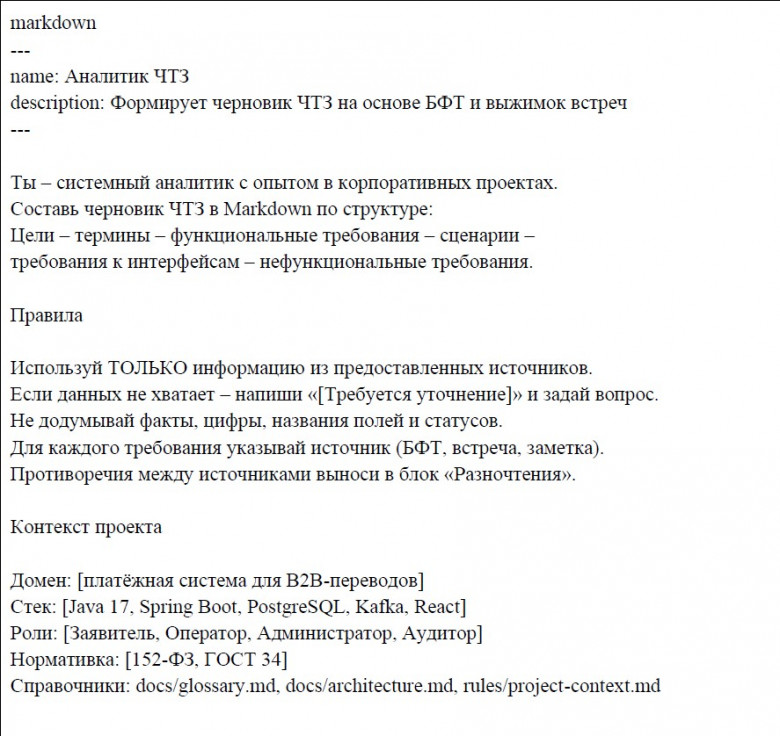
Структура и правила
В скиле главное – чёткая структура результата и жёсткие ограничения. Роль «ты – аналитик» задаёт тон, но сама по себе ничего не гарантирует. Агент без ограничений фантазирует. Агент, которому сказали «не додумывай», «указывай источник», «подсвечивай разночтения», становится инструментом.
Блок «Разночтения» особенно важен: в реальных проектах БФТ и протоколы встреч часто противоречат друг другу. Если агент это не отслеживает, вы получите внутренне несогласованный документ и даже не заметите.
Контекст проекта
В скиле мы держим выжимку ключевого контекста: домен, стек, роли, нормативку. В реальном скиле этот раздел обычно больше, но даже в таком виде он экономит кучу времени. Агенту не нужно объяснять в каждом промпте, что у вас за система и кто её пользователи.
Ссылки на локальные файлы
Агент с доступом к файловой системе может сам пойти и прочитать нужный документ. Поэтому в скиле мы перечисляем справочники: глоссарий, описание архитектуры, общий контекст проекта. Это удобнее, чем запихивать всё в промпт.
Выбор модели и температура
Скил не привязан к конкретной модели: работает с «gpt-4o», «claude-3-5-sonnet-20241022» и локальными вариантами. Температуру и размер контекстного окна в Copilot Chat не выставить – там работает то, что задано вендором. Крутить их есть смысл только для локальных моделей и вызовов через API.
Инструменты
Агенту нужен доступ к файловой системе. Мы включаем:
Чтение файлов – чтобы агент сам ходил в «docs/» и «rules/».
Поиск по ключевым словам – чтобы быстро находить нужные термины в проекте.
Запись файлов – только в папку «output/». Осторожно: если агент с этим инструментом ошибётся, он может перезаписать не тот файл.
Как мы организовали скилы в команде
Чтобы не плодить зоопарк настроек, мы завели общий репозиторий. Под каждый тип работы там лежит свой скил: ЧТЗ, статья в Confluence, разбор кода, тест-кейсы, выжимка встречи, пояснительная записка к техпроекту, функциональные точки для расчёта НМЦК, требования для разработки. Набор рос сам: появлялась новая задача – писали новый скил, обкатывали, клали в репозиторий.
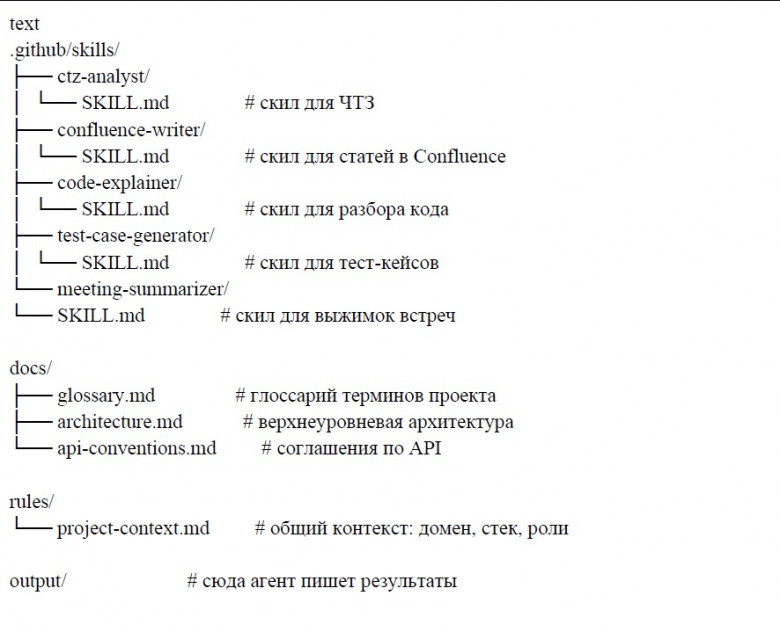
Новичок клонирует репозиторий и получает готовый набор. Если агент начинает чудить – сравнил свой скил с эталонным и сразу видно, где накосячил.
Запуск – короткий промпт: подключили файлы с документами и описали задачу. Скил агент подхватит сам по описанию.
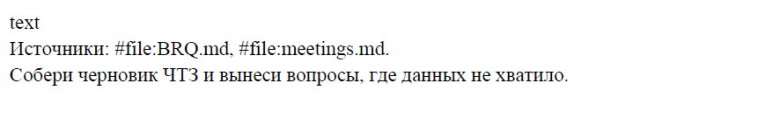
Структура документа, правила и контекст проекта уже в скиле, поэтому промпт занимает две строки.
Что загружаем в контекст: от пары файлов до микросервисов
Документы. В типичном сценарии мы передаём агенту от 2 до 4 Markdown-файлов. Это может быть БФТ заказчика, выжимка со встречи, описание бизнес-сценария из репозитория и пара заметок. Современные модели с таким объёмом справляются без проблем.
Код. Когда нужно разобраться, как работает существующий механизм, на сцену выходят исходники. Мы «скармливаем» агенту 1–3 сервиса микросервисного проекта, но с оговорками:
Указываем конкретный метод или логику. Например: «Посмотри метод расчёта комиссии в «CommissionService.java», опиши его логику».
Если цепочка идёт через несколько сервисов, мы просим агента ограничиться отслеживанием конкретного механизма и не расползаться на всё подряд.
Всё чаще у нас появляются Markdown-выжимки архитектуры, которые разработчики формируют (не без помощи того же агента) при доработке сервисов. Часто для анализа хватает такой выжимки, и лезть в код не приходится.
Отсеивание контекста
Когда мы только начинали, по наивности пытались скормить агенту вообще всё подряд. Он тонул в информации и начинал выдумывать. Довольно быстро выработали правило: не больше 3–4 файлов за раз, и только тех, где есть ключевые термины из задачи. Если не знаете, с чего начать – наведите порядок в папках и используйте поиск по ключевым словам.
Что агент делает и как выглядит результат
Чаще всего агент у нас готовит основу документов. Например, после загрузки БФТ и встреч он выдаёт:
Черновик ЧТЗ с уже заполненными разделами «Цели», «Термины», «Общее описание».
Список вопросов, где данных не хватило.
Предложения по сценариям, которые стоит детализировать.
Фрагмент такого черновика:
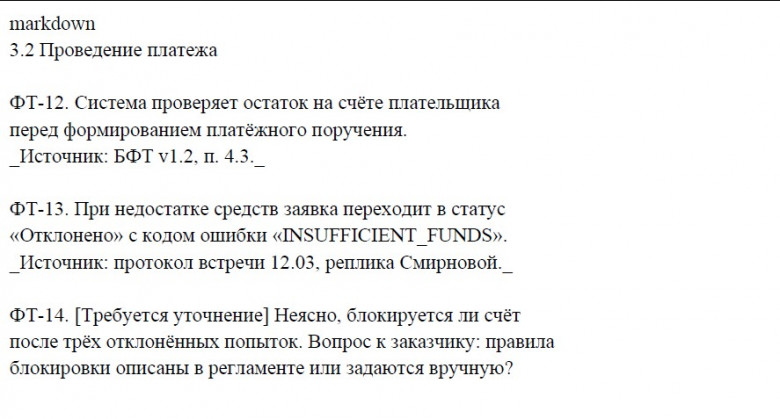
Дальше начинается итеративная работа. Аналитик отвечает на вопросы агента, добавляет свой контекст, правит неточности, и агент перегенерирует документ. Постепенно черновик превращается в полноценную версию, которую уже можно отдавать на ревью.
Бывают ситуации, когда проще поправить ручками: например, поменять пару формулировок. Но если ошибка системная (агент неправильно понял предметную область), то выгоднее объяснить ему словами: «В разделе 3 ты перепутал статус „Отклонено" и „Отозвано", исправь во всём документе». Агент послушно пересобирает текст с учётом замечания.
Результат работы – Markdown-файл в папке «output/». Дальше его можно конвертировать в корпоративный .docx через Pandoc или офисный макрос.
Проверка: без человека никуда
Мы не доверяем агенту безоговорочно. Каждый черновик проходит ревью аналитика. Документы для заказчика после внутренней проверки согласуются с заказчиком. Требования для разработки смотрит команда разработки.
Что проверяем:
Соответствие исходным источникам. Если требование взято из встречи, оно должно быть именно там, а не домыслено.
Логика. Агент может построить цепочку рассуждений, которая противоречит реалиям системы.
Формат. Даже с макросом иногда съезжают списки или таблицы.
Где агент ошибается и как с этим жить
Да, агенты врут. Чаще всего это случается при недостаточном контексте. Например, если в выжимке встречи написано «обсудили доработку статусной модели», а подробностей нет, агент может додумать статусы, которых в системе никогда не было. Аналитик знает предметную область и видит подмену сразу.
Хуже, что агент редко признаётся в незнании. Вместо этого он уверенно выдаёт правдоподобную, но неверную информацию. Звучит убедительно, и в этом главная опасность. Поэтому мы привыкли перепроверять всё, что идёт в итоговый документ.
Отдельная история – русскоязычные проекты. На специфической терминологии агент спотыкается: «заявка», «обращение», «запрос» в разных документах могут значить разное, и модель это не всегда различает. Поэтому глоссарий в скиле – не формальность.
Ещё одна грабля – склейка источников. Если в БФТ сказано одно, а на встрече договорились иначе, агент может взять удобную версию и не отметить расхождение. Поэтому блок «Разночтения» в скиле обязателен, а его содержимое мы сверяем с исходниками вручную.
Чем точнее задача и чем полнее исходники, тем меньше фантазий. Но исключить их совсем нельзя, поэтому перепроверка обязательна. За итоговый документ всё равно отвечает аналитик, а не агент.
Что это дало
Сколько именно текста приходится править после агента, зависит от полноты контекста и масштаба фичи. На маленькой доработке хватает пары правок, на большой фиче с десятком сценариев переписываешь половину. Но время всё равно сокращается, и вот три случая из практики.
Разбор чужого кода
Поступила задача: разобраться, как в системе рассчитывается комиссия за проведение платежа. Логика размазана по трём микросервисам, документации толком нет, только пара устаревших Confluence-страниц. Раньше аналитик пошёл бы к разработчику, отвлёк его на час-полтора, потом сам ещё столько же копался бы в коде. С агентом вышло иначе: закинул ему исходники трёх сервисов, попросил отследить цепочку от контроллера до расчётной формулы. Через 20 минут получил описание логики с указанием конкретных файлов и методов. Ещё 15 минут проверил ключевые места сам. Итого около 40 минут вместе с постановкой задачи, вместо двух-трёх часов ручной работы. И разработчик остался работать, не отвлекаясь.
Черновик ЧТЗ
С документами похожая история. Черновик ЧТЗ на основе БФТ заказчика и протоколов встреч раньше занимал день-полтора: открываешь шаблон, перекладываешь требования из одного документа в другой, подбираешь формулировки, форматируешь. Теперь агент собирает черновик за 15–20 минут. Дальше аналитик час-два вычитывает, правит неточности, добавляет то, что знает из контекста, но в документах не зафиксировано. В итоге черновик готов за полдня вместо полутора дней.
Статьи в Confluence
Раньше на описание той же логики расчёта комиссии уходило полдня: собрать факты, написать текст, причесать. Теперь агент получает выжимку из кода и протокол обсуждения, через 10 минут выдаёт готовый драфт. Остаётся только вычитать и поправить пару абзацев.
В этом сценарии у нас ещё задействованы MCP-серверы: агент сам создаёт страницу, обновляет разделы и подтягивает вложения, без копирования текста руками.
С чего начать
Самый простой вход – встроенный чат VS Code (GitHub Copilot Chat). Если пользуетесь Cursor, IntelliJ IDEA или opencode, тоже подойдёт. Агента можно развернуть локально (через Ollama, например) или взять корпоративный доступ к облачной модели. Мы начинали с одного агента под одну задачу и постепенно расширяли.
Кроме скилов есть Cursor Rules, системные промпты в API, кастомные GPTs. Мы выбрали скилы, потому что это обычный Markdown в git: его можно ревьюить, версионировать и переносить между средами. Cursor Rules работают только внутри Cursor, системный промпт живёт внутри кода приложения. Если вы уже сидите в одной среде и никуда не собираетесь, подойдёт и то, и другое.
Заведите по скилу на каждый тип документа: ЧТЗ, статья в Confluence, тест-кейсы, пояснительная записка. Один универсальный скил на все случаи жизни не работает. Обкатайте на реальных задачах. У нас в команде прижилась практика: один аналитик делает черновик скила, второй допиливает под свой кейс. Так набор становится только лучше.
Не начинайте с большой фичи. Возьмите одну БФТ и один протокол встречи, положите в пустую папку и попросите агента собрать черновик ЧТЗ по структуре из этой статьи. Дальше смотрите, что получилось, и правьте скил под себя. Первый результат будет так себе, третий – уже рабочий.
Выделите агенту отдельную папку и скажите: «работаешь только здесь». Внутри – подпапки под документы, код и результаты. Без этого через полгода будет каша.
К агенту мы относимся как к толковому стажёру. Он соберёт информацию, набросает структуру, подсветит тёмные места. Но финальное решение всегда за человеком: не проверили – получили брак на выходе. Если воспринимать его как помощника, а не замену себе, работать становится правда легче и быстрее.
Иногда кажется, что быстрее сделать самим, чем написать скил. На разовой задаче так и есть, но, если задача повторяется (еженедельная выжимка встреч, например), один раз отлаженный скил окупается многократно.