

В рамках данной статьи мы собрали кейсы наших клиентов, связанные с динамическими списками. Все кейсы сводились к тому, что после миграции с MS SQL некоторые привычные операции пользователей начинали выполняться дольше.
Мы подробно остановимся на причинах замедления, разберем, за счет чего на MS SQL это работало быстрее, и покажем, как мы улучшили планировщик нашей СУБД Tantor Postgres.
Почему важна скорость работы динамических списков?
Динамические списки в 1С — это привычные каждому пользователю списки документов и справочников, с которыми он работает каждый день. Например, сотрудник кадровой службы открывает журнал «Все кадровые документы», чтобы найти нужный документ или отобрать документы по конкретному сотруднику.
За каждым таким списком стоит запрос к СУБД. В простом случае он читает данные из одной таблицы, но может содержать множество соединений, сортировок и вычислений. Пользователь при этом видит обычный список, а вывод дополнительных полей, отбор или сортировка может заметно усложнить работу СУБД.
Тут есть важный нюанс: при динамическом считывании данные загружаются порциями. Сначала платформа получает первую порцию записей, а при прокрутке запрашивает следующие. Также динамический список обновляется при записи нового документа, например, при нажатии «Провести и закрыть». Поэтому недостаточно быстро открыть список — нужно быстро получать данные и при дальнейшей работе с ним.
Если каждый отбор, изменение сортировки или подгрузка очередной порции данных занимает несколько секунд, пользователь постоянно прерывается на ожидание. Из таких задержек и складывается ощущение, что «1С тормозит». Поэтому динамические списки должны работать не просто быстро, а практически моментально.
ЗУП и журнал документов «Все кадровые документы»
Первый два кейса клиентов были связаны с журналом документов «Все кадровые документы», который есть в типовых ЗУП, ERP, УХ...
Отбор по сотруднику
Данная форма журнала документов представляет собой динамический список, в котором часто используют отбор по сотруднику для того, чтобы быстро отобрать все его кадровые документы. Это можно делать двумя способами.
Через форму списка «Все кадровые документы»:
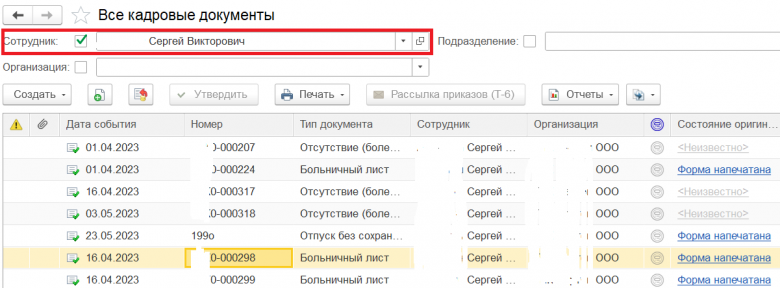
Или нажатием на команду «Кадровые документы» из карточки сотрудника:
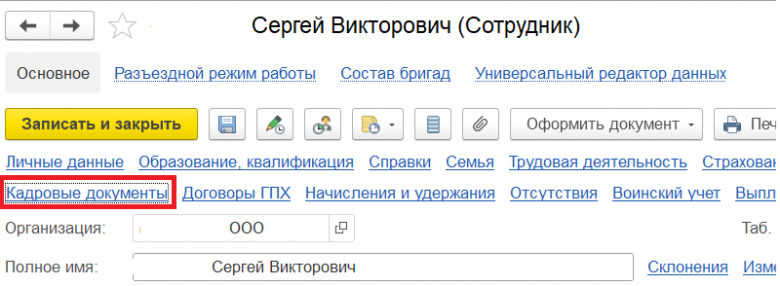
И проблема этого списка (и подобных ему) после перехода с MS SQL заключается в том, что данный отбор по сотруднику выполняется неоправданно долго. У клиента он выполнялся 8 секунд — план запроса. Разберемся, почему так происходит.
В 1С запрос этого списка выглядит так:
Текст запроса 1С
(я сократил поля выбора для компактного вида, они никак не влияют в данном случае на проблематику)
После применения на форме списка по сотруднику подставляются условия в секцию ГДЕ, и платформа 1С отправляет на исполнение следующий запрос:
Текст запроса 1С
Суть данного запроса в следующем:
Из РС СоставДокументовЗарплатаКадры отбираются все документы по выбранному сотруднику (
СоставДокументовЗарплатаКадры.Сотрудник = &Сотрудник)Отобранные документы накладывают ограничение на выборку из таблицы
ЖурналДокументов.КадровыеДокументычерез условиеЖурналДокументовКадровыеДокументы.Ссылка = СоставДокументовЗарплатаКадры.ДокументФизическогоЛицаВ результате мы выбираем из журнала документов только документы по выбранному сотруднику, которых, как правило, немного, и это должно выполниться быстро.
Но после миграции на PostgreSQL не выполняется быстро. Давайте посмотрим, какой SQL‑запрос отправляет платформа 1С на исполнение на СУБД:
Текст запроса SQL
SELECT
CAST(0 AS NUMERIC),
T1._DocumentTRef,
T1._DocumentRRef,
T1._Date_Time,
-- другие поля выбора
CASE WHEN T1._DocumentTRef = '\\000\\000\\262\\222'::bytea THEN T10._Fld45870 WHEN T1._DocumentTRef = '\\000\\000\\003\\031'::bytea THEN T11._Fld13945 WHEN T1._DocumentTRef = '\\000\\000\\003\\025'::bytea THEN T12._Fld13588 WHEN T1._DocumentTRef = '\\000\\000\\002\\330'::bytea THEN T13._Fld10006 WHEN T1._DocumentTRef = '\\000\\000\\003\\030'::bytea THEN T14._Fld13905 WHEN T1._DocumentTRef = '\\000\\000\\002\\325'::bytea THEN T15._Fld9389 WHEN T1._DocumentTRef = '\\000\\000\\002Z'::bytea THEN T16._Fld1596 WHEN T1._DocumentTRef = '\\000\\000\\002\\310'::bytea THEN T17._Fld8522 WHEN T1._DocumentTRef = '\\000\\000\\002\\312'::bytea THEN T18._Fld9013 WHEN T1._DocumentTRef = '\\000\\000\\002\\307'::bytea THEN T19._Fld8211 WHEN T1._DocumentTRef = '\\000\\000\\003F'::bytea THEN T8._Fld16633 WHEN T1._DocumentTRef = '\\000\\000\\002\\327'::bytea THEN T20._Fld9833 WHEN T1._DocumentTRef = '\\000\\000\\003\\020'::bytea THEN T21._Fld13188 WHEN T1._DocumentTRef = '\\000\\000\\003\\021'::bytea THEN T22._Fld13342 WHEN T1._DocumentTRef = '\\000\\000\\002\\255'::bytea THEN T23._Fld5938 WHEN T1._DocumentTRef = '\\000\\000\\003G'::bytea THEN T9._Fld17180 WHEN T1._DocumentTRef = '\\000\\000\\002\\311'::bytea THEN T24._Fld8839 WHEN T1._DocumentTRef = '\\000\\000\\002\\331'::bytea THEN T25._Fld10205 ELSE CAST(NULL AS TIMESTAMP) END
FROM _DocumentJournal18936 T1
LEFT OUTER JOIN _InfoRg22912 T2
ON (('\\010'::bytea = T2._Fld22913_TYPE AND T1._DocumentTRef = T2._Fld22913_RTRef AND T1._DocumentRRef = T2._Fld22913_RRRef)) AND (T2._Fld1386 = CAST(0 AS NUMERIC))
LEFT OUTER JOIN _Reference266X1 T3
ON (T1._Fld18937RRef = T3._IDRRef) AND (T3._Fld1386 = CAST(0 AS NUMERIC))
LEFT OUTER JOIN _Document683 T4
ON (T1._DocumentTRef = '\\000\\000\\002\\253'::bytea AND T1._DocumentRRef = T4._IDRRef) AND (T4._Fld1386 = CAST(0 AS NUMERIC))
LEFT OUTER JOIN _Document684 T5
ON (T1._DocumentTRef = '\\000\\000\\002\\254'::bytea AND T1._DocumentRRef = T5._IDRRef) AND (T5._Fld1386 = CAST(0 AS NUMERIC))
-- другие соединения
LEFT OUTER JOIN _Document729 T25
ON (T1._DocumentTRef = '\\000\\000\\002\\331'::bytea AND T1._DocumentRRef = T25._IDRRef) AND (T25._Fld1386 = CAST(0 AS NUMERIC))
WHERE ((T1._Fld1386 = CAST(0 AS NUMERIC))) AND (EXISTS(SELECT
TRUE AS Q_001_F_000_
FROM _InfoRg26249 T26
WHERE ((T26._Fld1386 = CAST(0 AS NUMERIC))) AND ((T26._Fld26252RRef = '\\205C\\260{%\\354@\\275\\021\\356+Z(T\\313\\325'::bytea) AND ('\\010'::bytea = T26._Fld26250_TYPE AND T1._DocumentTRef = T26._Fld26250_RTRef AND T1._DocumentRRef = T26._Fld26250_RRRef))) AND (T3._Fld35114RRef = '\\246\\210\\000PV\\215v\\354\\021\\343\\266/\\353\\310#+'::bytea) AND ((T1._Fld18942 < '2026-01-05 00:00:00'::timestamp) OR (T1._Fld18942 = '2026-01-05 00:00:00'::timestamp) AND ((T1._DocumentTRef < '\\000\\000\\002\\325'::bytea OR T1._DocumentTRef = '\\000\\000\\002\\325'::bytea AND T1._DocumentRRef <= '\\233\\244\\032l\\300\\214F \\021\\360\\324\\351C\\010\\306B'::bytea))))
ORDER BY (T1._Fld18942) DESC, (T1._DocumentTRef) DESC, (T1._DocumentRRef) DESC LIMIT 1000
Мы видим, что в тексте запроса появляются соединения с различными таблицами. Это результат обращения через точку к полю ЖурналДокументовКадровыеДокументы.Ссылка.ПериодРегистрации. Этих соединений очень много — в результате в запросе участвуют 26 таблиц. Количество таблиц можно легко определить из псевдонимов таблиц — нумерация идет сверху вниз и в самом низу мы видим FROM _InfoRg26249 T26.
Условие отбора по выбранному сотруднику трансформируется в следующую конструкцию SQL:
WHERE ... AND EXISTS(SELECT
TRUE AS Q_001_F_000_
FROM _InfoRg26249 T26
WHERE ((T26._Fld1386 = CAST(0 AS NUMERIC))) AND ((T26._Fld26252RRef = '\\205C\\260{%\\354@\\275\\021\\356+Z(T\\313\\325'::bytea) AND ('\\010'::bytea = T26._Fld26250_TYPE AND T1._DocumentTRef = T26._Fld26250_RTRef AND T1._DocumentRRef = T26._Fld26250_RRRef)))
Здесь все логично: на языке 1С это написано также в секции ГДЕ через подзапрос.
Взглянем на фактический порядок соединений таблиц в плане запроса:
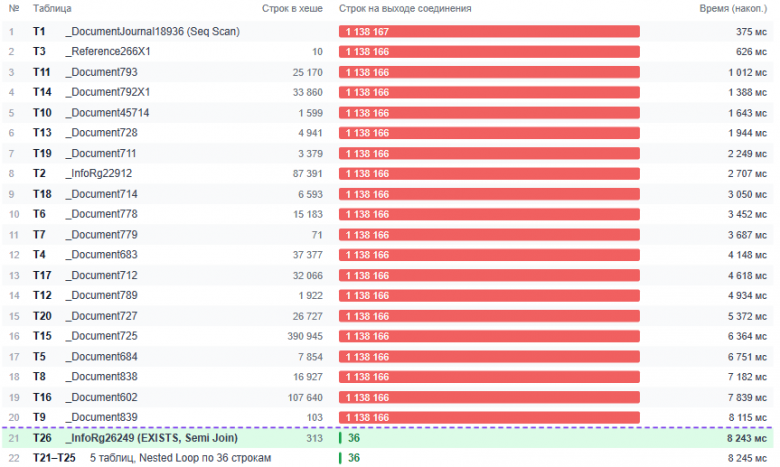
Журнал читается целиком, и все 1,14 млн строк проходят через 19 соединений. Только после этого подзапрос по _InfoRg26249 оставляет из них 36. К этому моменту уже потрачено 7,9 из 8,2 секунды. Если бы отбор по сотруднику выполнялся первым, остальные таблицы соединялись бы с 36 строками, а не с миллионом. Почему же планировщик не поставил его в начало?
Причиной долгого выполнения запроса является количество таблиц в запросе и параметры join_collapse_limit/from_collapse_limit, которые равны 20. Механизм работы этих параметров довольно сложен, поэтому дальше я объясню его в упрощенном виде: при планировании запроса планировщик перебирает варианты соединения таблиц для того, чтобы найти наиболее оптимальный порядок их соединения. Но он перебирает не все таблицы, а только первые 20 (значение параметров collapse_limit). А так как таблица _InfoRg26249 (соединение с отбором по сотруднику), которая сокращает выборку с миллиона записей до 36, идет в списке таблиц 26-й по счету, то планировщик не перебирает ее при планировании запроса, и соответственно не знает, что если сразу с ней соединиться, то это значительно сократит количество строк — вот причина неоптимального плана выполнения.
Как решить проблему? Думаю, что вы уже догадались. Можно увеличить параметры collapse_limit, например, до 30. Тогда планировщик переберет варианты соединения всех таблиц и выберет оптимальный план. Но у этого решения есть свои недостатки.
Первый недостаток — количество таблиц в запросе. Сейчас их 26, но может быть и 50 и 70, и что тогда еще увеличивать значения параметров collapse_limit?
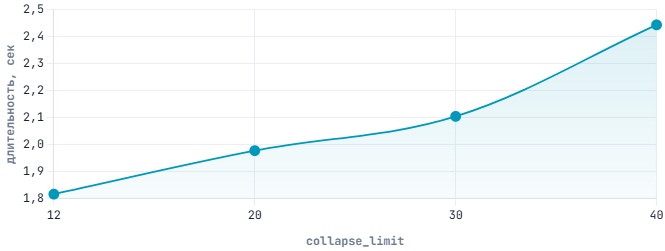
Второй недостаток связан с тем, что увеличение значений этих параметров может негативно сказаться на производительности работы 1С, так как это может привести к увеличению времени планирования запросов. Для проверки этой теории мы провели серию нагрузочных тестов на базе 1С:ERP и получили следующие результаты.
Вот как данные параметры влияли на среднее время ключевых операций в 1С:
А это график потребления оперативной памяти на сервере СУБД:
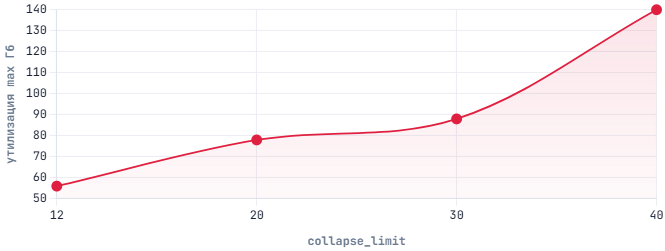
По графикам видны как деградация производительности пользовательских операций в 1С, так и повышение утилизации ОЗУ на сервере СУБД.
Также клиент потом прислал пример такого же запроса с РЛС: в нем было 77 таблиц, а выполнялся он 198 секунд (план запроса). Вместе с результатами нагрузочных тестов это подтверждает, что завязываться на параметры collapse_limit и увеличивать их для решения данной проблемы не стоит.
Решение мы здесь выбрали следующее.
Конструкция EXISTS, которая использовалась в подзапросе с отбором по сотруднику, трансформируется планировщиком в SEMI JOIN. Это такой вид соединения таблиц в PostgreSQL, который не приводит к дублированию строк левой таблицы и не выводит столбцов правой таблицы, а отбирает строки из левой таблицы, для которых есть хотя бы одно совпадение. Исходя из определения, можно сделать вывод, что SEMI JOIN, как правило, используется для того, чтобы сократить количество записей, выбранных из левой таблицы. А раз эта конструкция сокращает выборку, то логично при планировании запроса всегда учитывать узлы SEMI JOIN при выборе оптимального плана исполнения запроса, что мы и реализовали в Tantor Postgres.
Мы отдали клиенту новую сборку нашей СУБД и получили следующие результаты:
Варианты запроса |
До оптимизации |
После оптимизации |
Без РЛС (26 таблиц) |
8 сек |
0.001 сек |
С РЛС (77 таблиц) |
198 сек |
0.017 сек |
Клиента полностью устроил результат и мы получили от него план запроса с РЛС после оптимизации — ссылка. Но это было только начало..
Сортировка по полю
Следующая заявка от клиента была связана с этим же журналом документов, только вместо отбора по сотруднику была сортировка по полю «Дата события»:
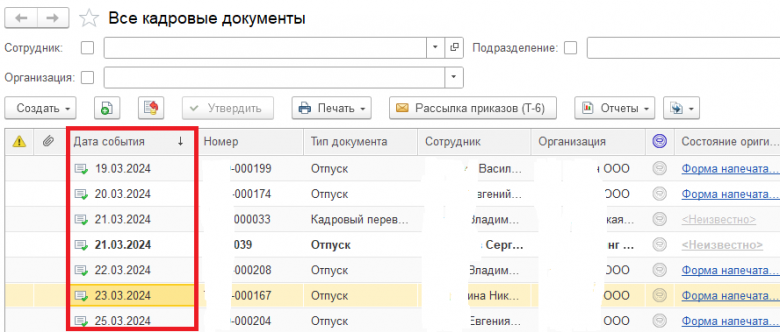
Запрос обновления динамического списка с сортировкой по дате события выполнялся более 7 секунд — план запроса — при этом на MS SQL выполнялся почти моментально со слов клиента.
И проблема тут в целом схожа с предыдущей: выбирается миллион записей из левой таблицы журнала документов, потом левые соединения с большим количеством таблиц, которые и занимают основное время выполнения запроса. И в конце сортировка по полю ДатаСобытия, которая вместе с оператором LIMIT 1000 сокращает выборку с миллиона до одной тысячи:
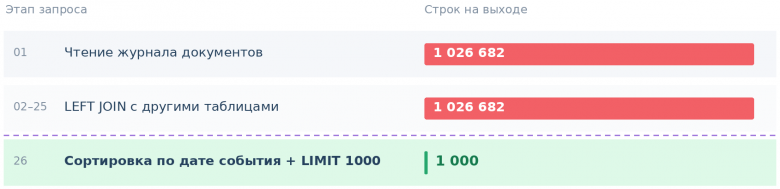
Можно ли тут также сразу сократить выборку из левой таблицы до тысячи строк, чтобы оперировать меньшим количеством записей при соединениях с таблицами?
Можно, если LEFT JOIN только добавляют к строкам реквизиты из других таблиц, не меняя количество строк и порядок их отбора. Для этого каждой строке левой таблицы должно соответствовать не более одной строки в каждой присоединяемой таблице — например, при соединении по уникальной ссылке. Если соответствия нет, LEFT JOIN все равно сохранит исходную строку, подставив NULL в поля правой таблицы. При этом отборы и сортировка должны зависеть только от полей левой таблицы, а поля присоединяемых таблиц использоваться лишь для вывода. Тогда первые 1000 строк можно определить до соединений: дополнительные реквизиты не повлияют на то, какие строки попадут в результат. Вместо сотен тысяч записей через цепочку LEFT JOIN пройдет только тысяча.
Чтобы до соединений оставить только первые 1000 строк левой таблицы, СУБД должна сначала выбрать строки, которые идут первыми при сортировке по полям ORDER BY: (T1._Fld33610), (T1._DocumentTRef), (T1._DocumentRRef), где _Fld33610 — это ДатаСобытия.
Это можно сделать двумя способами. Если есть подходящий индекс, строки можно читать уже в нужном порядке. Если индекса нет, СУБД может просканировать левую таблицу, отсортировать строки и оставить первые 1000 до выполнения соединений. Сначала рассмотрим вариант с индексом. Добавим индекс:
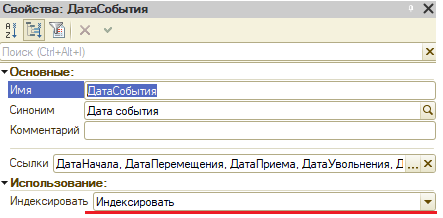
Обновляем конфигурацию ERP и смотрим состав нового индекса:
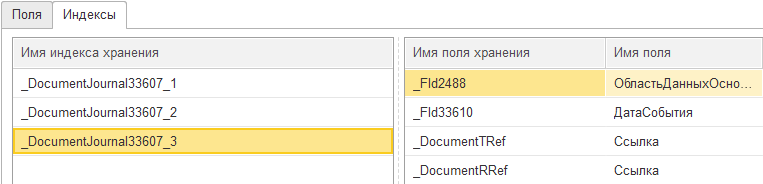
Все поля, по которым идет сортировка в нашем примере, входят в состав индекса в нужном порядке. Выполняем запрос еще раз и смотрим как изменился план запроса — у нас при выборке из левой таблицы сразу выбирается только тысяча записей, благодаря использованию нового индекса:
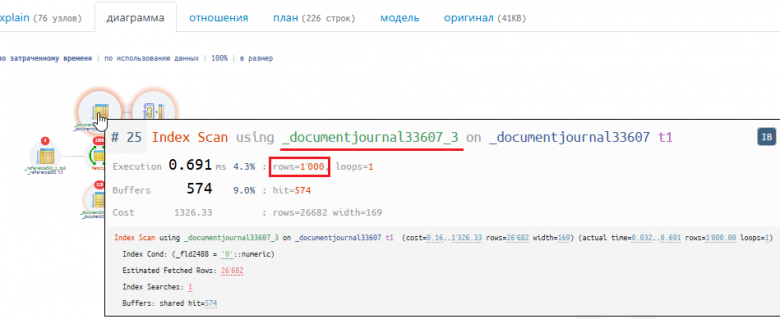
Это значительно сокращает объем работы, проходящей через все последующие узлы плана запроса, и запрос выполняется всего за 15 мс.
Отлично, мы нашли решение. Но... почему MS SQL работал быстро без индекса и пользователи не жаловались на производительность 1С? Давайте разбираться...
Эмулируем синтетический пример для MS SQL и смотрим получившийся план запроса:
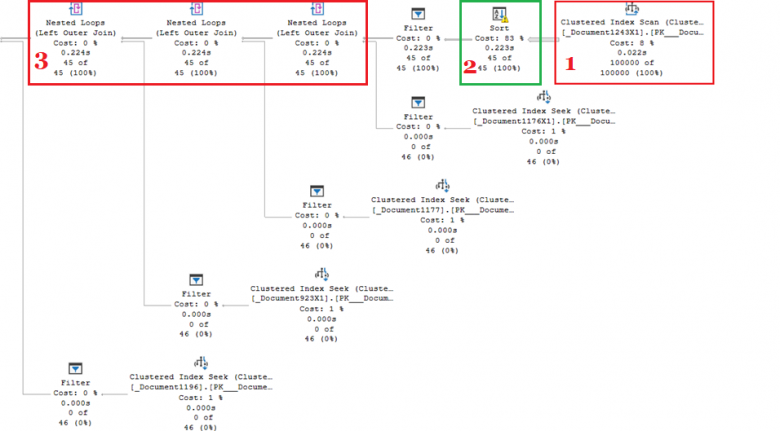
Что происходит:
Из левой таблицы выбираются все записи, которые в ней есть — 100 тысяч записей
Узел
Sortсортирует записи по полям из секцииORDER BY. И оставляет 45 записей (SELECT TOP 45)Соединение со всеми остальными таблицами.
В чём здесь особенность? Запросу нужны только первые 45 строк, заданные в TOP. Оптимизатор MS SQL учитывает это при выборе плана и может постараться быстрее получить именно эти строки. В нашем примере он сначала читает строки левой таблицы, сортирует их по полям из ORDER BY и оставляет первые 45 — ещё до соединения с остальными таблицами. Индекс по полям сортировки для этого не требуется, хотя чтение и сортировка строк всё равно выполняются. Учёт целевого числа строк при выборе плана в MS SQL называется row goal.
Мы реализовали в Tantor Postgres аналогичную оптимизацию планировщика, и теперь у нас также после выборки из левой таблицы появляется узел Sort, который сокращает выборку до количества записей, указанных в секции LIMIT:
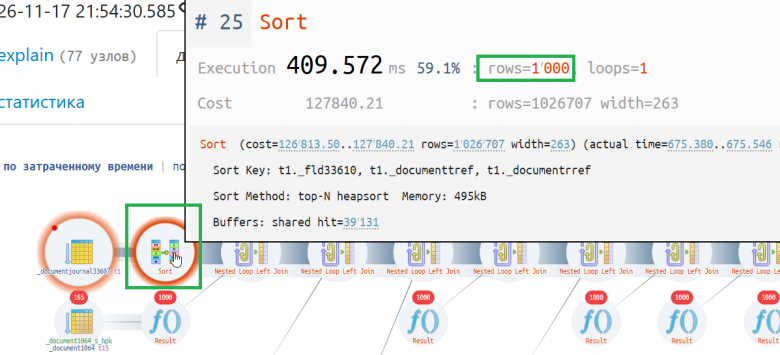
Благодаря данной технологии исходный запрос ускорился в 11 раз! Сочетание ORDER BY и LIMIT — типичный шаблон запросов динамических списков 1С: обновление списка для получения очередной порции данных в заданном порядке. Для пользователей это означает более быстрое открытие, прокрутку и сортировку списков — с привычной по MS SQL Server скоростью работы после миграции.
Ускоряем Nested Loop
При решении описанных выше задач мы обнаружили еще типичный пример работы динамических списков (и не только их), где можно ускорить время выполнения запроса за счет доработки СУБД. Он касается обращения через точку к полям составных типов, что довольно часто встречается в 1С, так как сами пользователи могут выводить на форму динамических списков реквизиты из полей составного типа.
Например, у нас есть журнал документов, в котором есть стандартное поле Ссылка, которое содержит все ссылки документов, включенных в журнал. В структуре базы данных на SQL такое поле будет состоять из двух полей:
DocumentTRef— тип ссылки. Например, Реализация товаров и услуг, Авансовый отчет и так далееDocumentRRef— непосредственно сама ссылка, то есть 36-символьный GUID.
Обращение к реквизиту поля Ссылка через точку приведет к тому, что платформа 1С обращается к каждой таблице, входящей в составной тип поля Ссылка, и на SQL такое обращение выглядит так:
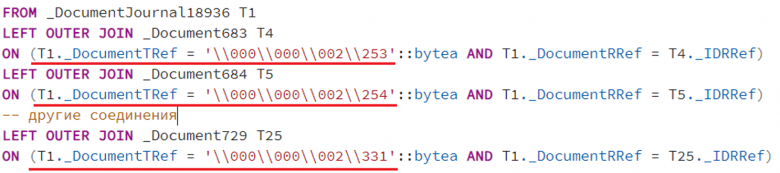
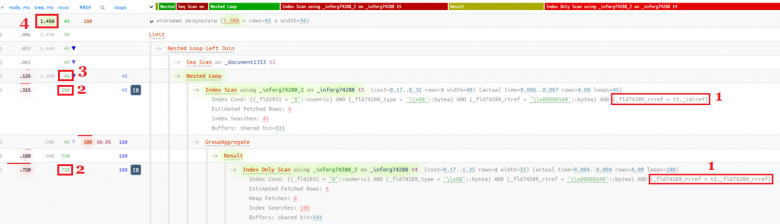
Красным выделено сравнение на тип ссылки, что оно значит? Например, таблица Document683 это Документ.АвансовыйОтчет и данное условие говорит о том, что соединение с таблицей Document683 необходимо делать только для тех строк таблицы _DocumentJournal18936, где DocumentTRef = '\\000\\000\\002\\253', то есть где DocumentTRef имеет значение Документ.АвансовыйОтчет. Пока все логично, но давайте посмотрим на план такого запроса (для простоты понимания в примере количество таблиц, участвующих в запросе, сокращено до четырех):
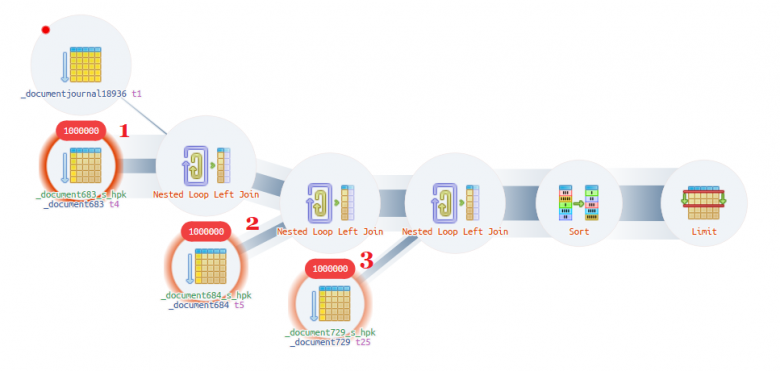
Из левой таблицы documentjournal18936 выбирается миллион записей и затем миллион раз мы обращаемся к каждой правой таблице (отмечено цифрами 1, 2, 3), которая у нас фигурирует в LEFT JOIN. Получается 3 миллиона обращений к таблицам из LEFT JOIN используя оператор Nested Loop, и как следствие, запрос выполняется 15 секунд. Но почему мы обращаемся к каждой таблице миллион раз, если у нас есть условие на тип документа? Разве мы не должны обращаться к документу Document683 только когда выражение T1._DocumentTRef = '\\000\\000\\002\\253'::bytea является истинным?
Оказывается, оператор Nested Loop проверяет такое условие слишком поздно. В LEFT JOIN условие на T1._DocumentTRef касается только левой таблицы. Отфильтровать по нему строки левой таблицы заранее нельзя: LEFT JOIN обязан вернуть их все. Поэтому планировщик делит LEFT JOIN на две части:
T1._DocumentRRef = T4._IDRRefстановится условием поиска по индексу правой таблицы (Index Cond);T1._DocumentTRef = '\\000\\000\\002\\253'становится условием соединения (Join Filter).
Nested Loop выполняет их в таком порядке: берёт строку таблицы documentjournal18936, ищет её по индексу в Document683, и только потом проверяет Join Filter. Он не смотрит заранее, что у этой строки другой тип документа и обращаться к правой таблице не нужно. В итоге выполняется индексный поиск в правой таблице для каждой строки журнала, хотя нужные строки есть лишь у небольшой их части.
И логичным решением здесь выглядит доработка планировщика, чтобы он учитывал условие на тип документа, и не делал лишние обращения к правой таблице, если это условие является ложным. Мы доработали планировщик Tantor Postgres — взглянем, какой получился план запроса:
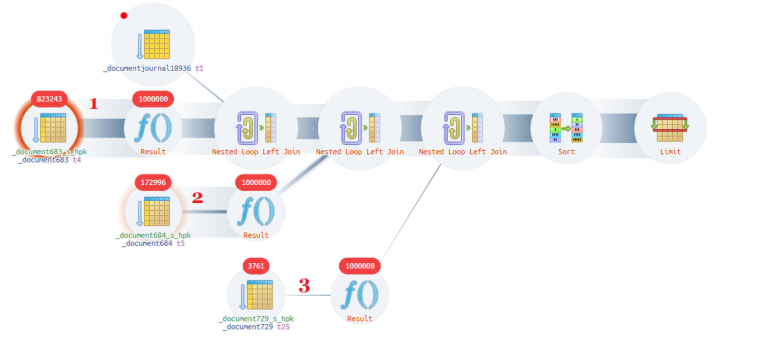
Теперь мы обращаемся к каждой правой таблице не миллион раз, а то количество раз, когда верно условие на тип документа, как условие T1._DocumentTRef = '\\000\\000\\002\\253' при соединении с таблицей _Document683. Если сложить количество обращений к правым таблицам (823 243 + 172 996 + 3 761), то мы получим миллион обращений. За счет чего так получается? В плане запроса у нас появляется новый узел Result, который вычисляет это условие на тип документа, и обращается к правой таблице, только если условие истинно:
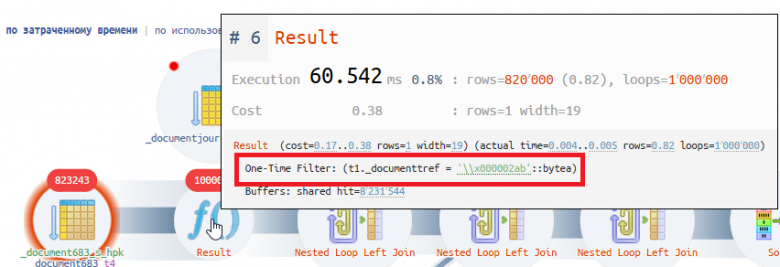
Запрос выполнился в 2 раза быстрее — за 7.5 секунд.
А теперь рассмотрим пару живых примеров от клиентов с более сложными запросами. Оба примера здесь также усложнены наличием механизма РЛС:
Ускорение запроса динамического от 2 до 6 раз. Отличная получилась оптимизация!
Отдельно стоит отметить, что она будет работать не только в списках, но и везде, где будут встречаться подобные шаблоны написания запросов, приводящие к указанным выше или даже более сложным условиям соединения. Например, это могут быть отчеты на СКД, позволяющие пользователю выводить в отчет поля составного типа, или обращения через точку, написанные разработчиками в коде.
Динамический список и срез последних
Следующий пример связан с доработкой логики динамического списка. Разработчики 1С часто их дорабатывают, но это содержит определенные риски и требует высокой квалификации, поскольку, как мы уже обсудили выше, запросы обновления динамических списков должны выполняться моментально.
Допустим мы хотим в форме списка получить статус по документу и вывести его в отдельную колонку. Бизнес часто приходит с такими хотелками. Выглядит запрос динамического списка вот так:
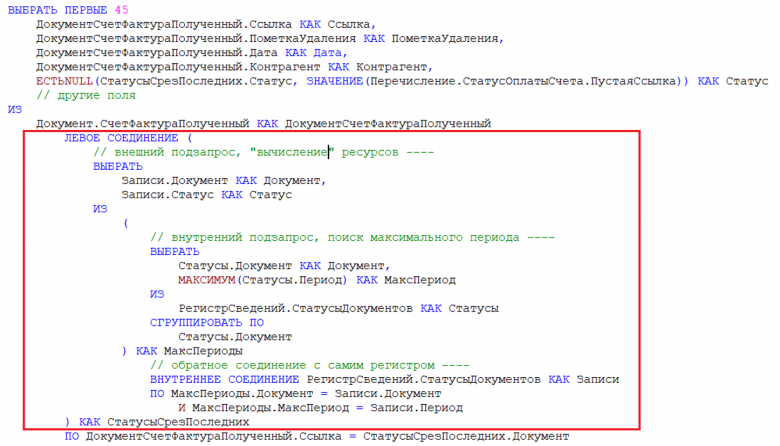
Обращаемся к виртуальной таблице РегистрСведений.СтатусыДокументов.СрезПоследних, чтобы получить актуальный статус по документу. Конструкцию ПЕРВЫЕ 45 добавляет платформа сама при выполнении запроса.
Казалось бы, вроде запрос написан хорошо: обращение к виртуальной таблице среза последних, чтобы получить статус. И выбираем всего 45 записей (платформа 1С сама добавит это при выполнении запроса). Вроде бы простейший запрос. И на MS SQL это действительно работало быстро, а на PostgreSQL — нет. Дело в том, что платформа 1С трансформирует данный запрос перед его выполнением на СУБД — он стал сильно сложнее:
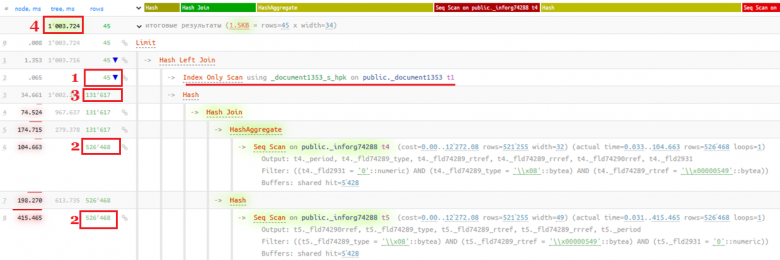
При трансформации добавился вложенный запрос, который вычисляет эти самые статусы по всем документам, которые есть в РегистрСведений.СтатусыДокументов, а не только по 45 документам СчетФактураПолученный, которые вернет запрос.
Посмотрим, как это выглядит в плане запроса:
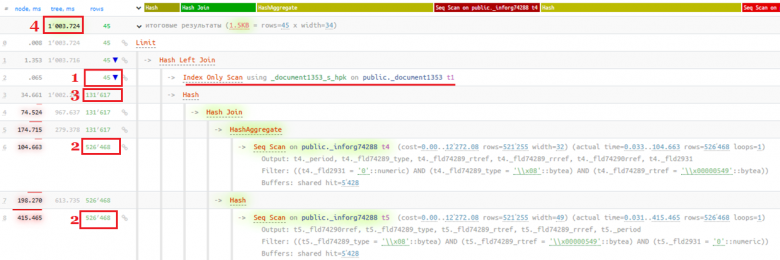
Разберем этапы выполнения запроса:
Выбираем 45 записей из таблицы документов
СчетФактураПолученныйДля вычисления среза последних таблицы
РегистрСведений.СтатусыДокументовсначала идет выборка по всем документам с вычислением даты последнего статуса по каждому из них, а затем вычисление последнего статуса по каждому документу — как видим выбираются сотни тысяч записей для этих вычислений, что и занимает основное время выполнения запроса.После всех вычислений на выходе мы получаем 131 617 записей, которые были получены при вычислении среза последних и затем соединяем их с 45 записями, выбранными на этапе 1.
В результате такой запрос выполняется 1 секунду.
В MS SQL это работает быстрее за счет того, что есть технологии переписывания (rewriting) запроса, в данном случае Join predicate pushdown, которая позволяет проталкивать предикаты из условий соединения во внутрь вложенного запроса как изображено ниже:
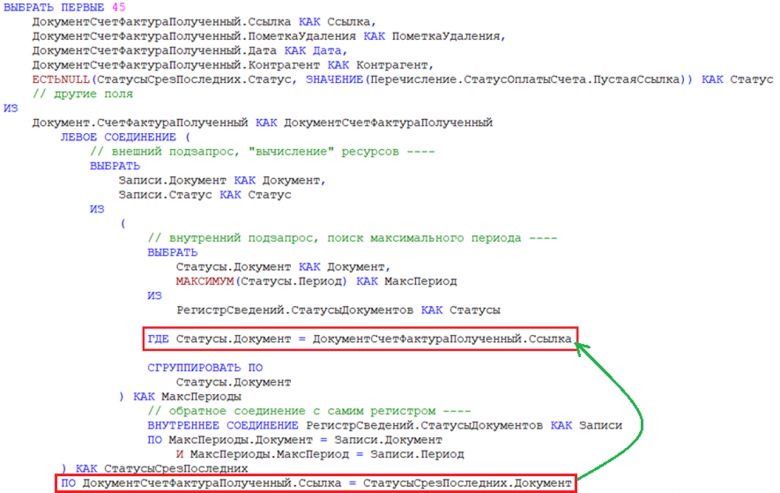
В Tantor Postgres такая технология тоже есть. Включим ее и посмотрим какой будет план запроса:
Разберем, что изменилось:
Внутрь вложенного запроса вычисления среза последних добавляется условие отбора по документам, которое переносится из условий соединения таблиц.
Данное условие позволяет вычислять статусы не по всем документам регистра сведений, а лишь по тем 45, которые вернет результат запроса. Это позволяет сократить выборку до сотен записей вместо сотен тысяч.
На выходе при вычислении среза последних получается 45 записей.
В итоге у нас нет ресурсоемких вычислений и запрос выполняется за 1 мс.
Вот таким образом благодаря продвинутым техникам планировщика Tantor Postgres запрос динамического списка ускоряется на 3 порядка.
Динамический список и получение итогов
Следующий пример похож на предыдущий, только вместо статуса бизнес попросил выводить по каждому заказу клиента сумму к оплате и к отгрузке:
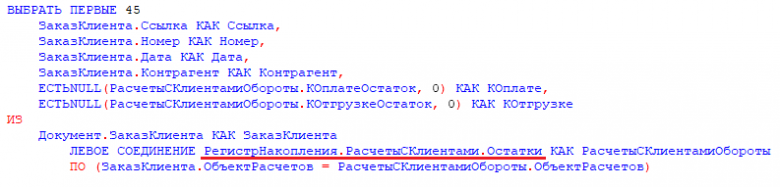
Для выполнения поставленной задачи мы обратимся к виртуальной таблице итогов РегистрНакопления.РасчетыСКлиентами.Остатки. Платформа 1С перед выполнением запроса на СУБД также трансформирует этот запрос в следующий:
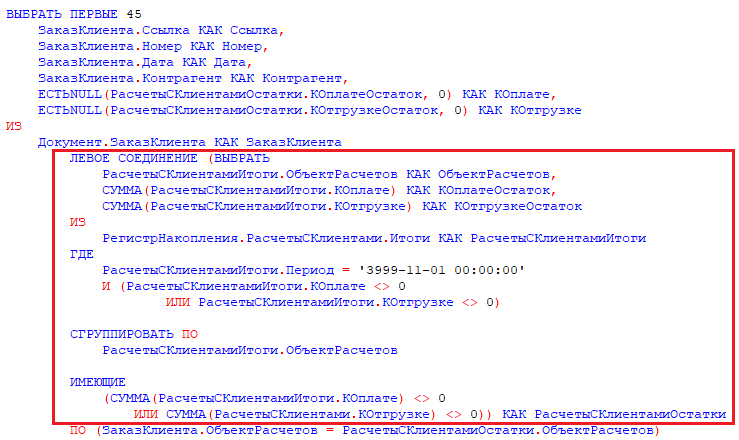
Здесь мы также видим, что платформа 1С формирует вложенный запрос для вычислений. Только здесь вычисления намного проще: мы получим текущие итоги из физической таблицы итогов РегистрНакопления.РасчетыСКлиентами — я назвал ее на изображении как РегистрНакопления.РасчетыСКлиентами.Итоги. Посмотрим на план запроса:
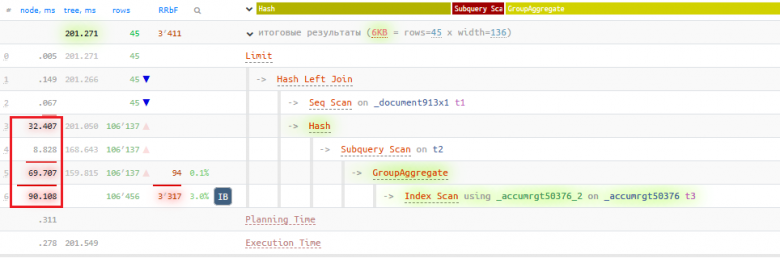
Опять мы видим, что основное время тратится на вычисления вложенного запроса, а именно на выборку из РегистрНакопления.РасчетыСКлиентами.Итоги, группировку и построение хэш‑таблицы на этих данных. Все дело в том, что мы получаем итоги опять же по всем документам регистра накопления, а не только по тем 45, что вернет результат запроса. Включаем join predicate pushdown и смотрим на план:
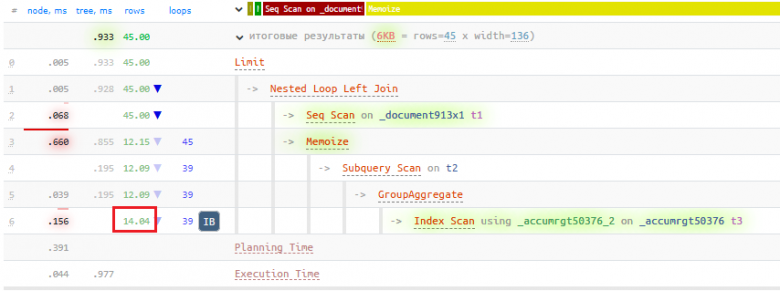
Теперь мы видим, что из таблицы РегистрНакопления.РасчетыСКлиентами.Итоги выбрались всего 14 записей, и время выполнения запроса сократилось с 200 до 1 мс!
Ускорение поиска в динамических списках
В 1С также очень популярна операция поиска в списке. Пользователи постоянно делают это, чтобы найти какой‑то нужный им документ, элемент справочника, запись регистра.
Например, поиск номера документа по части строки. Сотруднику отдела казначейства требуется найти поступление или списание ДС по части номера документа, который указан в назначении платежа одной из строк банковской выписки. Проще ввести часть цифр. Пользователи часто так делают, как показано ниже:
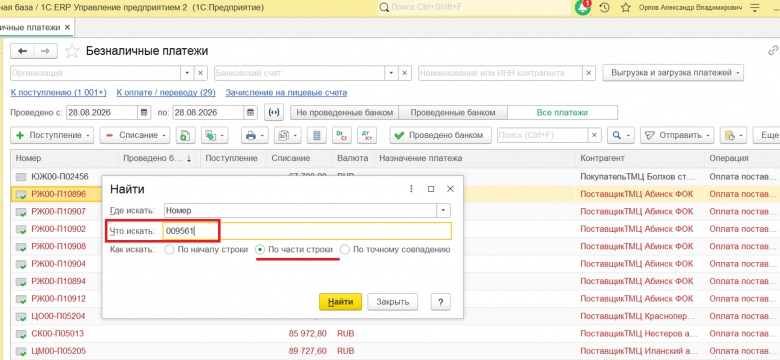
Платформа 1C в этом случае генерирует запрос для поиска по полю «Номер», используя оператор ПОДОБНО, эквивалентный оператору LIKE на SQL. Подобный запрос сканирует всю таблицу и выполняется 1.4 секунды:
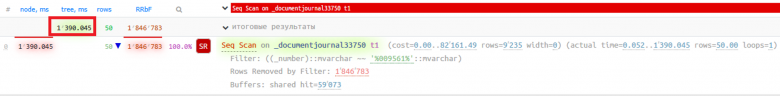
Ранее мы уже делали оптимизацию оператора LIKE, но увидели, что запрос можно ускорить ещё сильнее, если посмотреть на исходный код с «другой стороны». Раньше каждая строка таблицы сравнивалась с шаблоном посимвольно через ICU‑коллатор, что очень дорого. Теперь шаблон один раз за запрос приводится к нижнему регистру и кэшируется, а поиск %подстрока% выполняется быстрой системной функцией поиска подстроки, которая сравнивает данные целыми блоками байтов, а не по одному символу. Для шаблона из одних цифр, как в нашем примере с номером документа, приводить данные к нижнему регистру вообще не нужно.
Это помогло ускорить данный запрос в 4 раза:
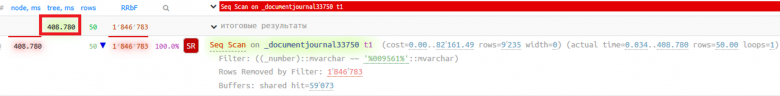
Но смотрите, таблица немаленькая, в ней почти 2 млн записей. Почему параллелизм не используется?
Мы также погрузились в этот вопрос и внесли правки в ядро Tantor Postgres, сняв ограничения использования параллелизма с оператором LIKE. Это еще ускорило запрос:
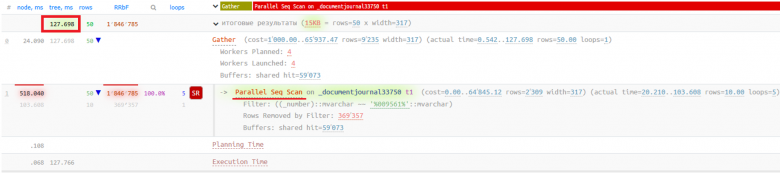
В результате данных оптимизаций у нас поиск ускорился более чем в 10 раз по сравнению с первоначальным временем выполнения!
Если хотите протестировать Tantor Postgres для 1С на своих кейсах, то вы можете бесплатно получить тестовую лицензию на 3 месяца по ссылке.
Fragster
Спасибо за статью! Вопрос: последняя оптимизация с like, проверяли ли её с составными юникод символами? например на айфоне была когда-то такая штука: при наборе с клавиатуры буквы й и ё шли как два символа и прямым сравнением строк не находились, только через "медленные" icu сравнения.