Сколько видеопамяти нужно LLM: считаем веса, KV-кэш и запас на одновременных пользователей 20.11.2026 08:23 tsKirill 1 Серверное администрирование Машинное обучение
Пишет ли локальная модель бэкенд по правилам проекта: 4 модели, 2 харнесса, 24 прогона +4 19.11.2026 15:32 pytorch38 8 Блог компании AIRI Искусственный интеллект Python Проектирование и рефакторинг качество кода
Независимые как понятия, зависимые как операции: параметры семплирования в LLM‑инференсе +4 16.11.2026 17:04 nikitatm333 2 Искусственный интеллект
Как ускорить локальную LLM на 50% без покупки новой видеокарты -15 14.11.2026 11:55 ki7onse 27 Искусственный интеллект Машинное обучение Kubernetes Видеокарты Серверная оптимизация
27B-модель на четырёх V100 в 2026 году: форк vLLM, INT4 на Volta и контекст 262K +1 13.11.2026 14:13 ZubikIT 2 Машинное обучение DevOps Искусственный интеллект
Спекулятивный декодинг в проде: сравнение методов в ИИ-ассистенте покупателя на Wildberries +9 13.11.2026 09:36 Vtmpas 5 Godot Блог компании RWB Big Data Python Искусственный интеллект
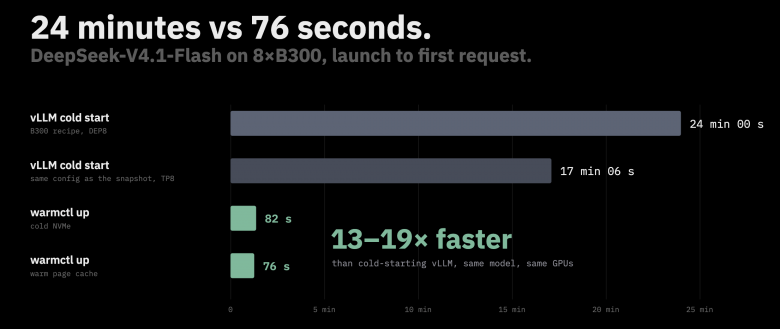
Оптимизация холодного старта vLLM: собираем прогретый OCI образ Deepseek и GLM и запускаем за 30 секунд +1 11.11.2026 17:21 kbespalov 0 DevOps Kubernetes
Claude Code без Anthropic: заводим агента на GLM-5.3 и Qwen через свой шлюз и собираем грабли -1 07.11.2026 09:17 ZubikIT 0 Искусственный интеллект DevOps Программирование
Scale-to-zero для LLM: на что уходят 294 секунды после первого запроса +1 06.11.2026 11:12 GRADDATA 1 Блог компании VK Tech Kubernetes DevOps Машинное обучение Облачные вычисления
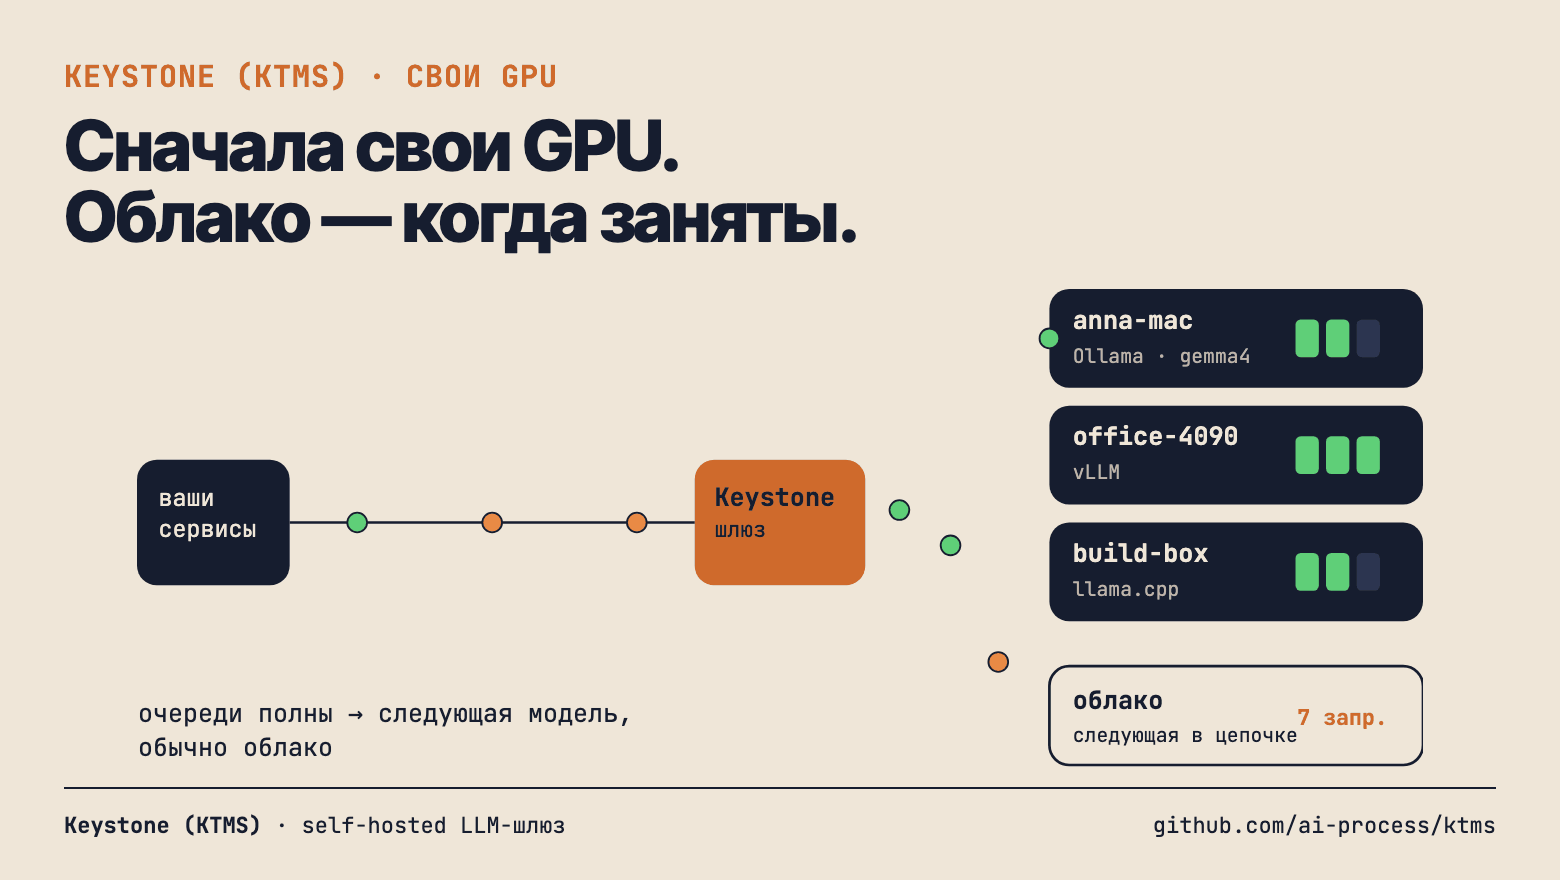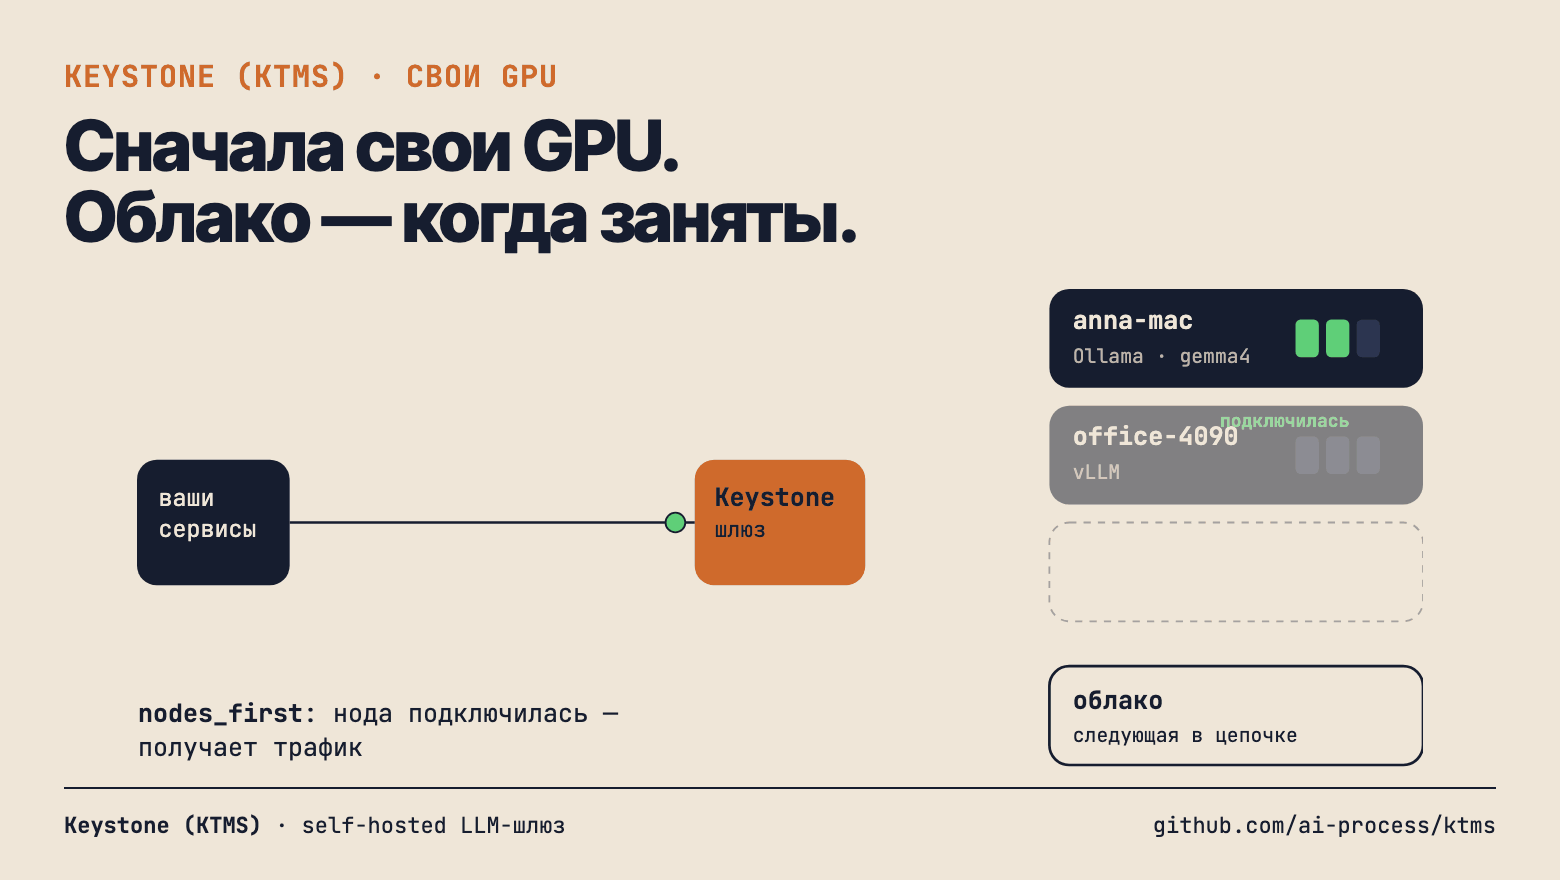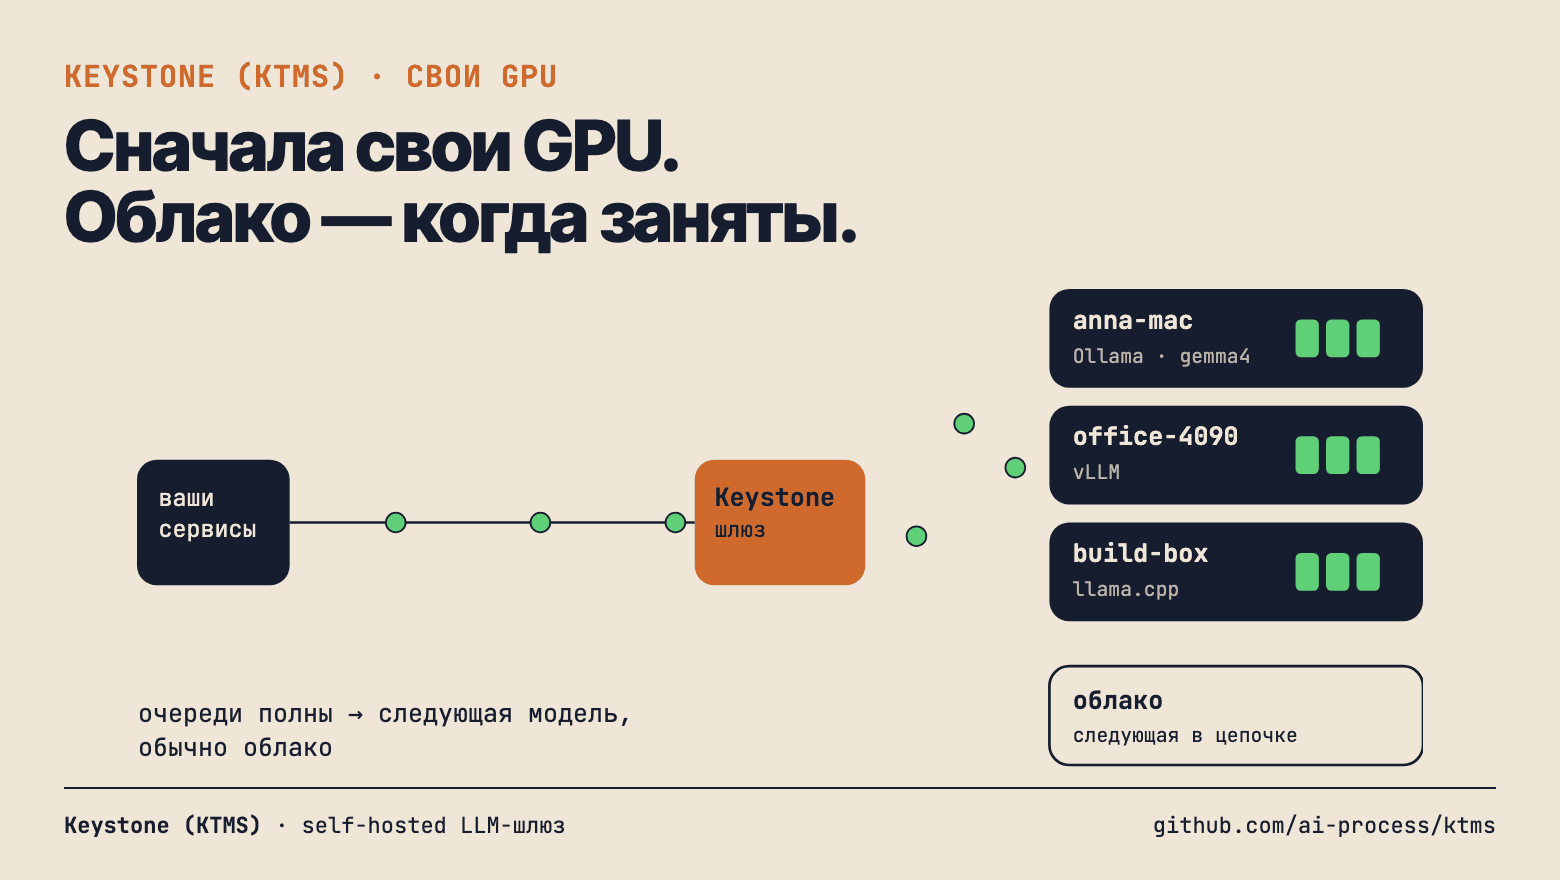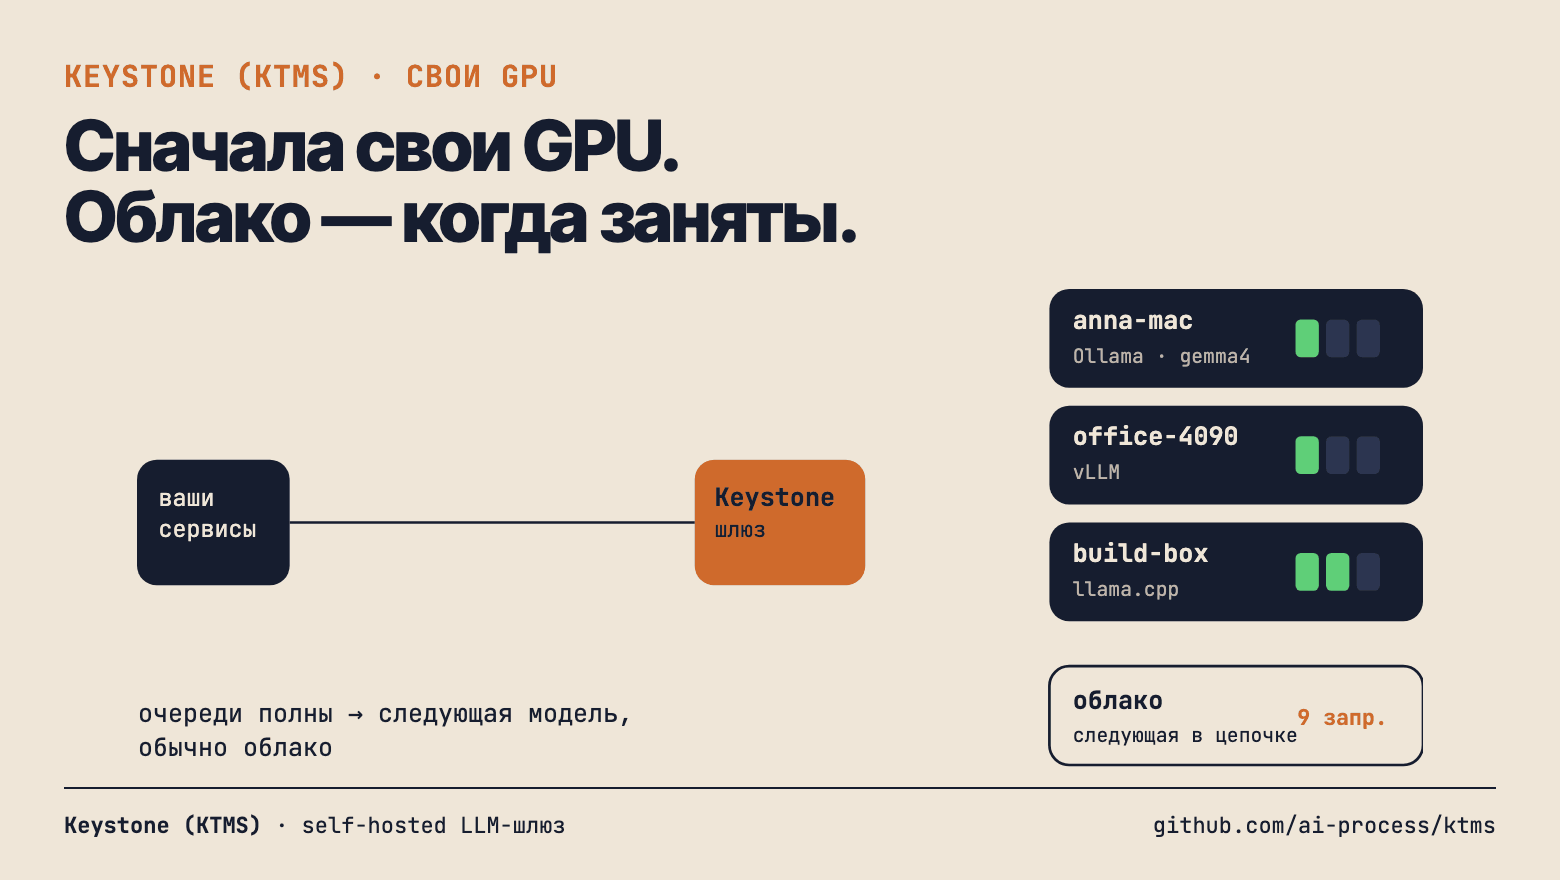
Свои GPU плюс облако: как LLM-шлюз живёт в продакшене — ноды, отказы, ключи, обновления -1 30.10.2026 08:30 coylOne 2 DevOps Системное администрирование Go Искусственный интеллект Open source
Бюджетная альтернатива RTX 3090 Ti для локальных ИИ, или как китайцы воплотили пророчество майнинг-бумового юмора +5 20.10.2026 09:01 Semen_Korneplodenko 22 Видеокарты Компьютерное железо
RPS одинаковый, но p95 по TTFT хуже в 2,7 раза: что round-robin делает с KV-cache +8 07.10.2026 12:58 GRADDATA 0 Блог компании VK Tech Блог компании VK nix Системное администрирование Серверное администрирование
Запускаем LLM локально на Windows: WSL2, Docker, CUDA и vLLM +4 06.10.2026 11:41 Qwertcoser 3 Машинное обучение DevOps GPGPU Linux IT-инфраструктура