

Разработка графического движка на Vulkan API с нуля (проект Shuttle Engine) требует ручного управления многопоточностью. В современном движке необходимо параллелить три основных направления:
Рендеринг: подготовка и отправка командных буферов.
Стриминг ресурсов: загрузка текстур и мешей в VRAM без микрофризов кадра.
Игровые системы: расчет трансформаций, физики, анимаций и видимости объектов.
Стандартная синхронизация через мьютексы неэффективна — из‑за постоянных блокировок многопоточное исполнение превращается в узкую трубу. Подход с цепочками коллбэков также неудобен, так как усложняет отладку и поддержку кода.
Для решения этих проблем я разрабатываю shuttle_async — легковесный фреймворк корутин и планировщик задач, который станет вычислительным фундаментом для Shuttle Engine.
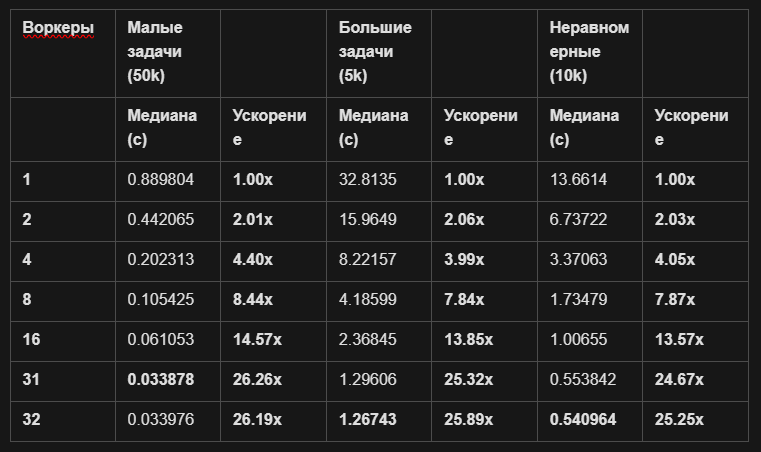
Результаты финального Release‑бенчмарка (‑O3)
Профили стресс‑тестирования
Стресс‑тест проводился на процессоре Intel Core i9-14900KF (24 ядра, 32 потока) в конфигурации Release. Для чистоты замеров lock‑free алгоритмов из кода полностью удален диагностический вывод.
Профиль теста |
Конфигурация |
Что проверяет (Цель) |
|---|---|---|
? 1. Много малых задач(Small tasks) |
50 000 корутин по 10 000 атомарных итераций. |
Издержки планировщика при высокой частоте запросов к очередям. Проверяет пропускную способность lock‑free алгоритмов. |
? 2. Большие задачи(Large tasks) |
5 000 корутин по 4 000 000 математических итераций. |
Чистую вычислительную мощность (Compute‑heavy). Обращения к диспетчеру минимальны. Проверяет способность рантайма утилизировать 100% CPU. |
? 3. Неравномерные задачи(Uneven tasks) |
10 000 корутин:• 10% тяжелых (8 000 000 итераций)• 90% легких (50 000 итераций). |
Балансировку нагрузки (Work Stealing) при сильном дисбалансе. Проверяет, забирают ли свободные потоки задачи из деков Chase‑Lev занятых потоков. |
Поток управления
В C++ бесстековые корутины по умолчанию не привязаны к конкретным потокам ОС. Чтобы управлять их выполнением в рамках игрового цикла Shuttle Engine, используется абстракция IExecutor. Она полностью контролирует поток управления (control flow).
Связующим звеном между планировщиком и потоками операционной системы выступает структура ThreadContext, объявленная как thread_local. Каждый рабочий поток инициализирует свой TLS‑контекст. За безопасность и корректный жизненный цикл этого состояния отвечает RAII‑обертка ThreadContextGuard, которая восстанавливает предыдущий контекст при уничтожении объекта.
Интерфейс ядра выглядит следующим образом:
class IExecutor {
public:
    virtual ~IExecutor() = default;

    // Ставит корутину на исполнение в lock-free очередь
    [[nodiscard]] virtual Status execute(std::coroutine_handle<> coro) = 0;

    // TLS-интроспекция контекста текущего потока
    [[nodiscard]] static IExecutor* getThreadPinnedExecutor() noexcept;
    [[nodiscard]] static IExecutor* getCurrentSharedExecutor() noexcept;
    [[nodiscard]] static std::coroutine_handle<> getCurrentDispatcherCoroutine() noexcept;

protected:
    // RAII-область для безопасного переключения и восстановления TLS-контекста
    class [[nodiscard]] ThreadContextGuard { /* ... */ };

private:
    inline static thread_local ThreadContext currentThreadContext = {};
};
Анатомия передачи управления потоком
Как корутины выполняются внутри системы без тяжелых блокировок? Процесс построен на прямой передаче управления между корутинами:
Точка приостановки: Когда корутина доходит до
co_await(например, ожидая готовности ресурса) и приостанавливается, она передает управление служебной корутине‑диспетчеру текущего потока. Хэндл диспетчера извлекается черезgetCurrentDispatcherCoroutine().Выборка задачи: Диспетчер просыпается на этом же потоке ОС, опрашивает контекст исполнителя и забирает следующую готовую задачу из локального дека Chase‑Lev или глобальной очереди.
Переключение контекста: Управление переносится напрямую в тело следующей корутины без возврата в ядро ОС. Поток операционной системы выполняет роль непрерывной вычислительной среды, а задачи сменяют друг друга через механизм симметричной передачи управления (Symmetric Transfer).
Кооперативная многозадачность
Для управления сложным жизненным циклом асинхронного графа в библиотеке реализована концепция Structured Concurrency, разделенная на следующие компоненты:
Иерархия владения: CoroScope и JoinableScope
Внутренние задачи игрового движка не должны жить в режиме «запустил и забыл» (fire‑and‑forget). CoroScope предоставляет контекст и древовидную иерархию для запуска и отслеживания дочерних корутин внутри асинхронного графа.
В свою очередь, JoinableScope выступает в роли корневого (root) скоупа. Он создается непосредственно в обычном блокирующем коде (синхронном контексте движка) и служит входной точкой, которая позволяет развернуть асинхронное дерево вычислений и гарантированно дождаться завершения всех порожденных в нем ветвей.
Защита локальных переменных: служебная корутина joinTask
Одна из главных опасностей в C++ — завершение родительской корутины до того, как отработают дочерние. Если родитель уничтожается раньше своих «детей», все захваченные по ссылке локальные переменные его фрейма пропадают. Это приводит к появлению висячих ссылок и указателей, вызывая неопределенное поведение (UB) и падения рантайма.
Для защиты от этой проблемы в архитектуру заложен внутренний предохранитель. При завершении родительской задачи в методах return_void или return_value её promise‑объекта неявно запускается служебная корутина joinTask, которая блокирует уничтожение фрейма, пока все дочерние задачи не завершат выполнение.
Логика работы предохранителя:
Замораживание фрейма: Если при завершении родителя счетчик активных задач в его
CoroScopeбольше нуля,joinTaskприостанавливает выполнение. Фрейм родителя и его локальные переменные остаются в памяти, а управление через диспетчер возвращается потоку.Возобновление: Последняя завершившаяся дочерняя задача атомарно сбрасывает счетчик до нуля и отправляет
joinTaskобратно в оригинальный поток родителя для финальной очистки памяти.
Только после этого происходит безопасное, каскадное удаление всей иерархии фреймов.
Безопасный финал: joinAll в деструкторе
Что происходит, когда объект JoinableScope выходит из области видимости (например, при уничтожении игровой подсистемы движка)? Чтобы предотвратить утечки «зомби‑корутин», в деструкторе JoinableScope принудительно вызывается метод joinAll.
joinAll осуществляет блокирующее ожидание всех незавершенных корутин, зарегистрированных в данном скоупе. Пока пул потоков полностью не докрутит оставшиеся задачи, деструктор не завершится, что гарантирует абсолютную безопасность очистки ресурсов Vulkan API на стыке уничтожения систем.
Режимы запуска: LaunchMode
Для гибкого управления потоком задач в рамках CoroScope я спроектировал три базовые стратегии планирования:
LaunchMode::Async— корутина сразу ставится в очередь указанного исполнителя (экзекутора) ещё до того, как методlaunchвернет управление.LaunchMode::Lazy— рантайм подготавливает и возвращает созданную задачу в приостановленном состоянии (initially suspended). Её фактический запуск и отправка на пул потоков происходят позже, по явному требованию.LaunchMode::Immediate— Корутина начинает выполняться сразу, на текущем потоке, прямо в контексте вызывающего кода.
? ПРЕДУПРЕЖДЕНИЕ ПО БЕЗОПАСНОСТИ
Жесткое правило контракта
shuttle_async: Использовать операторco_awaitвнутриImmediate‑задач разрешается строго в рамках одного и того же потока (например, совместно с привязанными к потокуThreadPinnedExecutorилиOneThreadExecutor). Смена пула или потока возобновления внутри тела корутины гарантированно ведет к неопределенному поведению (UB).
Связующее звено: AsyncSharedState, Promise и Future
Асинхронные задачи используют AsyncSharedState<T> — объект общего состояния для передачи результата выполнения от продюсера (Promise) к потребителю (Future).
Жизненный цикл и Lock‑Free координация
Взаимодействие построено на базе конечного автомата, который координирует потоки без использования глобальных мьютексов:
Выделение памяти: После успешного выделения памяти через mimalloc инициализируется объект состояния и связываются конечные точки. В случае сбоя аллокации рантайм возвращает ошибку через
std::expectedв рамках профиляAsyncResult.Публикация результата: Продюсер атомарно переводит автомат в состояние
Signaledи записывает вычисленное значение.Нотификация: Если корутина‑потребитель зарегистрировала свой хэндл до публикации значения, завершающий поток извлекает этот хэндл и планирует его выполнение через выбранный экзекутор.
Управление ресурсами и деаллокация
Рантайм задействует внутренний счетчик ссылок общего состояния (reference count). Этот счетчик атомарно учитывает активные конечные точки, выполняющиеся операции ожидания и обратные вызовы завершения.
Ключевая особенность: фабрика создания состояния жестко сохраняет внутри стейта операцию освобождения памяти конкретного пользовательского аллокатора. Когда счетчик ссылок падает до нуля, AsyncSharedState самостоятельно и корректно освобождает занимаемое хранилище.
Пул потоков
Как же нам удалось так утилизировать потоки? Секрет кроется в полностью децентрализованной lock‑free архитектуре планировщика ThreadPoolExecutor. Мы ушли от классической схемы с одной глобальной очередью под мьютексом, разделив потоки данных на два независимых уровня:
Локальные деки Chase‑Lev: Каждый воркер пула имеет собственную lock‑free деку, работающую по принципу Work Stealing. Поток забирает задачи из головы своей деки (
pop()) и добавляет новые задачи в её хвост (push()) без блокировок и конкуренции с другими ядрами.Глобальная воронка: Внешние задачи от сторонних потоков (или при редком переполнении локальных дек) агрегируются в потокобезопасной очереди
ConcurrentQueueот moodycamel. Воркер обращается к ней, только если его собственная дека опустела.
Если работы нет ни в локальной, ни в глобальной очереди, воркер переходит к рандомизированному сканированию дек своих соседей и пытается «украсть» ровно одну задачу. Если и кража не удалась, поток уходит в кратковременный спин‑лок через инструкцию процессора mmpause.
Для минимизации избыточных пробуждений потоков ОС используется 64-битное упакованное атомарное поле состояния сна (Packed sleep state). Оно координирует идентификаторы спящих воркеров и счетчик активных пробуждений.
Воркер выполняет системный вызов нотификации только при необходимости, что устраняет проблему Thundering Herd (эффект «дикой стаи»).
План дальнейшего развития (Roadmap)
Асинхронный ввод‑вывод для Win32: реализация неблокирующего стриминга текстур и мешей с диска в VRAM через Win32 Threadpool API с полной интеграцией в текущий Executor API.
Тестирование сценариев отказа: расширение покрытия для отмены задач через
CancellationTokenи проверка устойчивости автоматаAsyncSharedStateв условиях экстремальных гонок данных.
Послесловие
Проект shuttle_async создается как экспериментальное и специализированное решение под задачи Shuttle Engine, поэтому мне важна обратная связь.
Если вы сталкивались с похожими архитектурными вызовами при разработке игровых движков или рантаймов корутин, буду рад конструктивной критике и обсуждению. Вопросы по lock‑free очередям, балансировке задач или обработке сценариев отмены также приветствуются.
Поддержите проект лайком или звездой на GitHub, если вам интересна тема низкоуровневой асинхронности в C++. Весь исходный код планировщика, тесты, примеры и puml‑схемы переходов состояний открыты под лицензией MIT.
⭐ Ссылка на GitHub: ://github.com