

Привет, Хабр.
Мне нужно было открыть страницу и увидеть, что происходит на удалённых серверах: нагрузка, процессы, диски, логи. Всё, что я находил, делилось на два лагеря. В первом система, под которую поднимаешь несколько сервисов и потом живёшь с их конфигами. Во втором простая штука, которая выглядит как из прошлого десятилетия и под себя почти не настраивается. Красивого, простого и гибкого одновременно я не нашёл. Мне это надоело, и я написал своё.
Получился Pulse: мониторинг Linux- и Windows-серверов, который ставится на свою машину. Бэкенд на Go, интерфейс на Next.js, лицензия MIT. Состоит из трёх репозиториев: панель (Monitor), агент (Agent) и отдельный модуль для Docker.
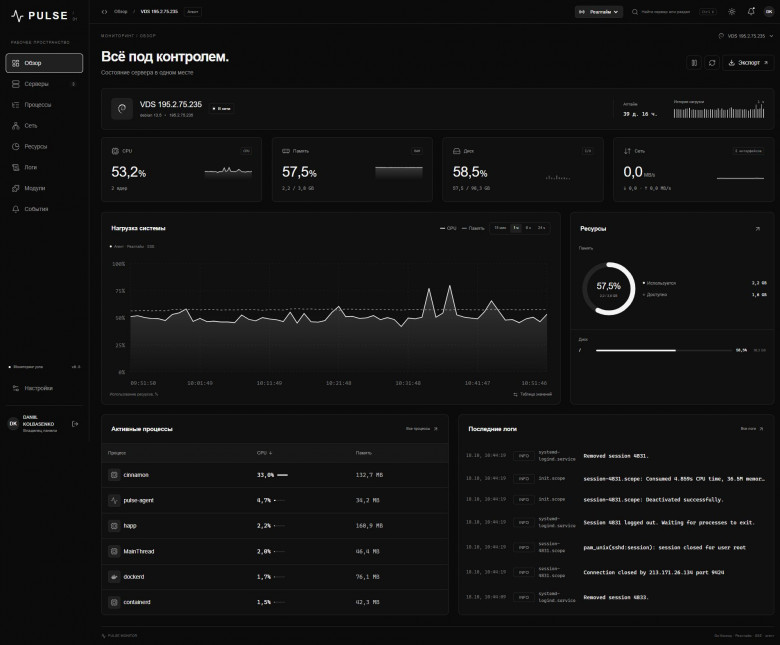
Про сам проект в README написано достаточно. Здесь я хочу рассказать о другом: после первого публичного релиза (v0.4.0) я пересмотрел три решения, которые мне самому перестали нравиться. Хранилище, модель модулей и то, как панель обращается к каталогу модулей. На момент написания актуальны Monitor v0.6.3 и Agent 0.5.0.
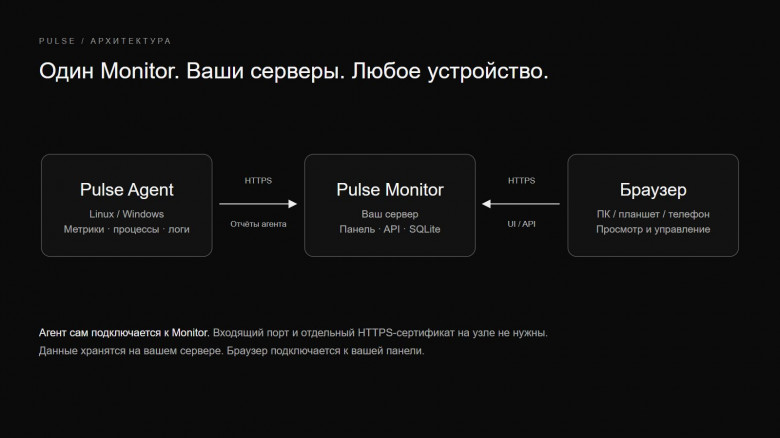
Как всё устроено в двух абзацах
Агент работает на каждом наблюдаемом сервере и сам отправляет отчёты в панель по HTTPS. Входящий порт на сервере открывать не нужно, сертификат панели проверяется всегда, режима «не проверять» нет. По умолчанию агент собирает данные раз в 500 мс, интервал можно поднять до 5 секунд. Он собирает CPU и память, процессы, диски, соединения, системные логи и GPU, если есть NVIDIA и nvidia-smi. Если показатель недоступен, панель рисует прочерк, а не ноль.
Панель принимает отчёты, хранит историю и показывает всё это в браузере. Модуль расширяет агента: это отдельная программа, которая собирает что-то своё, и описание того, как это показать.
Хранилище: почему я ушёл от JSONL
В v0.4.0 всё лежало в файлах. История метрик каждого агента шла в свой .jsonl, логи в общий logs.jsonl, события и реестр серверов в отдельных JSON. Метрики записывались раз в 10 секунд, графики читали последние 24 часа. Для старта это было удобно: открыл файл глазами, увидел, что происходит. Бэкап это просто копия каталога.
Цена тоже быстро проявилась. Архив JSONL не чистился автоматически, и в README мне пришлось написать «следите за свободным местом». Это звучит как оправдание, и по сути им и было. Бэкап по инструкции делался так: остановить панель, скопировать весь каталог данных, запустить обратно. Хранение логов по серверам настроить было нельзя.
В версии 0.5.0 телеметрия, логи, история метрик и события переехали в SQLite в режиме WAL. Почему именно он: агенты по умолчанию шлют отчёты каждые полсекунды, а браузер в это же время читает графики. В WAL читатели не блокируют писателя, для такой нагрузки это подходящий режим. Что я получил:
Миграция возобновляемая. Первый запуск после обновления импортирует старую историю до того, как панель начнёт отвечать по HTTP. Для больших архивов это занимает время, и я так и пишу в заметках к релизу: сделайте бэкап и не паникуйте, если панель пару минут молчит.
Резервные копии стали согласованными, то есть остановка панели для копии больше не нужна.
Появилась настройка хранения логов по серверам. Здесь я намеренно выбрал осторожный вариант: у уже существующих узлов автоматическая очистка выключена. Обновление не должно удалять чужие логи только потому, что у меня появилась новая настройка.
Файлы владельца и модулей остались в прежних хранилищах, их я пока не трогал.
Модули: от «запусти и прочитай stdout» к вызовам с разрешениями
В первой версии протокола модуль был устроен предельно просто. Модуль это один JSON-файл с полями настроек, описанием представлений (table, cards, chart, logs) и бинарниками сборщика под linux-amd64, linux-arm64 и windows-amd64. Агент скачивает нужный бинарник, проверяет SHA-256 и запускает как отдельный процесс. Процесс получает JSON на stdin и печатает один JSON в stdout:
stdin:  { "protocol": 1, "config": { "endpoint": "local-service" } }
stdout: { "service": { "status": "running" } }
Интерфейс модуль не пишет, его строит панель по описанию представлений. Для чтения данных этого хватает. На практике я упёрся в три вещи. Поле permissions в пакете было просто текстом для человека и ничего не ограничивало. Модуль мог только отдавать данные, но не выполнять действия. И каждый цикл запускал процесс заново, без собственного состояния.
В 0.5.0 появились нативные компоненты v2. Их возможности по документации такие: периодические и ручные вызовы, явные разрешения, проверка хешей и прав перед запуском, отмена вызова и постоянные квитанции. Последнее мне казалось самым важным. Если вызов вроде «перезапустить контейнер» ушёл, а ответ потерялся, повторять его вслепую нельзя: можно перезапустить дважды. Поэтому для ручных операций агент хранит квитанцию и не выполняет операцию повторно, если исход неизвестен. Результаты, которые уходят в панель, ограничены по размеру и не содержат секретов.
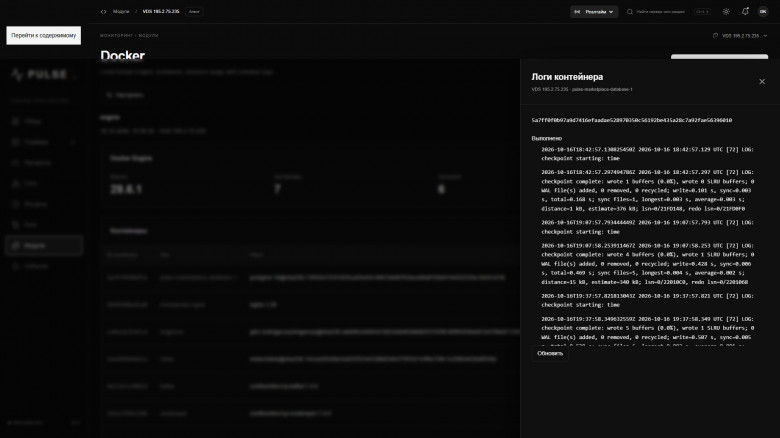
Первым на v2 перешёл Docker-модуль (2.0.0-alpha1). Теперь он показывает ID контейнеров, логи выбранного контейнера и стандартные графики, а ещё умеет start, restart и stop. Эти действия по умолчанию недоступны: владелец должен отдельно выдать право actions.execute, а компонент включить на каждом нужном узле. Если вы меняете контракт выполнения у компонента v2, права нужно подтвердить заново. При переходе с v1 на v2 старый модуль отключается, но его бинарники и данные сохраняются. Пакет v1 лежит рядом как docker-module-v1.json.
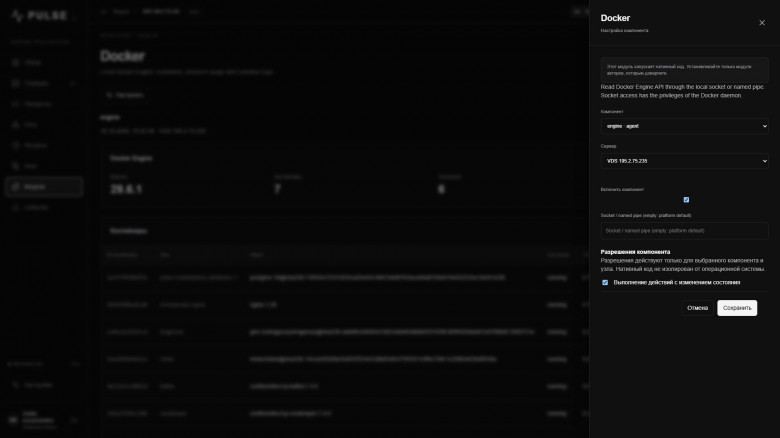
Теперь честно о границах. Разрешения это граница в протоколе панели и агента, а не изоляция на уровне ОС. Процесс сборщика по-прежнему живёт с правами агента, и если агент работает от root, то и модуль тоже. Доступ к Docker socket на хосте и так почти равен root, поэтому модуль Docker с правом управления нужно ставить осознанно. Кроме того, триггеры по событиям и долгоживущие задачи в v2 пока не реализованы.
Маркетплейс, которому не нужно доверять сразу
Модули кто-то должен находить. Я не хотел делать так, чтобы панель при установке без спроса ходила во внешний сервис, поэтому клиент каталога встроил как явное подключение. На вкладке «Модули → Маркетплейс» нужно ввести адрес каталога и нажать «Подключить». По умолчанию всё выключено.
Несколько решений, которые я принимал с оглядкой на злоумышленника:
Адрес каталога принимается только как HTTPS без пути, query и учётных данных. HTTP разрешён только для явно указанного loopback IP. Имена, которые резолвятся в частные адреса, и редиректы блокируются. Это защита от SSRF: панель делает запрос по адресу, который вводит владелец, и не должна превращаться в прокси к внутренней сети.
Панель передаёт каталогу только фильтры поиска и запросы выбранного модуля. Телеметрия, логи, конфигурация узлов и данные для входа не передаются. Агенты к каталогу вообще не обращаются.
При установке панель заново запрашивает опубликованную версию, проверяет размер и дайджест полного JSON, затем проверяет заголовки ELF/PE и хеши бинарников.
Идентификаторы модулей глобальны. Установка из каталога не заменяет уже существующий модуль с тем же ID, даже если издатель другой. Иначе подмена установленного модуля сводилась бы к регистрации такого же ID.
В 0.6.0 я добавил обновление модулей через каталог и через ручной импорт JSON. Источник каталога привязан к издателю. Если контракт v2 поменялся, нужно новое согласие на права, а совместимые настройки сохраняются. Предварительные версии проверяются отдельным переключателем.
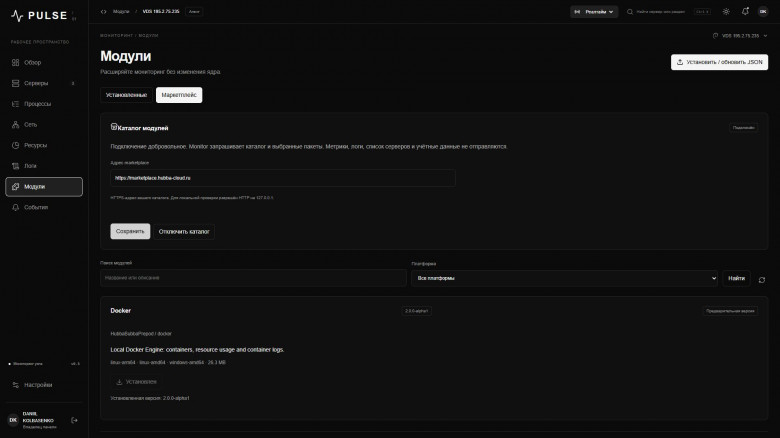
Одобрение в каталоге я прямо не считаю гарантией безопасности нативного кода, так написано и в документации. Публичный каталог пока не открыт: на сайте сейчас один модуль, Docker. Клиент в панели готов.
Агент на одном сервере с панелью
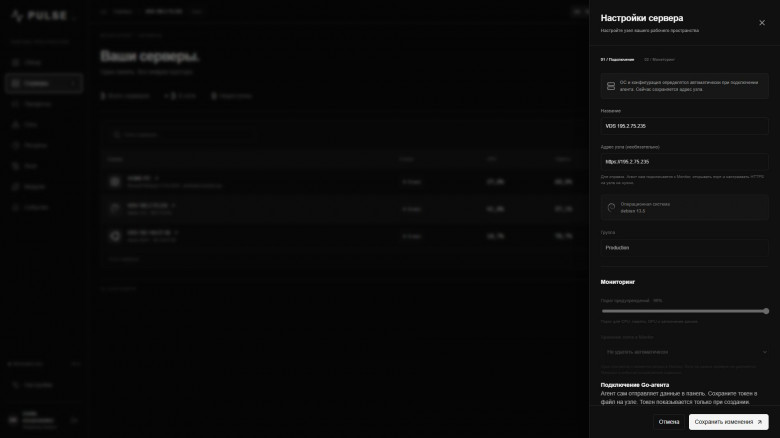
Ещё одна мелочь, на которую ушло больше времени, чем я ожидал. Агент ставят и на тот же сервер, где работает сам Monitor за публичным прокси. Агенту нужно прийти на конкретный IP и порт, но TLS при этом должен по-прежнему проверяться по домену. В 0.5.0 для этого появился флаг -connect-address: агент подключается напрямую по IP:порт, но сохраняет Host, SNI и проверку сертификата.
./pulse-agent -url https://monitor.example.com \
  -connect-address 127.0.0.1:8443 \
  -server SERVER_ID -token-file agent.token -state agent-state
Пример условный, адреса подставьте свои. Отдельно в 0.6.0 адрес узла в панели стал необязательным (он только справочный), а его смена больше не отзывает токен. Раньше это ломало подключение у тех, кто просто поправил подпись.
Что осталось сырым
Версии 0.x, и до v1.0 совместимость не гарантируется. Об изменениях я пишу в changelog обоих проектов. Docker-модуль v2 это альфа. Песочницы для модулей нет. Intel и AMD GPU без гарантированной телеметрии. После обновления на 0.5.0 откатываться на старые бинарники без бэкапа не стоит: новые файлы старыми версиями не читаются, и я не обещаю обратной совместимости. Три последних релиза (0.6.1, 0.6.2, 0.6.3) это только вёрстка карточек обзора на узких экранах.
Где посмотреть
Сайт и руководства: https://pulse.hubba-cloud.ru/
Monitor: https://github.com/HubbaBubbaPrepod/pulse-monitor
Agent: https://github.com/HubbaBubbaPrepod/pulse-agent
Docker-модуль: https://github.com/HubbaBubbaPrepod/pulse-module-docker
Если у вас есть опыт с моделью прав для нативных плагинов без песочницы, напишите в комментариях, что я мог упустить. Особенно интересно про повторное выполнение операций с неизвестным исходом: я выбрал «не повторять, хранить квитанцию», и мне любопытно, где это ломается.
Комментарии (4)

Fedasiaz
22.10.2026 12:18Отличная статья. Переход с JSONL на SQLite в режиме WAL — это прямо классика эволюции self-hosted проектов.
Насчёт вашего вопроса про «операции с неизвестным исходом» и квитанции. Я разрабатываю агентов на базе LLM (для автоматизации обновления зависимостей и починки тестов), и там эта проблема стоит особенно остро. Агент может сделать коммит и запушить ветку, но если связь оборвется, мы не знаем, применился ли патч или нет.
В итоге мы пришли к тому же паттерну: храним состояние (хэш коммита, результат тестов) как «квитанцию». Но есть нюанс: если операция имеет внешние побочные эффекты (как перезапуск Docker-контейнера), квитанция подтверждает только то, что команда ушла, но не гарантирует, что сервис поднялся. Приходится делать отдельный идемпотентный healthcheck после выполнения. Интересно, как вы решаете эту проблему на уровне ОС — проверяете ли вы реальный статус процесса/контейнера перед тем, как считать операцию успешной, или просто полагаетесь на exit-code модуля?
И второй момент, про который вы писали: раз песочницы (seccomp/AppArmor) нет, а модуль живет с правами агента, то как вы отслеживаете, что модуль не оставил после себя «зомби»-процессы или не залез в чужие директории? Только аудит логов?

zxchubbabubba Автор
22.10.2026 12:18Я, честно, в шоке от того, сколько можно узнать от людей в комментариях на Хабре. Когда писал проект, о некоторых таких сценариях даже не задумывался. Спасибо, что так подробно разобрали.
Полезли проверять код — и да, сейчас есть оба пробела. Мы проверяем не только exit-code, но и структурированный ответ модуля. Однако в Docker-модуле успешный ответ Docker API уже считается выполненной операцией. Отдельной проверки, что приложение внутри контейнера действительно поднялось и готово работать, пока нет. Состояние потом обновляется обычным сбором метрик, но это не то же самое, что проверка результата конкретного действия.
С дочерними процессами тоже нашли проблему: воспроизвели на Windows и Linux ситуацию, когда основной процесс модуля остановлен, а его потомок продолжает работать. Ограничения доступа к чужим директориям на уровне ОС сейчас нет — модуль работает с правами агента. Логами это надёжно не проконтролировать.
Так что не буду делать вид, что всё предусмотрел :) Забрал в доработку проверку состояния после действий и остановку дерева процессов. С файловой изоляцией нужно разбираться отдельно, пока нативный модуль — это именно доверенный код. Очень полезный комментарий, спасибо.
opium
У WAL стоит отдельно проверить долгий запрос истории: он может удерживать старый снимок и мешать checkpoint завершиться, пока новые отчёты продолжают увеличивать WAL-файл. Проверил на двух соединениях SQLite: открытая читающая транзакция и 50 коротких INSERT с commit — checkpoint смог перенести только 2 из 52 страниц; после закрытия читателя журнал удалось обнулить. Это не означает, что у вас есть такая проблема, но для мониторинга полезен тест «читаем большой диапазон истории, пока агенты пишут». Ограничиваете ли вы время читающей транзакции и следите ли за размером WAL?
zxchubbabubba Автор
Спасибо, проверили на используемом Go-драйвере и подтвердили сценарий. Закрытие транзакции предусмотрено, но отдельного deadline у HTTP-запроса истории и мониторинга WAL пока нет. Добавим ограничение времени чтения, наблюдение за WAL/checkpoint и конкурентный регрессионный тест.