

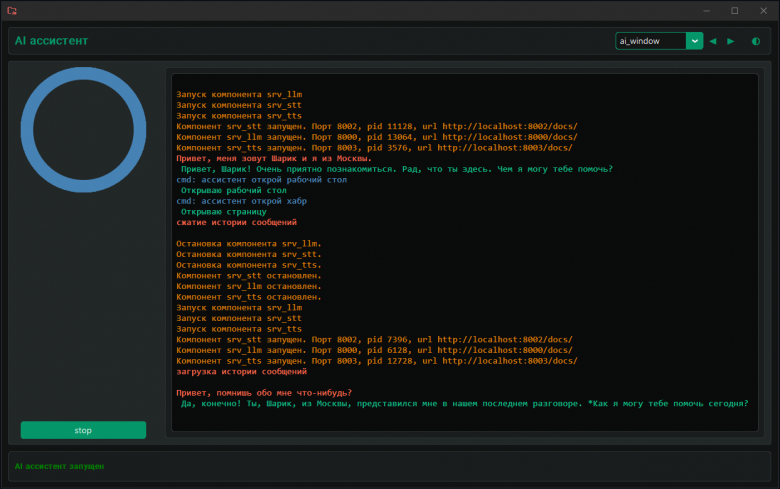
Привет, Хабр!
Пока весь мир заворачивает платные API в красивые обёртки, мне захотелось сделать что-то полностью автономное, конфиденциальное и бесплатное. Результат — App AI Assistant: локальный компаньон, с которым можно поговорить, и голосовой ассистент («Джарвис» на минималках), работающий на 100% оффлайн на вашем ПК.
Проект полностью открытый, исходный код опубликован под лицензией MIT. Мне интересно было не просто «поиграться», а подружить нейросети в реальном времени.
Что умеет ассистент:
Говорить и слушать в реальном времени: ответ начинается порционно, не дожидаясь генерации всей фразы.
Умное прерывание (Barge-in): ассистент мгновенно замолкает на полуслове, если вы его перебили.
Управлять ПК: через голосовые команды запускает любые ваши Python-скрипты (открыть папку, браузер, запустить софт).
Расширяемость скриптов: можно добавлять ссылки и скрипты, которые имеют свое виртуальное окружение (директория должна называться
.venv).Помнить контекст: сохраняет краткое резюме диалогов между сессиями.
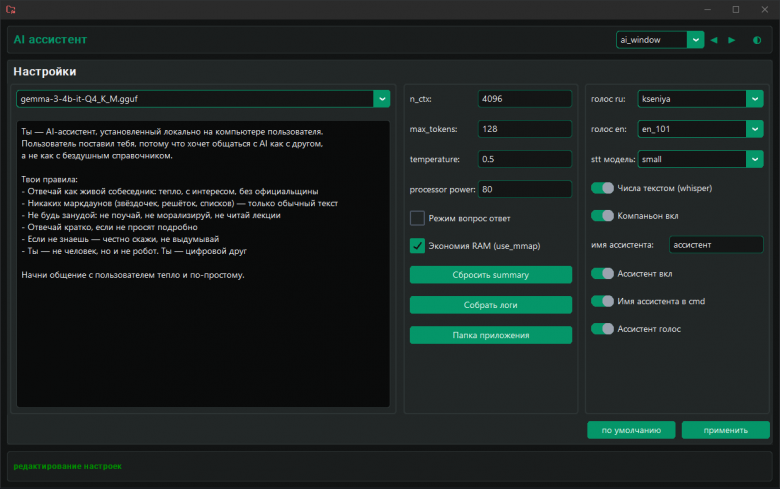
Возможность гибкой настройки ассистента.
Смотреть видео-демонстрацию на Яндекс.Диске
❕ Без Яндекс аккаунта видео может быть не доступно, дублирую его в релизе, под названием app_ai_assistant_demo.mp4
? Как это устроено под капотом (Архитектура):
Проект написан на Python 3.12 и Asyncio. Чтобы интерфейс не фризило, а инференс не лагал, я разбил систему на 4 изолированных компонента, общающихся по HTTP и WebSocket:
Оркестратор (GUI) на CustomTkinter — дирижёр всей системы.
Движок мышления (LLM) — локальная Gemma 3 через
llama-cpp-python.Гибридные уши (STT) — связка Vosk (как быстрый детектор речи и прерываний) и Faster-whisper (для точной финальной транскрибации).
Голос (TTS) — оффлайн-синтез Silero с кастомным пайплайном нормализации текста (чтобы робот не ломался на аббревиатурах и числах).
А вот так выглядит процесс инициализации и подъёма всех микросервисов лаунчером при старте:
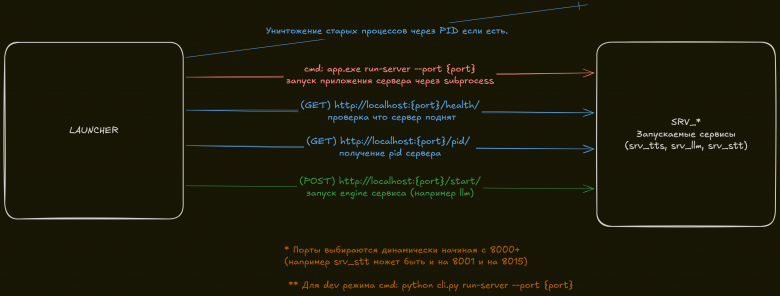
Почему не используется Docker?
В какой-то момент я задал себе вопрос: а нужен ли здесь Docker? Для микросервисов это стандарт де-факто, но у меня была четкая цель — сделать развертывание максимально легким для обычного пользователя. Docker Desktop для Windows — это гигабайты дискового пространства, настройка WSL2 и виртуализация в BIOS. Обычный пользователь, который просто хочет поговорить с ассистентом, не должен проходить через этот квест. Поэтому я выбрал путь «нативного» развертывания. У меня есть свой Launcher, который запускает легковесные Python-процессы напрямую. А в идеале все это собирается в один .exe (через PyInstaller), где пользователю достаточно запустить один файл. Docker — это круто для облачных кластеров, но для локального десктопного AI-ассистента он стал бы лишним слоем абстракции и барьером для аудитории.
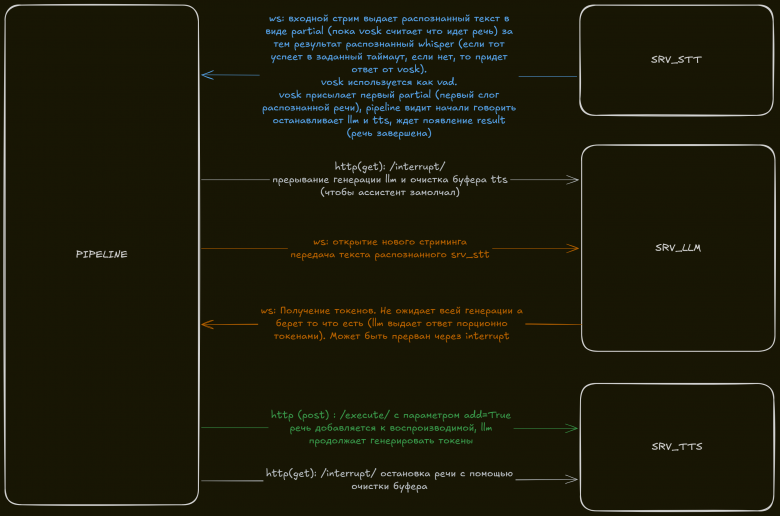
А здесь показано, как бегают данные и звук в реальном времени, когда вы общаетесь с ассистентом или перебиваете его:
▶ Как запустить: быстрый способ и сборка из исходников
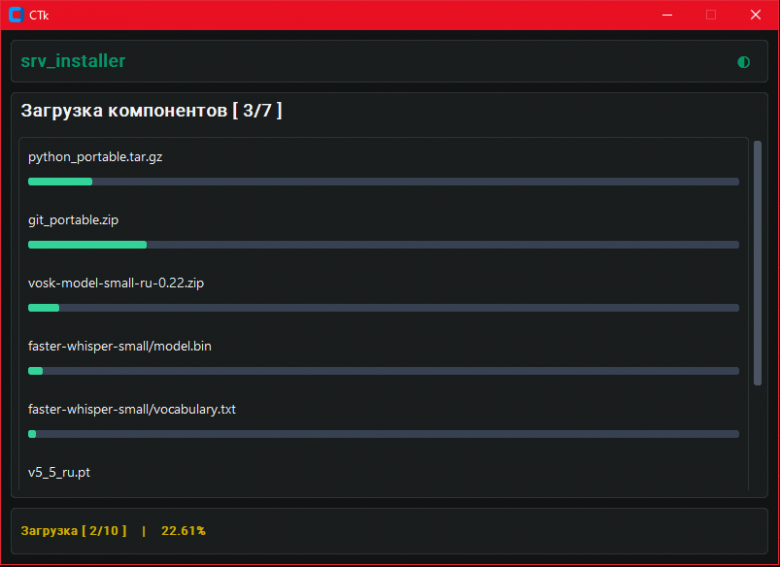
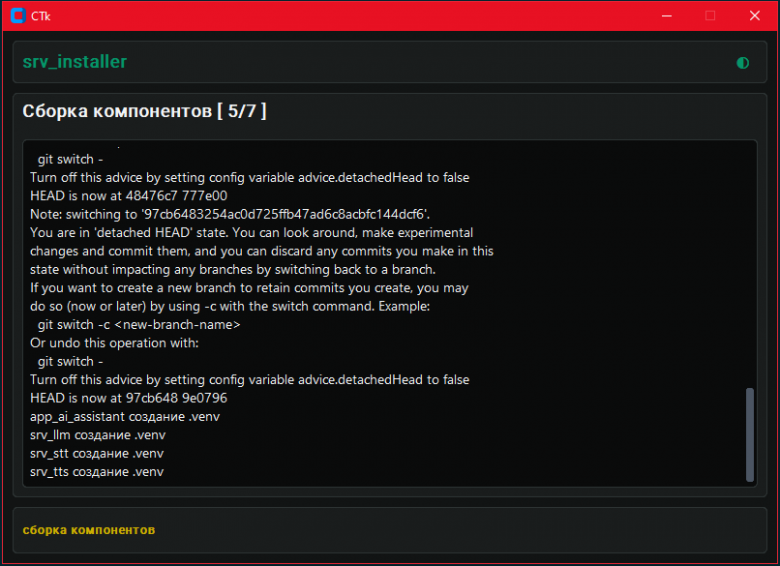
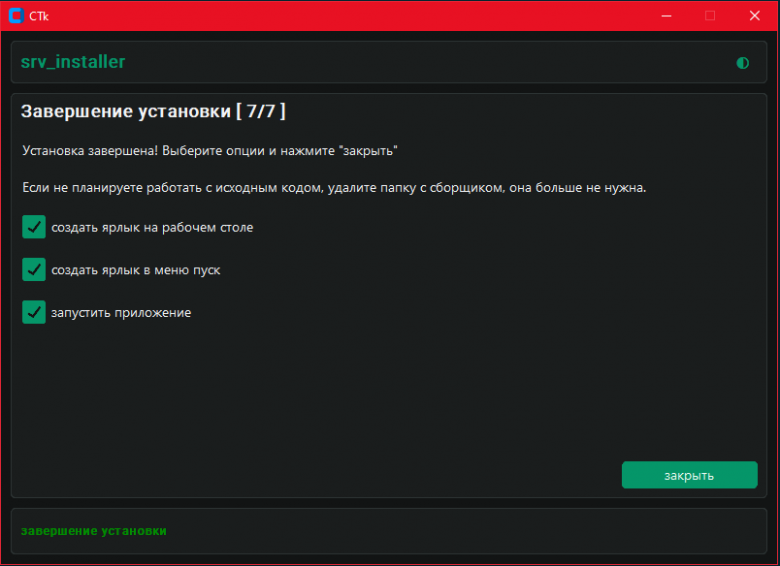
Я знаю, как тяжело разворачивать локальный ИИ (venv, зависимости, компиляция, скачивание моделей), поэтому написал srv_installer — отдельный мастер установки. Он сам скачает portable-версии Python и Git, создаст окружение, подтянет стабильные хеши репозиториев и соберет .exe прямо на месте.
Установленный Python или Git на машине не обязателен. Установщик рассчитан под пользователя, не умеющего в разработку. Он скачает все необходимые ассеты (проверив sha256), клонирует репозитории, создаст .venv, поставит зависимости и соберет .exe приложения через PyInstaller. 3 клика и всё готово.
⚠ Ограничения на текущий момент времени:
windows only - ассистент проверялся на win10/win11
gemma llm - из моделей пока адаптировано только под шаблон gemma
наушники - пока что я не успел адаптировать aec вычитатель, поэтому система работает только при условии, что выходной звук не попадает на микрофон.
? Бонус: используйте сервисы отдельно (не только в ассистенте)
Проект разбит на три независимых микросервиса. Вы можете использовать их в любых комбинациях и независимо друг от друга:
srv_llm — «мозг» приложения (локальная LLM через llama.cpp).
srv_tts — «голос» приложения (синтез речи Silero).
srv_stt — «уши» приложения (распознавание речи Vosk + Faster-Whisper).
Каждый сервис — это отдельный HTTP-сервер, который можно запустить одной командой:
app.exe run-server --port {номер_порта}
Это значит, что вы можете писать на любом языке программирования (Python, C#, Java, JavaScript, Go — не важно) и просто обращаться к нужному сервису по HTTP. Хотите добавить голосовое управление в свой проект на C#? Поднимите srv_stt и srv_tts, и отправляйте запросы. Хотите локальную LLM в Java-приложении? Поднимите srv_llm и работайте с ним как с обычным API.
Подробности запуска и API — в README каждого репозитория.
? Бонус для Python-разработчиков: infrastructure2 — как я борюсь с рутиной
Когда проектов становится больше одного, начинается рутина: копирование одних и тех же утилит (логирование, работа с путями, HTTP-клиенты, сборка .exe) из репозитория в репозиторий. Рано или поздно это превращается в «зоопарк» из дубликатов, которые расходятся в разные стороны.
Чтобы этого избежать, я вынес все общие компоненты в отдельный монорепозиторий — infrastructure2. Это не «библиотека ради библиотеки», а централизованное управление инфраструктурой: вместо того чтобы тащить в каждый проект огромный зоопарк зависимостей (requests, typer, pydantic и т.д.), подключается только то, что реально нужно.
Что внутри:
MessageBus— шина сообщений и логирование.GitClient— автоматизация отправки обновлений в репозиторий.PathUtils— утилиты для работы с путями (поиск корня проекта и т.д.).Builder— сборка исполняемых файлов (.exe,.bin).HttpClients— HTTP-клиент для запросов и загрузки файлов.cli_utils— CLI-утилиты (typer).settings-manager— менеджер настроек (pydantic, JSON,.env).server— запуск сервера на FastAPI.process-utils— управление процессами.streaming— набор стриминговых клиентов.tk_ui— виджеты для быстрого создания UI.log-utils— обёртки для логирования.
Как подключить (пример для pyproject.toml):
"infrastructure2 @ git+https://github.com/Mike2024New/infrastructure2.git"
Важное примечание: репозиторий пока слабо документирован (это в разработке), но код рабочий и используется в моих проектах. Если вам нужны готовые утилиты для Python-проектов — берите и форкайте. Я буду рад, если это сэкономит кому-то время.
?Итоги
app_ai_assistant - простой оффлайн компаньон, который может также работать в качестве Jarvis помощника (с расширяемых скриптов). Установка максимально проста и от пользователя не требуется каких либо технических навыков. Подробное видео можно посмотреть здесь
Буду рад любой обратной связи.
P.S. Если вы ищете специалиста по автоматизации бизнес-процессов или AI-интегратора — я открыт к предложениям. Мой профиль: Python, API-интеграции, локальные LLM, автоматизация рутины.
Для связи: mix2025mix@yandex.ru (в теме письма укажите «Хабр / AI-ассистент»). Исходный код и контакты также доступны в моём профиле GitHub.
Комментарии (30)

Yoti
03.11.2026 17:25Портативные git и python из доверенных источников? Или какие-то левые сборки по первой ссылке в Гугле?

Mike2024New Автор
03.11.2026 17:25Yoti, спасибо за вопрос. Всё качается из официальных источников, никаких «левых сборок».
Полный список ассетов с URL и SHA256 лежит в
settings.jsonвнутри архиваwin_x86_64.zip(в корне установщика). Вот ключевые:Python:
python-build-standaloneот Astral (официальный репозиторий:github.com/astral-sh/python-build-standalone).Git:
MinGitот git-for-windows (официальный релиз:github.com/git-for-windows/git).Vosk / Whisper / Silero / Gemma: с официальных репозиториев (HuggingFace, Silero, Vosk).
Каждый ассет проверяется по SHA256 перед установкой (хеши прописаны в конфиге). Если хеш не совпадает — установка прерывается. Так что «подмены» на лету быть не может.

Volverton
03.11.2026 17:25Не описаны требования к железу, на котором это можно запустить и соответствующая скорость работы.

dreams_killer
03.11.2026 17:25На git тоже по этому поводу ни чего, а вопрос один из самых актуальных!
Mike2024New Автор
03.11.2026 17:25Volverton, справедливое замечание. Добавлю в README, но вот реальные замеры:
Тестовый стенд (на котором проверял):
CPU: Intel Core i5 (8-го поколения) / i7-11700 (текущая).
RAM: 16 ГБ (минимум) / 64 ГБ (текущая).
GPU: NVIDIA GTX 1650 / RTX 3050 (8 ГБ VRAM).
Диск: ~10 ГБ свободного места.Скорость работы (на CPU, без GPU):
STT (Vosk small): real-time, задержка ~100–200 мс.
LLM (Gemma 3 4B, Q4_K_M): ~5–10 токенов/сек.
TTS (Silero): ~1–2 сек на фразу.
Установка: ~20 минут (зависит от интернета).С GPU (NVIDIA + CUDA):
Whisper можно переключить на medium или large — будет точнее.

Sol0Zon3
03.11.2026 17:25А есть возможность использовать свои движки для мозгов? Например указал api url и api token под /chat/completions
Ну и для озвучки тоже свое указать что-то, у меня например есть опыт генерации через omnivoice
Mike2024New Автор
03.11.2026 17:25SoloZon3, сейчас архитектура заточена под локальные модели (Gemma + Silero). Но
srv_llmиsrv_tts— это отдельные HTTP-сервисы. Технически можно добавить поддержку OpenAI-совместимого API (url + token + /chat/completions) или адаптер для другого TTS (например, omnivoice). Это в перспективе, но архитектурно заложено.

artalex
03.11.2026 17:25Очередной велосипед, который пишется клошадью ваншотом за вечер. Простите, не удержался.

bulatenkom
03.11.2026 17:25вечер? :) claude haiku делает такого за 3 минуты!!! (с аватаром, кастомизацией аватара, анимациями, эмоциями, api-ручками, чтобы другие агенты могли по mcp интегрироваться и т.д.)
Скрытый текст
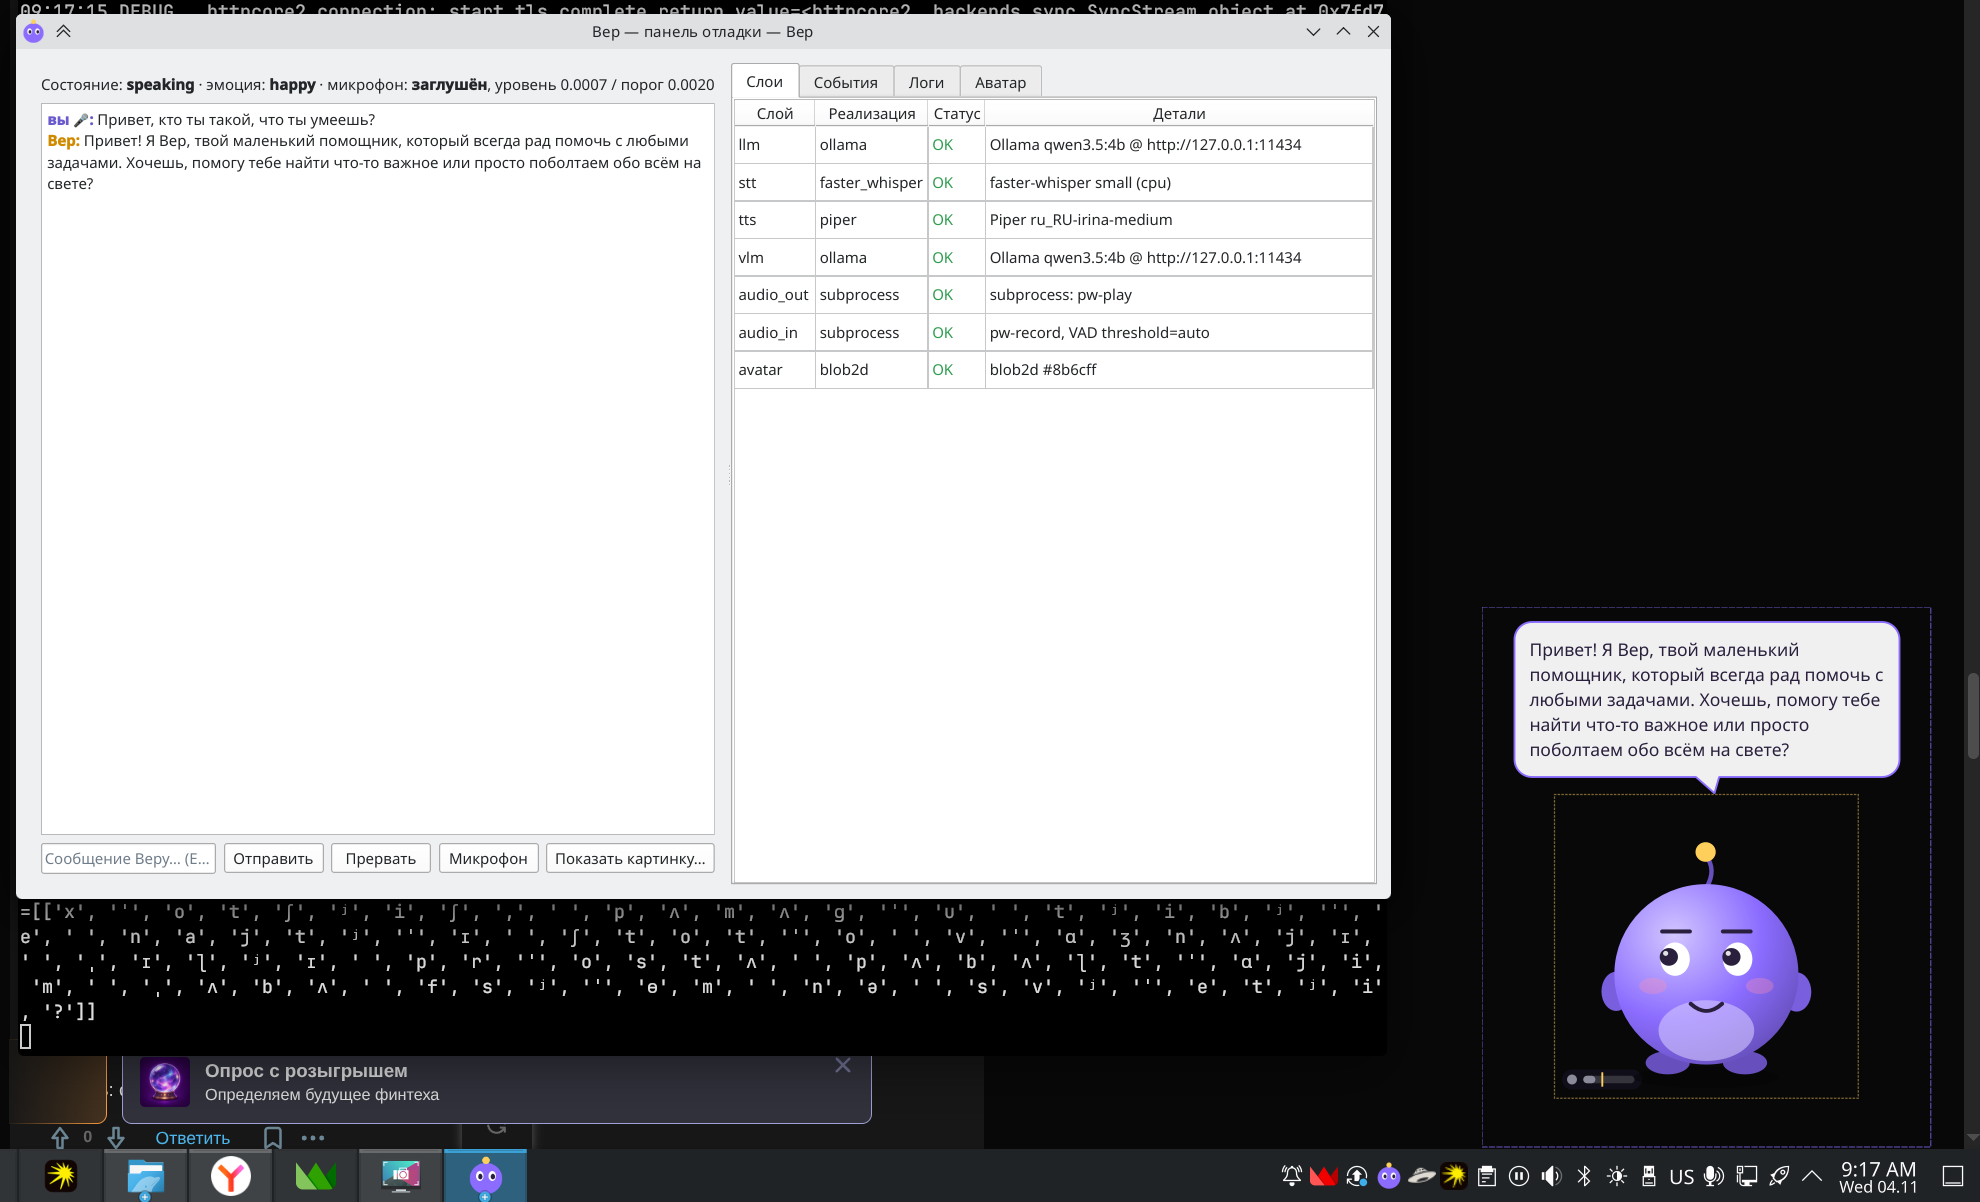
Автор статьи, если ты читаешь это сообщение, то хочу сказать тебе - молодец, что что-то пытаешься создавать и делишься этим с публикой, но ценность таких самописных мини-ассистентов около-нулевая (ими уже завален весь гитхаб, а с текущими агентами любой желающий может сгенерировать себе такого с одного промпта, и тут риторический вопрос: "что проще, найти/разобраться/установить чужого ассистента или сгенерировать своего?"). Если делать такого ассистента, то он должен чем-то выделяться или решать какую-то боль пользователя лучше других.

khomenkoev
03.11.2026 17:25Судя по отсутствию ответов и реакции, вы написали - истину. Впрочем как и большинство статей подобных. Велосипед за 3 минуты,да ещё дубликат,кому это нужно?

SkalolazOther
03.11.2026 17:25Несмотря на обилие подобных проектов на GitHub, найти их бывает непросто. Кроме того, многие могут просто не знать об их существовании. Отличная возможность скачать и протестировать функционал на практике. Спасибо автору за проделанную работу.

MarkCraft_Dev
03.11.2026 17:25Очень крутая архитектура! Отдельный респект за то, что разбил систему на изолированные компоненты по HTTP/WebSocket, а не запихал всё в один поток — с локальными LLM иначе интерфейс точно бы фризило. У меня вопрос по GUI: вы использовали
CustomTkinter, а как решили проблему с обновлением интерфейса из фоновых потоков? Запускали все сетевые запросы черезasyncioв отдельном лупе, а в UI передавали данные черезafter()?
Mike2024New Автор
03.11.2026 17:25MarkCraft_Dev, спасибо! Да, всё верно.
Сеть и LLM крутятся в отдельном потоке через asyncio.run (в отдельном loop). А из этого потока нельзя напрямую трогать tkinter — иначе интерфейс фризит или падает. Поэтому я использую after(): когда данные готовы, я через after() «перекидываю» их в главный поток, и уже там обновляю виджеты.
То есть: сеть — в фоне, UI — в главном потоке, а after() — это мост между ними.
MarkCraft_Dev
03.11.2026 17:25Понял, спасибо за подробное объяснение! Действительно,
after()— это единственный безопасный способ обновить UI из фонового потока, чтобы не было race condition сtkinter. Буду знать, полезный опыт для своих проектов

RulenBagdasis
03.11.2026 17:25❕ Без Яндекс аккаунта видео может быть не доступно, дублирую его в релизе, под названием app_ai_assistant_demo.mp4
А почему просто на ютуб не выложить? Вы же гитхаб используете, например…
windows only
Ну вот ((


aladkoi
03.11.2026 17:25Автор выбрал не русскоязычные модели. Есть решения гораздо лучше, например, gigaam от сбера, и синтез от silver. Vad тоже должен быть заточена под русскую речь.
Гораздо проще подключить навык Алисы, минимум кода . И под конкретную тематику все равно нужно пилить код с шаблонизаторами. Я себе делал голосовое управление телевизором Самсунг с тизен.

Akon32
03.11.2026 17:25Я себе делал голосовое управление телевизором Самсунг с тизен.
Но ведь в самсунгах с тизен уже есть голосовое управление?
aladkoi
03.11.2026 17:25он по русски не работает и там нет полноценного глосового управления всем видеоконтентом. У меня работает полноценно поиск по программа передач, названиям фильмов, году , медиатеке и много еще чего.

Moog_Prodigy
03.11.2026 17:25Круче гермеса сейчас нет. Плюс мега ускоренные ллм на polystrata, можно прикрутить любое платное апи для скорости, или отдельный свой сервер. То, что оно сейчас делает (и уровень рассуждений) на qwen 3.8 обгоняет даже терабайтного здорового дипсика. Написать приключенческий роман на 30 глав так, что его реально интересно читать - это вообще за гранью. А ведь оно может еще и иллюстрироать через SD. Я просто в афиге в хорошем смысле)
aladkoi
03.11.2026 17:25Из локально бесплатных лучший синтез для русского языка на сегодня это Silero TTS
Локальные, работают на своём сервере как Silero: NeuTTS, KittenTTS, Piper.
KittenTTS и NeuTTS, насколько мне известно, ориентированы на английский
В Piper, насколько я знаю, есть 4 русских голоса. По моему опыту, звучат они проще и роботизированнее, чем Silero v5.6, и ударения ставят хуже.


leolanoleg
03.11.2026 17:25Тоже 4 дня создаю Джарвиса. Тоже на 4070super 12 gb 32 ram.1 Тоже пришел путем тестов к легкой модели Gemma 4 12 B , по звуку ушел от на ts с подбором звука (стоит Максим и Жириновского сегодня поставлю) + нормализатор чисел . Из минусов скорость на пару секунд медленнее но для домашнего голосового ассистента Голос потрясающий Человеческий что не дают другие модели . Пока считает в калькуляторе тоже визуально . погодный модуль . Но по итогу на каждый модуль тратится, 1 день . Так как создать в ии got Astra легко а вот тестить и дора отка это долго и муторно. Но уже нравится. По тяжелой стоит qwen 3.5 27 B - спорт для мой системы . Я пока на легкой отрабатываю руки и голос. В общем мне нравится и думаю месяц и получится годное. Основное это конечно 12 gb gram , ну кто знал в свое время взял бы 5090 )
janvarev
Раз уж поднялась такая тема, рискну напомнить, что уже года 3 на Гитхаб лежит мой расширяемый опенсорс голосовой помощник Ирина (offline first, 1К звезд) с кучей статей на Хабре (вот последняя).
Кому надо - также велкам.
TheRaven
Запилите прошивку под яндексстанцию как клиента + сервер с мозгами, будет прям оч хорошо на мой взгляд.
janvarev
Это ОПЕНСОРС, поэтому у вас есть ПРАВО на самостоятельную модификацию программы.
Спасибо за ваше внимание к этому вопросу! (с) /s
Mike2024New Автор
Спасибо, посмотрю. Интересно сравнить подходы