

Универсальное FIFO для широкого круга задач на FPGA. Как правильно его организовать, что оно должно уметь и какие требования к нему предъявлять. Подробно – с постановкой задачи, разбором внутренней структуры, временными диаграммами и примерами кода. Пакеты произвольной длины, перенос кода между различными ПЛИС и никаких зависимостей!
Вступление
Почему я решил сделать своё собственное универсальное FIFO? Казалось бы, ведь есть готовые IP-ядра от вендоров – бери и используй. Зачем создавать очередной велосипед? Но лично для меня в применении готовых ядер есть две принципиальные и неустранимые проблемы. Во-первых, не получится просто взять и использовать. Придется реализовывать для этого FIFO дополнительную обвязку. И скорей всего для очередной задачи каждый раз заново. То есть IP от вендоров – это лишь полуфабрикат. Во-вторых, что самое неприятное для меня, я не смогу свободно переносить это FIFO между ПЛИС различных производителей. И значит любой мой модуль или алгоритм становится привязан к вендору. Как-то совсем не универсально выходит... А я хочу именно брать и использовать, и больше не думать ни о чем! :)
И вот несколько лет назад на одном из рабочих проектов у меня появилась задача (и время) для которой я мог заняться созданием именно такого FIFO. И я приступил.
1. Функциональные требования. Или что вообще должно уметь FIFO?
Прежде чем начать что-либо проектировать, даже не говоря про написание кода, нужно понять, что же вообще я хочу. Сформулировать набор функциональных требований. Список того, что должен выполнять разрабатываемый модуль. Здесь важно разделить понятия «что» и «как». Только после понимания того «что» он должен делать, можно приступать к тому «как» это реализовать.
Ниже – набор основных функциональных требований, которые я поставил перед собой:
Общие требования:
FIFO должно быть полностью асинхронным, то есть уметь работать с двумя тактовыми сигналами, имеющими физически разные источники.
Глубина памяти должна быть настраиваема перед синтезом. Причем не обязательно только степень двойки.
-
Иметь возможность задать перед синтезом ширину шин данных для входа и выхода (1, 2, 4, 8, 16, 32 байта). Причем данная настройка должна быть независима как для стороны записи (вход), так и стороны чтения (выход). То есть ширины чтения и записи могут не совпадать и иметь различные значения из указанных выше.
Здесь кратко поясню. В большинстве реальных задач разрядности входов и выходов совпадают редко. Например, при работе с видео у меня был входной поток 16 бит на пиксель (2 байта). А после обработки его требовалось передать по Ethernet – 1 байт для gmii/rgmii или 8 байт для xgmii.
-
Работа FIFO должна быть пакетной. Причем пакеты могут быть произвольной длины, даже некратной ширине обеих шин.
Этот пункт крайне важен. В большинстве инженерных задач базовой единицей информации является не байт и не слово данных, а именно пакет. Например, видео- или IP-пакеты. И следовательно, «принцип FIFO», то есть «первым пришел, первым ушел», должен осуществляться именно на уровне пакета целиком. Более того, во многих случаях пакет должен передаваться непрерывно, единым целым. Невозможно передать на монитор только часть видеостроки, а затем сделать паузу и ждать второй части. Строку нужно передавать сразу и без разрывов. А это возможно только если FIFO внутри себя будет знать, где одна строка отделяется от другой. То есть FIFO должно уметь выделять пакеты как единое целое.
Требования к записи:
-
Запись пакетов должна быть возможна частями (кратными ширине шины записи), то есть с паузами в произвольное количество тактов в произвольный момент.
Этот пункт указывает, что FIFO обязано уметь подстраиваться под того, кто в него пишет. Именно писатель сам выбирает удобный для себя темп работы, и FIFO должно работать с его скоростью.
-
Должно иметь настройку максимальной длины пакета для записи. И самостоятельно отбрасывать пакет, если его длина превышает установленную максимальную.
На первый взгляд кажется, что данное требование противоречит предыдущему, что FIFO не должно указывать писателю. Но на самом деле суть этого требования в защите от «спама». Если по каким-либо причинам в пишущем модуле произошел сбой, и он начал выдавать пакеты превышающие глубину FIFO, то отбросив такие пакеты, FIFO защитить себя от переполнения, от «зависания».
-
FIFO должно уметь самостоятельно отбросить записанный пакет если этот пакет был помечен писателем в момент записи как невалидный.
Пункт кажется неочевидным, но введен в результате практического опыта применения FIFO. В одном из проектов в FIFO записывались пакеты (фреймы) с шины xgmii. В процессе работы иногда возникали аппаратные сбои на шине. На такт появлялся байт ошибки – «FE» внутри фрейма. И фактически в этот момент фрейм становится невалидным, а его запись бессмысленной. Самый логичный вариант –отбросить фрейм.
-
Должно информировать пишущий модуль о наличие свободного места и о том, хватит ли этого места для записи пакета максимальной длины. Если закончилось место в FIFO, но при этом писатель продолжает передавать данные, то FIFO не должно «сломаться». Оно должно игнорировать эти данные, по завершении пакета отбросить его и вернуться к штатной работе.
Фактически – это часть внутреннего механизма защиты FIFO от переполнения независимо от поведения писателя. То есть FIFO не должно «сломаться» если писатель начнет творить всякую дичь.
Требования к чтению:
Выдача пакета должна быть строго по запросу стороны которая читает.
-
При выдаче пакета FIFO должно устанавливать в конце пакета признак-указатель на последний байт пакета внутри слова данных в тот момент, когда этот байт выдается.
Это требование для удобства читателя. Что бы он явно видел конец пакета, и ему бы не приходилось самостоятельно его искать.
-
FIFO должно приостановить выдачу пакета, если читающее устройство поставило признак паузы, и продолжить выдачу пакета, когда признак паузы снялся.
Крайне важное требование. Снова из практики. Этот механизм паузы позволяет организовать FIFO как ‘slave’ для читателя. Почему это принципиально? Например, читатель берет пакет из FIFO и передает его на SDRAM. А что делать, если в середине пакета нужно поменять адрес строки (ROW) или переключить банк (BANK) памяти? Это означает, что поток данных на память нужно прервать, выполнить переключение, а затем продолжить. FIFO должно уметь ждать, а не пихать данные когда читатель физически не может их принять.
-
Должно иметь возможность перейти к выдачи следующего пакета, если читающий модуль не хочет принимать очередной пакет. То есть FIFO должно выполнять команду пропуска пакета по требованию читателя.
Можно это назвать требованием «со звездочкой». Пока этот механизм я нигде не использовал на практике, но мне показалось, что он будет полезным при организации фрейм-буфера. Его я ввел для себя недавно, когда понял, что реализовать этот механизм будет достаточно просто, и при этом не нужно ничего значительно менять в работе FIFO.
Дополнительные требования:
FIFO должно иметь механизм инициализации после сброса. Причем нужно обрабатывать сброс по обоим портам. При сбросе по порту записи, если в этот момент FIFO выдает пакет на чтение – этот пакет должен быть полностью выдан потребителю.
FIFO должно быть аппаратно независимым (не быть привязано к ПЛИС конкретных производителей).
На самом деле все эти требования взялись не одномоментно, а были следствием необходимости решать реальные инженерные задачи. Функционал FIFO расширялся и до сих пор расширяется от проекта к проекту.
Если обобщить всё это многобуквие прям-таки совсем кратко: я вижу универсальное FIFO как законченное IP-ядро, черный ящик с несколькими настройками. И уже точно не конструктором который мне придется пересобирать или править, дописывая и меняя код под каждую новую задачу.
Но писать свои хотелки о том как что-то должно работать – в этом ничего сложного нет. Пальцы есть, клавиатура есть – шлепай по клавишам и шлепай! Интернет и не такое терпел :)
Лучше перейти к описанию того, как я эти функциональные требование реализовал, и что получилось в итоге.
2. Внутренняя структура
Начинать проектирование любого устройства или модуля всегда нужно с его структуры. Вот такой в итоге она получилась для FIFO:
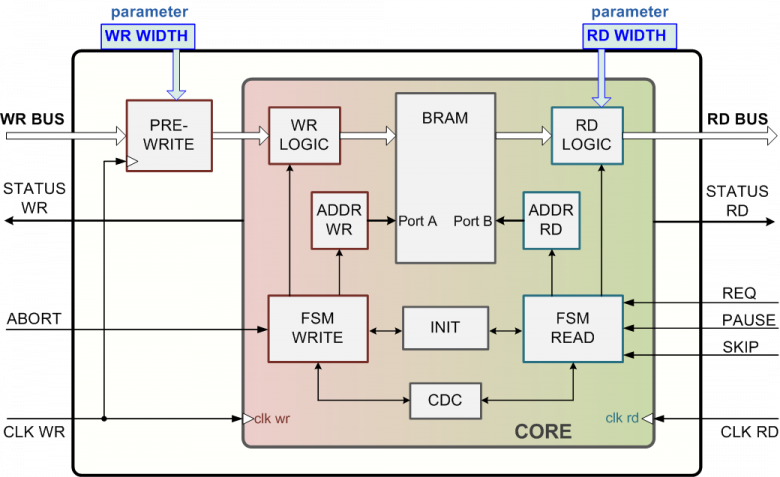
Основная часть FIFO – это ядро «CORE». Оно состоит из двух клоковых доменов, каждый из которых тактируется своим независимым клоком – clk_wr и clk_rd. Управляют доменами два отдельных конечных автомата («FSM WRITE» и «FSM READ»). Само собой есть два независимых счетчика-указателя адресов («ADDR WR» и «ADDR RD»). И набор различной логики («WR LOGIC» и «RD LOGIC»), которая состоит из счетчиков, мультиплексоров, регистров, компараторов и прочих элементов.
Внутри ядра присутствует блок инициализации «INIT», обнуляющий всё содержимое блочной памяти «BRAM» после снятия сбросов. И наборы триггеров для переноса управляющих сигналов между доменами.
В данной реализации ширина слова памяти фиксирована и равна 32-м байтам. Глубина памяти настраиваема. Задается в байтах, автоматически округляется до значения кратного 32 (кратного ширине слова памяти).
Вне ядра расположен отдельный небольшой модуль «PRE-WRITE», преобразующий входную шину «WR_BUS» к разрядности слова памяти. Обратное преобразование разрядности (слово памяти à выходная шина «RD_BUS») выполняет модуль «RD LOGIC» внутри ядра.
Описание верхнего уровня модуля FIFO:
entity bufring is
	 Generic (
		FIFO_BYTES		: positive;
		MAX_PACK_BYTES	: positive;
		WR_DATA_PWR	: natural range 0 to 5;
		RD_DATA_PWR	: natural range 0 to 5
	 );
    	Port  (
		--------  WR  --------
		---- sys
		clk_wr			: in std_logic;
		n_arst_wr		: in std_logic;
		srst_wr			: in std_logic;

		---- Входные пакеты
		data_in			: in array_vector8(2**WR_DATA_PWR-1 downto 0);
		ce_data_in		: in std_logic;
		ce_lb_in		: in std_logic;
		lb_ptr_in		: in unsigned(WR_DATA_PWR-1 downto 0);
		extra_in		: in array_vector8(23 downto 0);
		abort_pack		: in std_logic;
		--
		status_wr		: out std_logic_vector(15 downto 0);

		--------  RD  --------
		---- sys
		clk_rd			: in std_logic;
		n_arst_rd		: in std_logic;
		srst_rd			: in std_logic;

		req_data		: in std_logic;
		req_pause		: in std_logic;
		req_skip		: in std_logic := '0';
		--
		data_out		: out array_vector8(2**RD_DATA_PWR-1 downto 0);
		rts_out			: out std_logic;
		ce_data_out		: out std_logic;
		ce_lb_out		: out std_logic;
		lb_ptr_out		: out unsigned(RD_DATA_PWR-1 downto 0);
		pack_bytes_out		: out unsigned(15 downto 0);
		extra_out		: out array_vector8(23 downto 0);
		--
		status_rd		: out std_logic_vector(15 downto 0)
	);
* type array_vector8 is array(natural range <>) of std_logic_vector(7 downto 0);
3. Как записать в FIFO
Так как FIFO пакетное, то логично, что запись в него осуществляется пакетами. Размер их может быть произвольным – от 1-го байта до 64-х килобайт (а если точнее 65’535 байт). Вообще-то такой размер выбран несколько произвольно, и сейчас мне он кажется излишним. Думаю, можно убавить его до 16’383-х байт, чего вполне хватит для Jumbo-фреймов. Это в свою очередь уменьшит внутренние компараторы, что поможет немного поднять fmax (особенно важно для домена RD).
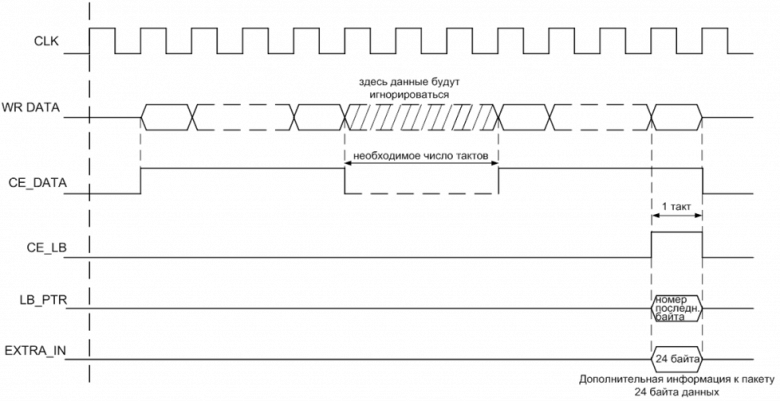
Шина записи достаточна проста. Клок, данные, разрешение данных (валидность). Плюс два дополнительных сигнала – признак наличия последнего байта «CE_LB» и указатель на него «LB_PTR». Про указатель – чуть позже.
Также шина имеет еще один дополнительный вход «EXTRA_IN». Сам по себе он не обязателен для работы и его можно игнорировать. Но этот сигнал очень полезен. «EXTRA_IN» позволяет записать дополнительно 24 байта метаданных к пакету. Например, если мы говорим о сетевом пакете, то туда влезет два MAC-адреса (12 байт) и два IP-адреса (8 байт), да еще 4 байта для TCP/UDP портов останется. И вся прелесть в том, что эти метаданные будут доступны на стороне RD сразу по готовности пакета к чтению (в момент установки на него указателя «ADDR RD»). То есть читатель будет видеть их еще даже до подачи запроса «REQ». Кто-то скажет – мелочь, а мне удобно. Не нужно самостоятельно пихать заголовки в тело пакета, за меня это сделает FIFO. Люблю когда мою работу выполняет кто-то другой! :)
И возвращаясь к указателю последнего байта («LB_PTR»). Он как раз и позволяет работать модулю FIFO с пакетами произвольной длины.
И возвращаясь к указателю последнего байта («LB_PTR»). Он как раз и позволяет работать модулю FIFO с пакетами произвольной длины.
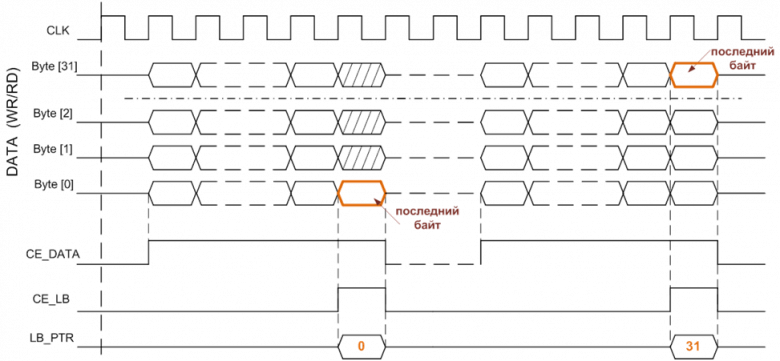
Сигнал «LB_PTR» содержит номер последнего байта в последнем слове на шине данных. Нумерация начинается с 0. Писатель может поставить это значение в любе время, но FIFO смотрит на него только при приходе «CE_LB». Само собой «CE_LB» и «LB_PTR» считываются только при высоком уровне сигнала валидности данных «CE_DATA». Иначе было бы совсем не логичным пытаться указать на последний байт в тот момент, когда он попросту не существует на шине.
Само значение указателя последнего байта вычисляется по простой формуле:
(Pack_len-1) mod BUS_WIDTH
Например, шина данных имеет ширину BUS_WIDTH = 32 байта. И я хочу передать по ней несколько пакетов с различными длинами Pack_len, равными: 1 байт; 52 байта; 128 байт. Тогда для этих пакетов указателями на последний байт будут значения: 0; 19; 31.
Так как ширина шины задается еще до синтеза, то значение «BUS_WIDTH» из формулы – это константа (причем всегда степень двойки). Следовательно, вычисление значения указателя не требует никаких накладных расходов. Это просто взятие младших битов из регистра длины пакета (или счетчика) с последующим вычитанием единицы.
Ну а чтобы мне не приходилось много думать, то количество бит необходимых для передачи указателя «LB_PTR», я определяю автоматически исходя из разрядности шины.
entity bufring is
	Generic (
		. . .
		WR_DATA_PWR	: natural range 0 to 5; 	-- 0 - 1; 1 - 2; 2 - 4; 3 - 8 байт и т.д...
		RD_DATA_PWR	: natural range 0 to 5; 	-- 0 - 1; 1 - 2; 2 - 4; 3 - 8 байт и т.д...
		. . .
	 );
	Port  (
		. . .
		data_in		: in array_vector8(2**WR_DATA_PWR-1 downto 0);
		lb_ptr_in	: in unsigned(WR_DATA_PWR-1 downto 0);

		. . .

		data_out	: out array_vector8(2**RD_DATA_PWR-1 downto 0);
		lb_ptr_out	: out unsigned(RD_DATA_PWR-1 downto 0);
		. . .
	);
Благодаря этому я никак не смогу задать значение указателя, превышающее ширину шины. В противном случае компилятор выдаст ошибку, защитив меня от моей невнимательности.
4. И как теперь прочитать записанное
Естественно, что чтение данных из FIFO также производится пакетами. Поднимая сигнал «PRSNT», FIFO информирует читателя о наличии пакета. Но его выдача начнется только после запроса «REQ» от читателя. Он может выставлять сигнал запроса когда угодно, или даже держать его всё время высоким, ограничений нет.
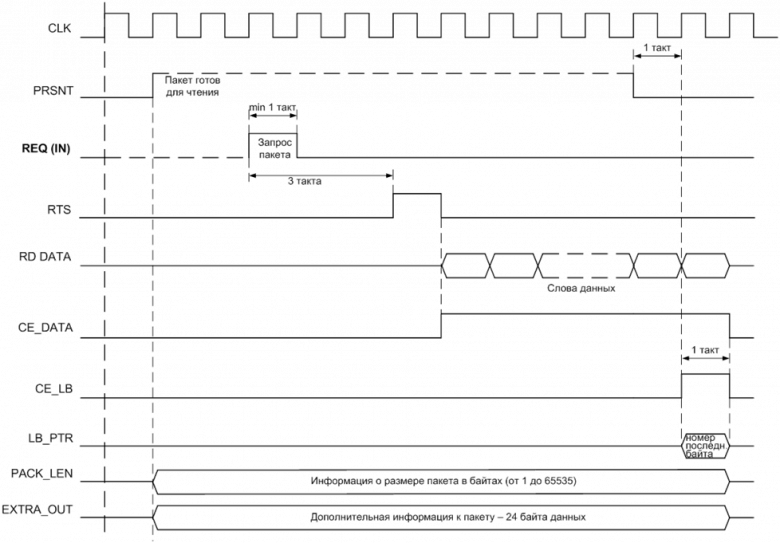
Если пакет готов для чтения, то внутренний автомат «FSM READ» перейдет в режим выдачи сразу после обнаружения сигнала запроса «REQ». Строго через три такта после запроса, FIFO выставляет сигнал «RTS» ровно на один такт. Тем самым сообщая читателю, что следующими тактами начнут передаваться данные.
В принципе сам сигнал «RTS» сугубо вспомогательный. Но я ввел его для удобства. Во-первых, с ним читателю не нужно гадать, когда появятся данные (хотя я строго зафиксировал 3+1 такта после запроса, но вдруг в будущем захочу это поменять, тогда «RTS» всё равно останется универсальным признаком начала). Во-вторых, читателю может оказаться нужным сбросить свои внутренние счетчики или регистры перед началом очередного пакета. И «RTS» как раз хорошо подойдет для этого.
В общем случае, если читатель не выставляет запросы паузы («PAUSE»), то выдача пакета непрерывна. Слова данных подсвечивает сигнал «CE_DATA». Последний байт определяется комбинацией сигналов «CE_LB» и «LB_PTR». Тут всё в точности то же самое, что и для записи – полное единообразие.
Кроме основных сигналов я ввел два вспомогательных. Первый – это длина пакета в байтах «PACK_LEN». Второй – метаинформация «EXTRA_OUT», добавляемая к пакету еще на стороне записи. Оба этих сигнала выставляются одновременно с признаком готовности «PRSNT», еще до запроса от читателя. Это оказалось весьма удобным. Не читая сам пакет, мне как читателю уже известна полная его длина и дополнительная информация. Особенно это полезно при работе с сетевыми пакетами. Например, формирователь IP-пакетов сможет сразу добавлять длину в заголовок.
И теперь про обработку запросов паузы. В любой момент читатель может потребовать от FIFO приостановить выдачу данных на произвольное количество тактов. Для этого он выставляет сигнал «PAUSE». Увидев его, FIFO на следующем такте опускает сигнал «CE_DATA» и перестает изменять данные на выходе «RD DATA». Когда читатель снимает запрос паузы, то FIFO возобновляет выдачу данных на выход «RD DATA» и поднимает «CE_DATA».
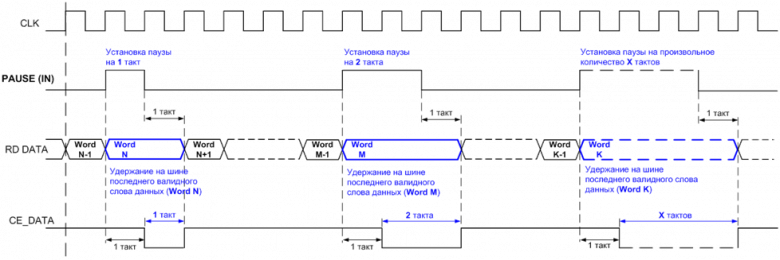
Запросы паузы можно устанавливать неограниченное число раз внутри одной передачи. Количество тактов между запросами также любое.
Еще хочу обратить внимание на механизм удержания слова данных на шине. Его я постарался сделать как можно более универсальным. Слово данных остается полностью неизменным в течение всей длительности сигнала «PAUSE» и плюс еще один такт. Это позволяет прочитать данные либо на первом такте паузы, либо уже после снятия запроса «PAUSE». Читатель сам определяет, когда ему это делать удобнее.
И подводя итог по механизму чтения. Я целенаправленно спроектировал и реализовал его таким образом, чтобы чтение было удобно принимающей стороне. Только по запросу читателя начинается выдача пакета. И только он управляет темпом передачи. Именно FIFO подстраивается под возможности читателя, но не наоборот.
5. А что же там внутри?
Теперь подробно про то, как выполняется работа с пакетами внутри. В ядре FIFO имеется буфер на основе блочной памяти. Логически он организован в виде кольца. В этот кольцевой буфер, кроме непосредственно данных передаваемых писателем, добавляется еще и служебная информация:
– размер пакета (в байтах);
– порядковый номер пакета (ID);
– признак начала пакета;
– указатель на последний байт в пакете;
– дополнительные биты для выполнения команды «SKIP»
Суммарно – это 8 байт. А так как ширина слова памяти выбрана равной 32 байта, то остаются свободными еще 24. Вот как раз туда и записывается пользовательская метаинформация со входа «EXTRA_IN».
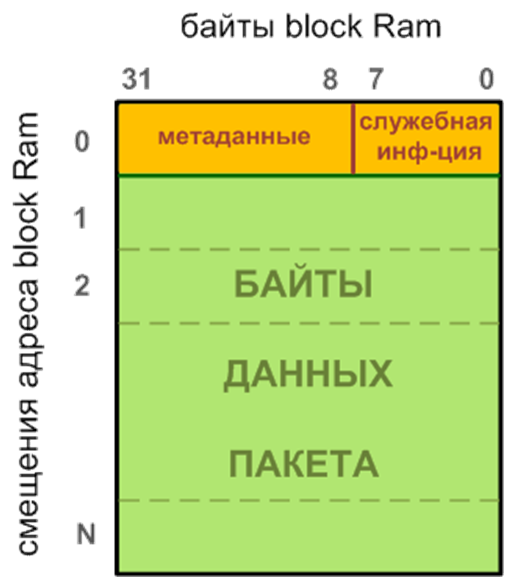
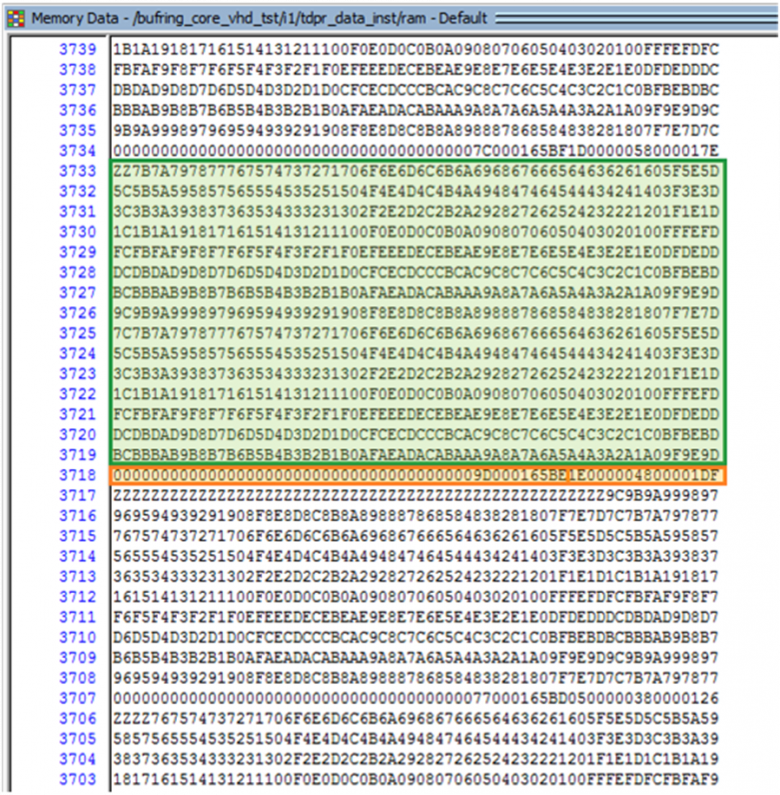
А вот так выглядит положение пакета в памяти при моделировании. Здесь из-за того что адреса возрастают снизу вверх, пакет визуально перевернут.
Хотя служебная информация расположена в начале пакета, но записывается она только после завершения приема всех байтов данных. То есть перед записью очередного пакета, указатель «ADDR WR» смещен на один адрес вперед относительно первого свободного адреса буфера. Когда писатель передает слова данных, то указатель «ADDR WR» последовательно увеличивается, а в самом конце делает возврат на адрес, зарезервированный для служебной информации.
Затем, после записи этой информации и метаданных, указатель перемещается вперед на второй свободный адрес относительно последнего слова только что записанного пакета. И цикл записи повторяется. Само собой, что все перемещения указателя – это с учетом закольцованности адресного пространства.
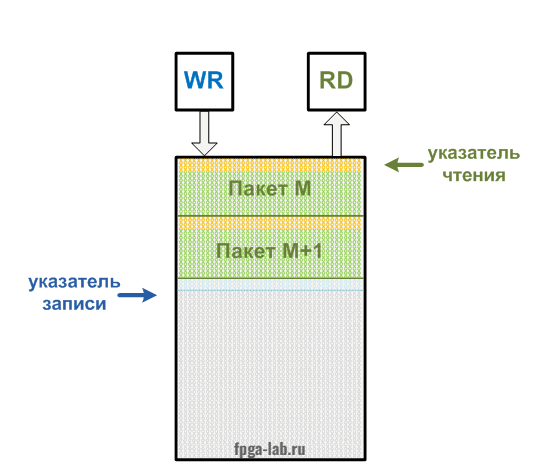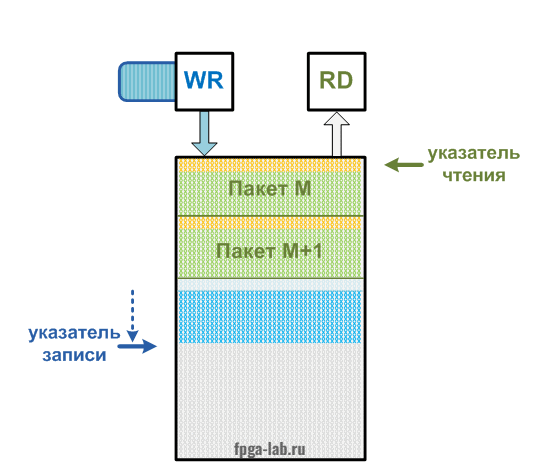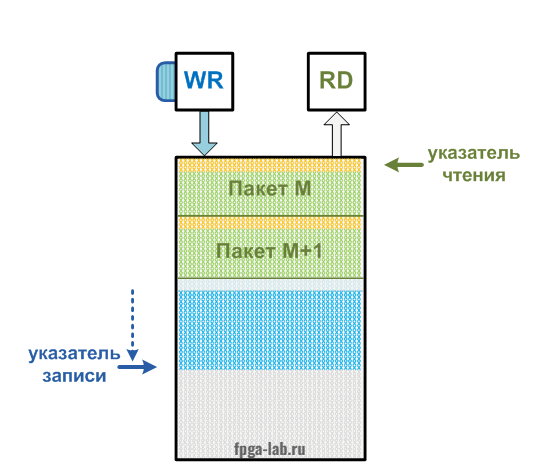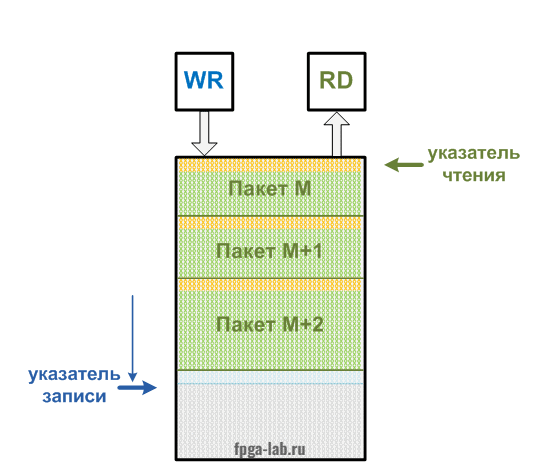
Теперь про чтение пакета. Оно происходит следующим образом: изначально указатель «ADDR RD» стоит на первом непрочитанном адресе кольцевого буфера. Обнаружив (при готовности пакета) по этому адресу заголовок, автомат чтения извлекает из него служебную информацию. В ней содержится размер пакета «Pack_len», который сохраняется в регистре. Одновременно с этим выставляется выходной сигнал «PRSNT». Теперь, как только читатель даст запрос «REQ», указатель «ADDR RD» начнет последовательно увеличиваться. Он пройдет количество значений, равное:
RoundUP(Pack_len / RD_WIDTH)
После того, как все байты пакета будут прочитаны, указатель чтения возвращается назад – на адрес заголовка. И очищает его, записывая нули. Затем указатель «ADDR RD» перемещается на первый непрочитанный адрес, и остается на нем в ожидании готовности очередного пакета.
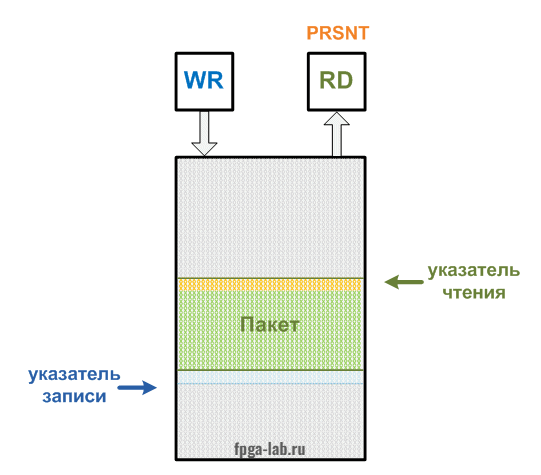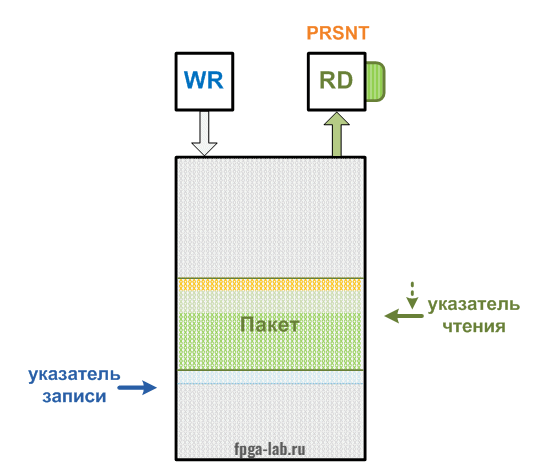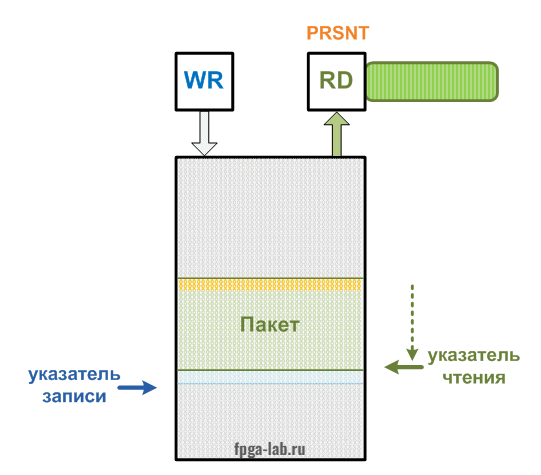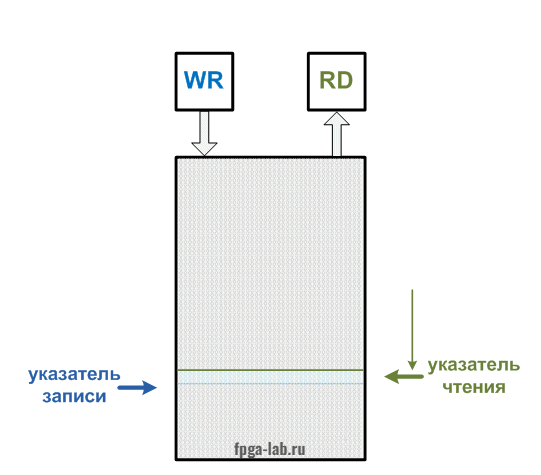
Очевидно, что при такой организации работы указателей, невозможно использовать код Грея для передачи адресов между клоковыми доменами. Поэтому вместо них передается информация о заполненности.
Адресное пространство FIFO логически разделено на несколько диапазонов, каждый из которых имеет свой флаг «FULL». Установленный флаг – это запрет для записи в соответствующий диапазон. Тем самым обеспечивается невозможность повторной записи в еще непрочитанные адреса.
Работа с «FULL» осуществляется следующим образом. Регистр флагов расположен в домене WR. Когда производится запись в последний адрес диапазона, то соответствующий бит для него устанавливается в ‘1’:
process(clk_wr, n_arst_wr)
begin

. . .
	for i in 0 to FIFO_LABEL_NUM-1 loop

		if rst_full_label(i) then
			full_label(i) <= '0';
		elsif set_full_label(i) then
			full_label(i) <= '1';
		end if;

	end loop;
. . .

end process;


process(all)
begin

for i in 0 to FIFO_LABEL_NUM-1 loop

	--set
	if (ram_we = '1' and addr_wr = (i+1)*WR_MEM_DEPTH/FIFO_LABEL_NUM-1) then
		set_full_label(i) <= '1';
	elsif (except_info_addr_wr(i) and ram_we) then
		set_full_label(i) <= '1';
	else
		set_full_label(i) <= '0';
	end if;

end loop;

rst_full_label <= rst_full_label_rd_ff(rst_full_label_rd_ff'length-1) or tmp_full_label;

end process;
А вот снятие признака «FULL» производится из домена RD. Причем сигнал сброса для него формируется не в момент чтения последнего адреса диапазона, а только при завершении чтения всего пакета целиком:
process(clk_rd, n_arst_rd)
begin

. . .

for i in 0 to FIFO_LABEL_NUM-1 loop

	-- Предварительный сигнал сброса для меток
	if (rst_tmp_label_rd) then
		tmp_rst_label_rd(i) <= '0';
	else
		if ((ce_cnt_addr_rd = '1' or ce_bytes_to_read = '1') and
             addr_rd = (i+1)*RD_MEM_DEPTH/FIFO_LABEL_NUM-1) then
			tmp_rst_label_rd(i) <= '1';
		end if;
	end if;

	-- сброс (сигнал на снятие меток)
	if (not full_label_ff(full_label_ff'length-1)(i)) then
		rst_full_label_rd(i) <= '0';
	elsif (read_data_ok) then
		if (addr_rd = (i+1)*RD_MEM_DEPTH/FIFO_LABEL_NUM-1) then
			rst_full_label_rd(i) <= '1';
		else
			rst_full_label_rd(i) <= tmp_rst_label_rd(i);
		end if;
	elsif (skip_cmd) then
		rst_full_label_rd(i) <= skip_label_vect(i);		--отдельно для SKIP
	end if;

end loop;

. . .

end process;
Каждый бит для флага «FULL» и сигнал для его сброса передаются между клоковыми доменами через цепочку из нескольких последовательных триггеров. Здесь тоже параметризация. Количество триггеров задается константой CROSS_DOMAIN_NUM.
-- количество триггеров
constant CROSS_DOMAIN_NUM	: positive := 3;

--тип для меток ФИФО
subtype label_t		is std_logic_vector(FIFO_LABEL_NUM-1 downto 0);
--тип для передачи меток фифо между доменами
type label_arr		is array(CROSS_DOMAIN_NUM-1 downto 0) of label_t;

signal full_label_ff, rst_full_label_rd_ff		: label_arr;

. . .
. . .

---- Переход из WR в RD
process(clk_rd, n_arst_rd)
begin

. . .
full_label_ff <= full_label_ff(full_label_ff'length-2 downto 0) & full_label;
. . .

end process;


---- Переход из RD в WR
process(clk_wr, n_arst_wr)
begin

. . .
rst_full_label_rd_ff <= rst_full_label_rd_ff(rst_full_label_rd_ff'length-2 downto 0) & rst_full_label_rd;
. . .

end process;
И небольшое замечания про передачу флагов. Можно заметить, что имеется обратная связь: WR (флаг) –> RD (сигнал сброса) –> WR (снятие флага) –> RD (снятие сброса) –> WR (завершение сброса). Она накладывает ограничение на соотношение частот Fwr и Frd. А именно, Frd должна быть не меньше чем:
Fwr / (FIFO_BYTES/32) / (FIFO_LABEL_NUM * CROSS_DOMAIN_NUM)
Например, для FIFO_BYTES = 65536, FIFO_LABEL_NUM = 12 и CROSS_DOMAIN_NUM = 3, и при Fwr = 350 МГц – Frd должна быть не меньше чем:
350 / (65536/32) / (12*3) = 6,15 МГц
В принципе, само это ограничение можно легко убрать, замаскировав сигнал на сброс флага в домене WR после непосредственно самого факта прихода этого сигнала в указанный домен. Но на практике, я никогда не достигал ограничения на отношение частот в реальных проектах.
Когда я заканчивал данную главу, у меня появилась идея как оптимизировать работу с указателями. Если обнулять заголовок еще перед началом чтения, то получится избежать возврата указателя адреса «ADDR RD». Это сэкономит один такт при чтении, и позволит освобождать диапазоны, не дожидаясь окончания чтения всего пакета. Надо будет проверить это на модели…
6. Кратко о прочих возможностях
6.1 Отбросить пакет еще при записи
В любой момент во время записи пакета, писатель может 'отменить' его, выставив сигнал «ABORT». Обнаружив этот сигнал, FIFO переходит в специальный режим. Оно перестает записывать данные пакета и просто ожидает его окончания (сигнал «CE_LB»). После завершения пакета, FIFO возвращает свой внутренний указатель памяти «ADDR WR» к исходному значению, которое было до начала записи. Таким образом, пакет считается отброшенным, не занимает место в блочной памяти и не существует для читателя.
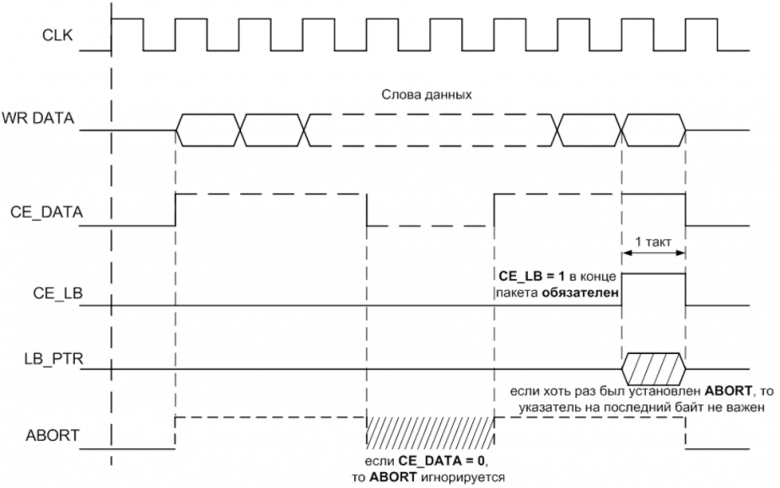
Сигнал «ABORT» может быть подан писателем на FIFO в любой удобный ему момент, даже на последнем слове. Для активации режима 'отмены' достаточно установки «ABORT» хотя бы на 1 такт вместе с сигналом «CE_DATA». После этого он защелкивается внутренней логикой FIFO.
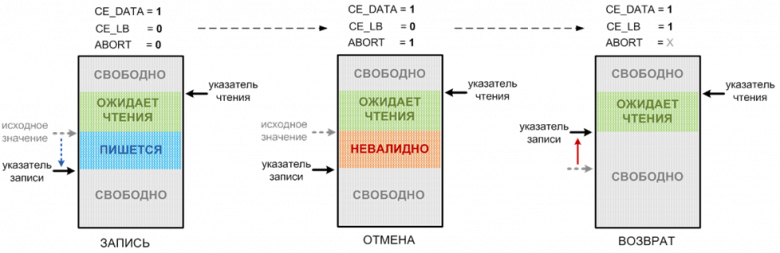
Когда я добавлял механизм отбрасывания, то основная идея была в следующем: не переносить логику принятия решения о валидности/невалидности пакета на сторону чтения. То есть читателю не придется утруждать себя дополнительным анализом. Если FIFO предоставляет ему пакет – он точно не 'битый'. Бери и читай.
6.2 Пропустить пакет не читая
А что если по каким-либо причинам читатель не хочет «брать и читать»? Например, увидев метаинформацию к уже готовому для выдачи пакету, он понимает, что пакет этот ему не нужен? Для такого варианта я ввел механизм пропуска пакетов. В любой момент до начала чтения читатель может установить сигнал «SKIP», сообщая FIFO об отказе от очередного пакета.
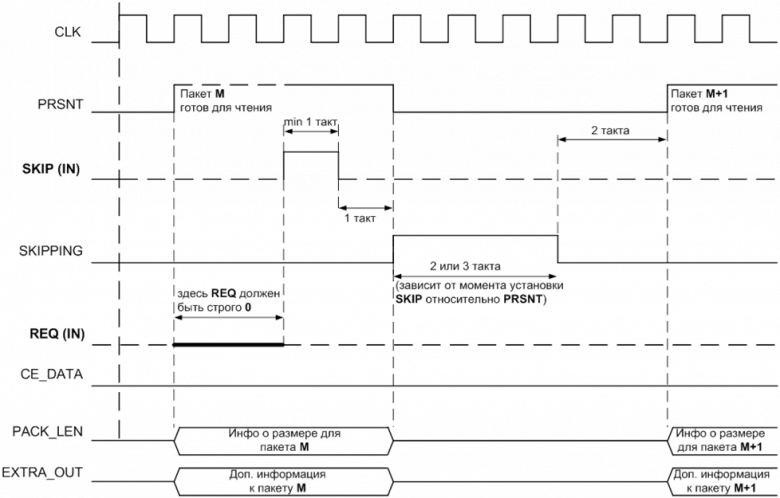
Через один такт после установки читателем сигнала «SKIP», FIFO снимает готовность «PRSNT», и одновременно устанавливает сигнал «SKIPPING». Он держится не более трех тактов, затем опускается, информируя читателя о завершении пропуска пакета. После чего, если внутри FIFO имеются уже готовые для чтения пакеты, то через 2 такта устанавливается сигнал готовности «PRSNT» для следующего пакета. Читатель может прочитать его командой «REQ», или же пропустить командой «SKIP».
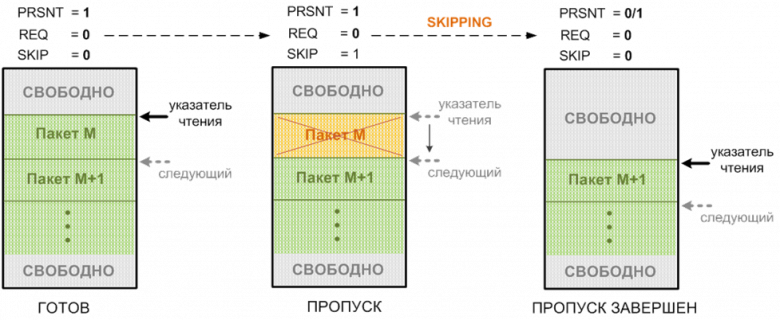
Удобство данного режима – это экономия времени. Если ненужный пакет имеет значительный размер, например 1024 байта, то для его чтения даже по 32-х байтной шине потребуется 1024/32 = 32 такта. А если пакет 4 килобайта, а шина шириной лишь один байт – то это уже 4096 периодов клока. Значительные потери времени и быстродействия. При этом, используя механизм «SKIP», пропуск любого пакета займет не более 7 тактов. Не придется гонять бесполезные данные вхолостую.
6.3 Инициализация – без неё нельзя
А нельзя по простой причине – информация о границах пакетов хранится вместе с данными. В общем случае, при включении питания, в блочной памяти внутри FIFO могут оказаться произвольные значения. Что с некоторой вероятностью приведет к сбою в логике указателей. Дабы избежать сбоев, нужно принудительно обнулить все адреса. То же самое справедливо и при приходе внешних ресетов. Они сбрасывают все регистры и триггеры внутри FIFO, но не очищают память. В ней сохранятся прежние уже невалидные данные, которые необходимо удалить.
Внутри FIFO за инициализацию отвечает отдельный модуль «INIT». Процесс этот состоит из нескольких этапов:
– На первом – очищается содержимое блочной памяти. По всем адресам записываются нулевые значения.
– Далее указатели записи и чтения устанавливаются в начальные значения.
– Затем оба FSM подтверждают друг для друга завершение процесса инициализации.
– И в заключении, FIFO выставляет внешний сигнал «READY», информируя о своей готовности к приему пакетов.
В процессе работы FIFO каждый FSM отслеживают состояние другого. Когда один из доменов приходит внешний ресет, то автомат второго обнаруживает это. Домен, в котором не было сброса, переводится в состояние подготовки к инициализации.
Если сброс произошел в домене WR, то домен RD сначала завершает текущие операции. В случае, когда он выдает пакет читателю, пакет выдается целиком до конца, и только затем домен RD переходит в состояние инициализации. То же самое справедливо и для автомата WR. Он всегда дожидается окончания записываемого в него пакета. И только когда пакет закончен, приступает к инициализации.
6.4 Защита от переполнения
В процессе работы FIFO сообщает внешним модулям о своей заполненности при помощи выходных сигналов статуса. Но всегда есть вероятность, что писатель эти сообщения проигнорирует. И будет пытаться впихивать данные, когда свободного места для них больше нет. И я не хочу чтобы FIFO при этом сломалось. Пришлось сделать обработку такого варианта развития событий, добавить внутреннюю защиту от переполнения.
При нехватке свободного места для записи очередного слова данных, автомат «FSM WRITE» переходит в специальное состояние. В этом состоянии все входные данные игнорируются. Также выставляется выходной сигнал «IGNORE», сообщающий писателю, что запись для текущего пакета больше не производится. При завершении пакета он будет отброшен. После чего, указатель записи вернется в исходное положение. Затем «IGNORE» снимается и FIFO становится снова готовым к приему.
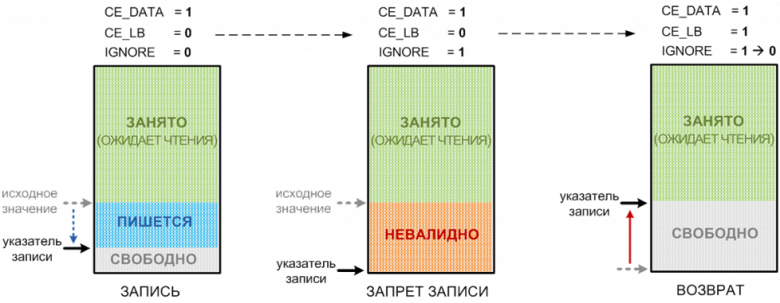
К сожалению, в нашей жизни всегда остается вероятность, что пойдет что-то не по плану. И даже защищенное FIFO вдруг может переполниться. Я отслеживаю и это. В таком случае выставляется выходной сигнал «FIFO_ERR». Тут уж ничего не поделать – внешнему наблюдателю останется только сбросить FIFO.
Но на практике я такого сигнала в своих проектах не наблюдал, всё еще впереди...
6.5 Информация и статистика
В предыдущих разделах я упоминал различные сигналы, выставляемые FIFO, такие как «PRSNT», «READY» и прочие. Это выходные информационные сигналы, для удобства объединенные в вектора «STATUS WR» и «STATUS RD». Они сообщают писателю и читателю о текущем состоянии FIFO.
STATUS WR | ||
Название |
Уровень |
Описание |
READY |
'1' |
готовность к принятию пакетов (пакет гарантированно будут записан) |
IGNORE |
'1' |
FIFO перестает записывать входные слова данных (они игнорируются, а пакет будет отброшен) |
HALF_FULL |
'1' |
FIFO заполнено наполовину |
FEW_SPACE |
'1' |
осталось мало свободного места (менее 10%), запись при этом возможна |
FIFO_ERR |
'1' |
ошибка переполнения FIFO |
LOW_MAX |
'1' |
для пакета с максимальной длиной не хватит места в FIFO (т.е. свободного места осталось меньше чем PACK_MAX_BYTE) |
STATUS RD | ||
PRSNT |
'1' |
пакет готов к чтению |
FIFO_ERR |
'1' |
ошибка переполнения FIFO |
SENDING |
'1' |
производится передача пакета на выход (бит активен и в момент паузы) |
SKIPPING |
'1' |
логика чтения находится в состоянии пропуска пакета в результате команды SKIP |
Также внутри есть набор счетчиков. Они непрерывно отслеживают статистику:
– количество входных пакетов, поступающих от писателя;
– количество пакетов, которые были записаны в память;
– отброшенные пакеты (например, из-за превышения заданного размера или из-за нехватки места в памяти);
– прочитанные пакеты (выданные читателю).
Добавил я их для помощи в отладке смежных с FIFO модулей. А то на одном проекте мы постоянно спорили – у кого же из нас разработчиков постоянно теряются пакеты.
7. С какой же скоростью эта "улиточка" ползает?
Написать только лишь HDL-код, выполняющий функциональные требования – этого мало. Код должен имплементироваться в цифровую схему, которая будет работать в реальной физической ПЛИС. А схема имеет такой важный параметр как быстродействие. Точнее максимальную тактовую частоту (fmax), на которой она способна корректно работать в выбранном кристалле при допустимых условиях эксплуатации.
Изначально, когда я только начал проектировать самую первую версию FIFO, от него требовалось работать на частоте 156,25 МГц (частота шины «xgmii» для 10 Gigabit Ethernet) в ПЛИС Xilinx Kintex7. Достигнуть такого значения для этой достаточно быстрой микросхемы было не особо сложно.
Проектируя последующие версии, я поставил задачу посложнее. А именно, получить гарантированную fmax = 156,25 МГц для ПЛИС «low-cost» сегмента. Само собой, что это значение должно быть достигнуто для обоих клоковых доменов – «WR» и «RD». В качестве микросхемы я выбрал Altera MAX10. Вот что для нее получилось при зафиксированном размере FIFO (65’536 байт) для различных комбинаций размеров шин записи и чтения:
Altera MAX10 – 10M50DAF484C7G
Quartus Prime 20.1.1
Размер FIFO: 65’536 байт – 64 из 182 блоков M9k (~35%)
Optimization mode: «Balanced»
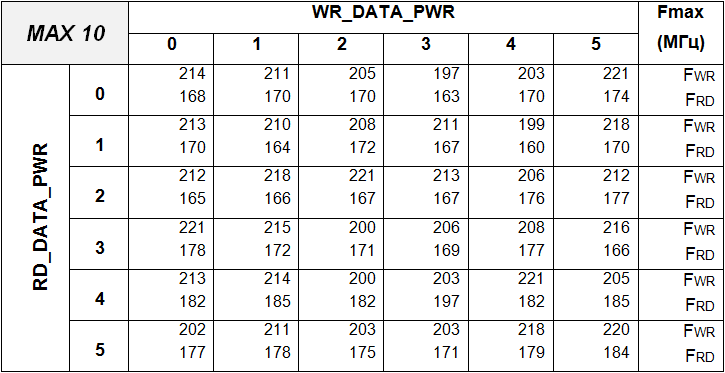
Как видно из таблицы, для всех сочетаний разрядностей шин требование по fmax = 156,25 МГц выполняется. Но сама частота мало о чем говорит. Более наглядной величиной будет битовая скорость, то есть количество обрабатываемых бит в единицу времени. Максимальная разрядность шин FIFO задается параметрами WR_DATA_PWR = RD_DATA_PWR = 5, и составляет 32 байта (256 бит).
В такой конфигурации при частоте 156,25 МГц битовая скорость составит 40 Гбит/с. Если же взять достигнутое для этого варианта значение Frd = 184 МГц, то скорость становится равной 47,1 Гбит/с.
Следующая ПЛИС, для который я сделал расчеты быстродействия – Xilinx Kintex7. Здесь задачей стало достижение значения fmax в два раза выше – 312,5 МГц. Так как эта ПЛИС содержит гораздо больше блоков памяти, то размер FIFO при расчетах я увеличил до 262’144 байт.
Кстати, кроме того что микросхема Kintex7 обладает большим количеством ресурсов чем MAX10, так еще и среда Vivado несколько ‘заторможенная’. Поэтому имплементация каждого варианта занимает уже ощутимое время. Ждать результатов, а затем вручную перезапускать имплементации мне совершенно не хотелось. И я попросил одну из бесплатных LLM написать tcl-скрипт для автоматизации этого процесса:
tcl-скрипт
cd [file dirname [file normalize [info script]]]
catch {close_design}

set report_file "fmax_sweep_results.csv"
set fp [open $report_file "w"]
puts $fp "WR_DATA_PWR,RD_DATA_PWR,Clock,Fmax_MHz,WNS_ns,Period_ns"

foreach wr {0 1 2 3 4 5} {
    foreach rd {0 1 2 3 4 5} {

        catch {close_design}

        set_property generic "WR_DATA_PWR=$wr RD_DATA_PWR=$rd" [current_fileset]

        # ---------- SYNTH ----------
        reset_run synth_1
        launch_runs synth_1 -jobs 4
        wait_on_run synth_1

        set syn_status [get_property STATUS   [get_runs synth_1]]
        set syn_prog   [get_property PROGRESS [get_runs synth_1]]
        if {$syn_prog ne "100%" || [string match "*ERROR*" $syn_status]} {
            puts "Синтез: status='$syn_status' progress='$syn_prog'"
            puts $fp "$wr,$rd,SYNTH_ERROR,NA,NA,NA"
            continue
        }

        # ---------- IMPL ----------
        reset_run impl_1
        launch_runs impl_1 -jobs 4
        wait_on_run impl_1

        set imp_status [get_property STATUS   [get_runs impl_1]]
        set imp_prog   [get_property PROGRESS [get_runs impl_1]]
        if {$imp_prog ne "100%" || [string match "*ERROR*" $imp_status]} {
            puts "Ипмплементация: status='$imp_status' progress='$imp_prog'"
            puts $fp "$wr,$rd,IMPL_ERROR,NA,NA,NA"
            continue
        }

        # ---------- Анализ таймингов ----------
        open_run impl_1

        foreach clk [get_clocks] {
            set paths [get_timing_paths -setup -from [get_clocks $clk] -quiet]

            if {[llength $paths] == 0} {
                puts "clk: $clk | path not found"
                puts $fp "$wr,$rd,$clk,NO_PATH,NA,NA"
                continue
            }

            set wns    [get_property SLACK  [lindex $paths 0]]
            set period [get_property PERIOD [get_clocks $clk]]
            set eff    [expr {$period - $wns}]

            if {$eff <= 0} {
                set fmax_str "INF"
                puts "CLK: $clk | WNS=${wns} ns | fmax: INF (eff_period<=0)"
            } else {
                set fmax_str [format "%.2f" [expr {1000.0 / $eff}]]
                set set_mhz  [format "%.2f" [expr {1000.0 / $period}]]
                puts "CLK: $clk | set: ${set_mhz} MHz | WNS: ${wns} ns | fmax: ${fmax_str} MHz"
            }
            puts $fp "$wr,$rd,$clk,$fmax_str,$wns,$period"
        }

        catch {close_design}
    }
}

close $fp
puts "Finished: $report_file"
Xilinx Kintex7 – xc7k325tffg900-2
Vivado 2019.1
Размер FIFO: 262’144 байт – 64 из 445 блоков RAMB36 (~14%)
Implementation Strategy: «Vivado Implementation Default»
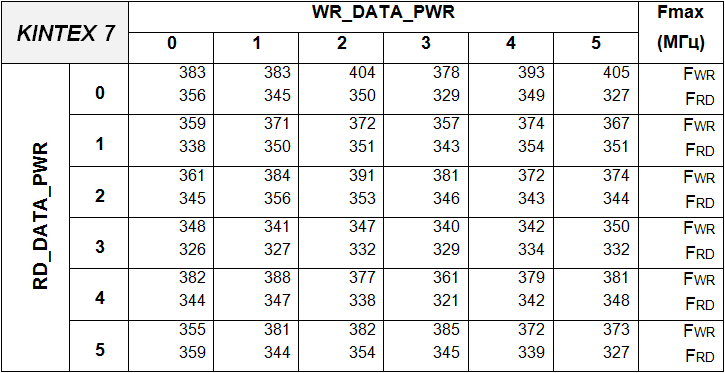
Для Kintex7 требование fmax = 312,5 МГц также выполнено. При такой частоте битовая скорость будет равна 80 Гбит/с. Для достигнутого значения Frd = 327 МГц – получится 83,7 Гбит/с.
И еще несколько комментариев к полученным значениям частот для выбранных микросхем:
Во-первых, в обоих случаях не была включена оптимизация по быстродействию. Это означает, что требования по fmax выполняются с запасом даже для ‘балансной разводки’. Следовательно, при необходимости, возможно выжать из FIFO несколько больше.
Во-вторых, результаты имплементации немного меняются в зависимости от такого параметра как «seed». В Quartus его можно задать явно:
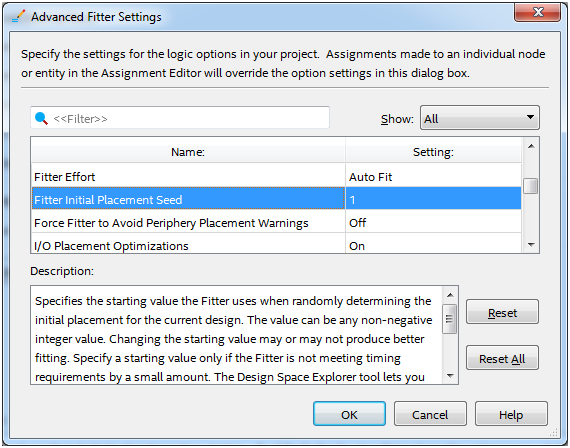
В Vivado я такого параметра в настройках не нашел. Но судя по сообщениям на форумах, на этот «seed» возможно влиять опосредованно, внося незначительные изменения в дизайн. Ради любопытства я менял разрядности отладочно-информационных счетчиков внутри FIFO. Сами по себе они никак не влияют на критический путь. Но изменения в этих счетчиках действительно приводили к иным значениям fmax.
Из этого следует, что цифры в таблицах несколько условны. Например, для варианта «WR_DATA_PWR=0 / RD_DATA_PWR=2» из первой таблицы (MAX10), для которого Fwr = 212, Frd = 165, другой «seed» поменял результат на Fwr = 211; Frd = 177.
В-третьих, быстродействие для различных сочетаний ширин «WR/RD» разное. Если для «WR_DATA_PWR» разброс значений невелик, то для «RD_DATA_PWR» ситуация чуть хуже. Вариант «RD_DATA_PWR =3» показал наименьшее быстродействие для обеих микросхем. Признаюсь, что для меня это стало даже немного удивительным. Наихудшие значения я ожидал увидеть для «RD_DATA_PWR=0». Ведь в этом варианте выходной мультиплексор имеет наибольший размер. И я думал, что именно он является критическим путем. Но оказалось, что этот путь меняются в зависимости от значения параметра «RD_DATA_PWR».
В-четвертых, в среднем максимальная частота для домена «WR» (Fwr) выше, чем для «RD» (Frd). Это предсказуемо и связано с двумя особенностями дизайна FIFO:
– логика выхода чтения организована сложнее из-за наличия механизма паузы.
– выход данных для порта чтения не имеет регистров в самих блоках памяти. Конечно их можно добавить и увеличить fmax, но это лишний такт задержки при чтении.
И выводы из вышесказанного – моя "улиточка" оказалась весьма бодренькой. Для «low-cost» ПЛИС достигается быстродействие в 47,1 Гбит/с. Для более продвинутой, но отнюдь не топовой ПЛИС – 83,7 Гбит/с. Причем задел для оптимизации дизайна по частоте вполне имеется. Осталось найти свободное время, чтобы заняться улучшениями.
И еще, что очень важно для меня: исходный код можно переносить между ПЛИС различных вендоров вообще без каких-либо изменений.
8. А оно вообще работает?
Описания и расчеты частот – это конечно же хорошо, но а что там на практике? Работает ли FIFO в реальном железе, и если да, то для каких задач оно используется?
Как я написал во вступлении, целью было сделать не какой-то пет-проект, и не очередную тестовую поделку, а готовое законченное IP-ядро, которое я смогу применять как черный ящик для множества различных задач. И я применяю – Ethernet , контроллер памяти, фильтрация и масштабирование видео, фрейм-буфер. Это те блоки, где трудится моё FIFO, причем в серийных коммерческих устройствах.
Ниже пример использования FIFO в контроллере памяти (SDR SDRAM). Оно здесь является внутренним буфером, и выдает пакеты по запросу логического подмодуля контроллера.
Временная диаграмма работы получена при помощи отладчика «Signal Tap». ПЛИС – Altera «MAX 10», плата – Terasic «DE10-Lite».
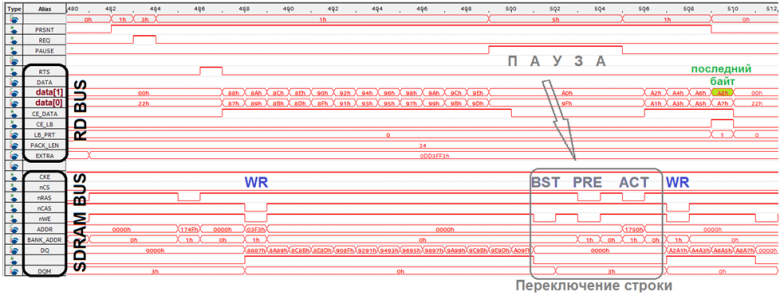
На диаграмме показано как происходит чтение с паузой.
После запроса «REQ» (отсчет 483) – FIFO выдает поток данных по шине «RD BUS» шириной 2 байта. Начало данных – отсчет 487. В определенный момент контроллер памяти ‘понимает’, что адреса в активированной строке памяти (ее адрес – x174F) заканчиваются, нужно переключиться на следующую строку. И он выставляет запрос паузы «PAUSE» (отсчет 499). На следующем такте (отсчет 500) FIFO прекращает выдачу данных, опуская сигнал «CE_DATA». При этом последнее валидное слово данных продолжает удерживаться на шине «RD BUS» (байты xA0, x9F).
Во время паузы контроллер переключает строку, выставляя на шину памяти последовательность команд – «Burst Terminate», «Precharge», «Activate». Затем он снимает запрос «PAUSE» (отсчет 505). Через такт после этого (отсчет 506) FIFO поднимает «CE_DATA» и возобновляет выдачу данных. А контроллер продолжает их снова записывать в память, начиная с нулевого адреса строки x1750.
Завершается выдача данных от FIFO на отсчете 510. Это сигнал «CE_LB» и указатель последнего байта «LB_PTR» = 1, который говорит контроллеру, что последним байтом пакета является старший байт на шине данных – xA8.
Кстати, забыл упомянуть, что в дополнительном выходе «EXTRA» FIFO выдает адрес, с которого должна начаться запись пакета в SDRAM – x0DD3FF3.
P.S.
Да, название статьи кому-то может показаться немного дерзким… Но конечно я не претендую на всю полноту знания. Это лишь мой субъективный взгляд на задачу пакетной передачи данных, исходя из моего опыта и практики. Никому его не навязываю как истину в последней инстанции. У кого-то он может оказаться иным. Мне просто захотелось поделиться своими мыслями, своими идеями и своим подходом к проектированию. Именно потому я и написал эту статью.
P.P.S.
Спасибо тем кто дочитал. Более трех недель писал эту статью. Само собой занимался не только ей, но времени на нее ушло больше, чем ожидал изначально... Несколько утомительно под конец было. Надеюсь, что для сообщества статья окажется хоть в чём-то полезной, и я не зря потратил силы на нее.
Есть еще много тем которые хотелось бы осветить касательно FPGA – алгоритмы потоковой видеообработки, подключение MIPI-камеры к плате с ПЛИС, организация фреймбуфера... Думаю, после Нового года что-нить на Хабр напишу, главное чтоб настрой на это был :)
mozg37
На мой взгляд, главный плюс ухода от вендорских IP - это появление у разработчика компетенций другого, значительно более глубокого уровня.
Сам практикую изобретение велосипедов - FFT, CORDIC, фильтры... А часто эти велосипеды работают на бОльших частотах и с меньшими ресурсами.