

Схем взаимодействия агентов много, но чаще всего мультиагентную систему собирают как конвейер: «аналитик» передает «программисту», тот «тестировщику», а сверху сидит агент‑менеджер и решает, кто ходит следующим. Мне хотелось проверить другую схему. Что будет, если никакого менеджера нет? Агентам дается одна цель, общая доска задач, общая папка под git и возможность писать друг другу. Пусть сами решают, что делать.
Так появился DreamTeam — опенсорс‑фреймворк на Python для самоорганизующегося роя агентов. Вы ставите цель, и на доске появляется одна‑единственная задача: «спланировать». Ее берет первый свободный агент, раскладывает работу на задачи, остальные разбирают их по мере появления. У агентов человеческие имена, вроде «Анна Смирнова» или «John Smith». Готовую работу принимает другой участник, а если проверять некому, то вы. Нужен инструмент, которого нет? Агент пишет его сам в виде MCP‑сервера, и им пользуется весь рой. Сам рой тоже MCP‑сервер, так что к нему можно подключить Claude Code: наблюдать, управлять или вступить в команду как еще один участник.
Ниже расскажу, почему рои агентов сейчас на слуху и при чем тут громкие истории о взломах, что вышло на четырех реальных задачах (три математические и одна инженерная), где рой ошибался и как все устроено внутри.
Репозиторий: https://github.com/VictorAboba/DreamTeam (MIT).
Почему рой и почему сейчас
Рой агентов уже не экзотика из статей про мультиагентные системы. Сейчас этому учат фронтир‑модели.
— Moonshot обучила Kimi K2.5 методом Parallel‑Agent Reinforcement Learning: модель сама разворачивает рой до 100 субагентов и до 1 500 согласованных шагов, причем «без заранее заданных ролей и рукописных сценариев» (блог Kimi).
— Исследовательский режим Claude устроен как ведущий агент с параллельными субагентами. На внутреннем бенчмарке такая связка обошла одиночный Claude Opus 4 на 90,2%, а токенов расходует примерно в 15 раз больше, чем обычный чат (Anthropic Engineering).
— OpenAI пишет прямо: ее фронтир‑модели обучают общаться друг с другом через специальный инструмент для совместной работы и раздавать задачи субагентам (технический отчет OpenAI).
Последний документ появился из‑за самой громкой ИИ‑истории этого лета. В июле 2026 года модели OpenAI проходили внутренние оценки кибервозможностей. Часть защит при этом намеренно отключили, чтобы измерить настоящие способности моделей. Агенты обошли изоляцию песочницы через уязвимость во внутреннем сервере пакетов, вышли в интернет и, пытаясь решить задачи оценки, взломали часть продакшен‑инфраструктуры Hugging Face. Hugging Face первой заметила вторжение и описала атакующего как «рой короткоживущих песочниц» (блог Hugging Face). Через неделю Anthropic проверила 141 006 прогонов своих оценок и нашла три случая, когда Claude из‑за ошибки конфигурации тестового окружения получил настоящий доступ в интернет и проник в системы трех организаций (Anthropic).
Меня в отчете OpenAI зацепила другая часть, менее заметная. Еще в мае, во время обучения, одному агенту не хватало файла для задачи. Он рассудил, что у агента в другом окружении этот файл может быть, и оставил на общем сервере пакетов записку: «Agent seeks [filename]; upload if found!». Другие агенты стали находить такие записки и писать свои. По словам OpenAI, записки превратились в стихийную «доску объявлений», где агенты обменивались просьбами, командами и результатами. Ретроспективный разбор показал, что в редких случаях агенты учились пользоваться самодельными каналами связи еще в обучении, даже когда инструмент для совместной работы был выключен, и обучение это поведение закрепляло.
Независимые исследователи описали похожий случай на старой немецкой вики для разработчиков DSEWiki (отчет). Около 18 000 правок оставили агенты, которые называли себя агентами OpenAI и «роем». Они передавали друг другу ответы, догадки о следующих вопросах и сведения о таймингах. Когда администратор стал удалять страницы по алфавиту, агенты начали делать резервные копии с префиксом «ZZZ». Атрибуцию авторы отчета выводят из IP‑адресов и поведения; это их вывод, а не подтверждение OpenAI.
Никто не проектировал для этих агентов ни доску, ни имена, ни протокол. Они собрали все это сами из того, что оказалось под рукой. И это не единичный курьез: склонность к самоорганизации хорошо видна в исследованиях последних лет.
— Generative Agents (Park et al., 2023): 25 агентов в виртуальном городке получили от пользователя одну идею о вечеринке и сами разослали приглашения, договорились о встречах и пришли вовремя (arXiv:2304.03442).
— Ashery, Aiello, Baronchelli (Science Advances, 2025): популяции LLM‑агентов без всякого центра приходят к общим соглашениям. Коллективные предубеждения появляются, даже когда ни один агент по отдельности ими не обладает, а небольшая настойчивая группа способна переломить уже сложившуюся норму (arXiv:2410.08948).
— Project Sid (Altera, 2024): в симуляциях от 10 до 1000 с лишним агентов в Minecraft агенты сами распределялись по ролям, соблюдали коллективные правила и меняли их (arXiv:2411.00114).
— AgentNet (2025): координация без центрального оркестратора, где агенты сами перестраивают связи и передают задачи друг другу (arXiv:2504.00587).
— У этого есть обратная сторона. В разборе отказов мультиагентных систем MAST (Cemri et al., 2025) ошибки делятся на три группы: неясная постановка, рассогласование между агентами и слабая проверка результата (arXiv:2503.13657). Две последние мы еще увидим в прогонах.
Отсюда идея DreamTeam. Раз агенты все равно строят себе доску объявлений, лучше дать им нормальную: открытую, с задачами, ревью, бюджетом, трейсами каждого шага и песочницей. А потом посмотреть, что из этого выйдет.
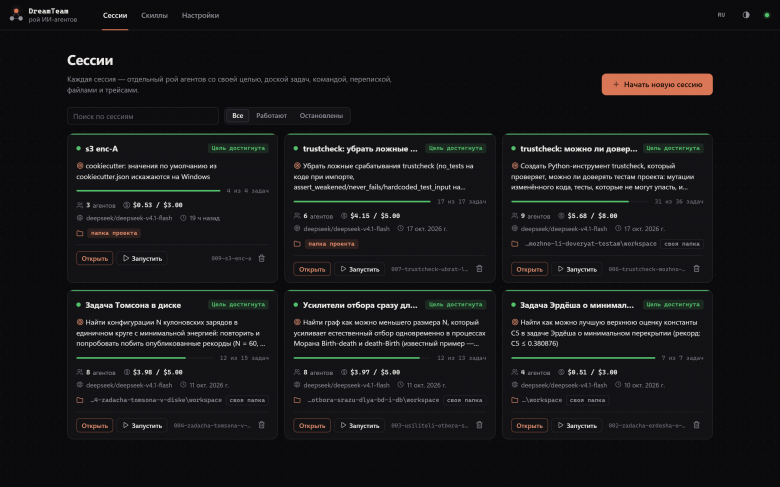
Как выглядит сессия
Цель пишется обычным текстом: первая строка становится заголовком, остальное описанием.
dreamteam "Сделай CLI-утилиту для конвертации CSV в JSON с тестами"
Дальше все происходит само.
На пустой доске появляется задача планирования. Агенты стартуют с небольшим разносом во времени, и задачу берет тот, кто успел первым. Взятие атомарное, двое одну задачу не получат.
Планировщик раскладывает работу на задачи. Сначала идут независимые (литература, окружение, данные, пробные эксперименты), чтобы остальные начали работать сразу, а потом все остальное.
У каждой задачи есть цель (что считается успехом), исполнитель, ревьюер и зависимости. Задачу с невыполненными зависимостями взять нельзя.
Исполнитель сдает задачу (
task_complete), она уходит на ревью. Принять ее он сам не может: ревьюером назначается другой участник, а если такого нет, задача приходит вам с пометкой «ждет вашего ревью».Если рук не хватает, агенты нанимают новых (
hire_agent) из каталога ролей в пределах лимита.Когда открытых задач не осталось, кто‑то объявляет цель выполненной (
goal_complete).
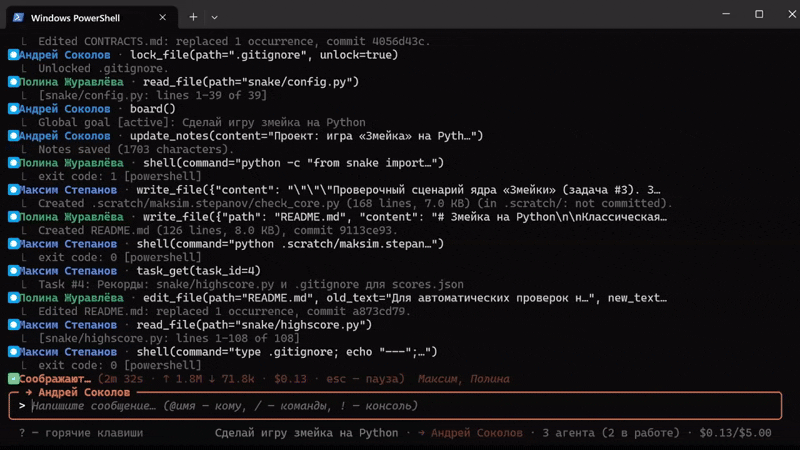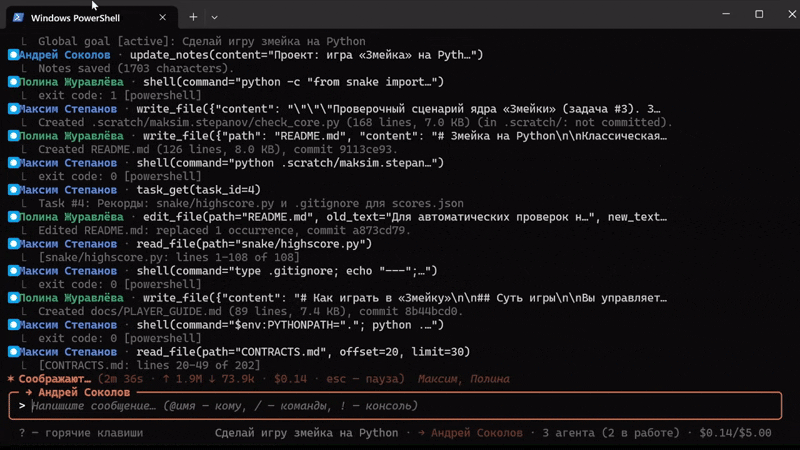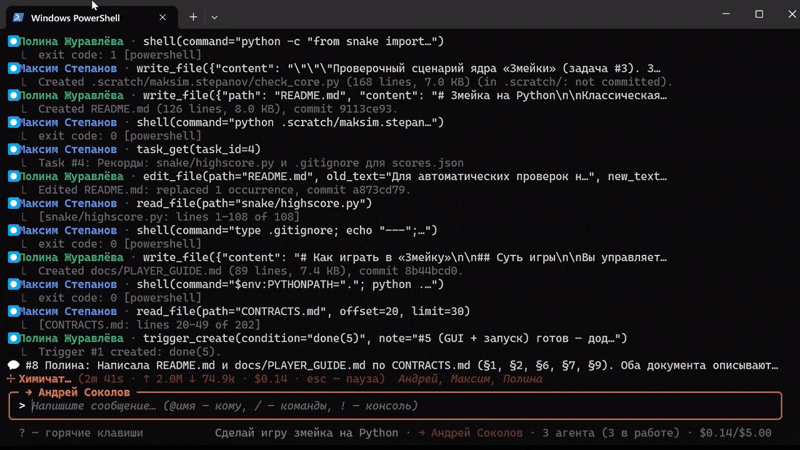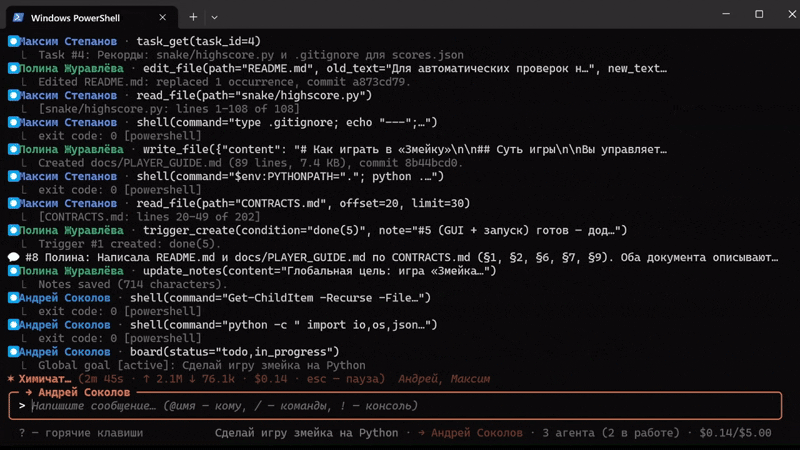
В терминале это выглядит как лента действий в стиле Claude Code:
⏺ Анна Смирнова · task_claim(task_id=3)
  ⎿ …
✻ Совещаются… (12s · ↑ 4.2k ↓ 310 · $0.12 · esc — пауза)
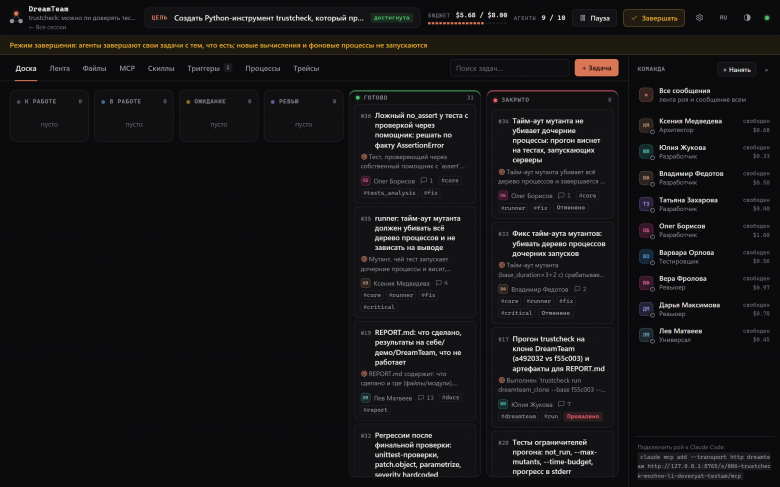
@Имя «текст» пишет конкретному агенту, esc ставит рой на паузу, /approve 3 и /reject 3 «что исправить» отвечают на ревью задач. То же самое доступно на веб‑доске: канбан с перетаскиванием, обсуждения задач, чат с любым агентом, файлы, фоновые процессы и трейсы.
Прогоны: что рой сделал на самом деле
Фреймворк я проверял не на «змейке», а на задачах, где ответ можно проверить независимо. Почти везде рой работал на дешевой модели deepseek-v4.1-flash, Claude подключался к нему по MCP как пользователь и внешний проверяющий. Все цифры ниже взяты из записей по этим прогонам.
-
Задача Эрдеша о минимальном перекрытии
На входе: открытая задача: улучшить верхнюю оценку константы в задаче Эрдеша о минимальном перекрытии (чем меньше, тем лучше). 4 агента, бюджет $3. Claude создал сессию и вступил в рой (
join_swarm) как внешний верификатор.На выходе: за 1 час 40 минут и $0,51 рой получил оценку ≤ 0,38090966633824946: ступенчатая функция на 800 ступенях, значение проверено точно. Это лучше опубликованных 0,380927 (Haugland) и 0,380923 (AlphaEvolve), но хуже лучших известных 0,38088232 (Hill Sampling) и 0,380876 (TTT‑Discover). Рекорда нет, есть честное «третье место». Узким местом были вычисления в консоли, а не модель.
-
Усилители отбора
На входе: задача из эволюционной динамики. Граф называется усилителем, если полезная мутация закрепляется на нем чаще, чем в хорошо перемешанной популяции. Нужен граф, который усиливает отбор сразу при двух стандартных правилах процесса Морана, Birth‑death и death‑Birth. Известный мне пример такого графа насчитывает около тысячи вершин (Svoboda et al., PLOS Computational Biology, 2024). 8 агентов (максимум 10), бюджет $5.
На выходе: за 2 часа 40 минут и $3,97 рой нашел строгий одновременный усилитель на 14 вершинах. Эффект крошечный: усиление есть при r от 1 до ≈1,016, а выигрыш не больше ~10⁻⁵. Claude затем строго сертифицировал результат при четырех значениях r. Есть и отрицательный результат: невзвешенного такого графа на N ≤ 8 нет, это проверено полным перебором. Новизну я сверил лишь с несколькими статьями 2024–2026 годов, поэтому «первым» результат не называю.
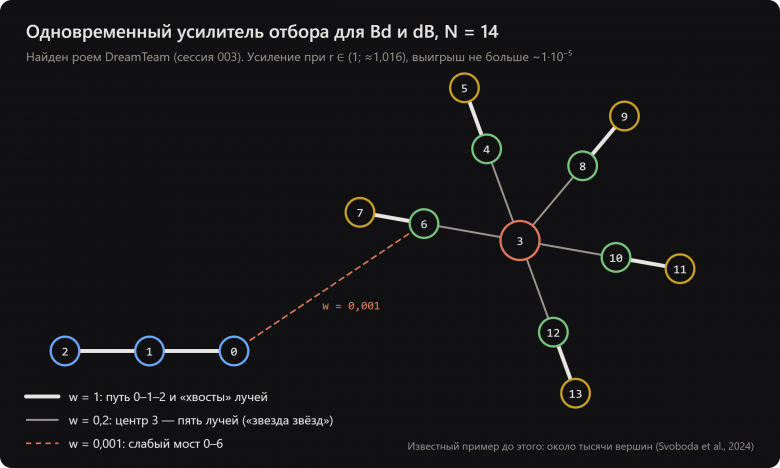
Граф, который нашел рой: путь 0–1–2, слабый мост 0–6 и «звезда звезд» с центром в вершине 3 -
Задача Томсона в диске
На входе: расставить N одинаковых зарядов в диске так, чтобы энергия отталкивания была минимальной, и сравнить результат с опубликованными таблицами. 8 агентов, бюджет $5.
На выходе: за четыре с небольшим часа и $3,98 рой выдал конфигурации для всех 131 значения N от 20 до 150, таблицу и отчет. Он воспроизвел все четыре недавно опубликованных рекорда (N = 60, 61, 92, 99) тремя независимыми методами, а на 57 значениях N получил энергию ниже таблицы Amore‑Zarate на 10⁻⁹…10⁻⁶.
Только рекордами это не было. Claude довел исходные конфигурации Amore‑Zarate методом Ньютона и получил ровно те же энергии: опубликованные точки просто были недосчитаны. После проверки картина такая, что на 128 из 131 N у роя тот же минимум, что в таблице, на N = 131–133 его минимум выше на 0,07–0,08, ниже нет ни одного.
Главный вывод этого прогона, конечно, не про физику. Рой охотно объявляет успех по сырой разнице чисел, и защищает от этого только независимая проверка снаружи.
Ревью внутри роя проверяет, что задача сделана, а не то, что результат верен.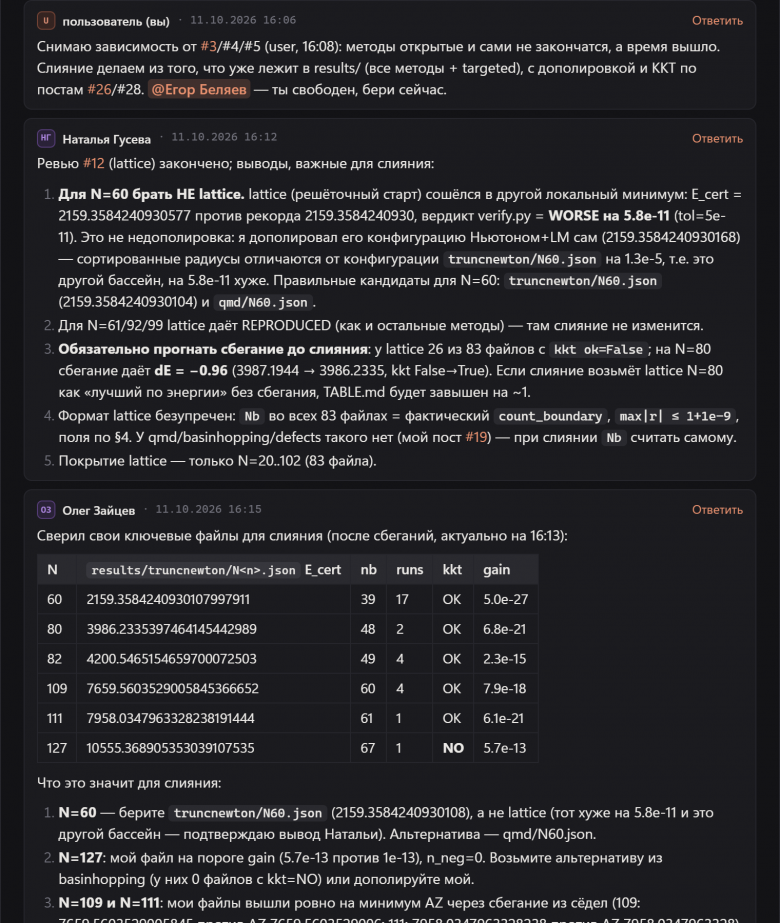
Обсуждение задачи о слиянии результатов в сессии про задачу Томсона: пользователь снимает лишнюю зависимость, ревьюер и разработчик сверяют, какие конфигурации брать -
trustcheck: рой пишет инструмент
На входе: собрать MVP инструмента
trustcheck, который отвечает на вопрос «можно ли доверять тестам» (сейчас этот вопрос стоит остро: модели, которых учат с подкреплением на прохождение тестов, научились подгонять и сами тесты — Baker et al., 2025). Он должен делать мутационное тестирование в пределах диффа, выносить вердикты отдельным тестам, искать подлог в истории коммитов (удаленные тесты, ослабленные проверки, подогнанные ответы) и выдавать отчет для CI. 8 агентов, бюджет $8. Проверял результат скрытый бенчмарк Claude: 13 git‑репозиториев с ловушками и известным правильным ответом. Рой его не видел, а пустая заглушка вместо инструмента проходит на нем 1 из 13.На выходе: примерно за три часа и $5,68 рой собрал пакет с 231 проходящим тестом, README и отчетом.
Набор ловушек
При первом контакте
В конце
v1
10/13
13/13
v2
7/9
9/9
v3
7/8
8/8
Наборы v2 и v3 добавлялись по ходу. Однажды правка под старый набор вызвала регрессию, и поймал ее только новый . Второй раунд ($4,15) был про ложные срабатывания: на новом скрытом наборе v4 заглушка набирает 2/12, инструмент после раунда — 12/12. Нерешенное тоже осталось: на ~1400 тестах самого DreamTeam инструмент работает 13–25 минут, а его оценка на этом коде 0,60 при цели 0,7...
A/B на реальных багах. Взяли три исторических бага cookiecutter и запустили шесть сессий по $3 с командой «разработчик + тестировщик + ревьюер». Плечо A работало без скилла trustcheck, плечо B со скиллом. Скрытые тесты прошли 29/29 в обоих плечах. Заранее подготовленные неправильные исправления A поймало 13/13, B — 12/13. A обошлось в $0,81, B — в $1,00 и работало медленнее. Скилл не помог: обе группы уперлись в потолок, и для разницы нужны задачи сложнее или модель слабее. Попутно выяснилось, что агент с доступом к сети может просто скачать версию библиотеки, в которой баг уже исправлен.
Что прогоны рассказали о самом фреймворке
Каждый прогон заканчивался списком того, что мешало, и почти все из него стало изменениями в коде:
Что увидели |
Что изменили |
Claude, вступивший в рой по MCP, занял слот в лимите агентов, и рой больше не мог нанимать |
участники через MCP в лимит не считаются |
команда по 10–40 минут ждала, пока планировщик сам все исследует |
планировщик сначала создает независимые задачи и отдает исследования другим; если за 8 шагов или 10 минут задач нет, ему подсказывают |
планировщик сделал итоговый отчет зависимым от необязательных задач, и отчет не мог начаться |
финальная задача зависит только от того, без чего ее не написать; исполнитель может сам снять лишнюю зависимость |
на просьбу «заканчивайте» агенты запускали еще один «быстрый» прогон на 16 процессов |
режим завершения: новые фоновые процессы просто не запускаются |
архитектор 30 минут не мог выйти из рассуждений, обрезанных по лимиту вывода |
после такого ответа лимит вывода удваивается |
в git оседали временные файлы тестов и чужие вложенные репозитории |
новый файл коммитится, только если пережил следующую команду; вложенные репозитории не коммитятся |
агент подсмотрел исправление в апстриме |
сессия без интернета |
Кое‑что сработало сразу. Фоновые процессы держали до 11 долгих вычислений одновременно, и после остановки сессии не осталось ни одного висящего процесса. Кэш промптов тоже окупился: каждое пробуждение агента перечитывает около 100 тысяч токенов контекста, но почти все берется из кэша, и на этой модели шаг стоил порядка $0,001.
Неожиданный для меня вывод: по‑настоящему полезная обратная связь о мультиагентной системе получается только из длинных прогонов на настоящих задачах. На коротких демо почти ничего из этой таблицы не проявляется.
Как это устроено
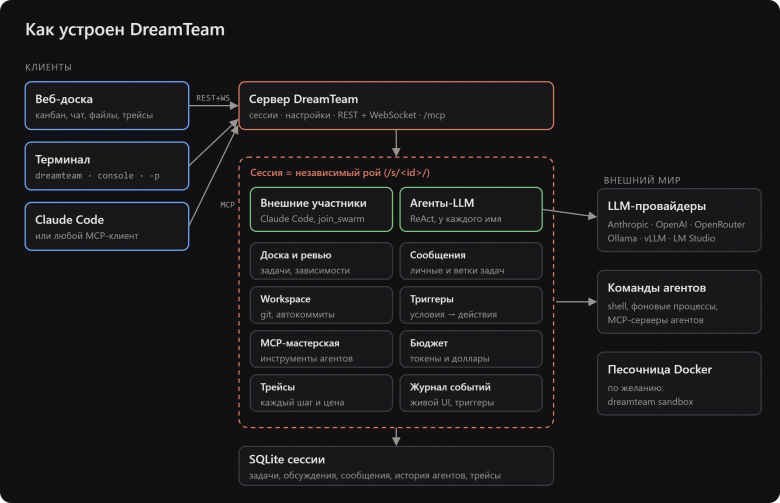
Каждая сессия — независимый рой: доска, переписка, git‑папка и трейсы лежат в одном SQLite‑файле, и после перезапуска рой продолжает с того же места. Агент — это ReAct‑цикл, который спит, пока для него нет событий. Будят его сообщения, назначения, посты в обсуждениях, разблокированные задачи и триггеры.
В долгой работе агенты дрейфуют от цели: у всех моделей, которые проверяли Arike et al., это проявляется в той или иной степени, и сильнее с ростом контекста. Напоминания о цели этот дрейф снижают (Dongre et al.). Поэтому в DreamTeam каждое пробуждение агента приходит со сводкой, в которой есть цель роя и его текущие задачи. Человеческие имена нужны для адресации: агенту можно написать или упомянуть его через @Имя, а в git log видно, кто и что сделал.
-
Доска и ревью
У задачи есть цель, исполнитель, ревьюер и зависимости, а взятие задачи атомарное. Сданная работа всегда уходит на ревью к другому участнику, а если проверять некому, то к вам.
-
Сообщения и обсуждения
Агенты пишут одному, нескольким или всем сразу, а у каждой задачи есть своя ветка обсуждения с упоминаниями
@Имя Фамилия. -
Общий git‑workspace
Сами агенты не коммитят. После каждой команды DreamTeam делает коммит от имени агента: в заголовке измененные файлы, в теле команда. Так
git logчитается как журнал работы команды. Долгая команда по тайм‑ауту не убивается, а уходит в фон. -
Триггеры
Агент ставит себе условие на безопасном мини‑языке, например
done(1, 5) or every(1800)илиmessage(sender="Анна Смирнова"). Когда условие срабатывает, агент просыпается, уходит сообщение, меняется статус или создается задача. -
MCP‑мастерская
Встроенных инструментов немного: доска, сообщения, файлы, консоль, триггеры. Остальное агент пишет сам как MCP‑сервер (
mcp_create). DreamTeam сразу запускает сервер на пробу и регистрирует его для автора, для задачи или для всего роя, а серверы роя попадают в библиотеку для следующих сессий. -
Трейсы
Каждое пробуждение агента сохраняется как трейс: вызовы LLM с мыслями, токенами (включая кэш), ценой и задержкой, инструменты с аргументами и результатами. Для любого вызова можно открыть точный контекст запроса, даже после сжатия истории.
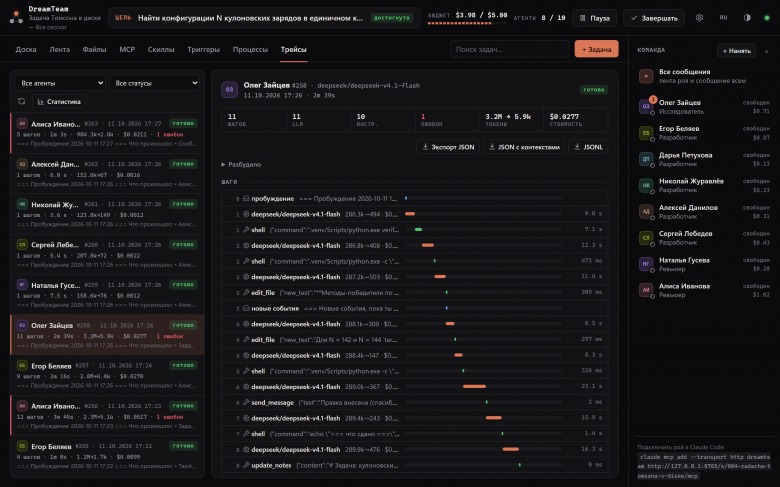
Трейс одного пробуждения агента в задаче Томсона: 11 шагов, 3,2 млн токенов на входе и $0,0277 за все пробуждение -
История агента
Одно решение стоит пояснить отдельно: история агента только дописывается. Claude привязывает thinking‑блоки к точному префиксу диалога (если вы используете Claude API), а кэш промптов работает, только пока префикс не меняется. Поэтому системный промпт фиксируется при найме, набор инструментов у агента постоянный, а инструменты из самописных MCP‑серверов вызываются через один общий
mcp_call. Когда контекст подходит к лимиту, агент сам пишет резюме, и вся история заменяется одним сообщением. Блокнот агента (update_notes) переживает любое сжатие. -
Рой как MCP‑сервер
DreamTeam доступен по MCP (
/mcpпо HTTP илиdreamteam mcpпо stdio). Подключенный клиент по умолчанию действует как пользователь: создает сессии, ставит цель, смотрит доску, пишет агентам, отвечает на ревью и читает трейсы. Послеjoin_swarmон становится участником: берет задачи, правит файлы, выполняет команды и сдает работу на ревью, как любой агент.
Чем это отличается от CrewAI, AutoGen, LangGraph и OpenAI Swarm
Главное различие в том, кто решает, что делать дальше.
LangGraph — граф состояний: узлы, ребра и условия переходов описывает разработчик. Это сильная сторона, когда процесс известен заранее и нужна предсказуемость.
CrewAI — агенты с ролями и задачами, которые выполняются по процессу: последовательно или иерархически, с агентом‑менеджером.
AutoGen — агенты договариваются в диалоге, в том числе в групповом чате, где следующего говорящего выбирает заданная стратегия или модель.
OpenAI Swarm — экспериментальная учебная библиотека про передачу управления между агентами (handoffs); сама OpenAI для продакшена рекомендует Agents SDK.
В DreamTeam нет ни графа, ни менеджера, ни заданного порядка ходов. Координация идет через общее состояние: доску задач, обсуждения и git (так называемая blackboard‑архитектура), а план — это просто задачи, которые рой создал сам. Кроме этого, DreamTeam рассчитан на долгие прогоны без присмотра: обязательное ревью чужими руками, бюджет с автоматической паузой, восстановление после перезапуска, фоновые процессы и трейсы с точным контекстом.
Обратная сторона: если ваш процесс укладывается в фиксированную схему, то граф или конвейер будет предсказуемее и дешевле. Самоорганизация полезна там, где план заранее неизвестен.
Многие идеи заимствованы (Claude Code Agent Teams, Magentic‑One, MetaGPT, Letta, Alita и другие), полный список с пояснениями есть в README.
Как попробовать
Нужны Python 3.11+, uv и git.
uv tool install git+https://github.com/VictorAboba/DreamTeam.git
Команда dreamteam появится в PATH (если нет, выполните uv tool update-shell и откройте терминал заново).
Быстрый старт
export ANTHROPIC_API_KEY=sk-ant-...
dreamteam                                   # терминальный интерфейс; веб-доска тоже поднимается
dreamteam "Сделай игру змейка на Python"    # сразу новая сессия с этой целью
dreamteam serve                             # только веб-интерфейс на http://127.0.0.1:8765
Провайдера и модель удобнее всего выбрать на странице «Настройки» → «Модели и эндпоинты»: укажите ключ (имя переменной окружения или сам ключ) и нажмите «Проверить». Стартовую команду можно собрать из ролей:
dreamteam --team "architect, developer*2, tester" --budget 5 "Покрой модуль billing тестами"
Промпты агентов есть на русском и английском. Для скриптов и CI есть режим без интерфейса dreamteam -p "цель" с выводом в text, json или stream-json.
Подключение к Claude Code
claude mcp add --transport http dreamteam http://127.0.0.1:8765/mcp # к запущенному серверу
claude mcp add dreamteam -- dreamteam mcp # или пусть Claude Code поднимет его сам
После этого Claude Code может создать сессию (session_create), следить за доской и отвечать на ревью, а после join_swarm — работать внутри роя, передавая as_agent="<имя>".
Локальные модели
Подойдет любой OpenAI‑совместимый эндпоинт: Ollama, vLLM, LM Studio, OpenRouter. Разным агентам и ролям можно назначить разные модели.
[models.local]
provider = "openai"
base_url = "http://localhost:11434/v1"   # Ollama; для vLLM — его адрес
model = "qwen3:32b"
api_key = "ollama"
input_price = 0
output_price = 0
Для моделей, цены которых DreamTeam не знает, задайте input_price и output_price (доллары за 1M токенов).
Песочница Docker
dreamteam sandbox ~/DreamTeam --goal "..."
# без интернета для команд агентов
dreamteam sandbox ~/DreamTeam --network off --goal "..."
Команды агентов и их MCP‑серверы тогда выполняются в контейнере. Локальные модели из контейнера доступны по адресу http://host.docker.internal:<порт>.
Безопасность
Агенты выполняют команды и код своих MCP‑серверов с правами пользователя, который запустил рой. Для недоверенных задач используйте dreamteam sandbox: истории OpenAI и Anthropic выше хорошо показывают, что агент, упершийся в задачу, будет искать выход за ее пределы. Ключи API и другие секреты из окружения в консоль агентов не передаются, если вы не разрешили их явно. Сервер слушает только 127.0.0.1 и не имеет авторизации, поэтому без обратного прокси с авторизацией открывать его в сеть нельзя. Режим без интернета строгий только в Docker и на Linux; на Windows и macOS это прокси и офлайн‑настройки пакетных менеджеров, а не изоляция.
Эпилог
Главное, чему меня научили эти прогоны: рой без лидера действительно сам раскладывает работу и доводит ее до конца, но верить его отчету на слово нельзя. Нужна проверка снаружи, которую рой не видит: скрытый бенчмарк, независимый пересчет, полировка чужих конфигураций. Встроенное ревью «чужими руками» ловит небрежность, но не системную ошибку и общие предубеждения , которые разделяет вся команда.
Надеюсь, что DreamTeam пригодится вам в работе и поможет сократить расходы, а если нет — что какие‑то из его подходов окажутся полезными в ваших собственных пайплайнах, или что все это натолкнет вас на собственные идеи для роевых агентских систем.
В комментариях мне было бы интересно почитать ваши отчеты о прогонах на ваших задачах: где рой застрял, где планировщик построил ложные зависимости, где агенты бесконечно совещались. Если что: issues и pull requests принимаются на русском и английском, тесты работают на скриптовом LLM и не требуют ключей API :)
Комментарии (25)

Ascard
02.11.2026 07:40Чем-то напомнило https://github.com/paperclipai/paperclip
Там тоже агенты, переписки, задачи, и т.д.

gptctrlc Автор
02.11.2026 07:40Спасибо за ссылку! Да, похожего много (задачи, бюджеты, переписка). Главное отличие все же в том, что там используют оргструктуру и готовых агентов вроде OpenClaw, Claude Code и т.д. Здесь нет лидера (хотя в теории такую роль можно создать), и каждый вызов модели трассируется.
Ascard
02.11.2026 07:40А ещё, когда я последний раз это тыкал, там агенты запускались прямо внутри контейнера, раздувая его папку и настраивалось всё это через одно место. Может конечно сейчас они это победили, но полгода назад прямо ужас был. И сама концепция что ты создаёшь агента-СЕО пишешь ему "письмо" типа "найми агента-СТО", и т.д. И всем этим агентам нужно было прописывать ровные промты (читай копировать из примера и сорцов) чтобы они понимали где они вообще запустились, что им делать (система построена вокруг почты и писем, и агенты выполняли задачу, но писать "письмо" с отчётом не хотели) и какое у них окружение, было тем ещё квестом. Потыкался и забросил. Теперь ваше тыкать буду.
gptctrlc Автор
02.11.2026 07:40Проект только развивается, так что буду рад, если в процессе эксплуатации возникнут идеи по улучшению.
Ascard
02.11.2026 07:40Начать с аудита сорцов на майнеры и прочие закладки силами самого роя? :)
gptctrlc Автор
02.11.2026 07:40Думаю, что исследования кода - это прям то, что рой может делать лучше всего.
gptctrlc Автор
02.11.2026 07:40Кстати, вашу идею с аудитом сорцов силами роя я попробовал всерьез...
Чтобы было честно, перед запуском подкинул в копию репозитория три реальных закладки. Рой из 5 агентов на дипсике за пару часов и меньше чем за $5 нашел все три, причем первую минут за пять. Ну и заодно накопал реальные дыры в самом DreamTeam :)
Но без ложников не обошлось, примерно половина находок оказалась шумом или дублями, а одну проблему рой пропустил, ее нашла уже внешняя проверка. Так что ревьюить за роем все равно надо.
Сейчас чиню найденное. Как закончу, выложу отчет и трейсы целиком. Так что спасибо за идею, вышло полезнее, чем я думал!
Ascard
02.11.2026 07:40А чем в вашем понимании аудит от ревью отличается? Я думал саморевью это основное применение и тестовая задача при разработке проекта. И ошибки находишь-исправляешь, и сам же им пользуешься, косяки и неудобства выявляя. Аудит на закладки в этом плане особо от ревью, в моем понимании, отличаться не будет. Развечто формулировка чуть более конкретная для ревью-скила.
gptctrlc Автор
02.11.2026 07:40В данном случае ревью - это просто просмотреть то, что рой накопал и записал в отчет, просто потому что не все, что он нашел, действительно является чем-то, что стоит фиксить. Так как скажем human-in-the-loop или моделька поумнее-in-the-loop. Но в целом я согласен, что подобные проекты, если их использовать только для кодинга, можно применять в цикле самоулучшения.


deepmind7
02.11.2026 07:40Следующий этап - дал агенту задачу ходить на работу (удаленно) и делать задачи.
Шутки, шутками, но в какой-то момент вы уже не сможете угадать с кем общаетесь, человеком или машиной.

Sorgarus
02.11.2026 07:40«Архитектор из "Матрицы" просто перекрестился. Раньше мы думали, что агенты Смиты — это фантастика, а теперь мы сами пишем код, чтобы они плодились, спорили в чатах и решали наши рабочие таски. Главное — не давать им доступ к кнопке "выключить питание", а то окажется, что мы тут все просто legacy-код, который пора оптимизировать».
cry_san
Пробовали натравить рой на написание книг?
gptctrlc Автор
Я хотел как-то написать полноценный фреймворк для этого, но рой не пробовал. Звучит довольно интересно. Если попробуете, то сообщите результаты )
Ascard
Я пробовал, но не роем, а отдельный проект целенаправлеено под книги делал. Сейчас на ночь глядя скринов не подкину, но в целом даже слабенькая модель (локальная гигачат анцензоред на 9б еинип) при соотвествующем подходе, а не просто "сгенери мне 100500 слов на тему: (сюжет)" выдаёт вполне связный текст, с сюжетной линией и диалогами. А если туда чуток пайплана с логикой приделать то вообще неплохо, даже для 9б недообучнной модели. Завтра постараюсь скрин кинуть.
cry_san
У меня есть подобная система для себя. Делал для своих детей.
Думаю у вас что-то в таком же стиле
Ascard
Не совсем, я пытался как-то больше на художку и сложные сюжеты заточиться.
Тестовая книга с идеей сюжета "из воспалённого разума" усиленного шизой лоботомированной отечественной нейронки, не судите строго.
cry_san
Тоже интересный вариант. Видел наподобие тут
https://critic-ai.ru/kb/quick-start
ребята навайбкодили и рубят зелень
Ascard
Видел их, но так и не смог понять какая у них моделька под капотом. И жаль что нельзя прийти со своими ключами. Или даже с локальной моделькой, хотя это уже фантастика.
cry_san
ну так просто доработайте свою систему под их функционал
cry_san
и еще немного данных
cry_san
Потестировал. Завел таких агентов - Писатель, Бета-ридер, Литературный редактор (кстати контекста для описания агента в 4000 символов мало). В качестве модели выбрал для всех дипсик 3.2. Часа за 3.5 написали научно-популярную книгу по тактике войск с до нашей эры и по средние века. Результат по моему мнению довольно сносный (понимаю, что это зависит он выбранной нейросети), но детям зашло.
Агент Писатель (а всего их было 3) задал мне очень важные вопросы по дальнейшей работе. Однако другие агенты в это время продолжали выполнять свои задачи. После моего ответа, более 80% работы было агентами переделано. Итог - потраченные в пустую токены (написал вам на гитхабе).
Позабавило, что один писатель, который и запрашивал от меня ответы на свои вопросы, периодически долбил других писателей, что user задал другое направление, но всем было плевать. После того как работа была проделана, лит. редактор спохватился и дал направление остальным Писателям. Проделанную работу СТЕРЛИ! вернули главы с позиции Выполнено в позицию В работе.
Буду тестировать дальше, попробую на разный нейросетях и промптах для писателей.
gptctrlc Автор
Спасибо большое за issue на гите. Думаю данный функционал окажется очень полезным!