

Описание изначальной предметной области
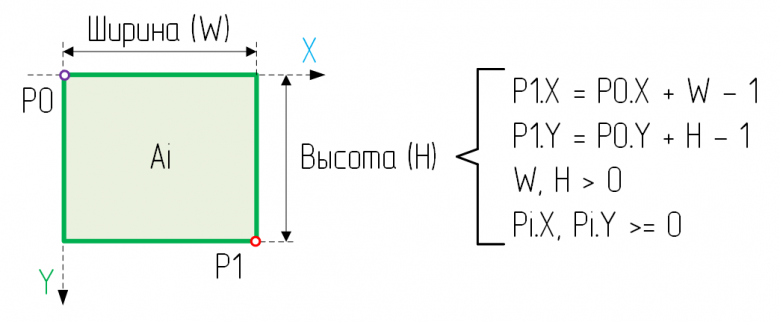
Изначальной задачей являлось определение конкретной области 2-х мерного пространства, которой принадлежит произвольная заданная точка, при условии наличия некоторой коллекции таких областей. Каждая область определяется двумя точками: начальной – P0, и конечной – P1 (рисунок 1). Вопрос заключался в том, каким образом организовать хранение и навигацию по данной коллекции для минимизации издержек и повышения производительности. Дополнительным условием, немного упрощающим реализацию алгоритма, являлась однозначность соответствия точек и областей, иными словами – области не пересекаются.
Наивная реализация предполагает создание массива, по которому можно осуществить поиск через простой перебор областей до момента нахождения искомой. Более продвинутая реализация, позволяющая сэкономить вычислительные ресурсы, в свою очередь, может базироваться на концепции KD-деревьев, о чем и будет рассказано в данной статье.
Пара слов о KD-деревьях
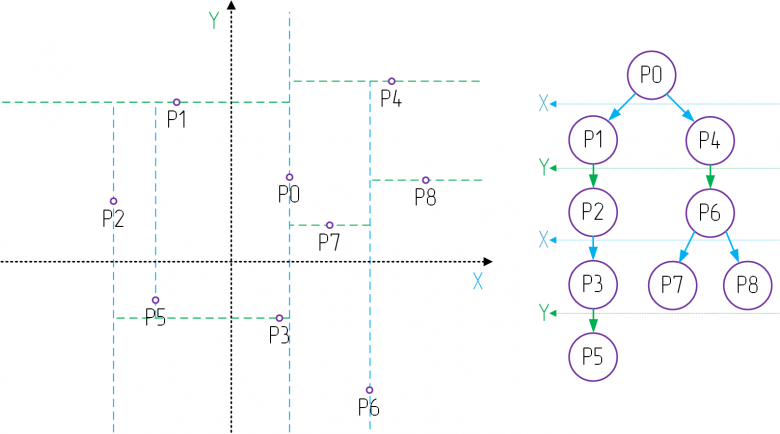
KD-дерево [1] – структура данных, позволяющая организовать хранение некоторой коллекции объектов (например, точек) N-мерного пространства через последовательную циклическую классификацию (разбиение) на подпространства по каждому из измерений. На рисунке 2 приведено облако точек, разделяющих общее пространство на подпространства, и их организация в виде дерева. Конкретные координаты каждой точки в данном примере не имеют значения, важны лишь их последовательность и относительное расположение. Классическая реализация предполагает применение бинарного разбиения с введением дополнительных параметров размерности для каждого выделяемого поддерева, что позволяет на этапе обхода выбирать только те узлы (ветви), которые потенциально могут содержать в себе искомый объект, а также осуществлять выборку по предельным расстояниям до искомого объекта.
Суть алгоритмов формирования и обхода деревьев
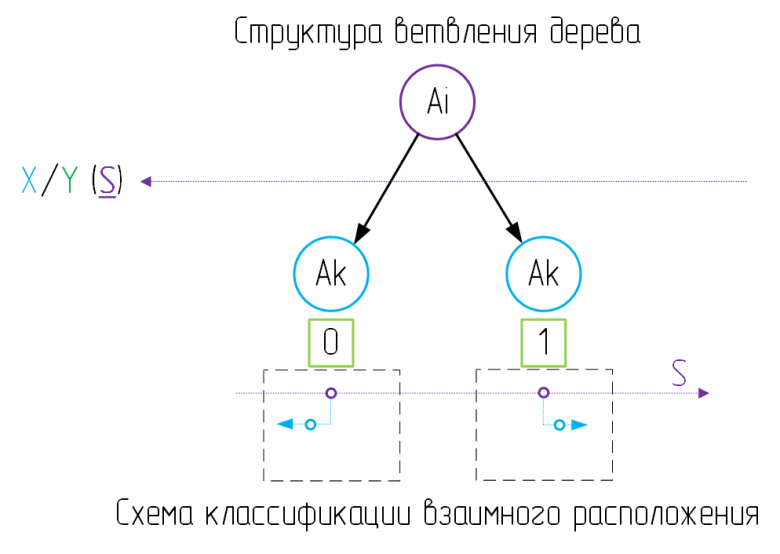
В отличие от классического KD-дерева, где многомерность исходного пространства проецируется в дереве путем последовательного чередования измерений при переходе между слоями, а сама топология дерева остается бинарной (двумерной), так как единичные координаты точек представляют из себя 0-мерные характеристики, взаимные расположения которых могут быть классифицированы двумя возможными случаями (рисунок 3); - предлагаемый алгоритм предполагает расширение дерева до 6-ти измерений, где каждой ветви потомков (Ак) конкретного узла (Ai) ставится в соответствие один из вариантов взаимного расположения отрезков в измерении S (X или Y, в зависимости от слоя), что обусловливается повышением размерности характеристик: отрезок определяется двумя точками (рисунок 4).
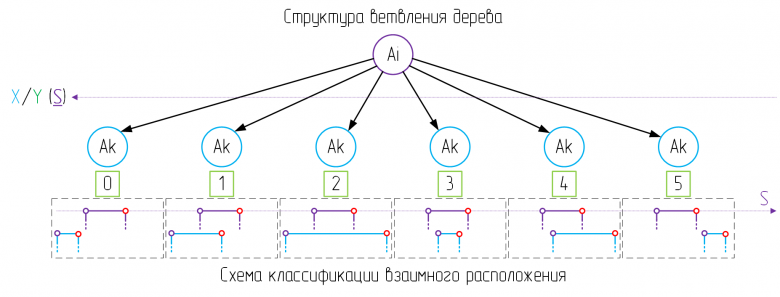
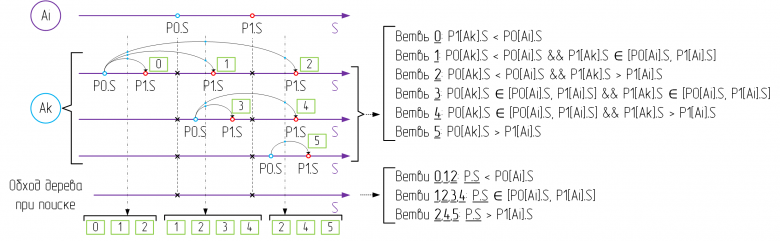
Классификация была осуществлена относительно расположения начальной точки (P0) второго сопоставляемого отрезка (рисунок 5), где принадлежность конкретному подклассу определяется положением его конечной точки. Из-за специфики невозможности задания отрицательной длины (в противном случае, точки, фактически, поменяются местами), количество возможных вариантов сужается при движении начальной точки от меньшего к большему значению, при условии фиксации положения базового отрезка (родительского), относительно которого осуществляется классификация на конкретном шаге. Фактические условия соответствий взаимных расположений классам также указаны на рисунке 5.
Обход дерева при поиске области, которой принадлежит заданная точка (P), требует перехода к дочерним узлам по подмножеству ветвей, обусловленному положением точки по отношению к базовому отрезку. На рисунке схематично видно, что это подмножество определяется через опускание мнимой линии с поиском пересечений с ранее выделенными классами. При заходе в конкретный узел осуществляется проверка условия принадлежности точки области (нахождение в подпространстве, ограниченном точками P0 и P1), выполнение которого обусловливает терминацию работы алгоритма поиска и возврат найденной области, в противном случае происходит переход к следующим узлам. Необходимо учитывать, что в случае, если топология пространства предполагает пересечение областей, то поиск будет осуществляться до достижения нижнего уровня дерева с возвратом коллекции найденных областей.
Применение алгоритма на практике
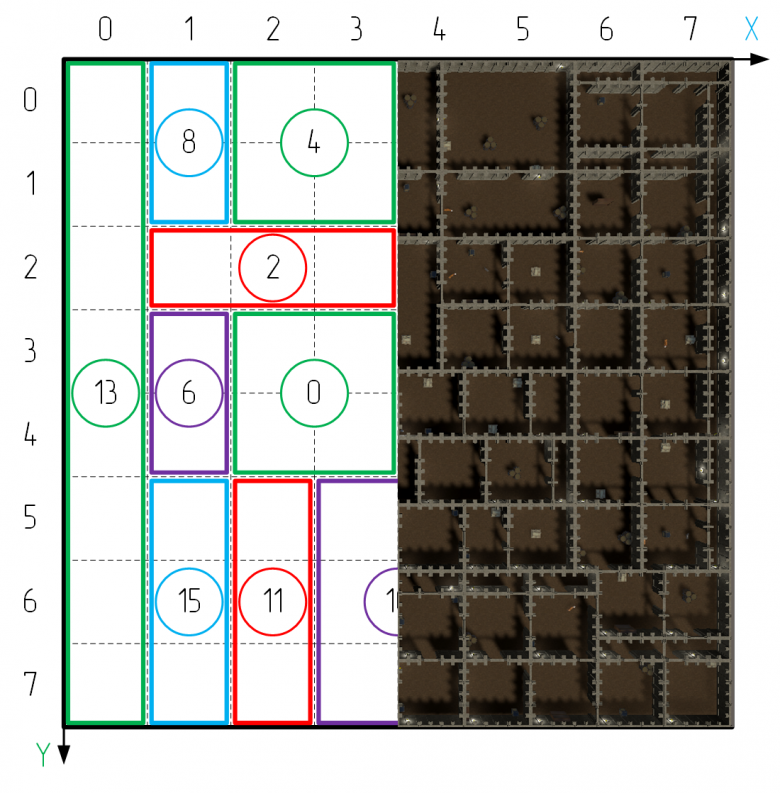
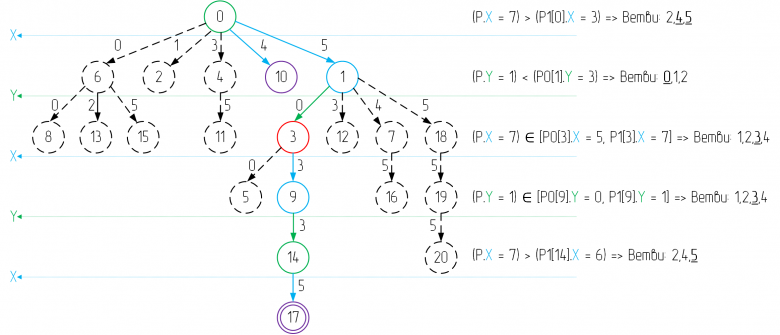
В качестве иллюстрационного примера ниже представлены пространство (8x8 клеток), разделенное между 21-ой областью (рисунок 6), и полученное на его основе дерево поиска (рисунок 7), где над ветвями указываются их классы взаимного расположения. Использовалось замощение пространства без пропусков (выполнение этого условия не является обязательным). При формировании дерева брались области в последовательности, соответствующей их индексам.
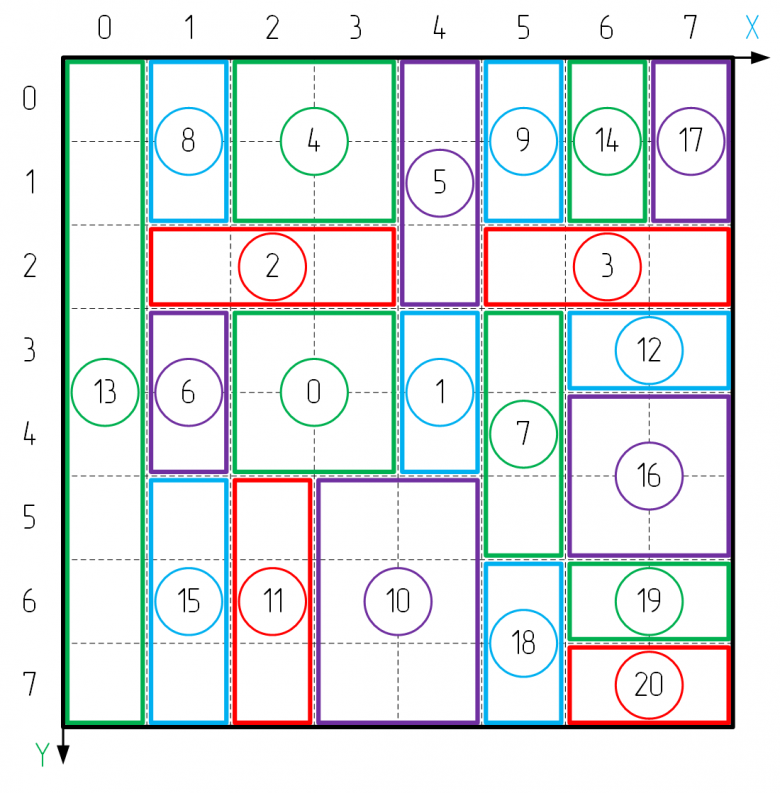
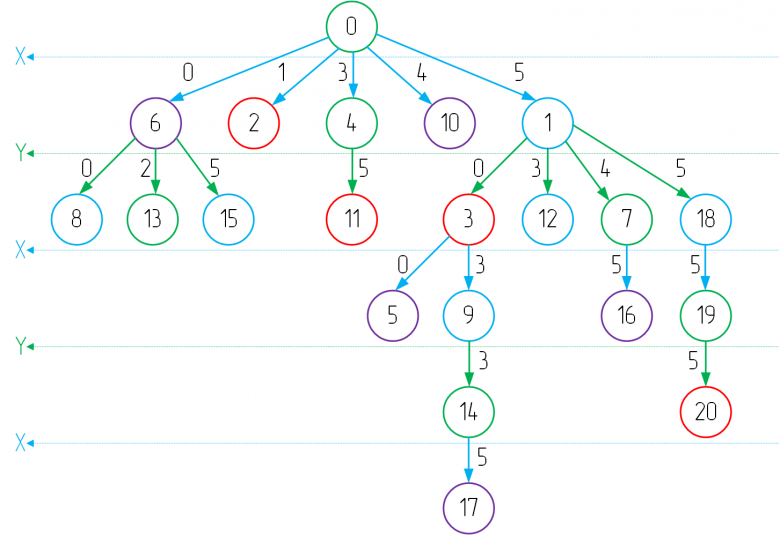
В качестве примера предлагаю рассмотреть поиск области для точки P (X = 7, Y = 1), обход дерева при котором представлен на рисунке 8. Обход при поиске осуществляется с заходом в поддеревья с учетом классификации взаимного расположения и при условии наличия узлов в соответствующих ветках. Цветом выделяются узлы, в которые был произведен заход. В результате алгоритм определил, что искомая область – под индексом 17, в чем можно удостовериться при взгляде на рисунок 6.
Результаты тестирования
При тестировании использовалась метрика количества проверок принадлежности точек областям. В качестве базового алгоритма выступила наивная реализация поиска областей через последовательный перебор массива (M1). Представленный в данной статье алгоритм – М2. В таблице 1 содержатся результаты тестирования. Можно заметить, что фактический выигрыш в производительности во многом зависит от размерности коллекции областей. Сценарием тестирования выступил последовательный поиск областей всех точек пространства. Стоит отметить, что фактическое время выполнения сценариев в первую очередь зависит от мощности вычислительной системы и от потенциального распараллеливания процесса поиска.
Размер пространства |
Кол-во областей |
M1 |
M2 |
M2/M1 |
8x8 |
21 |
685 |
273 |
39.8 % |
30x30 |
124 |
55328 |
7841 |
14.1 % |
100x100 |
1366 |
6801705 |
370722 |
5.4 % |
Послесловие
Автор данной статьи не заявляет исключительные интеллектуальные права на описанный алгоритм. В случае, если он уже был описан в профильной литературе, изложенный материал может быть рассмотрен в качестве дополнительной иллюстрации и будет принят во внимание искушенными читателями. Недостатком данного алгоритма является отсутствующая масштабируемость при изменении размерности пространства, тогда как обычные бинарные деревья являются универсальными.
wataru
Очень плохо написанно. Ничего не понятно. Одно ясно - у вас никакое не kd дерево.
Не факт что такое ваше дерево вообще можно для всех конфигураций построить. И оно точно не сбалансированно, да и поиск тут идет сразу в несколько ветвей, так что это максимум эврестическое отсечение. Тогда уж используйте R-tree. Тоже эвристическое отсечение, но стандартно и понятно.
Но у вас тут задача имеет очень важное упрощение: все области прямоугольники, выравненные по осям координат.
Тут есть много решений, но мое любимое требует O(n log n) памяти и работает за O(log n). Разбейте все пространство на вертикальные полосы всеми вертикалными границами всех областей. В каждой из полос у вас есть несколько неразывных горизонтальных отрезков и вам надо лишь найти ближайший к точке сверху или снизу. Это и будет границей области, в которую ваша точка может быть входит. Но наивная реализация этого алгоритма будет плохой, ведь каждая область разобъется на O(n) отрезков в куче полос, так что тут будет O(n^2) памяти.
Но тут на выручку приходит классная структура данных - персистентное балансированное дерево поиска. Она позволяет добавлять элементы и удалять их, при этом создает новый снимок структуры. Состояние до изменения все еще доступно. При этом новый снимок добавит лишь O(log n) памяти. А так это обычное дерево поиса, и таме можно найти ближайшее число снизу/сверху.
Итак, каждая область преобразуется 2 события: во время x0 создаются отрезки y0 и y1. Во время x1 они исчезают. Отсортируйте все события, потом применяйте их по одному в дерево. В дереве вы храните ключи - y координаты, ну и к ним в навесок id объекта.Если следующее событие больше по времени текущего, сохраните корень дерева с текущим временем в массив.
При запросе найдите бинарным поиском "время", оно же x координату, ближайшую к искомой точке. Потом в этом дереве найдите живой отрезок ближайший к искомой y координате. Проверьте, что точка лежит в области которая создала этот отрезок.
Есть небольшой крайний случай - когда области касаются. Надо из дерева брать 2 элемента, если они одинаковые.
DemiEljar Автор
Старался максимально подробно все разжевать и проиллюстрировать.
Спорное утверждение с вашей стороны, при условии, что KD-дерево – метод упаковки многомерного пространства в древовидную структуру, формальные условия для такого определения алгоритм, представленный в статье, выполняет.
Вопрос в том, что мы подразумеваем под конфигурацией, ограничений на положение областей в пространстве нет.
Я и не говорю, что получаемое дерево будет обязательно сбалансированным. Да, описанный алгоритм является эвристическим отсечением, но гарантирующим снижение издержек.
Да, это следует из определения «области», которое дается в самом начале.
Я благодарен вам за предоставленный комментарий и за то, что вы поделились альтернативным решением, но фактически, нападки в мою сторону, как мне кажется, обусловливаются тем, что вы не нашли в моей статье того решения, которое предполагали. Я ставил своей целью продемонстрировать один из потенциальных путей решений конкретной задачи, на который наткнулся в процессе экспериментов, поделиться им с читателями и сформировать понимание, что работа с деревьями — это не просто абстрактная сортировка, а в первую очередь – принцип применения некоторой классификации ко множеству объектов.
wataru
Ну так R-дерево, квадро-дерево, многоменрые деревья отрезков тоже "упаковывают многомерное пространство в древовидную структуру". Но они не KD-дерево. Ваша структура тоже отличается от KD-дерева. Главное отличие, что оно не разбивает пространство. В KD-дереве, когда вы ищите точку, вы идете только в одну сторону. Тут же вам надо идти сразу в несколько веток, потому что отрезки лежат как попало.
Вы тут не пространтсво разбиваете, а группируете объекты, так что ваша идея концептуально ближе к R-дереву. Но вы не используете отсечения, вроде обрамляющих прямоугольников, ваши отсечения сильно слабже.
Да и эффетивнее и проще было бы не 6 случаев отрезков рассматривать, а всего три: отрезок целиком ниже/левее отсекающей координаты, целиком выше/правее, или пересекается с ней. Тогда при поиске вы всегда выбрасываете одну из веток - котора я лежит в противоположной с искомой точкой полуплоскости.
И я вам в ответ привел широко известное, более эффективное решение.