

Где языковая модель хранит порядок слов, грамматику и смысл — и зависит ли это от архитектуры? Я обучил 12 небольших моделей, которые отличаются только архитектурой, и проверил линейными пробами каждый слой каждого чекпоинта. Короткий вывод: на этом масштабе заметнее всего различается то, как хранится позиция токена (номер токена в окне; про позицию в документе см. раздел 1а), а для синтаксиса и смысла модели при равном loss выглядят похоже.
Сравнивал RWKV-7, трансформер с RoPE и трансформер без позиционного кодирования (NoPE). Размеров два (56.6M и 115M параметров), языков два (русский, английский), на модель 1–2 млрд токенов, по 21 чекпоинту на прогон, у 9 из 12 прогонов есть второй сид инициализации.
Номер токена в окне линейная проба считывает из NoPE почти идеально, из RoPE заметно хуже, из RWKV ещё хуже (R² от log(1+t) на лучшем слое: 0.99 / 0.38–0.51 / 0.29–0.42). Это воспроизводится на обоих языках, обоих размерах и обоих сидах.
Но в окно упакованы несколько документов. По расстоянию от границы документа разрыв RoPE − NoPE почти исчезает (−0.05…−0.08 вместо −0.73…−0.81 на тех же позициях), у RWKV он сокращается с около −0.9 до −0.20…−0.32. Нелинейная (MLP) проба добавляет RoPE до 0.17 R² по номеру в окне, а RWKV почти ничего. Порядок сохраняется.
Глубина слова в дереве зависимостей даёт тот же порядок, но с гораздо меньшим разрывом (0.02–0.06).
Всё остальное — не больше 0.02–0.03 или в пределах разброса между сидами.
У RWKV пик «синтаксических» проб приходится на слои на 1–4 ниже, чем у трансформеров, но это наводка, а не результат (подробности ниже).
Модели маленькие, корпуса скромные. «Различий нет» здесь значит «не видно на этом масштабе», а подтвердившиеся различия — не закон архитектур. Код, результаты и чекпоинты открыты: репозиторий, чекпоинты сида 0.
Зачем это нужно
Языковой модели нужно знать, где в тексте стоит токен, какую роль он играет в предложении и что он значит. Три способа получить порядок слов:
RoPE — трансформер получает позицию, поворачивая запросы и ключи в внимании.
NoPE — у трансформера нет позиционного кодирования вообще, единственный источник порядка — причинная маска. Haviv и др. показали, что такие модели всё равно выучивают позиционную информацию (arXiv:2203.16634).
RWKV-7 — рекуррентное состояние без внимания; порядок встроен в то, как это состояние обновляется. Я обучил согласованные модели каждого вида и спросил: в каком слое то или иное свойство читается линейно, и чем это отличается между архитектурами?
Модели обучались и проверялись на сервере, предоставленном Bo Peng, автором RWKV. Это третья статья серии: раньше были про квантизацию RWKV-7 и про state tuning против системного промпта.
Сначала прочитайте это. Модели маленькие (56.6M и 115M параметров), обучены на 1–2 млрд токенов скромного корпуса, сида два, и они меняют только инициализацию (порядок данных одинаковый). Разброс по двум сидам — ориентир, а не доверительный интервал.
Что именно я сделал
Модели
56.6M («M») |
115M («L») |
|
|---|---|---|
ширина × слои |
512 × 12 |
768 × 12 |
токенов / шагов |
~1.0 млрд / 3 800 |
~2.0 млрд / 7 600 |
learning rate |
1e-3 |
6e-4 |
Остальное одинаково: контекст 1024, 256 последовательностей на шаг, AdamW, warm-up 100 шагов, косинусный спад до lr/10, обрезка градиента 1.0, bf16, BPE-токенизатор на 16k на язык. Порядок данных одинаков во всех прогонах, сид меняет только инициализацию. Корпус — около 2.1 млрд токенов на язык, 76 % из них Википедия; остальное литература, наука, новости и разговорные тексты (подробно).
Финальный val-loss (сид 0 | сид 1):
RWKV-7 |
Трансформер RoPE |
Трансформер NoPE |
|
|---|---|---|---|
ru M |
2.554 | 2.554 |
2.683 | 2.667 |
2.786 | 2.802 |
ru L |
2.318 | 2.320 |
2.422 | 2.423 |
2.505 | 2.506 |
en M |
2.764 | 2.765 |
2.893 | 2.892 |
2.993 | 3.011 |
en L |
2.534 | — |
2.640 | — |
2.725 | — |
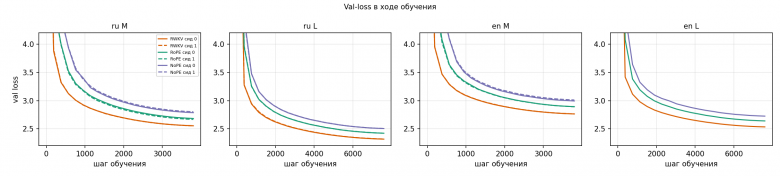
Здесь сразу видна проблема сравнения: RWKV-7 заканчивает на 0.10–0.13 ниже RoPE, то есть финальные чекпоинты просто не сопоставимы. Модель с меньшим loss может выглядеть «умнее» по любой пробе уже по этой причине. Поэтому я сравниваю архитектуры при равном val-loss.
Пробы
Проба — это простая модель (линейная ridge-регрессия или классификатор) на замороженном скрытом состоянии токена, обученная отдельно для каждого из 13 слоёв (эмбеддинги и 12 блоков). Она измеряет то, что читается линейно, а не то, что модель использует. Я проверял:
позицию токена (R² для log(1+t));
синтаксис русского (SynTagRus): роль в предложении, глубину в дереве зависимостей, селективность UPOS;
морфологию: падеж, род, время, вид;
смысл: омонимы, парафразы против сложных пар (наборы я написал сам);
тональность (русский и английский). Для задач со словами использовалось состояние последнего субтокена слова. Контрольные задачи со случайными метками дают селективность (реальная точность минус контроль, по Hewitt и Liang), а случайно инициализированная сеть (шаг 0) — нижний ориентир.
Что такое «позиция»
t — номер токена в окне (0–1023). Обучающий поток собран из кусков не длиннее 4096 токенов, перемешанных, после каждого куска стоит токен <|doc_sep|>; блоки по 1025 токенов берутся из потока подряд, поэтому в одно окно попадают несколько кусков. У трансформеров причинное внимание без маски по документам, у RWKV состояние на границах не сбрасывается. d — число токенов после ближайшего <|doc_sep|> слева (0 у первого токена документа). Оно известно только там, где разделитель есть в окне: у 43 % позиций проб в русских окнах и 47 % в английских (в русских окнах в среднем 1.42 границы на окно, в 35 % окон их нет вообще).
Как сравниваю при равном loss
Для каждой пары архитектур я интерполирую каждую пробу по val-loss на 21 чекпоинте и сравниваю на 4 уровнях loss: худший финальный loss из трёх архитектур, затем +0.1, +0.3, +0.6. Δ — первая архитектура минус вторая.
Различие я называю устойчивым, если выполнены три условия: оба сида, один знак на всех 4 уровнях и |Δ| больше разброса между сидами (средний |сид 0 − сид 1| у одной архитектуры). Два сида — не доверительный интервал, поэтому слово «значимо» я не использую.
Результаты
1. Номер токена в окне: NoPE ≫ RoPE > RWKV
Проба предсказывает log(1+t), где t — номер токена в окне (не в документе: см. раздел 1а). На финальном чекпоинте R² лучшего слоя равен 0.99 у NoPE во всех четырёх конфигурациях, 0.38–0.51 у RoPE и 0.29–0.42 у RWKV. NoPE к 3-му слою достигает R² ≈ 0.98 (0.84–0.95 уже на 2-м слое), до 11-го слоя держится не ниже 0.85 и падает до 0.22–0.44 на последнем.
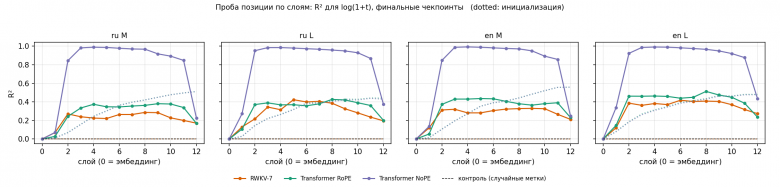
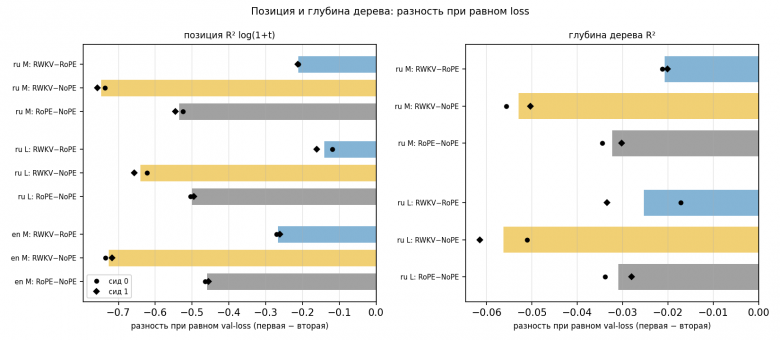
При равном val-loss разность RWKV − NoPE по R² равна −0.64…−0.75, RoPE − NoPE: −0.46…−0.54, RWKV − RoPE: −0.14…−0.27. Это верно для моделей 56.6M и 115M, для русского и английского, в обоих сидах (у английской 115M один сид).
Три вещи, которые нужны для правильного чтения:
Случайно инициализированный трансформер уже имеет R² от 0.44 до 0.56, потому что одна причинная маска даёт позиционный сигнал. Поэтому правильный ориентир для трансформера — шаг 0, а не ноль.
RoPE в ходе обучения эту информацию теряет (русский 56.6M: 0.51 → 0.38; английский: 0.56 → 0.44). Это согласуется с идеей, что позиция вводится прямо в внимание и ей больше не нужно храниться в остаточном потоке, но это объяснение я не проверял.
Номер в окне — не положение в документе, а документы в окне перемешаны. Как это меняет разрывы, показано в разделе 1а. Позиция — не главный признак того, как устроена архитектура, а лишь тот, что различается сильнее всего. Подробнее: позиция, позиция против loss.
1а. Позиция внутри документа: разрыв почти исчезает
Этот раздел появился после комментария к статье: если в окно упаковано несколько документов, номер токена от начала окна мало что говорит о положении в своём документе, а модели полезнее знать именно его (расстояние от последнего разделителя). Кроме того, линейная проба могла не видеть позицию, лежащую нелинейно. Я проверил оба предположения.
Что сделано. Для каждой позиции проб посчитано d — расстояние до ближайшего <|doc_sep|> слева. Проба предсказывает log(1+d) и, для сравнения на тех же строках, log(1+t); берутся позиции с известной границей (набор из 1200 окон, на русском около 48 тыс. обучающих строк). Старая цель на тех же окнах воспроизводит числа раздела 1. Сравнение при равном loss и критерий «устойчиво» те же. Дополнительно MLP-проба (один скрытый слой на 512 нейронов, GELU, 40 эпох, лучшая эпоха по dev, нижняя граница — константный предсказатель; контроль со случайной целью даёт R² 0.00). Первый вариант MLP переобучался (контроль около −0.1), я его исправил по контролю на одной модели и больше не подбирал. Корреляция log(1+d) с log(1+t) на этих строках около 0.4, так что цели в основном разные.
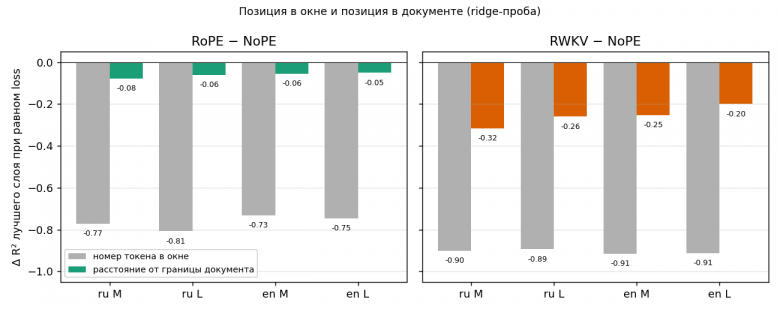
Разности при равном loss, линейная (ridge) проба; на строках с известной границей, среднее по 4 уровням и по сидам (у en L один сид):
цель |
RWKV − RoPE |
RWKV − NoPE |
RoPE − NoPE |
|
|---|---|---|---|---|
ru M |
окно |
−0.131 |
−0.902 |
−0.771 |
ru M |
документ |
−0.239 |
−0.316 |
−0.077 |
ru L |
окно |
−0.086 |
−0.894 |
−0.808 |
ru L |
документ |
−0.199 |
−0.259 |
−0.060 |
en M |
окно |
−0.182 |
−0.915 |
−0.732 |
en M |
документ |
−0.197 |
−0.252 |
−0.055 |
en L |
окно |
−0.166 |
−0.913 |
−0.746 |
en L |
документ |
−0.149 |
−0.199 |
−0.050 |
Для ru M, ru L и en M все эти сравнения проходят критерий «устойчиво». R² лучшего слоя на финальном чекпоинте (сид 0), RWKV / RoPE / NoPE:
окно |
документ |
|
|---|---|---|
ru M |
0.080 / 0.125 / 0.985 |
0.666 / 0.865 / 0.951 |
ru L |
0.094 / 0.115 / 0.980 |
0.662 / 0.888 / 0.947 |
en M |
0.055 / 0.157 / 0.986 |
0.746 / 0.893 / 0.953 |
en L |
0.079 / 0.143 / 0.984 |
0.764 / 0.911 / 0.960 |
MLP-проба. Для ru M, ru L и en M два сида, для en L один. По расстоянию от границы документа RoPE − NoPE: −0.055 (ru M), −0.059 (ru L), −0.040 (en M), −0.050 (en L); RWKV − NoPE: −0.253, −0.227, −0.208, −0.176. По номеру в окне на всех позициях MLP добавляет RoPE R² на финальном чекпоинте (ridge → MLP): ru M 0.380 → 0.484, ru L 0.426 → 0.456, en M 0.436 → 0.604, en L 0.512 → 0.586. У RWKV 0.286 → 0.320, 0.423 → 0.393, 0.329 → 0.350, 0.417 → 0.380, то есть нелинейная проба почти ничего не меняет. На строках с известной границей RWKV номер в окне не читает и MLP-пробой (R² около 0).
Что из этого следует.
Разрыв RoPE − NoPE по позиции в основном объясняется тем, что мерился номер в окне: по расстоянию от границы документа он сжимается с 0.73–0.81 до 0.05–0.08. Кроме того, часть позиции у RoPE лежит нелинейно, и линейная проба её занижала.
RWKV номер в окне на этих позициях почти не хранит, а расстояние от границы хранит (0.66–0.76). Разрыв с NoPE сокращается с около 0.9 до 0.20–0.32, но не исчезает.
Порядок NoPE > RoPE > RWKV не меняется ни на одной цели и ни у одной пробы.
Не выяснено, почему у RWKV R² по номеру в окне на всех позициях 0.29–0.42, а на позициях с известной границей около 0.01–0.09. Гипотеза (не проверена): сигнал даёт «разогрев» состояния, которое в начале окна равно нулю. Ограничения этой проверки: d определено только у 43–47 % позиций (подвыборка смещена к близким границам); «документ» — кусок до 4096 токенов с разделителем в конце, не обязательно целая статья; модели обучены без маскирования по границам, что дало бы маскирование, не проверялось; у MLP-пробы нет разброса по её инициализации. Подробные таблицы: позиция внутри документа.
2. Глубина в дереве: тот же порядок, меньший разрыв
Для глубины слова в дереве зависимостей (русский, SynTagRus) порядок NoPE > RoPE > RWKV сохраняется на обоих размерах: RWKV − RoPE −0.021 и −0.025, RWKV − NoPE −0.053 и −0.056, RoPE − NoPE −0.032 и −0.031. Разброс между сидами 0.003–0.013.
Поскольку глубина слова коррелирует с его номером в предложении, я считаю это тем же эффектом, увиденным с другой стороны, а не отдельной находкой.
3. Малые различия
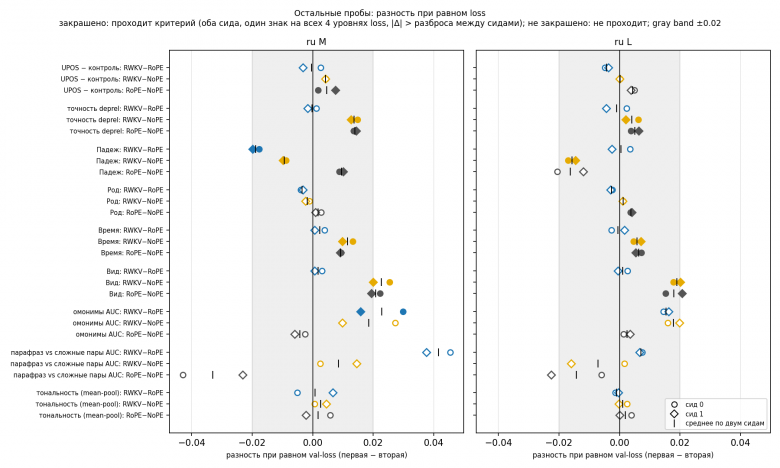
При равном loss все остальные пробы различаются на 0.003–0.03. На рисунке каждое сравнение (два сида и их среднее); закрашенные маркеры проходят критерий устойчивости.
Что выполняется в русском в обоих сидах:
Роль в предложении, время, вид: NoPE ниже RWKV и RoPE на 0.004–0.023, наибольший разрыв у вида (0.019–0.023). Между RWKV и RoPE различий нет.
Падеж: RWKV − RoPE −0.019 (только 56.6M; на 115M +0.001), RWKV − NoPE −0.009 и −0.016. Так что «RWKV и RoPE лучше NoPE» верно для роли в предложении, времени и вида, но не для падежа и не для глубины дерева.
Омонимы, RWKV − RoPE: +0.023 на 56.6M, +0.015 на 115M — это ниже разброса между сидами (0.015–0.019). В английском (один размер, 56.6M) RWKV выше NoPE на омонимах (+0.020), парафразах против сложных пар (+0.033) и тональности (+0.017). В русских моделях это не повторяется, английский набор на смысл маленький (16 слов), а разрыв 0.017 на 1 066 примерах тональности — около одной биномиальной стандартной ошибки (≈ 0.013). Поэтому я считаю эти различия слабыми.
Различий между архитектурами не видно у селективности UPOS (не больше 0.005, один размер), рода, тональности в русском и теста на парафразы. Тональность в основном лексическая: слой 0 уже даёт 0.83–0.85 (русский) и 0.70–0.72 (английский). Усреднённые по токенам парафразы отделяются от случайных пар уже на слое 0 (AUC 0.95–0.99), так что этот контроль мало говорит о слоях.
И отдельно о «преимуществах RWKV» на финальных чекпоинтах (омонимы в русском 0.876 против 0.819, тональность в английском 0.758 против 0.720): они в основном объясняются меньшим loss у RWKV и при равном loss уменьшаются или исчезают. Это хороший пример того, зачем нужно сравнение при равном loss.
Подробнее: все сравнения, морфология, смысл и тональность.
4. Какой слой: у RWKV пик раньше
Пробы синтаксиса и морфологии у RWKV достигают пика раньше. Для роли в предложении лучший слой у RWKV 7–8, у RoPE и NoPE 9–10; для глубины в дереве 7–8 против 9–10 у RoPE и 8–9 у NoPE; для падежа, рода и времени 4–9 против 7–11. Для вида RWKV и RoPE совпадают (5–6 против 6–7), NoPE позже (8–10). Омонимы везде пикуют поздно (слои 9–12). Для этих проб два сида согласуются в пределах 2 слоёв.
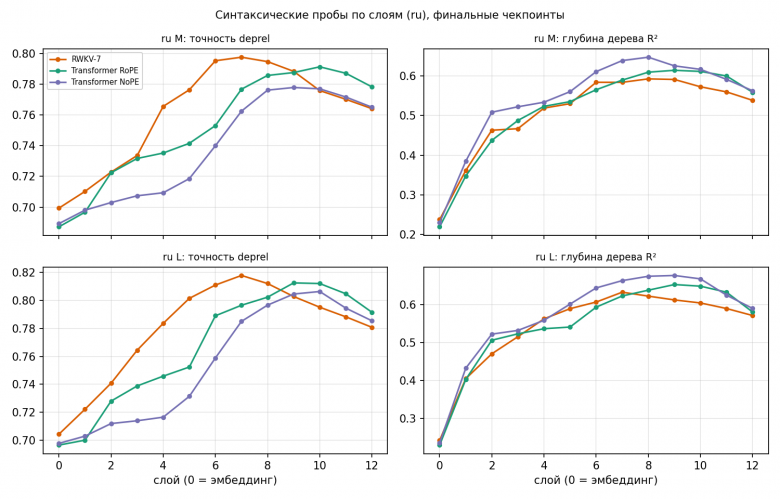
Два предупреждения. Пики считаны по финальным чекпоинтам, где у RWKV к тому же меньший loss, а кривые около максимума плоские (для роли в предложении и глубины лучший слой в среднем на 0.003, не более чем на 0.010, выше второго по качеству). И я не оценивал разброс самого слоя между сидами при равном loss. Относитесь к сдвигу как к наводке для более крупного исследования. Таблица лучших слоёв: docs/results.ru.md.
Что это показывает и чего не показывает
На этом масштабе самое явное различие между RWKV-7 и трансформерами — как хранится позиция; для синтаксиса и смысла модели при равном loss выглядят для линейной пробы похоже.
Это не показывает, что RWKV «понимает» меньше или больше. Линейная проба — один взгляд, а мои семантические тесты малы (20 русских и 16 английских слов).
Это не показывает, что происходит выше 115M параметров или за пределами 2 млрд токенов.
Размер разрыва зависит от того, что называть позицией: по номеру в окне разрыв RoPE − NoPE 0.5–0.8, по расстоянию от границы документа 0.05–0.08.
Порядок NoPE > RoPE > RWKV сохраняется и у линейной, и у MLP-пробы, но величины от этого зависят. Он ничего не говорит о том, какая модель лучше использует позицию.
Чему верить, а чему нет
Один автор, один набор рецептов, один прогон обучения на (архитектуру, язык, размер, сид); два сида меняют только инициализацию. У английской 115M второго сида нет.
Порядок данных не варьировался.
Расстояние от границы документа определено только там, где слева в окне есть разделитель (43–47 % позиций); «документ» — кусок до 4096 токенов. MLP-проба подобрана один раз по контролю со случайной целью.
Семантический тестовый набор написан мной, носитель языка его не вычитывал. Подсказка смысла стоит до слова (модели причинные); вариант с подсказкой после слова не измерялся.
Утечка в обучающий поток проверена только для русского синтаксического набора (SynTagRus): убрано 1 487 предложений и 10 документов. Предложения короче 12 токенов не проверялись. Для английского синтаксиса, тональности и семантических наборов утечка не проверялась.
Английский набор тональности приведён к нижнему регистру и с пробелами вокруг знаков, то есть сдвинут относительно обучающего текста.
Сравнение при равном loss — линейная интерполяция между чекпоинтами, взятыми каждые 5 % обучения, поэтому в начале обучения оно грубее.
Позиция и глубина в дереве не независимы. Для слоёв (раздел 4) оценки разброса при равном loss нет.
Лицензии корпусов и пробных наборов нужно прочитать перед повторным использованием: таблица лицензий. Полный список ограничений: docs/results.ru.md.
Что открыто
Код и результаты (код проб, все результаты в JSON, кривые val-loss, таблицы равного loss и лучших слоёв, скрипт рисунков): github.com/RafaelUI/rwkv-layer-probing_ARTICLE.
Чекпоинты сида 0: все 21 чекпоинт каждого из 12 прогонов (86.5 ГБ,
.pth) на Hugging Face: RafaelUI/rwkv-layer-probing-checkpoints. Чекпоинты сида 1 пока только на сервере обучения. Код обучения, конфиги и токенизаторы в репозиторий ещё не входят (что воспроизводится).Лицензия: Apache License 2.0. Обучающие корпуса и пробные наборы в репозиторий не входят и сохраняют свои лицензии.
Литература
Haviv, A. et al. Transformer Language Models without Positional Encodings Still Learn Positional Information. Findings of EMNLP 2022. arXiv:2203.16634.
Hewitt, J., Liang, P. Designing and Interpreting Probes with Control Tasks. EMNLP 2019. arXiv:1909.03368.
Kazemnejad, A. et al. The Impact of Positional Encoding on Length Generalization in Transformers. 2023. arXiv:2305.19466.
Su, J. et al. RoFormer: Enhanced Transformer with Rotary Position Embedding. 2021. arXiv:2104.09864.
Alain, G., Bengio, Y. Understanding intermediate layers using linear classifier probes. 2016. arXiv:1610.01644.
Tenney, I., Das, D., Pavlick, E. BERT Rediscovers the Classical NLP Pipeline. ACL 2019. arXiv:1905.05950.
Peng, B. et al. RWKV-7 “Goose” with Expressive Dynamic State Evolution. 2025. arXiv:2503.14456.
Nivre, J. et al. Universal Dependencies v2: An Evergrowing Multilingual Treebank Collection. LREC 2020. arXiv:2004.10643.
teraferma_io
Интересно, что именно считается позицией. Если в окно 1024 подряд упакованы несколько документов, то номер токена от начала окна для RWKV мало что значит: состояние стартует с нуля в начале окна, но в большинстве каналов затухание сильное, информация о начале окна быстро размывается, и модели незачем хранить абсолютный номер. А вот расстояние от последнего разделителя документа ей знать полезно. Вы не пробовали пробу на позицию внутри документа, от ближайшего EOS, вместо позиции в окне? Подозреваю, разрыв с NoPE там сократится. Кстати, к RoPE это тоже относится, если внимание не маскируется по границам документов. И второй вопрос: смотрели ли MLP-пробу на тех же слоях? R² 0,3–0,4 у линейной может означать, что позиция в RWKV есть, но лежит нелинейно.
RafaelUI Автор
Спасибо, это важное замечание. Позиция у меня считалась от начала окна в 1024 токена, а не от границы документа. Документы в потоке идут подряд через разделитель, в среднем около 680 токенов на русском, так что в большинстве окон есть граница, и интерпретировать «R² от номера токена» как что-то про архитектуру можно только с этой оговоркой. Пробу на расстояние до последнего разделителя я не делал и MLP-пробу тоже: все пробы в статье линейные, так что «читается линейно» не равно «отсутствует». Обе проверки добавлю и допишу результаты в статью, как только прогоню
RafaelUI Автор
Я добавил пробу на расстояние до ближайшего разделителя документа слева. Она определена там, где разделитель есть в окне (43–47 % позиций), и для сравнения я мерил на тех же строках и номер в окне. При равном val-loss, R² лучшего слоя, разность архитектур:
RoPE − NoPE: по номеру в окне −0.73…−0.81, по расстоянию от границы −0.05…−0.08;
RWKV − NoPE: по номеру в окне около −0.9, по расстоянию от границы −0.20…−0.32.
То есть для RoPE разрыв с NoPE почти исчезает, как вы и предполагали. У RWKV он сокращается, но остаётся: номер в окне на этих позициях он почти не хранит (R² 0.05–0.09), а расстояние от границы хранит заметно (0.66–0.76), но слабее RoPE и NoPE. Порядок NoPE > RoPE > RWKV сохраняется.
MLP-пробу тоже сделал. У RoPE номер в окне частично лежит нелинейно: MLP добавляет к линейной пробе +0.03…+0.17 R², так что линейная проба его занижала. У RWKV MLP почти ничего не добавляет. Контроль со случайной целью даёт R² 0.00.