

Недавно, просматривая фрагмент исходного кода, я наткнулся на следующий метод из Guava — популярной Java‑библиотеки от Google.
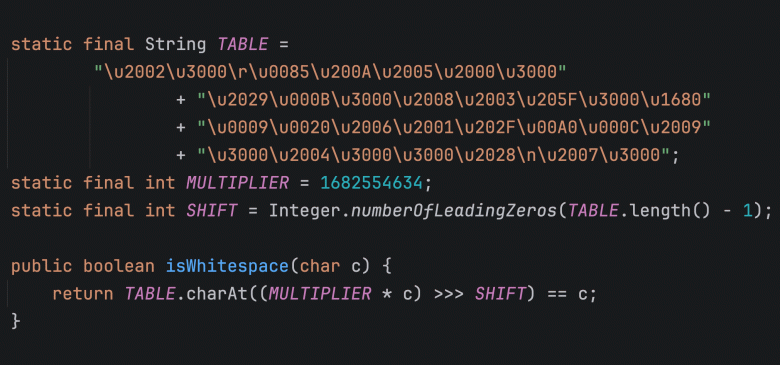
Как понятно из названия, этот метод проверяет, является ли заданный символ пробелом. Но код выглядит гораздо сложнее, чем тривиальная проверка c == ' '. Поэтому я заинтересовался и углубился в настоящую кроличью нору, пытаясь разобраться, откуда берётся вся эта сложность. Если вам тоже интересно, как работает этот код, то статья — для вас.
Что такое вообще «пробел»?
Исследуя работу функции, проверяющей, является ли символ пробелом, нужно первым делом определить, что такое «пробел». В самом деле, SPACE (U+0020) — пожалуй, самый известный символ пробела, но не единственный. Если вы пишете код уже достаточно давно, то, вероятно, сможете назвать ещё несколько похожих символов, например, неразрывный пробел NO‑BREAK SPACE (U+00A0), символ табуляции CHARACTER TABULATION (U+0009), переход на новую строку LINE FEED (U+000A).
На самом деле, их даже больше. В Unicode определяется свойство White_Space, в котором насчитывается 25 символов. Вот они все — я их тщательно скопировал , ,,, , ,
, , , , , , , , , , , , , ,
,
, , , .
У каждого из этих символов своё назначение. Например, FIGURE SPACE (U+2007) равен по ширине цифре в таблице, тогда как THIN SPACE (U+2009) и HAIR SPACE (U+200A)дают серию пробелов, в которой каждый следующий меньше предыдущего. NO‑BREAK SPACE (U+00A0) равен по ширине обычному пробелу, но при переходе на новую строку не даёт рассыпаться окружающему тексту.
Бывает нелегко сразу определить по названию символа, относится ли он к множеству пробелов. По внешнему виду глифа это также неочевидно. Например, ZERO WIDTH SPACE (U+200B) — вообще не пробел. Несмотря на название, это символ форматирования, указывающий, что здесь можно указать разрыв в слове или строке, не добавляя видимого промежутка.
Есть в этом множестве и не столь очевидные члены. Например, OGHAM SPACE MARK (U+1680) может отображаться как видимая горизонтальная линия. В шрифтах Ogham (огамическое письмо), где буквы нанизываются на центральную линию, пробел продлевает эту линию между буквами (напр., ᚛ᚆᚓᚂᚂᚑ ᚒᚑᚏᚂᚇ᚜), тогда как в шрифтах без центральной линии он пуст. Поэтому неверно даже такое допущение, что пробел — это обязательно пустота.
Различные среды выполнения, разные правила
Единое определение пробела полезны лишь при условии, если с этим определением все согласны. Но даже в одной и той же среде выполнения в некоторых библиотеках понятие пробела может трактоваться по‑разному.
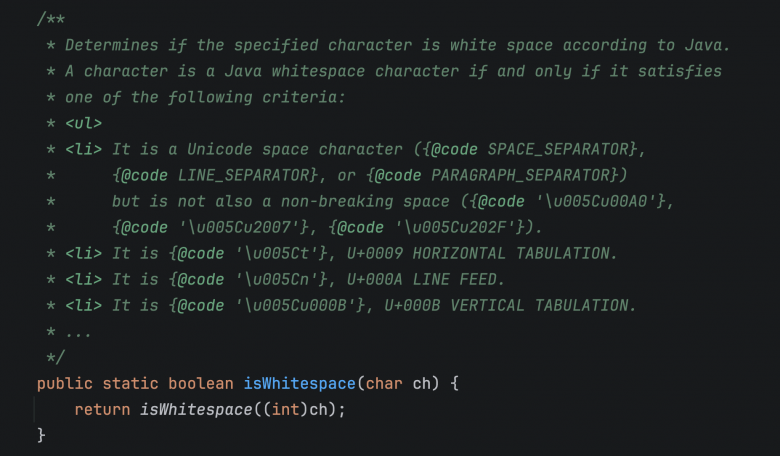
Рассмотрим NO‑BREAK SPACE (U+00A0), который я упоминал выше. Он входит в свойство Unicode White_Space, но в Java он явно исключается, наряду с ещё двумя неразрывными пробелами. В документации javadoc как раз подчёркивается, что этот метод проверяет наличие пробелов в соответствии с Java, а не в соответствии с тем свойством Unicode, которое мы рассмотрели выше.
Character.isWhitespace(' ');      // true
Character.isWhitespace('\u00A0'); // false
Но что насчёт других сред выполнения? Если рассматривать две более популярные, Python и JavaScript, то видим, что нет единого и признаваемого всеми списка символов. Например, в Python есть удобный метод str.isspace(). В отличие от метода из Java, он считает U+00A0 пробельным символом.
Так может быть, Python просто придерживается свойства White_Space из Unicode? Не вполне
"\u00A0".isspace()  # Истина
"\u0085".isspace()  # Истина
"\u001C".isspace()  # Истина
"\uFEFF".isspace()  # Ложь
В данном случае интересен FILE SEPARATOR (U+001C). Это управляющий символ ASCII, который исходно предназначался для разделения информативных фрагментов. Он не входит в состав свойства White_Space из Unicode. Так что в Python различается 29 пробельных символов, а не 25 как в Unicode.
В JavaScript — свой особый подход. Там нет метода, эквивалентного Character.isWhitespace(), но можно использовать в регулярном выражении класс символов \s:
/\s/.test("\u00A0");  // истина
/\s/.test("\u0085");  // ложь
/\s/.test("\uFEFF");  // истина
Наиболее странный из приведённых выше — NEXT LINE (U+0085). В Unicode он явно включается в White_Space, и в Python также признаётся, а в JavaScript — нет. Напротив, JavaScript признаёт ZERO WIDTH NO‑BREAK SPACE (U+FEFF), который Unicode не включает в это множество.
Другие среды выполнения я не рассматривал, но что‑то мне подсказывает, что несогласованности на этих трёх случаях не заканчиваются.
Ничто не является незыблемым
Ситуация дополнительно осложняется из‑за того, что Unicode остаётся динамичным и постоянно развивается. Это влияет на определение пробела. Например, в Unicode 6.3 MONGOLIAN VOWEL SEPARATOR (U+180E) переквалифицирован в из пробела в символ формата, и свойство White_Space у него удаляется. Таким образом, в Unicode множество пробелов сократилось с 26 символов до 25. Те среды выполнения и библиотеки, которые стремятся к обратной совместимости, не без труда справляются с такими вызовами, поскольку мы всегда стремимся, чтобы стандартная библиотека была настолько стабильной, насколько это возможно.
Быстрая проверка на наличие пробелов
Допустим, мы, наконец, условились о том наборе символов, которые хотим проверять — это актуальный набор пробельных символов по версии Unicode. Наивный способ реализовать это — перебрать список символов и проверить, совпадает ли каждый из них с одним из пробелов. Да, «mnjn подход рабочий, но определённо не самый эффективный. »
Итак, возвращаясь к реализации из Guava, которую мы видели в начале этой статьи — там была внедрена идеальная хеш‑функция. Это хеш‑функция, гарантирующая отсутствие коллизий хеша для всех символов из известного множества.
static final String TABLE = "\u2002...";

@Override
public boolean matches(char c) {
    int slot = (1682554634 * c) >>> 27;
    return TABLE.charAt(slot) == c;
Выше TABLE — это строка из 32 символов. Фактически, это хеш‑таблица, в которой каждый индекс (ключ) отображается на символ (значение). В ней содержатся 25 пробельных символов Unicode, плюс из нескольких дублей, заполняющих оставшиеся позиции.
В данном случае интереснее всего рассчитывать индекс. При умножении 1 682 554 634 * c получается 32-разрядное целое число, а >>> 27 смещает его на 27 разрядов вправо, изолируя пять наиболее значимых разрядов — это число в диапазоне [0, 32), который используется для поиска в таблице. Разумеется, возможных символов больше, чем записей в таблице. Поэтому нужна финальная проверка == c, позволяющая убедиться, что мы нашли именно тот символ, который искали.
Можете пощёлкать по символам, приведённым ниже и посмотреть, как именно заполняется таблица тут: https://serce.me/posts/2026-10-30-how‑hard‑is‑it‑to‑check‑for‑whitespace
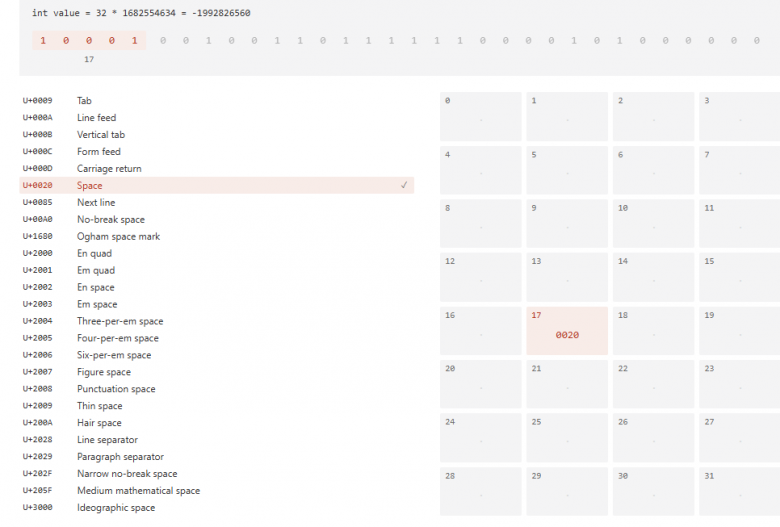
Волшебное число 1 682 554 634 не кажется особенно волшебным, и мне непонятно, как именно оно было выбрано (пожалуйста, поделитесь, если знаете ответ). Но это не единственный возможный множитель, и все подходящие варианты можно найти обычным поиском «в лоб» (простым перебором).
static final char[] ALL_CHARS = (
        "\u2002\u3000\r\u0085"
        + "\u200A\u2005\u2000"
        + "\u2029\u000B\u2008"
        + "\u2003\u205F\u1680"
        + "\u0009\u0020\u2006"
        + "\u2001\u202F\u00A0"
        + "\u000C\u2009\u2004"
        + "\u2028\n\u2007"
).toCharArray();

public static void main(String[] a) {
    var slots = new BitSet(32);
    outer:
    for (int mul = 1; mul != 0; mul++) {
        slots.clear();
        for (char c : ALL_CHARS) {
            int index = (mul * c) >>> 27;
            if (slots.get(index)) {
                continue outer;
            }
            slots.set(index);
        }
        System.out.println(mul);
    }
}
Интересно, что любой, кто хочет изучить эту проблему глубже, может посмотреть, как в Guava пришли к такой реализации. Для этого достаточно проверить историю git. Библиотека перешла от простого механизма сопоставления к версии mod-79. Здесь есть интересное наблюдение о наборе символов Unicode, но был и недостаток — операция деления. Затем её сменила версия с идеальной хеш‑функцией.
Если вам интересны другие варианты применения идеального хеширования — то, как ни странно, прямо когда я готовил эту статью, Дэниэл Лемайр опубликовал текст на ту же тему и разбирает в ней, как идеальное хеширование применяется для проверки HTTP‑методов.
Заключение
Когда я впервые увидел код для проверки пробелов в Guava, мне стало любопытно. В результате я узнал много нового о Unicode и познакомился с интересным применением идеальной хеш‑функции. Эта возможность не так часто применяется в реальных условиях.
Надеюсь, и вы узнали из этой статьи что‑то интересное. Если же и вам что‑то показалось любопытным, тоже напишите об этом пост в блоге. Думаю, такие записи всё реже встречаются в современном мире, переходящем на ИИ‑тексты, и всё меньше авторов, готовых заглянуть под капот даже такой простой функции как isWhitespace.
Комментарии (9)

vasyakolobok77
16.11.2026 09:18В свое время тоже бились над обработкой "всех" пробелов.
В дополнение к https://serce.me/posts/2026-10-30-how-hard-is-it-to-check-for-whitespace еще пробельные символы
u+001c  file separator
u+001d  group separator
u+001e  record separator
u+001f  unit separator
u+200b  zero width space
u+2060  word joiner
u+feff  zero width non-breaking space, byte order mark

MaximianQaAuto
16.11.2026 09:18На автотестах это больнее всего бьёт по суммам.
NumberFormatпод ru-локаль отдаёт «1 000» с U+00A0 внутри, и ассерт со строкой набранной руками падает. В отчёте две одинаковые строки, сидишь смотришь на них как баран) а trim() его, как вы показали, не видит
vadimr
Как любят люди всё запутать.
Реализация здорового человека:
domix32
Щас бы в свой JS или питон лисп добавить
vadimr
Тут же вопрос не в лиспе как таковом, а в том, что редко принято хотя бы немного подумать при реализации. А не то чтобы уж там формальную семантику прослеживать.
Какой там уж вайбкодинг, если слово "пробел" все де-факто понимают по-разному. Хотя, казалось бы, специально для этого придумали стандарт.
vasyakolobok77
В том и печаль, что в стандарте не все "пробельные" символы помечены как пробелы. И еще печаль, что в java уже 2 метода обрезки пробелов .trim / .strip и ни один не убирает все пробелы.
vadimr
Учитывая многочисленность видов письменности в Unicode, далеко не все из которых имеют линейное представление, то задача выделения визуальных пробелов вообще, по-видимому, не имеет точной постановки и, соответственно, точного решения (хотя, если ограничиться наборами символов для русского, английского и китайского языков, то всё очень упрощается – при всей многочисленности иероглифов, китайская письменность строго линейна и вдобавок почти полностью моноширинна). Но в общем, на мой взгляд, разумным подходом является считать пробелом именно то, что так названо в стандарте.
domix32
Ну, можете сравнить дату появления unicode с датой появления какого-нибудь isspace в стандартной библиотеке Си, например. Или дату появления языка Python. На какой стандарт должны были опираться те люди.
vadimr
Ну Scheme в 1975 году появился, а Лисп в 1958, задолго до Питона и Си, и это им не мешает опираться на актуальные стандарты.