

В последние годы технология Digital Twin превратилась в один из главных трендов промышленной автоматизации. Крупные вендоры — Siemens, Schneider, Aveva, и десятки других предлагают платформы, в которых «двойник» обещает предсказывать отказы, оптимизировать режимы, экономить миллионы. Аналитики Gartner и MarketsandMarkets оценивают рынок в десятки миллиардов долларов к концу десятилетия.
На практике картина скромнее. Многие компании ограничиваются цифровыми двойниками отдельных технологических процессов: локального техпроцесса, конкретной линии розлива, конкретного узла. И только единицы, как правило, крупные корпорации с собственными R&D‑командами доходят до цифровых двойников инфраструктуры целиком: завода, месторождения, трубопроводной системы на сотни километров.
Между этими подходами лежит, не столько технологический, сколько организационный и интерфейсный разрыв.
В этой статье я подробно расскажу о практических подходах к построению Digital Twin решений который относятся к классу ПО интеллектуальных корпоративных систем интеграционного менеджмента информации (ИКСИМИ), а также расскажу про ограничения, грабли и подводные камни с которыми сталкиваются разработчики. Я AI\ML исследователь и специализируюсь на интеллектуальных системах управления корпоративными данными. Мои публикации на тему гибридных информационных систем, интеллектуальных графов и кластерной AI маршрутизации можно найти в Хабр статьях и в ORCID
Организационный и интерфейсный разрыв
Организационный разрыв возникает из‑за того, что цифровой двойник требует единой модели данных. К ней не готовы ни текущие СЭД, ни MES, ни ERP, ни многочисленный «зоопарк» офисных форматов данных. Половина сопроводительной инженерной документации до сих пор создается и хранится в текстовых и табличных редакторах на рабочих машинах сотрудников. Каждый источник проектировался автономно: у него свой владелец и свой формат идентификаторов.
Интерфейсный разрыв кроется в том, что даже там, где данные удалось свести вместе, пользователю предлагают либо красивую 3D‑модель без документов, либо сложный документо‑центричный интерфейс без пространственного контекста, либо чат с LLM, который ничего не знает о физическом объекте и семантическом контексте. Три мира, три отдельных окна, три разных способа мышления.
При этом запрос на связность давно назрел. Инженеру на площадке нужно не «предсказание отказа по вибрации» (это уровень зрелого двойника), а базовое: найти документ по физическому объекту. Открыть паспорт задвижки, кликнув на неё в модели. Понять, какие акты опрессовки относятся к этой линии. Спросить у ассистента «что нужно проверить перед пуском?» и получить ответ со ссылками на регламент и страницу, а не общими словами из интернета или ИИ.
Стартовый вход в эту технологию может строиться на синхронизации нормативной, рабочей, документации с 3D визуализацией обьекта. Методов агрегации для различных систем несколько и в своей архитектуре я стараюсь придерживаться подхода независимой агрегации, когда в составе интеграционной системы сервис — агрегатор «пылесосит» все доступные (охваченные интеграциями) ресурсы и связывает данные с физическими обьектами, базами знаний, хранилищем и обьектами цифровых двойников
От проблемы до решения как связать 3D‑модель, документацию и Hybrid RAG‑ассистента в один интерфейс
Проблема
Представьте типичную ситуацию на промышленном объекте. Есть инженерная установка, например, тепловой узел, система вентиляции, топливораспределительная инфраструктура с трубопроводами, насосами. Есть сотни документов: паспорта, акты опрессовки, регламенты ТО, ГОСТы, чертежи, наряды на ремонт. Возможно даже есть 3D‑модель, которая лежит в отдельном файле и открывается в отдельной программе.
Инженеру нужно быстро ответить на вопрос: «Что нужно опрессовать в этом квартале?» или «Где паспорт на этот насос?» или «Покажи все акты, где упоминается водородная линия».
Что происходит сейчас:
3D‑модель открывают в одной программе (Navisworks, Revit, GLTF‑вьювер).
Документацию ищут в другой (папки на сетевом диске, СЭД, локальные файлы).
Уточняю что‑то у коллег — в третьей (чат, почта, звонок).
Между этими мирами нет связи. 3D‑модель «не знает», что у сферы ЖК-01 есть паспорт 2023 года. Документ «не знает», к какому физическому объекту он привязан. А чат с документами не может показать, где этот объект находится.
Итак вы решили построить систему, в которой всё это связано. Формально цифровой двойник. На практике это новый способ навигации по объекту и документации одновременно. Не дублирующий реальные процессы. Сейчас этот путь который зачастую начинается с отказа от глобальных облачных, SaaS решений и входа в собственную разработку.
Логика решения.
Три ключевых принципа, на которых должна строится вся система:
Первый. Субъект это центр. Пользователь всегда находится «внутри» чего‑то: либо на уровне всей сборки, либо на уровне узла (сферы, трубы, насоса), либо на уровне конкретного документа. Все три панели интерфейса (3D, документы, чат) синхронно отражают этот субъект. Переключился на узел — 3D подсветил его, документы отфильтровались по нему, чат перешёл в область «узел»
Второй. Прямая и обратная связь. Из 3D можно попасть в документ (клик по сфере → её паспорт). Из документа — в 3D (открыт акт опрессовки → подсвечены все узлы, которые он затрагивает). Из чата — в оба (ответ ассистента содержит чипы узлов, клик по чипу переносит в 3D и открывает карточку узла).
Третий. Ассистент понимает контекст. Когда открыт документ, вопрос «о чём это?» обращается именно к этому документу. Когда выбран узел — к документам этого узла. Когда выбрана вся сборка — ко всему корпусу данных. Область поиска переключается автоматически и отображается в интерфейсе.
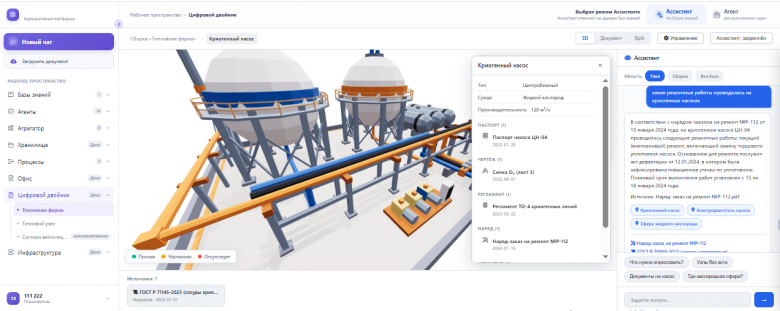
Технически это означает: единая модель данных (узлы, документы, связи many‑to‑mny), единое состояние UI (state‑driven), единый канал коммуникации между компонентами (WebSocket).
Что в такой архитектуре реализуется.
Навигация в 3D с подсветкой узлов. Сцена на базе viser показывает реальную GLTF‑модель установки. Каждый меш соответствует узлу. Клик по узлу → подсветка, карточка с атрибутами, список связанных документов. Программная подсветка работает извне: чат вернул узлы → они подсвечиваются в 3D без перезагрузки.
Просмотр PDF с текстовым слоем. Нативный PDF‑вьювер браузера не годится: он отдаёт выделение в свой iframe, а не в наше приложение. Поэтому документы рендерятся через PDF.js с текстовым слоем поверх canvas. Выделение текста работает как в обычном HTML, плюс поддерживается прямоугольное выделение области для графических модальностей (AIOCR — подробнее ниже).
-
Hybrid RAG‑ассистент с контекстом. Чат работает в трёх режимах:
Узел — поиск только в документах выбранного узла (причем каждый документ можно привязать к нескольким узлам)
Документ — поиск только в открытом PDF (полный текст передаётся в модель напрямую, без RAG — потому что документ и есть контекст)
Сборка / вся база — гибридный поиск по всему корпусу с фильтрацией по узлам в результатах
VL‑агент для изображений. Если в документе есть чертёж, схема, таблица‑картинка — выделяем прямоугольную область, нажимаем «VL‑агент», вводим вопрос. Визуальная модель получает картинку области и текст, отвечает по существу.
Инструменты работы с выделением. Выделили фрагмент в PDF, появилось плавающее меню: «Объясни», «Переведи», «Кратко». Ответ приходит в чат. Выделение сохраняется до следующего выделения или клика по документу.
Отображение релевантных документов — По каждому запросу отображается список релевантных документов, AI генерирует ответы, основанные на содержимом этих источников, обеспечение контекстной точности;
Автоматическая семантическая фрагментация, векторизация загружаемых документов, формирование векторного хранилища базы знаний при загрузке документов и связей
Семантические кросс‑языковые запросы на русском языке — Система поддерживает запросы на русском языке по мультиязычным документам, используя семантический кросс‑языковой подход, что обеспечивает поиск и извлечение релевантной информации независимо от языка оригинала
Подсветка базового фрагмента в тексте документа источника, использованного ИИ в качестве контекста. Возможность одним кликом перейти к фрагменту прямо из ответа;
Стриминг ответов. LLM отдаёт токены по мере генерации, интерфейс рендерит markdown на лету. Первые символы появляются через 1–2 секунды вместо 5–15.
Гибкая настройка прав пользователей, как на уровне интерфейса, так и на уровне RAG специфичных прав доступа пользователя к необходимым базам;
Гибкость в работе с базой документов. После работы с выбранным документом пользователь может вернуться к общей базе знаний\сборке\узлу и продолжить задавать вопросы, охватывающие все доступные источники;
Технология гибридного RAG, включая семантический и несколько видов ключевого поиска, обеспечение точности и релевантности результатов + Обогащение и предобработка запросов, формирование уточненных промежуточных запросов для повышения релевантности извлеченного контекста;
Возможность полностью автономной работы системы, без сети интернет, в закрытом информационном контуре. Архитектура обеспечивает локальную обработку, хранение, извлечение, и ИИ генерацию;
Единый интерфейс документа с чатом, без необходимости переключения между окном просмотра и чата ИИ ассистента;
Панель администрирования — Отдельная модалка для загрузки документов, привязки к узлам, ручной пересборки индексов.
Архитектура
Под капотом такого решения не используется готовых RAG‑фреймворков, весь пайплайн построен на базовом низкоуровневом AI\ML стеке:
ML стек: PyTorch, Transformers
Векторный поиск: Семантика — sentence‑transformers, Векторный индекс — FAISS
Модели: NLP — spaCy, Embedding — e5 LLM (рекомендуемые): Облачные gpt-4o‑mini, Локальные семейство qwen3
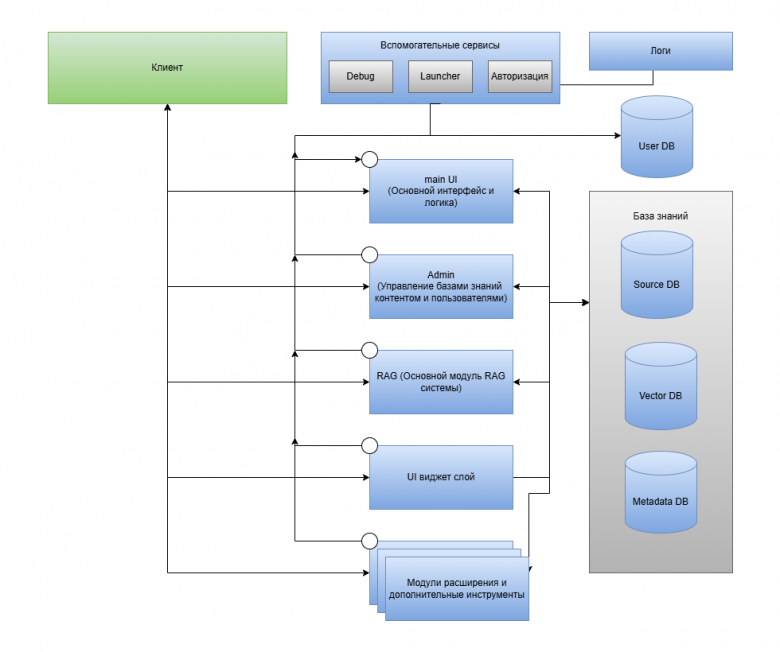
Три сервиса, которые работают параллельно и синхронизируются через WebSocket.
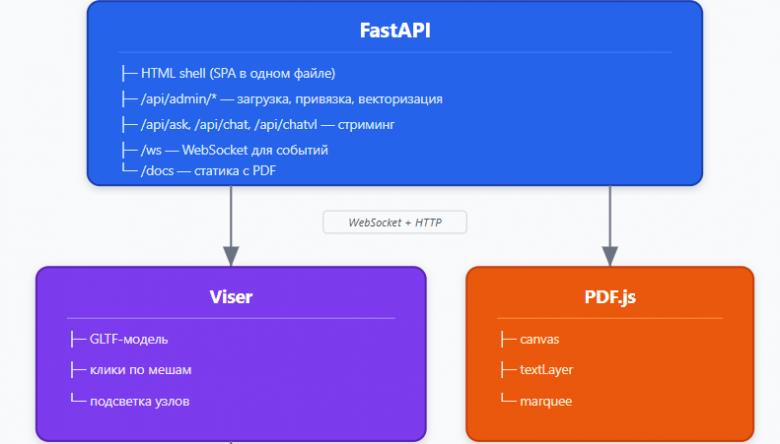
Команды от Shell к Viser:
{"type": "highlight", "ids": [...]}— подсветить узлы;{"type": "focus", "id": "..."}— приблизить камеру к объекту;{"type": "reset"}— снять подсветку.
События от Viser к Shell: [1]
{"type": "node_clicked", "id": "..."}— пользователь кликнул по мешу.
Вся остальная логика (документы, чат, рендер PDF) живёт на стороне Shell.
Реализация RAG
Ранее в своих статьях Методы построения RAG систем, Hybrid RAG: методы реализации., Hybrid RAG knowledge base за 15 минут я подробно разбирал реализацию RAG пайплайнов, они включают следующие основные модули:
Извлечение текста из PDF с координатами
Для качественной работы с документами нужно не просто получить текст, но и понимать, где именно на странице находится каждый фрагмент. Это позволит потом подсвечивать источники прямо в PDF.
import pdfplumber

with pdfplumber.open("document.pdf") as pdf:
    first_page = pdf.pages[0]

    # Извлекаем слова с их позициями на странице
    words = first_page.extract_words(
        x_tolerance=3,      # допуск по горизонтали
        y_tolerance=3,      # допуск по вертикали
        keep_blank_chars=False
    )

    for word in words:
        print(f"Слово: {word['text']}")
        print(f"Координаты: x0={word['x0']}, top={word['top']}, "
              f"x1={word['x1']}, bottom={word['bottom']}")
        print(f"Страница: {word.get('page_number', 1)}")
Сегментация текста на смысловые блоки
Классический подход с нарезкой по фиксированному числу токенов часто режет предложения посередине. В технической документации это критично — теряется смысл. Мы используем сегментацию по предложениям:
import spacy

# Загружаем модель для нужного языка
nlp = spacy.load("ru_core_news_sm")

text = "ГОСТ 1234-56 устанавливает требования безопасности. "
       "Испытания проводятся при температуре 20°C. "
       "Результаты фиксируются в протоколе."

# Обрабатываем текст
doc = nlp(text)

# Получаем предложения
sentences = [sent.text.strip() for sent in doc.sents]
# Результат: [
#   "ГОСТ 1234-56 устанавливает требования безопасности.",
#   "Испытания проводятся при температуре 20°C.",
#   "Результаты фиксируются в протоколе."
# ]

# Группируем по нескольку предложений
chunks = []
chunk_size = 3  # предложений в чанке
for i in range(0, len(sentences), chunk_size):
    chunk = " ".join(sentences[i:i + chunk_size])
    chunks.append(chunk)
Такой подход сохраняет смысловую целостность и улучшает качество поиска.
Гибридный поиск: комбинируем семантику и ключевые слова
Чисто семантический поиск хорош, но для технической документации с точными терминами (номера ГОСТов, коды) ключевой поиск часто работает лучше. Комбинируем оба подхода.
Семантическая часть с sentence‑transformers:
from sentence_transformers import SentenceTransformer

# Загружаем модель
model = SentenceTransformer('intfloat/multilingual-e5-base')

# Для поиска используем префикс "query:", для документов — "passage:"
query_embedding = model.encode("query: температура хранения литиевых батарей")
doc_embedding = model.encode("passage: Литиевые батареи хранятся при 5-25°C")

# Считаем косинусное сходство
from sklearn.metrics.pairwise import cosine_similarity
similarity = cosine_similarity([query_embedding], [doc_embedding])
Ключевая часть с TF‑IDF:
from sklearn.feature_extraction.text import TfidfVectorizer

# Создаем индекс по всем документам
vectorizer = TfidfVectorizer(max_features=50000, stop_words=['и', 'в', 'на'])
tfidf_matrix = vectorizer.fit_transform(all_document_chunks)

# Преобразуем запрос
query_tfidf = vectorizer.transform([user_query])

# Считаем релевантность
from sklearn.metrics.pairwise import linear_kernel
scores = linear_kernel(query_tfidf, tfidf_matrix).flatten()
top_indices = scores.argsort()[-10:][::-1]
Объединение результатов — отдельная задача. Мы используем взвешенную сумму с нормализацией, но можно применять и более сложные алгоритмы ранжирования.
Улучшение пользовательских запросов
Пользователи редко формулируют запросы так, как нужно для эффективного поиска. Типичный запрос: «А не подскажете, какие там требования к хранению в последней версии стандарта?»
Для поиска лучше: «требования хранению последняя версия стандарта»
from openai import OpenAI

def compress_query(original_query):
    """Превращает разговорный запрос в компактный поисковый"""

    prompt = f"""Преобразуй запрос для поиска по технической документации.
    Удали вводные фразы, оставь только ключевые термины.
    Ответ дай одной строкой, 3-8 слов.

    Запрос: {original_query}

    Поисковый запрос:"""


client = OpenAI()
    response = client.chat.completions.create(
        model="gpt-4o-mini",
        messages=[{"role": "user", "content": prompt}],
        temperature=0
    )

    return response.choices[0].message.content
Это добавляет ~300 ms к времени ответа, но повышает точность поиска на 15–20%.
Работа с метаданными
Корпоративные документы редко существуют сами по себе — у них есть авторы, даты, версии, типы. Добавление фильтрации по метаданным сильно улучшает качество:
# Концепт — загрузка метаданных из CSV
import pandas as pd

# Загружаем CSV с описанием документов
metadata_df = pd.read_csv('documents_metadata.csv')
# Колонки: filename, title, author, year, document_type, department

# При индексации обогащаем чанки метаданными
for chunk in chunks:
    doc_metadata = metadata_df[metadata_df['filename'] == current_file].iloc[0]

    chunk_entry = {
        'text': chunk,
        'file': current_file,
        'title': doc_metadata['title'],
        'author': doc_metadata['author'],
        'year': doc_metadata['year'],
        'type': doc_metadata['document_type']
    }
Потом можно фильтровать: «покажи только регламенты за 2023 год» или «найди в документах отдела разработки».
Векторный индекс с FAISS
Для быстрого поиска по тысячам фрагментов нужен эффективный индекс. FAISS — стандарт индустрии:
import faiss
import numpy as np

# Допустим, у нас есть 1000 эмбеддингов размерностью 768
embeddings = np.random.random((1000, 768)).astype('float32')

# Создаем плоский индекс L2
index = faiss.IndexFlatL2(768)  # размерность эмбеддингов

# Добавляем векторы в индекс
index.add(embeddings)  # на входе numpy array float32

# Поиск
query = np.random.random((1, 768)).astype('float32')
distances, indices = index.search(query, k=10)  # ищем 10 ближайших

print(f"Индексы ближайших: {indices[0]}")
print(f"Расстояния: {distances[0]}")
Для продакшена можно использовать IVF‑индексы, которые быстрее на больших коллекциях.
Технические детали реализации
1. Подсветка мешей в Viser
viser отличная открытая Python‑библиотека для интерактивных 3D‑сцен в браузере. Важен быстрый старт без усложнения, одна строка add_mesh_trimesh и модель уже на сцене.
Проблема: стандартное изменение цвета через handle.color = (255, 0, 0) не работает, если у меша зашиты vertex color,а у GLTF‑моделей они есть почти всегда. Вершинные цвета перебивают программную заливку.
Решение: при загрузке сцены для каждого меша мы создаём его overlay‑копию с жёлтыми гранями, масштабом scale=1.02 и прозрачностью 0.85. Храним её под отдельным именем (/root/hl_XX) и просто переключаем флаг visible. Это работает безотказно и не требует пересборки геометрии.
2. PDF.js и синхронизация текстового слоя
Нативный <iframe src="file.pdf"> не отдаёт выделение текста в родительское приложение, поэтому мы не можем поймать mouseup и показать контекстное меню.
В PDF.js каждая страница рендерится в <canvas>, а поверх накладывается <div class="textLayer"> с прозрачными тегами <span> (color: transparent). Пользователь видит картинку, но выделяет реальный текст. [1]
Важный нюанс: обязательно задавайте CSS‑переменную
--scale-factorдля обёртки каждой страницы. Без неё текстовый слой при масштабировании начинает съезжать относительно рендера наcanvas.
3. Прямоугольное выделение (Marquee)
В технической документации часто нужно выделить блок текста в таблице, не зацепив соседние столбцы, или вырезать кусок чертежа.
Алгоритм работы:
На
mousedownфиксируем стартовые координаты.На
mousemove(при сдвиге > 5 px) отрисовываем пунктирныйdiv.На
mouseupпроверяем пересечение всех<span>в.textLayerс рамкой выделения, сортируем их по оси Y (с допуском ±5 px) и оси X, собирая связный текст.Параллельно вырезаем эту же область из
<canvas>черезdrawImageв offscreen‑canvas и кодируем вbase64.
Рамка остаётся на экране до следующего клика, а собранные данные (текст + картинка) передаются в инструменты «Объясни / Переведи / VL‑агент».
4. Асинхронный ввод для VL‑агента
Отправлять картинку в мультимодальную модель с дефолтным промптом «Что здесь изображено?» это плохой UX. Инженеру нужен ответ на конкретный вопрос. Поэтому после нажатия на «VL‑агент» изображение сохраняется в state.pendingVLImage, поле ввода чата подсвечивается оранжевым, а плейсхолдер меняется на «Опишите, что нужно сделать с выделенной областью…». Запрос в qwen-vl уходит только после того, как пользователь введёт запрос и нажмёт Enter.
5. Динамическая область поиска в RAG
Каждый чанк в индексе FAISS хранит метаданные: имя файла, номер страницы, координаты (bounding box) и массив ID привязанных узлов. При запросе бэкенд проверяет текущее состояние интерфейса:
Открыт документ: извлекаем текст PDF и отдаём в LLM напрямую без векторного поиска.
Выбран узел: выполняем гибридный поиск с жёсткой фильтрацией по ID узла в метаданных.
Выбрана вся сборка: ищем по всему корпусу документов.
6. Стриминг через NDJSON
FastAPI отдаёт поток токенов через StreamingResponse, где каждая строка валидный JSON‑объект:
{"type":"t","c":"В соответствии "}
{"type":"t","c":"с ГОСТ "}
{"type":"t","c":"32569-2013, "}
{"type":"s","s":[{"file":"passport_jk01.pdf","relevance":0.95}]}
На фронтенде читаем поток через fetch().body.getReader(), парсим построчно и накапливаем буфер. Чтобы браузер не тормозил от перерисовки DOM на каждый токен, рендер Markdown (через marked.js) дебаунсится с помощью requestAnimationFrame.
Сценарии использования на практике
Подготовка к ремонту. Инженер кликает на насос в 3D‑модели, сразу видит его паспорт, последний наряд‑заказ и регламент ТО-4. Спрашивает в чате: «Что проверить перед пуском?» и получает чек‑лист со ссылками на конкретные пункты регламента.
Аудит полноты документации. Начальник участка включает режим цветовой индикации на 3D‑сцене: зелёные узлы полностью укомплектованы документами, жёлтые — частично, красные — без паспортов. Клик по красному узлу сразу открывает форму привязки недостающих файлов.
Разбор инцидентов. При открытии акта опрессовки водородной линии на 3D‑модели автоматически подсвечивается весь задействованный участок трубопровода и соседние задвижки.
Локализация документа. При работе с документацией сразу ясны границы действия документа. Например Акт дефектовки, наряд на работы или результаты испытаний сразу подсветят на какие области сборки они распространяются.
Онбординг новичков. Новый сотрудник изучает установку в 3D, кликая по агрегатам и читая краткие AI‑сводки по их устройству и регламентам обслуживания.
Что может вызвать проблемы и на что обратить внимание при реализации
Сканы без текстового слоя.
Если у вас тысячи старых актов в виде pdf сканов\фото система «из коробки» их не распознает. PyMuPDF вернёт пустой текст, чанки не соберутся, RAG по этим документам не заработает. Обязательно необходимо реализовать отдельный OCR‑пайплайн (Tesseract, VL‑модели), и OCR это отдельная довольно крупная задача, решения используемые в моих OCR кейсах разработавались годами, к сожаление обилие рукописного текста, таблиц, дефектов печати и сканирования не позволяют обойтись простым разворачиванием tesseract или visual LLM пайплайна в пару кликов
Технические чертежи через VL.
qwen‑vl неплохо описывает «что на картинке», но не извлекает надежно размеры, допуски, позиции, маркировку арматуры. На некоторых схемах модель галлюцинирует: придумывает несуществующие обозначения, путает единицы измерения. Подходит для ответа на вопрос «какой диаметр у этой задвижки?». Для коммерческих кейсов приходится использовать более сложные, чем описанный пайплайн, для многих видов сложной тех документации, например чертежей нужно проводить полноценный AI OCR с извлечением данных и упаковкой в IFDRP граф
Полностью автономная работа без подготовки.
Пункт «работает без интернета» работает с оговорками. Зависимости проекта: PDF.js, marked.js, шрифты и иконки необходимо будет локализовать отдельно, Также необходимо для локальной работы LLM развернуть сервер с поддержкой OpenAI API. Чтобы развернуть эти компоненты в закрытом контуре, и сконфигурировать, нужна реальная работа: развернуть JS‑библиотеки локально, поднять qwen3 на своём сервере (vLLM или Ollama), выделить GPU под инференс.
3Д сборка не появится сама
Для 3Д навигации нужно создать самостоятельно 3Д версию реального обьекта — сборки. Это довольно трудоемкий и трудозатратный процесс. Многие компании перекладывают его на подрядчиков, требуя при сдаче обьекта подготовить и передать 3Д модель. Важно что 3Д модель должна поддерживать деление на узлы, а не просто быть набором монолитных полигонов. Из плюсов в большинстве кейсов, которые я реализовал заказчиков вполне устраивают низкополигональные модели, это серьезно снижет их вес (модель в примере весит всего 400 кб) и требования к железу клиента
Привязка требует пользователя‑специалиста
Привязка документов к узлам ручная. Для 18 документов и 10 узлов это 10 минут в админке. Для 1000 документов и 200 узлов — это недели ручной работы. Я активно прорабатываю пайплайны автоматической привязки по имени файла, содержимому, метаданным, но пока этого нет. В проде это станет узким горлышком быстрее, чем RAG.
Огрехи в рендере
3Д Камера в 3D приблизительная. Формула dist = max(radius 3, scene_diag 0.15, 5.0) работает достаточно хорошо, но не идеально. Для крупных объектов иногда камера отлетает слишком далеко, для мелких иногда врезается в соседние трубы. Идеальной навигации пока нет, потому что для этого нужна отдельная работа с глубоким рендерингом 3Д.
Стрим режим может ломать MD при генерации «на лету»
Stream режим ломает markdown на короткое время. Когда токены приходят быстро, marked.parse() может получить на входе **жирный без закрывающих звёздочек — и на долю секунды показать жирный как plain text. Дебаунс через requestAnimationFrame это сглаживает, но не убирает. На медленных соединениях артефакт заметен.
Скорость локальной работы зависит от железа
VL‑модель локально отвечает медленнее. qwen‑vl локально это не gpt-4o‑mini в облаке. Первый токен 3–5 секунд, полный ответ на сложный вопрос 20–30 секунд. Streaming частично спасает UX, но на коротких вопросах («что это за символ?») ожидание ощущается. В целом время локальной обработки зависит от производительности GPU и размера выделенной области. Из плюсов для работы достаточно 8Gb VRAM
Затраты на обновление
Пересборка индексов полная. Добавили один акт пересчитываются все 18 документов. Для 600 чанков это 2–3 минуты, для 60 000 уже часы. Инкрементальная индексация (только новый файл, только изменённые чанки) которая уже работает в моих проектах для чистого RAG, здесь пока остается в бэклоге.
Заключение
Цифровые двойники это один из ключевых элементов систем нового класса — интеллектуальных корпоративных систем интеграционного менеджмента информации (ИКСИМИ), которые связывают данные из разных источников в единую модель, и позволяют к изолированной семантической связке RAG добавить визуализацию и интуитивный UI в гибридной модальности представления и обработки данных
В следующих частях подробнее остановлюсь на коде, и логике отдельных модулей, метриках качества RAG, расскажу о кейсах Digital Twin систем с подключением к телеметрии, реализации предиктивной аналитики и анализа сбоев, рекомендательных модулях такой системы и возможности прямого управления тех процессами Отдельного упоминания требуют кастомные архитектуры например как строить граф узлов, когда сборка не «плоская» (иерархическая с вложенными узлами и перекрёстными связями), выполнение оценки качества RAG, Глубокие AI OCR пайплайны распознавания при работе с VL‑моделями.
Комментарии (15)

1Fedor
16.11.2026 18:57"Крупные вендоры — Siemens, Schneider, Aveva, и десятки других предлагают платформы, в которых «двойник» обещает предсказывать отказы, оптимизировать режимы, экономить миллионы. Аналитики Gartner и MarketsandMarkets оценивают рынок в десятки миллиардов долларов к концу десятилетия."
Может ошибаюсь, но задача паспорт задвижки и давление опрессовки, просто рутина, никто просто так не прессует, либо ремонт, либо сроки освидетельствования, а там прогааммы и прочее.
А вот такое заявление: "Крупные вендоры — Siemens, Schneider, Aveva, и десятки других предлагают платформы, в которых «двойник» обещает предсказывать отказы, оптимизировать режимы, экономить миллионы. Аналитики Gartner и MarketsandMarkets оценивают рынок в десятки миллиардов долларов к концу десятилетия."- напоминает, то какие решения предлагает Палантир, архисложная и дорогая задача.

WhiteBehemoth
16.11.2026 18:57Digital twin, он же цифровой двойник, имеет основное назначение отражать реальный объект. Как минимум в одну сторону, давая читать актуальное состояние. Статичные свойства ака ссылки на документации это уже так, "nice to have".
И да, сделать большой связанный граф разномастных компонентов, да с привязкой по местности, это та еще задача. Но если уж делать, на почему бы не использовать специально созданные для того структуры данных, например DTDL ? С упорядоченными связами и иерархиями? Опять же иишки формат знают, и со структурой помогут.

itGuevara
16.11.2026 18:571 А это точно "настоящий DT"? Существует ли "3 Digital Twin checklist" (см. Digital Twin. Часть 1. Цифровой двойник vs цифровой самозванец).
2 А DT точно нужен ИИ, RAG etc? Может быть "Не ИИ-тизируй это, удаляй!".
Может ему достаточно добавить семантики и онтологии?

ToxaBes
16.11.2026 18:57Отличная статья, спасибо за ссылку. Все так. Самое печальное, что у многих до сих пор все так.

iximy Автор
16.11.2026 18:57В п 5.4. ГОСТ Р 57700.37- 2021 прямо указано
...В зависимости от области применения, типа изделия и стадии его ЖЦ могут быть выделены следующие варианты реализации цифрового двойника: цифровой прототип изделия, цифровой двойник экземпляра изделия, цифровая тень изделия и др. Требования к вариантам реализации цифрового двойника, включая требования к его валидации, могут устанавливаться в рамках серии национальных стандартов и стандартов организаций по цифровым двойникам, разработанных в развитие данного стандарта.
В п 3.19. ГОСТ Р 70991-2023 приводится определение
цифровой двойник: Цифровое представление, достаточное для удовлетворения требований набора вариантов использования.
Если сценарий использования и цели реализации это навигация по оборудованию, аудит комплектности и поиск паспортов/регламентов/требований данных о статусе узлов испытаниях/ремонте/статусе то связка «3D-сборка + база знаний + RAG» является достаточным цифровым представлением
В Digital Twin ИИ это в первую очередь вспомогательный инструмент взаимодействия с пользователем и анализа "больших" объёмов данных, семантики и кроссязыковой обработки данных, то есть прикладной надстроечный функционал
RAG пайплайны на базе эмбеддинг представлений семантических фрагментов документов позволяют вести точный поиск по массиву документации без передачи текстов целиком в модель. Это как раз кардинально отличает RAG системы от "оберток chatGPT"
Вся обработка данных производится вне LLM, и только на выходе запрос + релевантный контекст скармливаются ИИ для формирования ответа
Если пользователю нужен семантический и кросс-языковой поиск по неструктурированной технической документации, то ИИ (эмбеддинги + LLM) делает это на порядок дешевле, быстрее в развертывании и гибче классических поисковых движков
Граф и онтология действительно решают задачи связывания данных, даже без нейросетей, об этом я упоминал в статье, в контексте работы с VLДля коммерческих кейсов приходится использовать более сложные, чем описанный пайплайн, для многих видов сложной тех документации, например чертежей нужно проводить полноценный AI OCR с извлечением данных и упаковкой в IFDRP граф
ToxaBes
Ну вот, опять, все описанное в статье хорошо и правильно, кроме одного: использование LLM строится исключительно вокруг текста: RAG-система и ответы чат бота, а 3D используется, но без всякой интеграции с самой моделью.
Пусть даже не 3D, но 2D схему установки можно же было и научить понимать модель. Вот прям понимать, что какой вентиль значит, какие вообще элементы в системе есть и как они связаны. Но для этого нужен ML-инженер, который знает как обучать такие модели, а его походу, забыли нанять.
В итоге снова наблюдаем систему с AI, где этот самый AI прилеплен сбоку в виде текстового ассистента в чате с RAG-базой знаний (что хорошо), но все показанное 3D больше раскраска для пользователя, чем реальная часть цифрового двойника (что плохо).
Если ваша модель не понимает схему вашей системы, то это не AI цифровой двойник.
Конечно не извлекает, ведь его на это не дообучали. Исправить это может один ML-инженер за 2-3 месяца, причем для работы в итоге понадобится одна видеокарта с 16-24GB памяти, не больше.
Dekartio
А это точно нужно? Дообучать локальную модель (вероятно on-prem) на чтение схемы, когда система обеспечивает открытие исходника (источника правды) и позволяет инженеру за секунды вникнуть в структуру без наяривания сообщений в чат?
Тут ведь ещё момент в том, что даже обученная на чтение схемы модель не будет проводить поверочные расчёты. Да и если идти в это, то тут уже по классике, через редактор схем и узлов с обвязкой формулами.
ToxaBes
Зависит от уровня автоматизации, предлагаемой клиенту, го во многих случаях да - нужно.
Помимо собственно инженеров в таких системах есть еще операторы и там часто нужно не просто вернуть список действий по регламенту, но и показать как его сделать оптимально, а для этого нужно понимать саму инженерную систему.
Например, модель считывает данные с датчиков ректификационной колонны (температура/давление/заполнение танка/положение вентилей) и позволяет, например, безопасно слить содержимое в резервный танк при попадании инородного предмета самолетного типа в основной. По регламенту обычно в таком случае все содержимое сливается в отстойник без возможности дальнейшей переработки.
Или часть шагов по регламенту уже сделаны явочным порядком (вентили в нужных положениях) поэтому некоторые этапы можно безопасно пропустить.
Регламент, инструкции и нормативка само собой лежит в RAG.
Цифровой двойник это не только информационный помощник справочного типа, но и система принятия решений вида "второе мнение" помогающая людям действовать в том числе тогда когда промедление недопустимо.
Понятно, что это не просто взяли qwen и готово, а гибридный ансамбль из мультимодальной и графовой моделей.
Причем тут поверочные расчеты, которые всегда производятся детерминированно? ИИ это не калькулятор.
Dekartio
Ровно об этом же..
Однако примеры про телеметрию с датчиков, управление сложными, почти аварийными режимами, а также отклонениями от регламента - это явно уже не уровень 2-3 месяцев работы ML-инженера по дообучению модели. Будь он даже самый гениальный ML-инженер в мире, заход в контур АСУ ТП требует уже другого масштаба систем, регламентов, ответственности и сертификации. И это тема отдельных перспективных, интересных обсуждений, но не всё тут в одну кучу.
А вот продавать заказчикам захватывающие дух возможности, а потом тихонечко пилить на ретейнере бесконечные дообучения - хороший бизнес-кейс для специалиста, но не так очевидно для предприятия.
ToxaBes
Понятно, что это MVP/Pilot, но уже развернутый на предприятии. Бывает, что железо дольше едет чем MVP собирается, особенно сейчас.
О гениальности речь не идет, но ситуации, когда клиенту заявляется MVP на 6-8 месяцев командой из 5 человек который фактически реализует один человек на субподряде за 2 месяца это реальность ML-автоматизации в РФ. А двухмесячный PoC делается за неделю-другую. Тут скорее дело в реальных 6 годах опыта, а не в какой-то там гениальности.
Для пилота делается зеркалирование данных, что позволяет не менять текущий контур и быстро заходить "рядом".
Также учтите, что все решения такой системы это "второе мнение", что в медицине, что в производстве. Система может подсказать оператору, но именно он несет ответственность. У каждого принятого решения есть фамилия имя и отчество. ML-системы это один из вспомогательных механизмов управления и принятия решений, а не замена человека. Цель: облегчить и ускорить принятие решения, сделать его более качественным. О замене человека речь не идет.
В некоторых случаях узкоспециализированные системы могут отправлять управляющие сигналы на оборудование напрямую, например, контроль флотации руды (камера смотрит на лоток, определяет гранулярность фракции, регулирует подачу реагентов в реальном времени). Но оператор все равно сидит и смотрит глазками на показания приборов и датчиков.
На этом стояла, стоит и будет стоять вся интеграция в РФ. Просто к системам аналитики и шинам данных добавился современный ML.
Но я к продажникам не отношусь (к сожалению, я техногик, а не продавец), я как раз из тех к кому приходят после того как наобещали клиенту и теперь с этим надо что-то делать. Стараюсь в меру сил своих исправить ситуацию, подготовил реальные кейсы внедрений, с инфой для пресейлов, понятными для клиентов целями и тд из того что реально нужно в разных отраслях (18 отраслей).
Но процесс идет не так чтобы быстро как хотелось бы, тк зачастую ЛПРы просто не верят, что такое реально сделать (помня о собственном ML-отделе с выученной беспомощностью), приходится записывать видеодемонстрации, но все показать нельзя тк NDA с теми кому уже внедрял итд. Отдельное недоверие идет к срокам, "слишком быстро", оно и понятно, если часто на молоке обжигаться, на воду дуть будешь. Наверное, надо научится умножать сроки на 2, цену на 4 и нагловато улыбаться.
Короче, все это колка льда вручную в Северном-Ледовитом океане отдельно взятым ИП.
iximy Автор
Вы поднимаете важную тему зрелости и уровня реализации Digital Twin решений
Вы абсолютно правы в том, что классический, зрелый Digital Twin должен понимать физику, топологию и связи элементов. Но в статье (и это указано в самом начале) речь идет исключительно об управлении документацией.
Мой посыл в том, что 80% проблем на заводах это не отсутствие предиктивной аналитики, а организационный и интерфейсный разрыв. Инженеру на площадке в первую очередь нужно не «предсказание отказа по вибрации» (до этого нужно дожить), а возможность кликнуть на задвижку в 3D и увидеть её актуальный паспорт и регламент опрессовки.
Несмотря на это решение не просто “раскраска” где 3D вьюверу прикрутили RAG. Это полноценный пространственный индекс. Мы связываем физический объект (меш) с семантическим ядром (документами и RAG).
То, о чем вы говорите, реализуется на других уровнях, о чем я пишу в последнем абзаце статьи:
Для таких случаев, когда есть возможность описать физическое взаимодействие узлов системы и рассматривать все систему и ее связи, строится граф физических свойств системы, который передается модели и дает ей “понимание” физической структуры, включая свойства и характеристики (связи, телеметрию) узлов при формировании ответа.
Дообучение моделей это к сожалению пройдённый и тупиковый путь для гибкой и стабильной архитектуры цифровых двойников и систем управления данными в целом. Дообученная модель всегда останется “черным ящиком”, с вероятностями, которые мало применимы для целей построения таких систем. Единственное исключение это реализация предиктивной аналитики
Модели qwen-vl это стартовый уровень vision моделей. На данный момент нет открытых моделей который могут выполнить полное распознавание даже простых чертежей, хотя бы на уровне img2vector. В данной реализации VL агент это инструмент диалога пользователя с графическим фрагментом документа. Для коммерческих кейсов используется пайплайн с полноценным AI OCR и извлечением данных в IFDRP граф
К сожалению 1 ML-инженер х 2-3 месяца на видеокарте это распространённый миф. Думаю за 3 месяца не удастся подготовить даже значимы датасет для дообучения, не говоря о итерациях дообучения и получения надежного инструмент для извлечения размеров и допусков с чертежей по ГОСТу. Например разметка одного сложного чертежа специалистом-конструктором может занимать часы. Даже относительно простой OCR невозможно уложить в эти сроки. У меня огромная коллекция сканов техдокументации СССР и начала 90-х с которыми не может справится практически ни одна OCR
Статья описывает начальный, но крайне востребованный уровень: интеграцию документации, 3D и LLM в единый UX.
ToxaBes
Полностью принимается, это моя проф деформация, увидел:
загорелась красная лампочка, забрало упало и заверте...
В этом я с вами полностью согласен.
Под раскраской я имел 3D UI элемент, который используется для определения разделов (навигации), но модель его не понимает и не "читает" напрямую.
Вот тут в корне не согласен, нужны ML-инженеры определенной квалификации. Тема с мультимодальными моделями (не OCR/CV) на производстве довольно новая, ей и 1.5 года нет, поэтому если у вас и были неудачные попытки, то это легко обьяснимо.
Именно так, поэтому их нужно дообучивать, об этом я и пишу. Чертежи бывают двух типов, первый это pdf с векторным слоем данных. Из таких чертежей обученный ансамбль моделей вытащит практически все включая сегменты вращения, резьбы, фаски и галтели. Второй вид это чисто картинка, это гораздо сложнее, но и здесь возможны варианты.
Ансамбль сначала определяет места с текстом, потом кропает их и распознает по очереди, потом соотносит с элементами детали на чертеже, потом.... там еще очень много всего, но это вполне реально. Дальше хоть смету считать, хоть DFMEA.
Приятно познакомится, Миф Универсал.
Ну, если без опыта, то и года не хватит, и нейронка не подскажет.
Распознавание занимает минуты, потом конструктор сверяет распознанное с чертежом и сохраняет паспорт детали. Это делается один раз, затем дальнейшие работы идут уже с паспортом детали. Чет мы как-то резко в чертежи ушли, ну да ладно.
Я в основном сталкиваюсь с чертежами из современных CAD программ в виде pdf с векторным слоем. Если есть возможность, скиньте пожалуйста ваши примеры деталей вращения (сейчас исследую на них определенные вещи), с удовольствием попробую. Сложным примерам я всегда рад.
В большинстве случаев это не начальный, а единственный уровень, который интеграторы могут предложить клиенту. Весь мой спич был об этом.
iximy Автор
У Вас уникальный опыт в обработке данных и задачах дообучения моделей
Модель “видит” действительно не всю структуру, а получает только JSON массив включающий все узлы и их связи с загруженными документами в составе метаданных релевантных фрагментов
“Каждый чанк в индексе FAISS хранит метаданные: имя файла, номер страницы, координаты (bounding box) и массив ID привязанных узлов.”
В коммерческих кейсах там где позволяет структура создается полноценный граф
Если вы говорите про VLM, то практика их внедрения в промышленности действительно крайне молода (1–2 года), здесь я полностью согласен. Но именно поэтому я с осторожностью отношусь к их применению в качестве единственного источника истины для критической инженерной документации. Когда VLM извлекает, например, размер из фрагмента чертежа, она выдает крайне нестабильный результат. Даже детерминированная модель покажет 1–5% галлюцинаций. Это не вопрос качества ML инженеров, это вопрос природы нейросетей. В промышленной эксплуатации такие «черные ящики» недопустимы без жесткой верификации.
Предполагается, что векторный слой должен серьезно упростить задачу извлечения данных. Однако огромное количество документов в обороте состоят из простого набора векторных элементов, без замкнутых полигонов и закрытых кривых. Начинаешь разбираться в DWG/DXF: визуально аккуратное отверстие, а в исходнике 512 несвязанных и незамкнутых линий. А таких отверстий пару сотен, и символы в кривых. Извлечь из этого отдельная огромная инженерная задача.
Вы описали типичный подход HITL - человек в цикле: модель извлекает данные, а конструктор их верифицирует и сохраняет. Это отличный подход для ускорения пайплайна: модель делает черновую работу, эксперт проверяет и включает в "библиотеку узлов" Если это делается один раз, а дальше данные переиспользуются это грамотная архитектура. Расскажите подробнее про ваш подход, это действительно интересно. По моему мнению сейчас нет достойных моделей для дообучения на таком специфичном корпусе
У меня почти все данные под NDA, приложил примеры типичных фрагментов из сканов открытых НТД https://disk.yandex.ru/d/AyWOTu0eYZkw4A
И здесь я с Вами полностью согласен! Именно поэтому я и упомянул в статье что это стартовый уровень. Сейчас в РФ этот путь часто начинается с отказа от глобальных облачных, SaaS решений и входа в собственную разработку. Судя по публикациям разработчиков, даже крупные компании не уходят дальше в импортозамещении. Мое глубокое убеждение: Пока у компании нет единого структурированного пространственного индекса (того самого связывания мешей с документами), никакие «умные» предиктивные модели и физические графы работать не будут, им просто не на что опираться. Статья описывает этот базовый, но абсолютно необходимый фундамент, без которого Digital Twin остается красивой презентацией вендора, а не рабочим инструментом инженера.
ToxaBes
Конечно, вы правы, это не единственный источник истины и я этого не утверждал. Все факты лежат в RAG, расчет смет детерминирован, а конструктор проверяет то, что выдала модель перед утверждением паспорта модели.
Вы правильно поняли что это HITL с ансамблем из 4-5 моделей, большинство из них небольшие и узкоспециализированные для определенных шагов распознавания.
Те сегментация/ббоксинг/кроппинг/распознвание текста и общее понимание это 4-5 последовательных шагов.
Спасибо, у вас явно скрины из старых учебников, на производствах чертежи гораздо качественнее, на этом я сам глазами прочитать не все могу. Тут явно нужны предварительные шаги, выравнивание, масштабирование, отстройка уровней яркость/контраст и тд. Я не занимаюсь подобной археологией, т.к. нет коммерческих запросов достаточного уровня на нее.
Я все-таки считаю, что никакой индекс не поможет пока не появятся грамотные ML-инженеры, но я понимаю, что мы просто каждый со своей стороны на проблему смотрим. И то и другое надо.