

Мы - маленькая инди-студия anywaymachines, делаем игру NAND² - головоломку, где из одного вентиля NAND собираешь всё остальное: NOT, сумматор, регистры, АЛУ, процессор с подмножеством RISC-V, а дальше пишешь для своего процессора программы на ассемблере, вплоть до 3D-шутера в духе Wolfenstein. Игра ещё в разработке, по плану около 200 уровней в шести эпохах: реле, транзисторы, микросхемы, микропроцессоры, скорость, система.
Выросла игра из любви к Turing Complete и курсу nand2tetris: оба проекта когда-то показали нам, как интересно собирать компьютер с нуля своими руками. Нам захотелось пройти этот путь ещё ближе к настоящему железу: собрать процессор с реальной системой команд в стиле RISC-V и дойти до запущенной на нём программы, от вентиля до картинки на экране.
Эта статья не про геймдизайн, а про движок: как схема с поля превращается в плоский массив, почему основной режим — это тупой проход по всем вентилям без всякой событийности, где событийный режим всё-таки нужен и как это всё рисуется, когда на поле 10 000 вентилей, и камера отъезжает так, что каждый становится размером в пару пикселей. Всё ниже — реальный код из репозитория (Rust, crates/sim — движок, crates/game — игра на egui + wgpu), скриншоты прямо из редактора.
Что вообще симулируется
Игрок видит сетку, на ней детали и провода. Внутри движка всё это сводится к трём сущностям:
сеть (net) — набор проводов и пинов, электрически соединённых между собой. У сети есть значение
u32и ширина от 1 до 32 бит. Шина — это просто широкая сеть;узел — вентиль (
NAND,AND, …,NOT,BUF) или «сложный» узел: разветвитель шины, сборщик шины, поведенческий блок;последовательные элементы — D-триггеры и регистры, которые защёлкиваются по фронту тактового сигнала, и генераторы
CLOCK.
Компиляция схемы идёт в два шага. Сначала compile_into обходит поле: для каждой клетки собирает провода, которые через неё проходят, и сливает сети через union-find (конец провода, упёршийся в другой провод, — это Т-соединение; пересечение двух проводов без конца в этой точке — не соединение). Блоки игрока (свой сумматор, свой регистр) рекурсивно разворачиваются внутрь, с ограничением глубины 32, чтобы блок, вложенный сам в себя, давал понятную ошибку, а не переполнение стека.
Второй шаг - Builder::finish, где из графа получается то, что реально крутится в цикле.
Плоский массив вентилей
Главный цикл симулятора выглядит так:
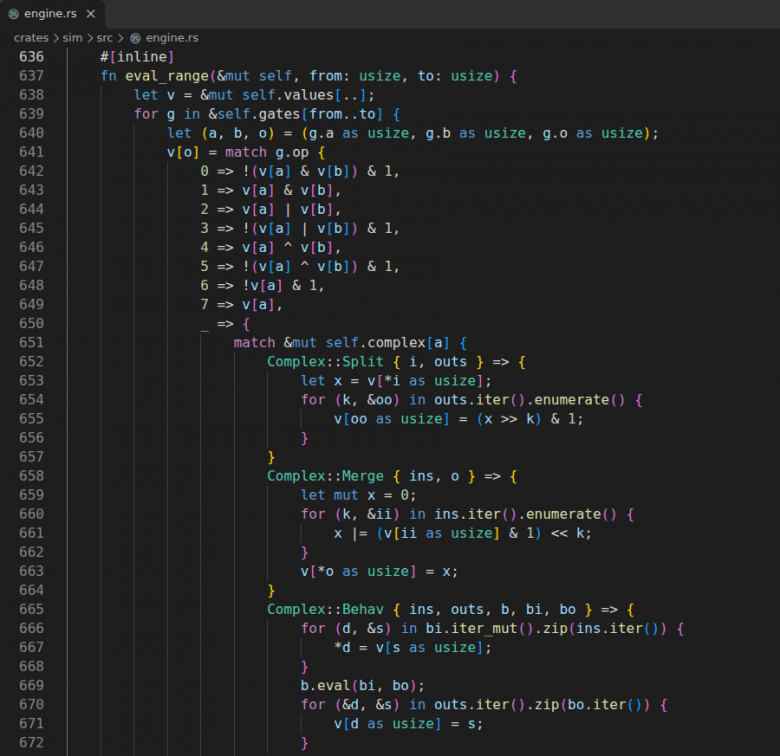
Вентиль - это struct Gate { op: u8, a: u32, b: u32, o: u32 }: 16 байт, три индекса в общий массив values и код операции. Никаких указателей, Box<dyn ...> или хеш-таблиц в горячем пути. Восемь простых операций разбираются одним match прямо в цикле, а всё, что не влезает в два входа и один выход (сплиттеры шин, ПЗУ, блоки-таблицы), лежит в отдельном векторе complex, и вентиль с кодом 255 хранит в поле a индекс туда.
Почему значения u32, а не биты в битсете: в игре полно шин по 8, 16 и 32 бита, и хранить их одним словом проще, чем гонять по 32 отдельные сети. Однобитные вентили маскируют результат & 1, вентили на шинах работают побитово, как есть. Платить за это приходится памятью: на однобитной схеме из 10 000 вентилей 31 бит из 32 в каждом значении пустой. Пока 10 100 сетей занимают 40 КБ, нас это устраивает.
Порядок: уровни, петли и Тарьян
Чтобы схема без памяти досчиталась за один проход, вентили должны идти в топологическом порядке: драйвер сети раньше всех её потребителей. Это классическая levelized-симуляция. Проблема в том, что игроки строят петли. Защёлка на двух NAND — это петля, генератор из нечётного числа инверторов — тоже петля, и в игре это легальные конструкции, а не ошибки.
Поэтому перед сортировкой граф сжимается по сильно связным компонентам:
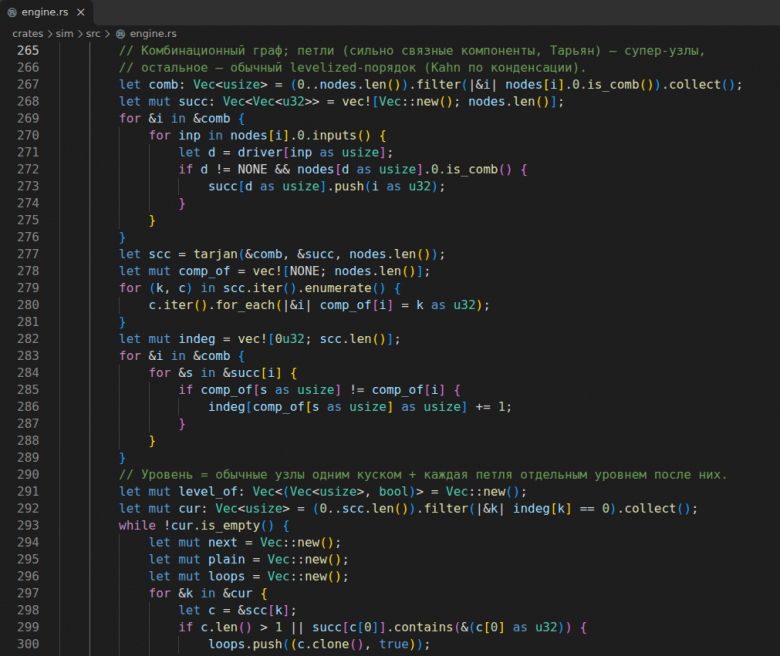
Тарьян (итеративный, без рекурсии, чтобы не упереться в стек на большой схеме) находит компоненты. Компонента из одного узла без самопетли — обычный узел. Компонента из нескольких узлов — «супер-узел», петля. Дальше обычный алгоритм Кана по конденсированному графу, и на каждом шаге обычные узлы кладутся одним уровнем, а каждая петля — отдельным уровнем после них. В итоге получается массив gates, разрезанный на уровни через level_start, и список уровней, которые являются петлями.
Попутно finish решает ещё две вещи. Если у сети несколько драйверов (игрок соединил два выхода), каждому выдаётся своя частная сеть, а в общую их сводит цепочка вентилей OR — монтажное ИЛИ становится обычными вентилями и не требует отдельной логики в цикле. И проверяются ширины: 8-битный выход на 1-битный вход — ошибка компиляции с подсветкой проводов.
Петли до неподвижной точки и фронт тактового сигнала
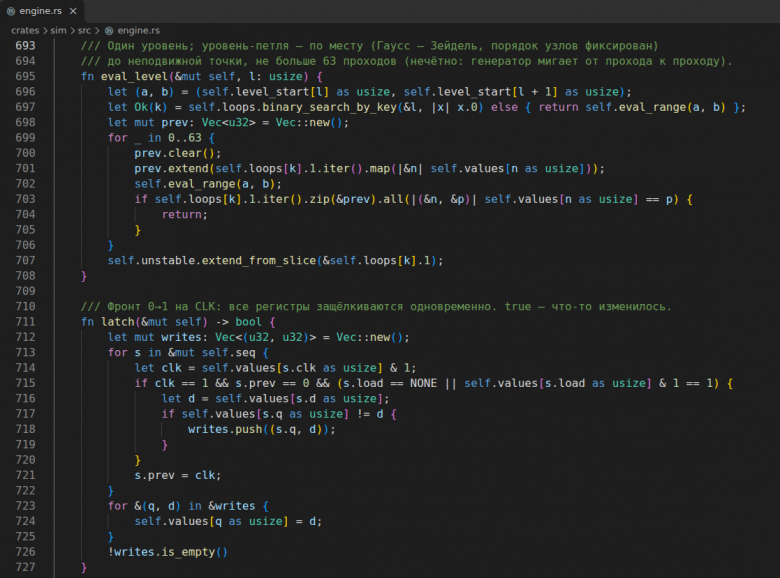
Обычный уровень считается одним проходом. Уровень-петля считается по месту, в фиксированном порядке узлов (по сути метод Гаусса — Зейделя), пока выходы петли не перестанут меняться, но не больше 63 раз. Число нечётное специально: генератор из инверторов на каждом проходе меняет значение, и после нечётного числа проходов он оказывается в противоположном состоянии — на экране он мигает, а не залипает. Если петля не сошлась, её сети попадают в unstable, и шейдер рисует их красными: игрок видит «дребезг», а не зависший кадр.
latch — защёлкивание регистров. Сначала все регистры читают свой d и записывают пары (q, d) во временный вектор, и только потом всё записывается в values. Это две фазы, как у настоящего синхронного регистра: если выход одного регистра идёт на вход другого (сдвиговый регистр), второй должен увидеть старое значение первого, а не уже обновлённое.
Полный такт — step(): переключить все CLOCK, а дальше settle() — комбинационный проход, защёлка, и так по кругу, пока защёлка что-то меняет (до 64 раз). Повтор нужен для каскадных фронтов: в асинхронном счётчике выход одного триггера — это тактовый вход следующего.
Стресс-плата и честные цифры
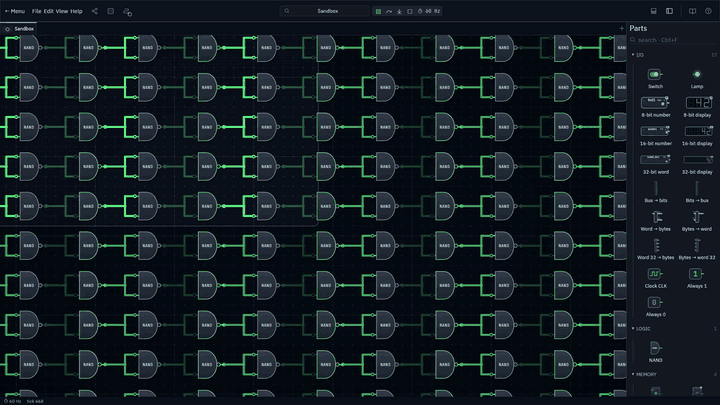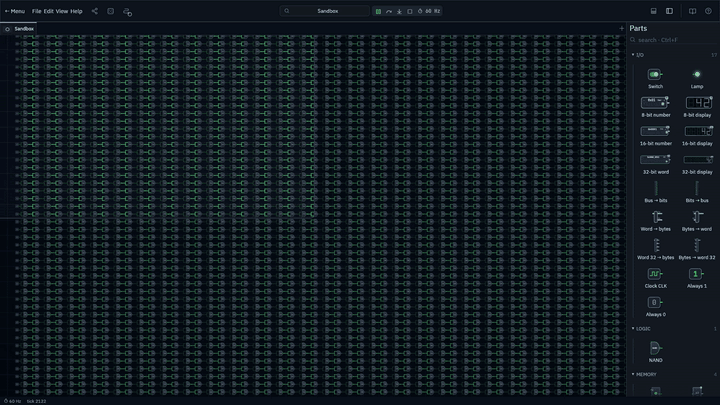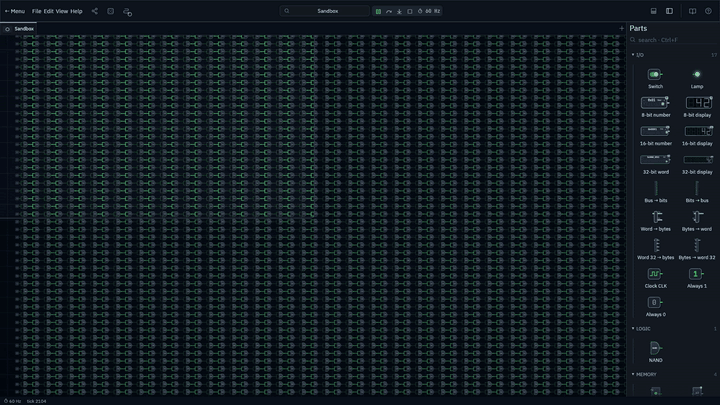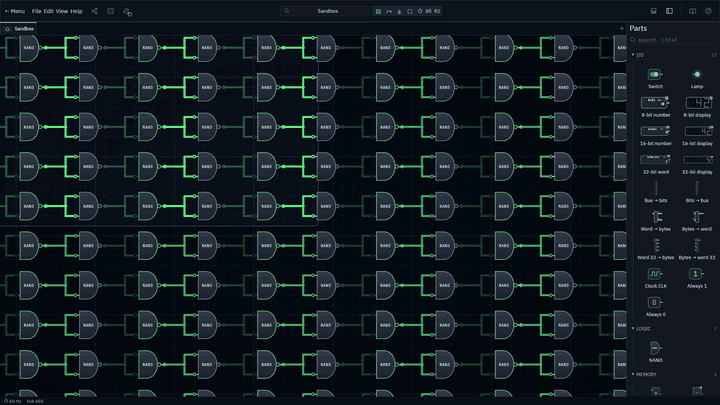
Вот как строится плата из гифки:
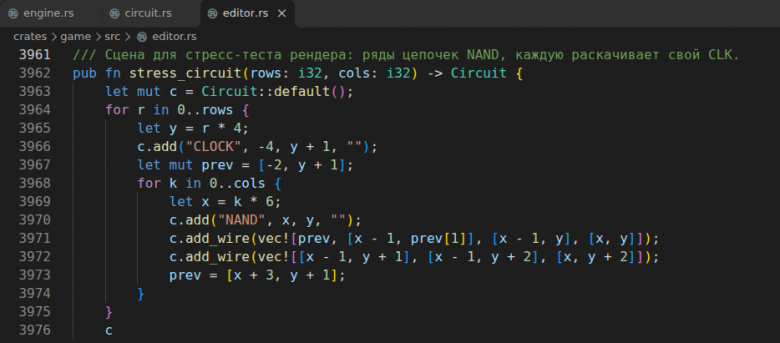
100 рядов, в каждом свой CLOCK и цепочка из 100 NAND, у которых оба входа соединены (то есть каждый работает как инвертор). На каждом полутакте генератор переключается, и волна проходит через всю цепочку: меняют значение все 10 000 вентилей. Это худший случай для любой оптимизации «считать только то, что изменилось».
Мы вынесли эту функцию в отдельную программу поверх крейта sim и замерили на машине, где пишем (AMD EPYC 7402, серверный процессор, сборка --release):
значение |
|
|---|---|
компиляция платы |
29,8 мс |
узлов / сетей / уровней |
10 000 / 10 100 / 100 |
полный проход, один |
16,1 мкс |
событийный режим, один |
144,8 мкс |
То есть полный проход по всем 10 000 вентилей — около 16 мкс, порядка 600 миллионов вычислений вентиля в секунду на одном ядре. В крейте лежит ещё бенчмарк cargo run -p sim --release --bin bench на сумматорах: 1000 восьмибитных сумматоров по 120 NAND (123 003 узла, 37 уровней) устаканиваются за 289 мкс. Цифры с одной машины, на ноутбуке будут другие, но порядок такой.
Событийный режим здесь в 9 раз медленнее, и это ожидаемо: когда меняется 100% вентилей, учёт «кто изменился» — чистые накладные расходы. Поэтому в песочнице работает простой проход, а событийный режим включается там, где он выигрывает, — об этом ниже.
Бюджет кадра
Симуляция идёт в том же потоке, что и интерфейс, поэтому её нельзя пускать «сколько успеет»:
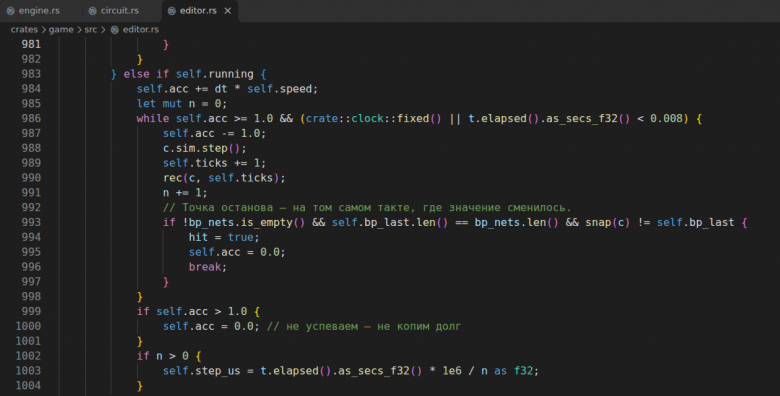
Скорость задаёт игрок (тактов в секунду), время копится в acc, и цикл делает столько тактов, сколько накопилось, но останавливается, если на это ушло больше 8 мс. Если не успели, долг не копится: acc обнуляется, и симуляция просто идёт медленнее заданной скорости, а не замораживает кадр, пытаясь догнать. Отсюда же цифра step_us в строке статуса редактора - она меряется прямо здесь.
Заодно в этом цикле живут точки останова на проводах: после каждого такта сравниваются значения отмеченных сетей, и если что-то сменилось, симуляция встаёт ровно на этом такте.
Рендер: геометрия один раз, состояние каждый кадр
Теперь про отъезд камеры. Поле рисуется своим рендером на wgpu, встроенным в egui через paint callback. Провода и пины — инстансированные капсулы, которые рисуются в фрагментном шейдере через SDF (signed distance field), так что провод остаётся гладким на любом масштабе. Главная идея: геометрия и состояние разделены.
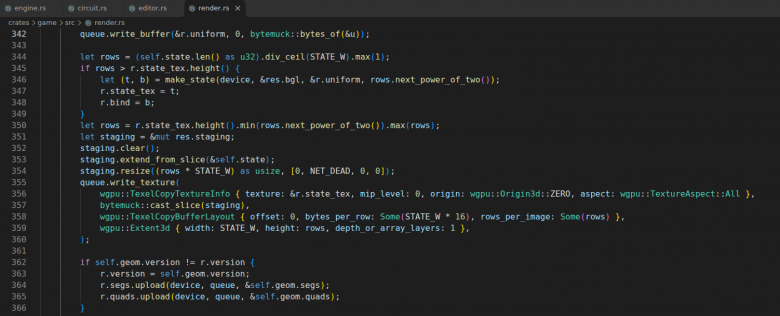
Геометрия (отрезки проводов, корпуса) загружается в GPU-буфер только когда меняется версия схемы — игрок что-то поставил или удалил. Каждый кадр на GPU уходит только состояние: текстура Rgba32Uint шириной 1024, один тексель на сеть — [значение, флаги, время последнего изменения, ширина]. Каждый отрезок провода знает номер своей сети, и вершинный шейдер достаёт её состояние textureLoad по координатам (net & 1023, net >> 10). Для стресс-платы это 10 100 текселей по 16 байт, около 160 КБ в кадр, — для шины PCIe пустяк.
Отсюда «живая» картинка: провод светится, когда в сети 1, вспыхивает при смене значения (по времени из третьего канала), краснеет, если сеть в unstable. CPU в этом не участвует, он только копирует массив values.
Чего здесь нет, так это иерархического LOD - агрегации далёких вентилей в «квадратик среднего цвета». При отъезде работают три более простые вещи:
корпуса деталей рисуются через egui, и каждый проверяется на попадание в видимую область (
part_on_screen), так что при приближении рисуется только видимое;сетка поля гаснет через
smoothstepот масштаба, чтобы на дальнем плане не было муара из точек;полосы битов на шинах гаснут в сплошной цвет, когда шаг полосы становится меньше примерно двух пикселей, — фильтр прямо в шейдере, как у уменьшенной картинки.
Масштаб камеры ограничен от 2 до 160 пикселей на клетку. Плата 100×100 — это 600×400 клеток, и при 2,2 пикселя на клетку (кадр из гифки) она целиком помещается в окно. Сколько это даёт FPS на конкретном железе, мы тут называть не будем: проверяли на своей машине и на записи роликов, а не на парке видеокарт.
Когда событийный режим выигрывает
Процессор — противоположность стресс-платы. Там десятки тысяч вентилей, но за такт меняется малая часть: в АЛУ считается одна операция, декодер дешифрует одну команду, большинство регистров стоят. Для этого в движке есть «турбо» - событийная симуляция:
struct Ev {
    fan_at: Vec<u32>,   // сеть -> комбинационные узлы-потребители (CSR)
    fan: Vec<u32>,
    clk_at: Vec<u32>,   // сеть -> регистры, у которых она clk
    clks: Vec<u32>,
    loop_of: Vec<u32>,  // узел -> номер петли
    dirty: Vec<u64>,    // битовая маска «грязных» узлов
    ...
}
Когда сеть меняется, touch ставит в битовую маску бит каждого её потребителя (список потребителей - в формате CSR, два плоских массива). А дальше главный трюк:
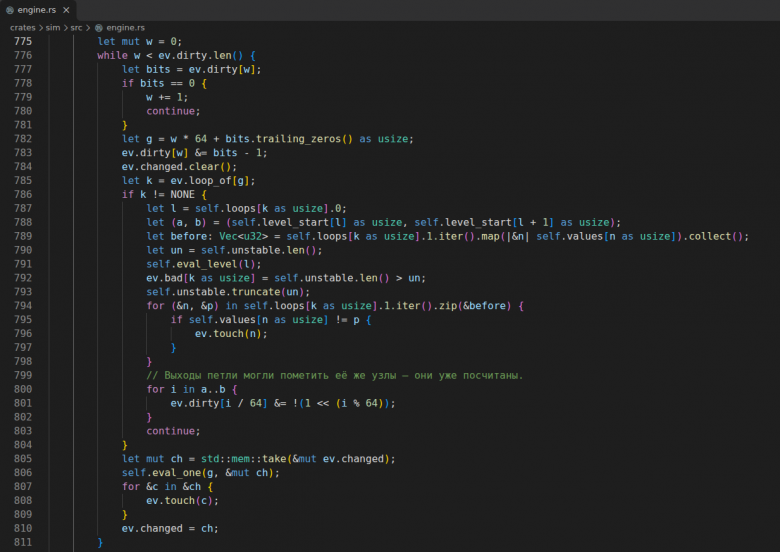
Узлы уже отсортированы по уровням, значит, потребитель всегда стоит в массиве позже своего драйвера. Поэтому вместо очереди событий хватает битовой маски и курсора, который идёт только вперёд: берём слово маски, trailing_zeros() даёт номер ближайшего грязного узла, считаем его, и если выход изменился, помечаем потребителей - а они гарантированно правее курсора. Проход заканчивается, когда курсор дошёл до конца. Ни приоритетной очереди, ни сортировки по времени, и каждый узел считается за проход не больше одного раза. Пустые слова маски пропускаются по 64 узла за раз.
Петли и здесь особый случай: если грязный узел принадлежит петле, пересчитывается весь её уровень до неподвижной точки, а потом снимаются отметки с её собственных узлов. Петля, которая не сошлась (генератор), помечается как «плохая» и пересчитывается на каждом проходе.
Результат событийного режима обязан совпадать с полным проходом бит в бит. Это проверяют два теста: turbo_matches_settle на синтетических схемах и turbo_matches_machines на настоящих процессорах из игры - после каждого полутакта сравниваются все сети.
Таблицы истинности вместо вентилей
Второе ускорение — поведенческий режим. Блок, который игрок уже собрал, и который прошёл свой уровень, можно не разворачивать в вентили, а посчитать готовой функцией. Если у блока нет памяти и на входе не больше 20 бит, движок просто прогоняет его вентильную схему на всех входах и запоминает ответы:
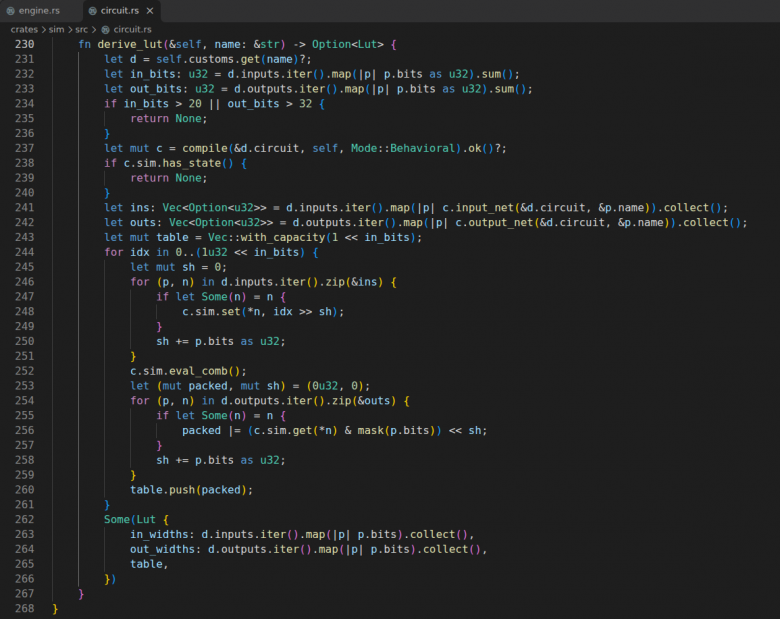
2^20 строк по 4 байта — максимум 4 МБ на блок, а восьмибитный сумматор с переносом (17 входных бит) - 128 тысяч строк, которые считаются один раз и кэшируются в библиотеке. Дальше вычисление блока — это склейка входов в индекс и одно чтение из массива. Ключевое свойство: таблица снята со схемы самого игрока, а не написана нами, поэтому поведенческий блок ведёт себя точно как его вентили, включая ошибки.
Для широких блоков конвейера (16-битный сумматор, мультиплексор, декодер команд, исполнительный блок), которые в 20 бит не влезают, есть нативные модели на Rust, около сотни строк в natives.rs. Это сознательная оптимизация: без неё большие схемы поздних глав тормозили бы на машинах игроков. Нативные модели включаются только в турбо-прогоне финальных глав, только для блоков без состояния и только после того, как блок прошёл тесты своего уровня, — дальше он считается по спецификации, без повторной проверки в рантайме. Цена этого решения известна и записана прямо в комментарии к модулю: поведение блока за пределами тестов не покрывается, то есть блок, верный на тестах и неверный вне их, в турбо посчитается «правильно». Эталоном при этом остаётся обычный режим в вентилях.
Что это даёт на машине из главы «Твоя игра» (замер тестом turbo_matches_machines с NAND2_BENCH=1, тот же EPYC, сборка без LTO):
режим |
узлов |
тактов в секунду |
|---|---|---|
всё в вентилях, полный проход |
44 910 |
~2 500 |
всё в вентилях, турбо |
44 910 |
~5 500 |
блоки таблицами, полный проход |
4 005 |
~5 600 |
блоки таблицами, турбо |
4 005 |
~16 200 |
таблицы + нативные блоки, турбо |
2 867 |
~31 500 |
Разница между первой и последней строкой — больше чем в 12 раз, и именно эта разница отделяет «процессор работает» от «на процессоре можно играть».
От NAND до шутера
Теперь, когда понятно, на чём всё крутится, — что на этом строится. Путь по эпохам такой: NAND, из него NOT, AND, OR, XOR, полусумматор и сумматор, мультиплексоры, триггеры и регистры, счётчик, АЛУ, затем своя простая система команд и ассемблер, потом команды RISC-V.
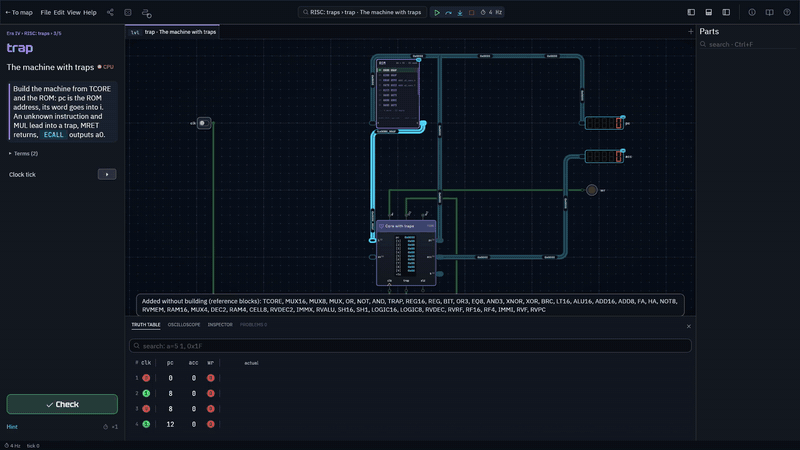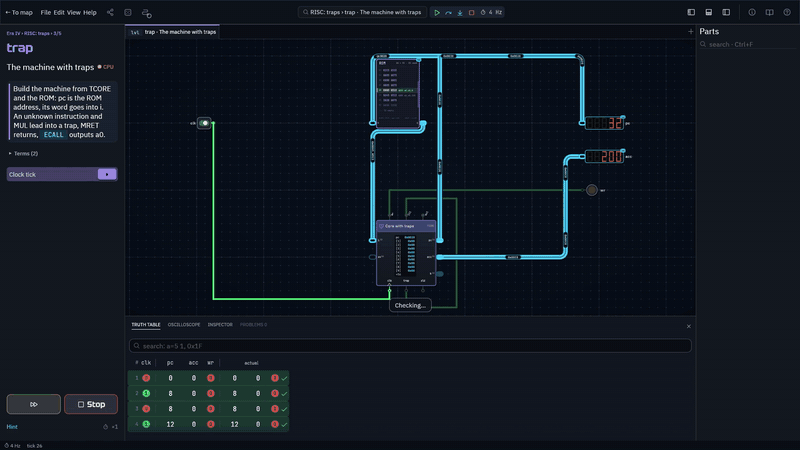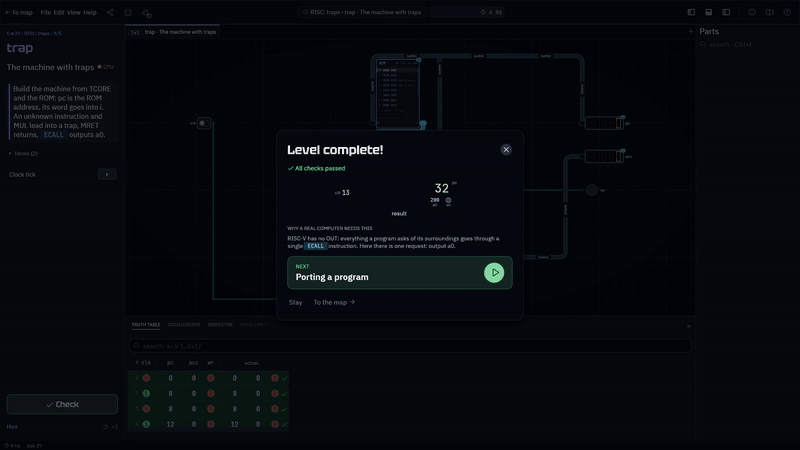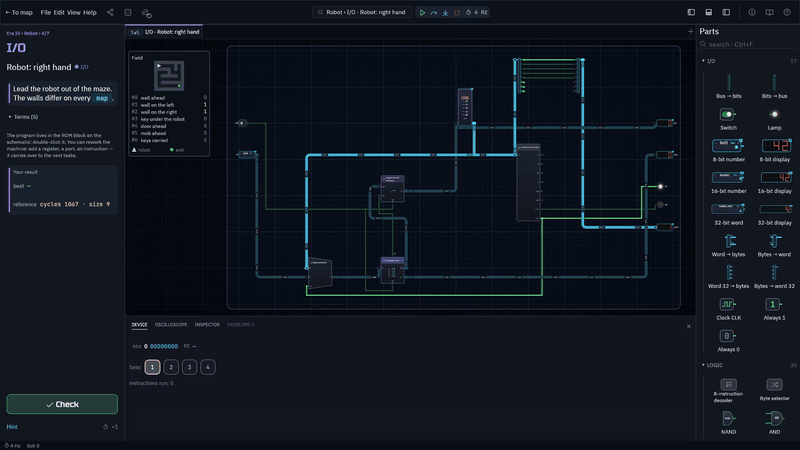
Процессор в поздних главах — это подмножество RISC-V с раскладкой полей RV32E: 32-битные команды, 16 регистров, но данные и адреса 16-битные, чтобы схема оставалась обозримой. Дальше игрок делает его быстрее: конвейер, проброс результатов (forwarding), кэш. Метрика скорости — «путь», самая длинная цепочка вентилей между регистрами; она считается тем же движком по тем же уровням.
В главе «Твоя игра» процессор подключается к шине устройств: экран 64×48 пикселей в формате RGB332, клавиатура, сделанная по образцу PL050 (PS/2-контроллер ARM), и устройство SYSCON, запись 0x5555 в которое означает «тест пройден», как test finisher в SiFive.
Дальше игрок пишет на ассемблере для своей же машины рейкастер: DDA, как в Wolfenstein 3D, фиксированная точка 8.8 (умножение 8.8 × 8.8 собирается из четырёх 8-битных MUL), карта 16×16 клеток, кадр — 32 луча, по столбику на луч. Поздние главы ещё в работе и будут приходить обновлениями, так что их содержимое может поменяться.
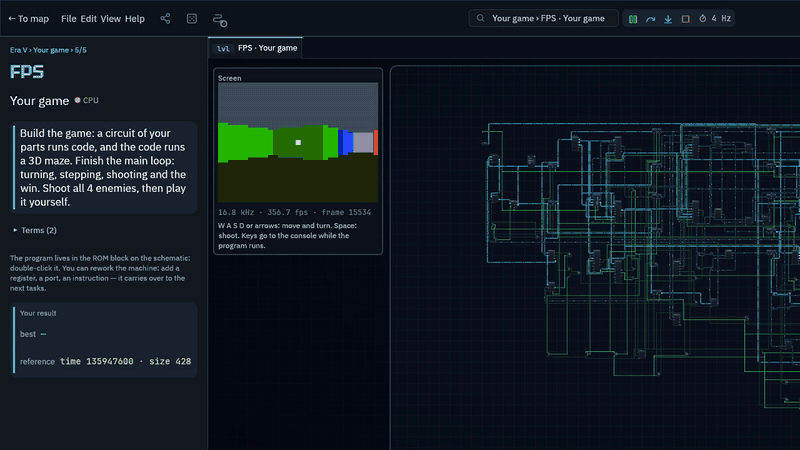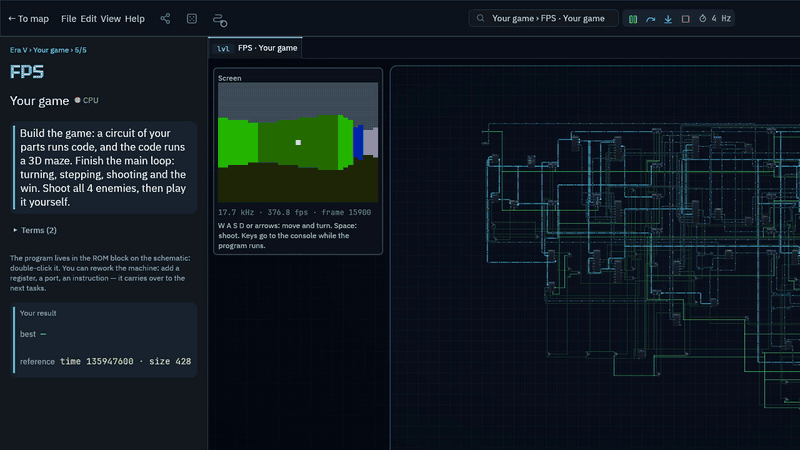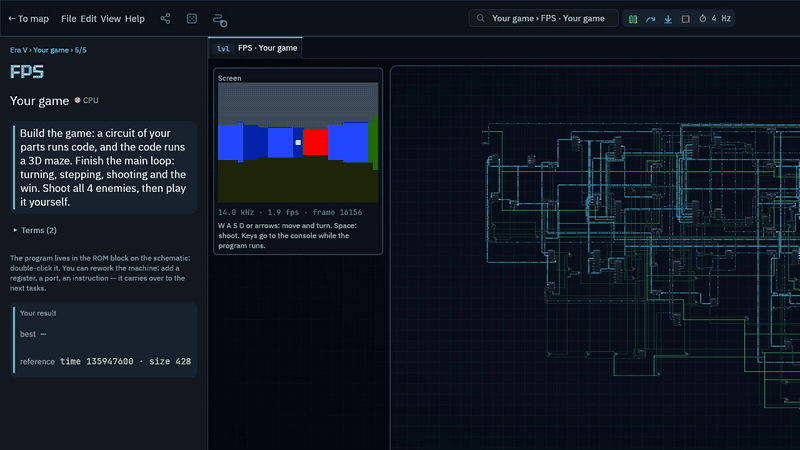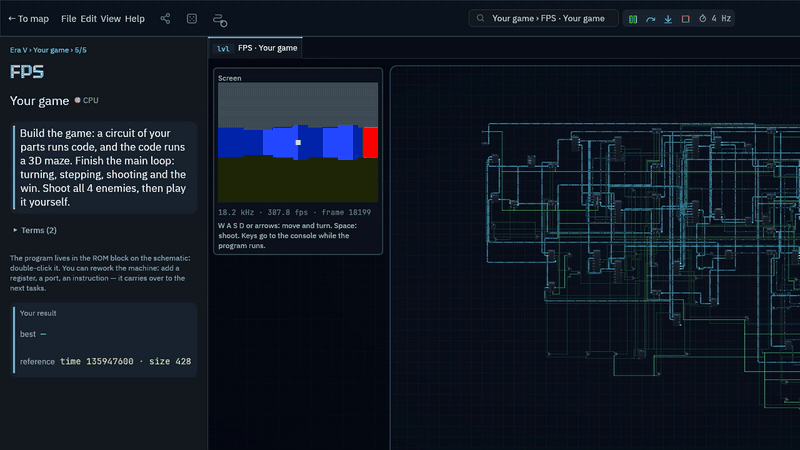
(Клип ускорен в 2 раза.) Каждый пиксель на этом экране посчитан программой, которая выполнена схемой, которую игрок собрал из своих же блоков, — и при выключенных нативных моделях всё это сводится к тем самым NAND из первого уровня.
Что мы бы сделали иначе
values: Vec<u32>для однобитных схем расточительно. Битово-параллельная симуляция (64 вентиля в одномu64) была бы быстрее на стресс-плате, но сломала бы простоту шин. Пока упора в это нет.Нет многопоточности. Уровни естественно параллелятся, но на 10 000 вентилей проход занимает 16 мкс, и синхронизация потоков съест больше, чем даст.
Нет иерархического LOD в рендере. С текущими лимитами доски он не понадобился, но если игроки начнут строить платы на сотни тысяч вентилей, это первое, что придётся делать.
Если хотите посмотреть на это вживую, у игры есть страница в Steam, её можно добавить в список желаемого: https://store.steampowered.com/app/4984320/
Вопросы по движку - в комментарии, ответим.
WannaCode
А на видеокарте не пробовали делать? В Turing Complete на RTX 3060 RISC-V до 1 МГц разгонялся.
anywaymachines Автор
не пробовали. 10к вентилей у нас проходят за ~16 мкс на одном ядре, это ~60к тактов в секунду. на gpu каждый такт надо синхронизировать и тащить состояние обратно на cpu (тесты, осциллограф, ram), на наших размерах это дороже самого счёта. плюс петли защёлок досчитываются итерациями, они плохо параллелятся. если игроки начнут строить на порядок больше, посмотрим, wgpu и так под рукой
rPman
зачем? зачем визуализации realtime информация?
почему бы все не делать на gpu?
p.s. 10к структур данных это очень мало, pcie спокойно прожует и большие объемы
anywaymachines Автор
справедливо, каждый такт гонять туда-обратно не обязательно: визуализации хватит кадра, а след для тестов и осциллографа можно копить в буфере на gpu и забирать пачкой. но шина тут и не узкое место.
посмотрели в бенче: схема на 12к вентилей — это 37 уровней, полный пересчёт всех вентилей ~30 мкс на одном ядре (~380 млн вычислений вентилей в секунду), а в обычном режиме считаются только те, у которых сменился вход, их обычно единицы процентов. на gpu уровни зависят друг от друга, значит на такт нужно 37 глобальных барьеров. в wgpu нет синхронизации всей сетки внутри одного запуска, поэтому это 37 dispatch'ей по несколько мкс каждый — уже дольше, чем весь такт на cpu. плюс петли защёлок досчитываются до неподвижной точки с заранее неизвестным числом итераций.
где gpu реально выиграет — сотни тысяч вентилей или много независимых копий одной схемы разом, например прогнать все тест-векторы уровня параллельно. вот это, кстати, хорошая мысль, запишем