

На сайте Хэдхантер можно пройти тесты навыков, результаты которых должны выделять успешных кандидатов среди «основной массы». Эти же тесты входят в национальную систему подтверждения ИТ‑компетенций, а на Госуслугах за них можно получить электронный сертификат. Звучит солидно и крайне полезно, но насколько вообще репрезентативны эти тесты в современных условиях бума ИИ? Давайте разберемся.
Меня зовут Виктор, я разработчик с многолетним опытом (про качество опыта говорить ничего не буду, оставим это за скобками). Знаю Delphi, C++ и Java/Kotlin, но особо не разбираюсь в веб‑разработке, JavaScript, Python и искусственном интеллекте. Весь описанный ниже результат я получил с помощью браузерной версии Gemini: просто следовал советам ИИ, запускал скрипты, отчитывался об ошибках, и так по кругу. Мои личные правки минимальны. В целом ничего сложного здесь нет: хоть «домохозяйки» едва ли повторят, но любой начинающий айтишник справится, а более опытные ребята и девчата смогут сделать во сто крат лучше.
Дисклеймер
Материал носит исключительно исследовательский характер. Использование автоматизации для прохождения профессиональных тестов может противоречить правилам площадок и нарушать этику найма.
В данной статье умышленно не приводится готовый к запуску код автоматизации, чтобы он не использовался для массового обмана систем тестирования. Фокус сделан на инженерной стороне задачи: проектировании архитектуры системы, проверке возможностей современных локальных LLM и оценке их результативности и производительности.
В начале была Мысль
Началось всё с желания создать базу тестов. На сайте есть защита: если переключаться в другие вкладки или окна, результаты не засчитываются. То есть просто скопировать вопросы и сохранить в блокнот — не вариант. Записывать экран на видео, а потом распознавать текст — лень. Нужен был инструмент, считывающий и сохраняющий текст в фоне без моего участия. Решил делать систему с помощью скрипта Tampermonkey, который должен парсить страницу и отправлять данные на локальный сервер. Поскольку сейчас я потихоньку осваиваю мир ИИ, следующая логичная мысль была: «А почему бы не прикрутить нейросеть и немного всё это не автоматизировать?» В итоге родилась достаточно простая схема:
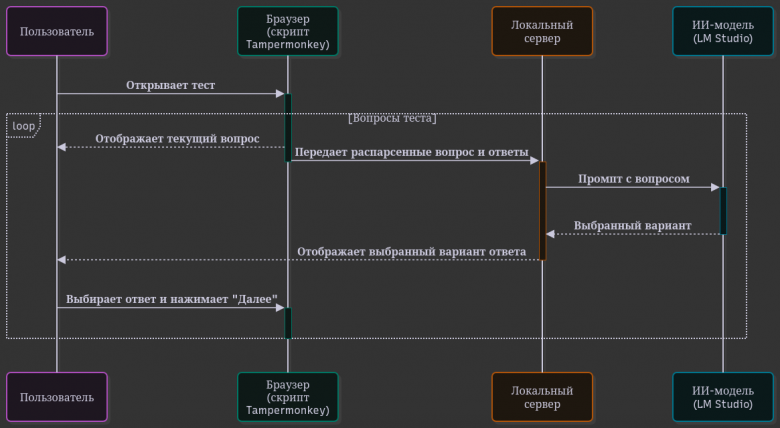
Значит, дальше нужно делать локальный сервер. Идем за советом в Google: «Свет мой, Джемини! скажи, да всю правду доложи: кто в IT‑мире всех милее, всех удобней и быстрее?» И услышал я в ответ: «то Питон, тут спору нет». Сказка ложь, да в ней намек — спорить с ИИ совсем не впрок, связал я кодик в узелок и сварганил сервачок.
Первая версия имела две функции: могла сохранять всю HTML‑страницу и отдельно тексты тестов в файлы. Потом я добавил возможность работы с ИИ‑моделями через LM Studio, чтобы мучить их каверзными вопросами от составителей тестов.
В коде прописал системный промпт:
Промпт |
Пояснение |
Тестирование по Git: задан 1 вопрос и несколько ответов на него. |
На всякий случай указал предметную область, чтобы ИИ было проще понять контекст тестирования. |
Не перепроверяй себя более одного раза. |
Поставил условие, чтобы модель слишком тщательно себя не перепроверяла, иначе она может зациклиться на самопроверках, на что уходят драгоценные минуты. |
Не задавай уточняющих вопросов. |
Работа должна идти в фоне и полностью автономно, так что необходимо было избавиться от уточняющих вопросов (хотя я не уверен, что ИИ‑модель в режиме API‑чата вообще станет их задавать). |
Отвечай коротким сообщением, содержащим только текст выбранного ответа и его номер. Не объясняй ответ. |
Указал урезать ответ до предложенных вариантов, чтобы избавиться от лишнего мусора в выдаче. |
Определи правильный ответ. Если есть несколько правильных вариантов, выбери наиболее оптимальный. |
В процессе тестов заметил, что модель иногда выбирает неоптимальный вариант. Пытался улучшить это через промпт, но эффект получился 50/50. |
Для тестирования был сгенерирован еще один Python‑скрипт. Он брал файлы с ранее распарсенными тестами и отправлял их на мой локальный сервер. Таким образом можно было и основной сервер протестировать, и промпты докрутить, и посмотреть, как разные модели справляются с задачами.
После всех доработок итоговый процесс выглядел так: на экране два окна — слева браузер с тестами, справа терминал с запущенным сервером. Как только в браузере появляется вопрос, он улетает на сервер к ИИ, я жду ответа и руками выбираю нужный пункт. И так по кругу.
Тестирование ИИ‑моделей
Базовая схема работала отлично, но захотелось проверить, как разные модели справляются с подобными задачами. Для сравнения выбрал семейство моделей Qwen. Интересно было оценить результативность свежих, относительно крупных моделей на 27–35 млрд параметров в сравнении с мелкими моделями на 7–9 млрд параметров, проверить старые версии (Qwen 2.5), а также узнать, как уровень сложности теста влияет на итоговый балл.
В шапке итоговой таблицы «вопросы» и «время» — это общее количество вопросов и максимальное время, отведенное на одно тестирование. В теле таблицы — количество допущенных ошибок и затраченное время. Модели проходили тесты по 3 раза, время указано среднее, а ошибки — минимум и максимум.
Для тестов базового уровня (на 10–11 вопросов) допустимо сделать 2 ошибки. Для продвинутого уровня, скорее всего, допускается 3–4 ошибки (точную границу не знаю, у меня было либо 2 ошибки, либо тест провален вхламину). Красным в таблице выделены явные провалы, а желтым — пограничные результаты.
Модель Qwen3.8–27B на моем ПК выдает не более 6 токенов/сек. Это слишком медленно для работы в режиме рассуждений, но хотелось проверить возможность использования моделей на такой скорости, поэтому она тестировалась без рассуждений. В самом конце я добавил модель Qwen3.8–9B CPU — она загружалась полностью в оперативную память и работала на процессоре, имитируя совсем спартанские условия.
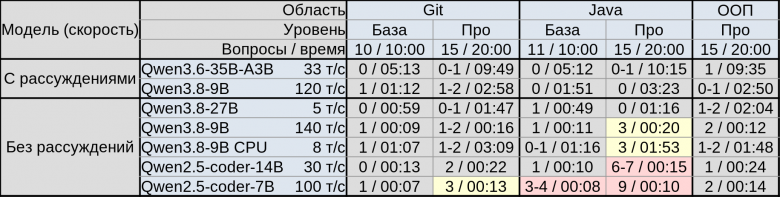
Как видим, почти все модели успешно справились с тестированием, только старушка Qwen2.5 подкачала в некоторых задачах. Сложность теста может быть критичной для слабых моделей, хотя по теме ООП все участники успешно сдали даже продвинутый уровень.
Из минусов мелких моделей: формат ответов крайне нестабильный. Я просил выводить только полный текст ответа и ничего больше (сами тексты всегда начинались с номеров), но модели всё равно выдавали:
текст, удалив номер;
только номер;
текст, а затем номер;
номер одного ответа, а текст от другого (самый неприятный момент);
«лишнюю» информацию — текст вопроса или развернутое объяснение своего выбора.
Выводы
Не претендую на роль истины в последней инстанции, этот блок — лишь мое оценочное суждение и личное мнение.
По сути, система теоретических тестов HeadHunter сегодня — это филькина грамота. Используется простейшая защита, разработанная еще в до‑ИИ эпоху. Сейчас обойти её может любой страждущий, даже не сильно разбирающийся в теме. Соответственно, наличие этих сертификатов у кандидата вообще ничего не гарантирует.
Причем для обхода защиты достаточно бесплатных программ, веб‑версии Gemini, слабого ПК и минимума времени. Но даже если локальные ИИ для вас не вариант, всегда можно просто открыть Gemini во втором окне браузера и использовать его в место локальной LLM. А можно пойти еще дальше и обойтись вообще без автоматизации: просто фотографировать вопросы на смартфон и отправлять их в ИИ‑чат со встроенным зрением — модель мгновенно распознает текст с экрана ПК и выдаст правильный ответ, пока система защиты Хэдхантера будет свято верить, что вы никуда не переключались. Но это совсем другая скучная история, не подходящая для пытливого ИТ‑ума.
Что дальше?
Мне еще хочется немного поэкспериментировать в этом же направлении с двумя темами:
-
прохождение практических тестов (Java и C++) с помощью ИИ‑агента. В моих планах модель должна написать код, агент — скомпилировать его, прогнать по тестам, поправить по необходимости и выдать мне готовый результат. Возможные трудности:
нужно разбираться с оркестрацией и управлением агентами;
локальная модель может не успеть выполнить задачи за отведенное время;
неизвестно, как защита сайта отреагирует на работу с буфером обмена (возможно, придется писать эмулятор ввода текста, чем заниматься совсем не хочется).
-
прохождение тестов по английскому языку. Здесь появятся задачи, с которыми я ранее не сталкивался:
необходимо перехватывать и вытаскивать аудиопоток прямо из браузера;
нужно внедрять отдельную Speech‑to‑Text модель для распознавания речи и перевода аудио в текст.
Кому тема понравилась или если что‑то осталось непонятным — добро пожаловать в комментарии. А признанных гуру ИИ и автоматизации буду рад видеть с конструктивной критикой: указывайте на ошибки и узкие места, до исправления которых я еще не дорос.
ajijiadduh
это же сарказм, да?