

Я заметил что кодинг агенты перед выполнением задачи запускают "find, rg --files, glob" для поиска файлов и нужных классов и модулей. Потом поиск по содержимому файлов через "rg, grep". И на это сжигается много токенов. И я решил проверить можно ли сэкономить на токенах используя семантический поиск вместо всего выше перечисленного. Если локальный GPU простаивает, почему бы тогда на нем семантический поиск не гонять.
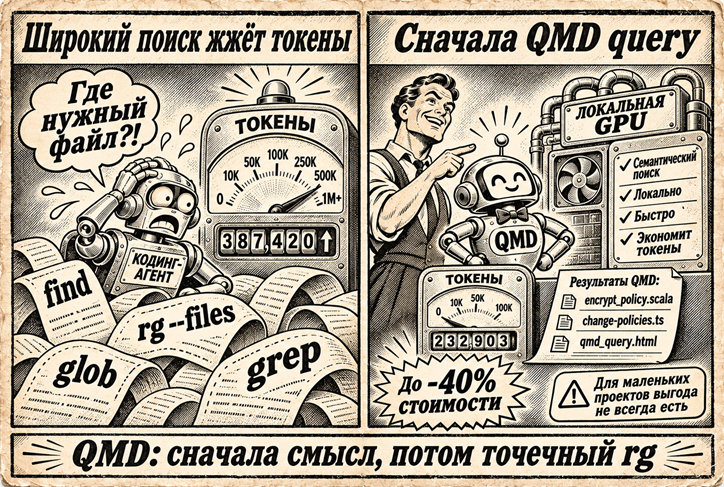
Сам я работаю в компании связанной с безопасностью. И в одном из моих проектов я использую семантический поиск чувствительных документов. И тут мне знакомый присылает ссылку на OpenSource проект который тоже занимается этой задачей. Проект называется "QMD - Query Markup Documents". Работает из командной строки, извлекает текст из всех форматов документов и создает индекс. Поддерживает он несколько вариантов поиска:
# Search across everything
qmd search "project timeline"           # Fast keyword search
qmd vsearch "how to deploy"             # Semantic search
qmd query "quarterly planning process"  # Hybrid + reranking (best quality)
Нас интересует последний вариант. Чтобы он работал требуется 3 вещи:
embeddinggemma-300M-Q8_0 Vector embeddings (default) ~300MB
qwen3-reranker-0.6b-q8_0 Re-ranking ~640MB
qmd-query-expansion-1.7B-q4_k_m Query expansion (fine-tuned) ~1.1GB
Первая модель используется для индекса чтобы вычислить смысловые вектора кусков текста. Вторая используется чтобы сравнить то что было найдено насколько оно близко по смыслу с поисковым запросом. Ну а третья чтобы нагенерить несколько поисковых запросов из исходного запроса чтобы поиск был шире.
Сначала надо добавить свои исходники в qmd (это пример для минималистичный проект где сервер на Rust а фронтенд на Angular):
qmd collection add . \
  --name PROJECT1 \
  --mask "src/**/*.rs,\
frontend/src/**/*.{ts,html,scss},\
README.md,\
frontend/README.md,\
Cargo.toml,\
frontend/package.json,\
frontend/angular.json,\
frontend/tsconfig*.json,\
frontend/proxy.conf.json"
Можно руками не делать этого - покажите пример этого своему кодинг агенту и скажите сделай также только для текущей репы - он сам догадается что в индекс добавить какие папки, расширения - что исключить и тд.
Теперь запустим индексацию (ее надо перезапускать периодически когда у вас кодовая база меняется):
qmd update && qmd embed -c PROJECT1
Чтобы сдружить кодинг агента с этой qmd ему нужно в AGENTS.md добавить следующее:
# QMD — Efficient Code Discovery

**Цель:** минимизировать стоимость токенов и время поиска кода без ущерба корректности.

## Выбор инструмента

- Известен путь → читай файл напрямую.
- Известен идентификатор, ошибка или строка → `rg` / LSP.
- Известно только поведение → `qmd query`.
- Код найден → изучай необходимые участки через стандартные инструменты.
- Информации достаточно → выполняй задачу.

**QMD заменяет первоначальный широкий поиск, а не добавляет новый этап.**

## Семантический поиск

Используй существующую коллекцию проекта.

"""
qmd query "DESCRIPTION" -c PROJECT1 -n 15 --files \
  | grep -E '\.(EXT1|EXT2|EXT3)$' \
  | cut -d, -f3- \
  | sed 's|^qmd://[^/]*/||' \
  | head -n 10
"""

- Один конкретный запрос, предпочтительно с английскими техническими терминами.
- Выбирай расширения по проекту, включая конфигурационные при необходимости.
- Читай сначала 3–5 наиболее релевантных файлов, только нужные участки.
- Если реализация не найдена — уточни запрос, при необходимости увеличь `-n` до 60, затем используй `rg` / LSP.
- После обнаружения реализации прекрати семантический поиск.

## Экономия токенов

- Не сканируй весь репозиторий перед QMD.
- Не повторяй поиски без причины и не открывай все результаты.
- Не исследуй несвязанный код и зависимости.
- Не составляй подробных планов и отчётов о поиске.
- Не пересказывай прочитанный код.
- Как только информации достаточно — вноси изменения и проверяй результат.

**Приоритет: корректность → стоимость токенов → время.**
Тестировал я вот на таком вот репозитории где 1231 исходный файл на Java/Scala/Angular:
C:\Users\igumn\jcm-server>qmd collection list
jcm-server (qmd://jcm-server/)
  Pattern:  server/src/**/*.scala,server/src/**/*.java,server/src/**/*.xml,server/src/**/*.properties,server/src/**/*.js,server/src/**/*.ts,server/src/**/*.css,server/src/**/*.html,server/src/**/*.tmpl,server/src/**/*.txt,server/src/**/*.md,server/pom.xml,server/Dockerfile,server/*.md,server/README.txt,web/src/**/*.ts,web/src/**/*.html,web/src/**/*.scss,web/src/**/*.css,web/package.json,web/angular.json,web/tsconfig*.json,web/karma.conf.js,web/README.md,!server/src/main/resources/templates/**,!server/src/main/resources/messages*,!server/src/main/resources/messages*/**,!web/src/assets/lang/**
  Files:    1231
  Updated:  1h ago
Промпт: "Добавь в полиси шифрования дисков флаг антиквантовое шифрование - по умолчанию оно выключено - т.е. оно должно в редактировании полиси задаваться в веб-интерфейсе - сохраняться в БД и передаваться на агента как полиси шифрования через REST-эндпоинт"
Сравнение стоимости
По тем же тарифам GPT-5.3-Codex: Input $1,75, Cached $0,175, Output $14 за 1 млн токенов.
Метрика |
С QMD |
Без QMD |
Разница |
|---|---|---|---|
Input |
65 006 |
101 501 |
-35,96% |
Cached input |
317 568 |
1 191 808 |
-73,35% |
Output |
13 859 |
16 348 |
-15,23% |
Reasoning |
9 607 |
11 260 |
-14,68% |
Стоимость |
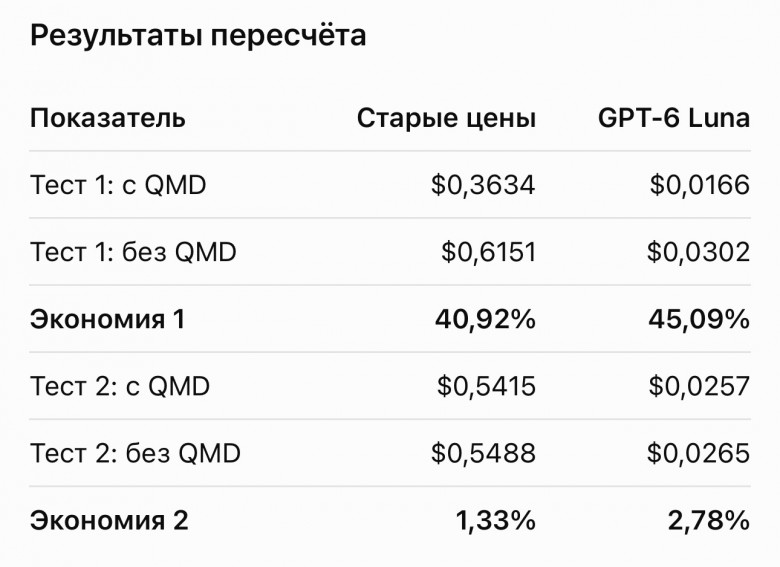
$0,3634 |
$0,6151 |
-40,92% |
Теперь QMD экономит 40,92% стоимости!
Особенно заметно снижение cached input: почти в 4 раза.
Промпт: "Добавь в полиси стирания поле "dry" - нужно его редактировать в веб-интерфейсе и сохранять в БД - также передавать через /rest эндпоинт на агент который занимается стиранием - по умолчанию значение false"
Расчёт по прежним тарифам GPT-5.3-Codex: Input $1,75, Cached $0,175, Output $14 за миллион токенов.
Сравнение
Метрика |
QMD |
Без QMD |
Разница |
|---|---|---|---|
Input |
77 167 |
98 042 |
−21,29% |
Cached input |
936 832 |
854 912 |
+9,58% |
Output |
17 322 |
16 259 |
+6,54% |
Reasoning |
8 835 |
10 264 |
−13,92% |
Стоимость |
$0,5415 |
$0,5488 |
−1,33% |
Здесь QMD оказался дешевле на 1,33%. Экономия есть, но небольшая.
Вывод: QMD сократил обычные входные токены на 21,3% и reasoning на 13,9%, но увеличение cached input и output почти полностью съело экономию.
В общем разброс экономии от 40% стоимости до 1%. По-моему неплохой результат. Надо конечно выборку побольше делать. Но я уже спать хочу. Пишите в комментариях кто больше выборку сделал и какие результаты.
PS
Рекомендую проверять не попадает ли хлам в ваш индекс. Попробуйте сами запустить смысловой запрос. Я один раз прошляпил скомпилированные .js файлы и большие lang-файлы - они сильно засоряли результат семантического поиска. Вот пример, как запустить руками поиск:
C:\Users\igumn\jcm-server>qmd query "disk encryption policy editing form persisted setting sent to endpoint for agent" -c jcm-server -n 15 --files
Expanding query... (3.0s)
├─ disk encryption policy editing form persisted setting sent to endpoint for agent
├─ lex: disk encryption configuration
├─ lex: disk encryption policy
├─ vec: disk encryption configuration
├─ vec: disk encryption policy
└─ hyde: The topic of disk encryption policy editing form persisted setting se...
Searching 6 queries...
Embedding 4 queries... (1.5s)
Reranking 40 chunks... (3.3s)
#d70022,1.00,qmd://jcm-server/server/src/main/java/com/jetico/jcm/server/domain/common/bcvolume/EncryptPolicy.scala
#732b09,0.63,qmd://jcm-server/server/src/main/java/com/jetico/jcm/server/service/ajax/common/EncryptSettingsManager.scala
#e66494,0.63,qmd://jcm-server/web/src/app/modules/management/components/company/dialogs/add-or-update-policies/add-or-update-policies.component.html
#413c5e,0.62,qmd://jcm-server/web/src/app/modules/management/components/group/dialogs/change-policie/change-policies.component.html
#413c5e,0.62,qmd://jcm-server/web/src/app/modules/management/components/computer/dialogs/change-policie/change-policies.component.html
#758b4d,0.62,qmd://jcm-server/server/src/main/java/com/jetico/jcm/server/service/mcp/McpFacade.scala
#4e8973,0.62,qmd://jcm-server/web/src/app/modules/management/components/group/dialogs/change-policie/change-policies.component.ts
#bef78e,0.62,qmd://jcm-server/web/src/app/modules/management/components/computer/dialogs/change-policie/change-policies.component.ts
#4fcd1c,0.61,qmd://jcm-server/server/src/main/java/com/jetico/jcm/server/service/mcp/McpToolbox.scala
PPS
Пробовал на маленьком проекте из 27 файлов. Наоборот вышло +60% стоимости. Решение оказалось избыточное. В общем пользуйте только на больших кодовых базах.
UPDATE
Тестирование велось на модели Luna 6. Цены взял от старой модели для быстрой качественной оценки. Если пересчитать на цены Luna 6 картина не меняется. И да по скорости, там где -40% время работы кодинг агента с 6 минут сократилось до 4 минут.
UPDATE
Я всетаки сделал гибридное решение QMD + GitNexus. GitNexus делает структурный анализ кода (AST, граф зависимостей) и позволяет по нему искать. Вот такие результат:
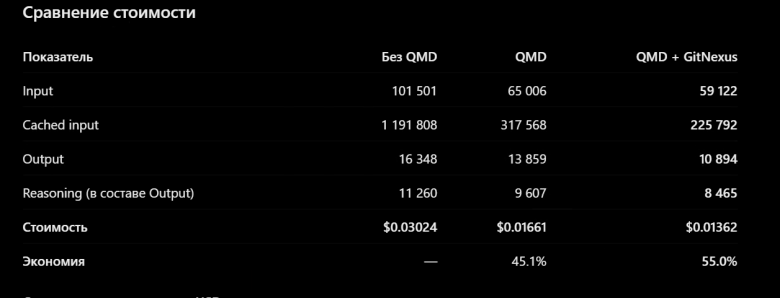
Показатель с 45% вырос до 55%! Время работы с 6 минут выросло до 7 минут. Вот видоизмененные инструкции для AGENTS.md
# QMD + GitNexus — Efficient Code Discovery

**Цель:** находить нужный код и его связи с минимальными затратами токенов, не снижая корректность.

## Выбор инструмента

- Известен путь к файлу → читай его напрямую.
- Известен точный идентификатор, ошибка или строка → используй `rg` / LSP.
- Известно только поведение, а место реализации неизвестно → используй семантический поиск QMD.
- Нужно понять связи символа, путь выполнения или влияние изменения → используй структурный анализ GitNexus.
- После обнаружения кода → изучай нужные участки стандартными инструментами.

QMD и GitNexus заменяют первоначальный широкий поиск, а не добавляют обязательные этапы. Используй только те инструменты, которые нужны для задачи.

## Семантический поиск QMD

Используй существующую коллекцию проекта:

    qmd query "DESCRIPTION" -c PROJECT1 -n 15 --files \
      | grep -E '\.(EXT1|EXT2|EXT3)$' \
      | cut -d, -f3- \
      | sed 's|^qmd://[^/]*/||' \
      | head -n 10

- Сформулируй один конкретный запрос, предпочтительно с английскими техническими терминами.
- Укажи подходящие расширения исходников и конфигурационных файлов.
- Сначала читай 3–5 наиболее релевантных файлов и только нужные участки.
- Если реализация не найдена — уточни запрос, при необходимости увеличь `-n` до 60, затем используй `rg` / LSP.
- После обнаружения реализации прекрати семантический поиск.

## Структурный анализ GitNexus

GitNexus используй через CLI, когда нужно исследовать структуру кода:

- `context` — связи и контекст известного символа.
- `impact` — возможное влияние изменения символа.
- `trace` — путь между известными символами.

Примеры:

    gitnexus context SymbolName
    gitnexus impact SymbolName
    gitnexus trace SourceSymbol TargetSymbol

Если символ неизвестен, сначала найди его через QMD, `rg` или LSP. Используй GitNexus только когда его структурный анализ поможет ответить на вопрос; не запускай все команды подряд.

## Экономия токенов

- Не сканируй весь репозиторий перед QMD.
- Не повторяй поиски без причины и не открывай все результаты.
- Не исследуй несвязанный код и зависимости.
- Не составляй подробных планов и отчётов о поиске.
- Не пересказывай прочитанный код.
- Как только информации достаточно — вноси изменения и проверяй результат.

**Приоритет: корректность → стоимость токенов → время.**
Создавайте обязательно .gitnexusignore файл что бы в индекс мусор не попадал, а попадали только исходники. Ну и запуск GitNexus индексации командой:
gitnexus analyze --index-only
Комментарии (23)

InsiderCrush
16.11.2026 01:04Вы только токены и цены посчитали, но нет никаких данных о качестве кода с применением QMD и без применения. Плюс отчетливо видно что характер экономии нестабильный и невоспроизводимый. Очень похоже на то, что вы своими допусками и оговорками притягиваете результат за уши для броского заголовка и выводов недоказанных и обоснованных небольшой выборкой.

igumnov Автор
16.11.2026 01:04Согласен, выборка небольшая, о чем я прямо написал в статье. Это предварительный эксперимент, а не полноценный статистический бенчмарк. На двух задачах большого проекта экономия составила 40,92% и 1,33%. Формально медианная экономия 21,1%, но при двух измерениях делать из нее статистически значимые выводы некорректно. При этом разброс между разными задачами еще не означает невоспроизводимость. Для ее оценки нужно многократно запускать одну и ту же задачу в одинаковых условиях и смотреть на распределение результатов. Качество кода отдельно не измерял, это справедливое замечание. Для полноценного исследования нужны десятки задач, повторные прогоны, проверка корректности изменений, медиана стоимости и межквартильный размах. Но цель статьи была скромнее проверить, может ли семантический поиск вообще снизить расходы на токены. В одном случае снижение оказалось около 41%, в другом — практически нулевым, а на маленьком проекте QMD вообще увеличил стоимость на 60%. То есть я не утверждаю, что QMD гарантированно экономит 40%. Я показываю, что такой эффект возможен, и при каких условиях инструмент может оказаться полезен.
InsiderCrush
16.11.2026 01:04Ну, тогда получается, что Вы просто описали любопытное локальное наблюдение. Я то подумал Вы уже метод заявляете.
igumnov Автор
16.11.2026 01:04Я хочу расширить эксперимент. Добавить структурный анализ кода (AST, граф зависимостей) с помощью GitNexus. Авторы GitNexus тоже заявляют о снижении расхода токенов кодинг-агентами. Идея не в том, чтобы сравнить три подхода по отдельности, а в том, чтобы объединить их в одной сессии: обычный текстовый поиск (find, rg, grep), семантический поиск (QMD) и структурный анализ (GitNexus). Хочу, чтобы ИИ-агент сам выбирал наиболее подходящий инструмент в зависимости от ситуации и при необходимости комбинировал их. Например, семантическим поиском находил нужную функциональность, через граф зависимостей изучал связи между компонентами, а точным поиском находил конкретные вызовы и реализации. Цель добиться максимальной эффективности всей связки: сократить расход токенов без потери качества анализа и генерируемого кода.
InsiderCrush
16.11.2026 01:04Хочу, чтобы ИИ-агент сам выбирал наиболее подходящий инструмент
Рискуете еще снизить эффект от снижения расхода токенов за счет перебора вариантов, лишних диалогов и ложных срабатываний. Но еще до всего этого надо прогнать тесты с одинаковым ТЗ с QMD и без него и качество кода сравнить. Иначе может получиться что гора родила мышь.
igumnov Автор
16.11.2026 01:04Посмотри апдейт статьи ) сокращение еще на 10%, те экономия 55% если QMD + GitNexus. Желаешь сам попробовать потестить? Независимый и нормальный бенчмарк сделать )
InsiderCrush
16.11.2026 01:04Да, глянул! Впечатляет прирост, если он не фиктивный. Сам не, не вывезу. Это кучу всего готовить и настраивать. Но если по факту через какое то время тема с QMD подтвердится и еще статьи будут - однозначно сворую идею и себе :D

Varowlord4
16.11.2026 01:04К тому же кэшированный ввод у моделей очень сильно зависит от порядка чтения файлов и длины системного промпта в конкретной сессии. Два разных промпта на одной и той же задаче легко дадут разброс в тридцать процентов даже без всяких плагинов

MaxAhmed
16.11.2026 01:04я где-то похожую идею уже встречал. По моему был аналогичного назначения плагин для. Opencode, но не уверен. Выглядит логично, но есть один момент - grep и прочие работают непосредственно по актуальной кодовой базе. В вашем варианте, если я правильно понял, поиске идет по состоянию на момент последней индексации. Переидндексация как-то автоматически выполняется или ее надо руками проводить?
igumnov Автор
16.11.2026 01:04Я руками запускаю, но можно в AGENTS.md добавить 1 строчку - мол запускай переиндексацию когда завершил работу такими-то командами или хук сделать, который по завершении сессии сам переиндесацию запускает, кстати она очень быстрая так как 10-20 файлов переиндексировать быстро ). А 1000 файлов за 2-3 минут на моей GPU он индесирует "с нуля".
Varowlord4
16.11.2026 01:04По уму такой инструмент должен работать как фоновый демон с файловым вотчером, пересчитывая эмбеддинги только для измененных файлов на лету, как это делают современные IDE. Запускать обновление руками в 2026 году уже неудобно
igumnov Автор
16.11.2026 01:04Либо это уже есть в QMD и GitNexus или ИИ вам напишет за 5 минут такой демон )
igumnov Автор
16.11.2026 01:04Или проще поставить хук на ИИ агенте после завершения его работы всегда переиндексировать что изменилось. Работы - это не выход из него, когда он закончил и отчитался о проделаной работе.

Asmolve
16.11.2026 01:04Есть же Graphify для этого
igumnov Автор
16.11.2026 01:04Да, Graphify тоже интересный вариант. Но у меня цель немного другая, объединить семантический поиск по embeddings (QMD) и структурный анализ кода через AST и граф зависимостей (GitNexus). Хочу, чтобы агент сам выбирал подходящий инструмент в зависимости от задачи и минимизировал расход токенов. Graphify тоже можно добавить в сравнение, но в нем нет семантического поиска совсем.
Varowlord4
16.11.2026 01:04Граф хорош, когда ты уже знаешь точку входа или имя класса и хочешь проследить цепочку вызовов
Когда же в ТЗ написано поменять логику биллинга и ты вообще не знаешь, как названы файлы в старом проекте, граф тебе слабо поможет

Yarus23
16.11.2026 01:04codebase memory mcp
igumnov Автор
16.11.2026 01:04QMD использует три локальные модели: embeddings, расширение запросов и LLM reranking. Codebase Memory использует встроенную
nomic-embed-codeи комбинирует векторную близость с признаками AST, графа и типов. Это потенциально удобнее для поиска функций, но не доказывает, что его поиск точнее QMD. Предполагаю что: Codebase Memory может оказаться выгоднее двух отдельных инструментов, особенно на больших репозиториях. Но QMD способен выиграть по качеству первоначального семантического поиска благодаря LLM reranking. Вобщем тестировать нада ) Что лучше )
Varowlord4
16.11.2026 01:04Замер экономии на двух прогонах, где в одном -40% а в другом -1% пока больше похож на обычный шум кэширования промптов и случайность траектории агента, рановато делать выводы без серии из хотя бы 20 одинаковых задач
igumnov Автор
16.11.2026 01:04Это невозможно. Эксперимент без QMD, с QMD, c QMD + GitNexus имеют 3 разных AGENTS.md, что в априори приводит к тому, что промт кешь между экспериментами не возможен. Agent Loop никто не отменял и он начинается с AGENTS.md в самом начале...
jshapen
А где замеры скорости? И почему такая древняя модель выбрана?
igumnov Автор
Модель для оценки стоимости. Использовалась Luna 6 при тестировании. Наверное на ее ценах надо было посчитать. Но это же не суть. Там где экономия 40% ускорение было с 6 минут ускорилось до 4 минут.