

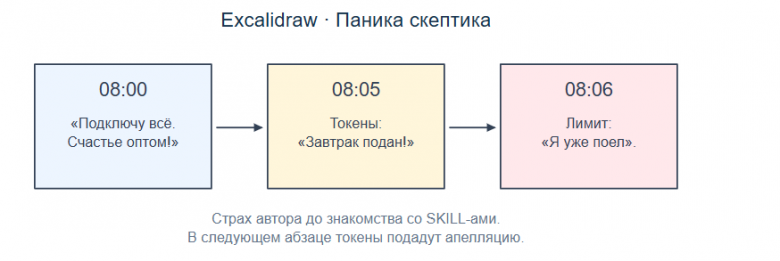
Скажу честно: я не понимал, зачем нужны SKILL‑ы для LLM‑агентов. Вот с MCP все понятно: полезная вещь, с помощью которой можно дать LLM доступ к базе данных или к Figma. Единственный недостаток: чтобы не тратить много токенов, желательно не подключать сразу 30 MCP‑серверов. И вообще, лучше отключать лишние и подключать только те, которые действительно нужны для задачи. В этом свете SKILL‑ы казались мне бесполезным оверхедом, который жрет токены как не в себя. В TikTok часто видел россказни в духе: подключи такой SKILL или сразу целую пачку, и будет тебе счастье. У меня сразу возникала мысль: если подключить их все, лимиты по подписке будут заканчиваться не к обеду, а уже утром.
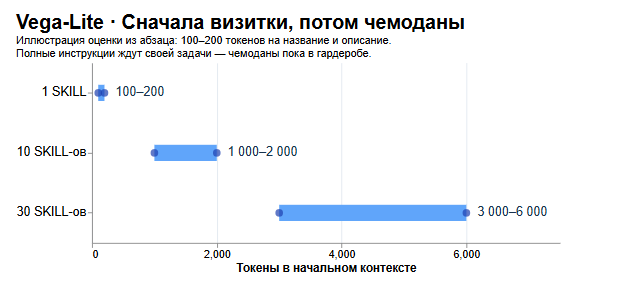
Почему же все‑таки SKILL‑ы полезны и нужны? Ну, во‑первых, по сравнению с MCP SKILL‑ы не раздувают контекст: каждый подключенный SKILL добавляет не десятки тысяч токенов, а 1–2 сотни. Так как в контекст сначала попадают только название и описание SKILL‑а, можно безболезненно добавить 30 своих SKILL‑ов без особых последствий. Когда потребуется использовать SKILL, LLM‑агент сам подтянет его описание, если поймет из контекста задачи, что это нужно, или пользователь сам скажет ему использовать такой SKILL для работы.
Во‑вторых, LLM‑модели обучаются на самых популярных и известных вещах. Например, всем очевидно, что LLM без проблем может работать с Git или писать программу на Python. Но если вы сами разработали программу или для работы вам нужно пользоваться малоизвестной тулзой или технологией, SKILL тут просто незаменим. Вам достаточно создать файл SKILL.md и описать в нем, как работать с этой программой или технологией. Таким образом, вы облегчаете жизнь LLM: при выполнении ваших задач ей не придется искать в интернете документацию и лазить по сайтам, чтобы понять, как этим пользоваться. А уж тем более, если в интернете ничего нет, потому что ваша программа закрыта для публичного доступа.
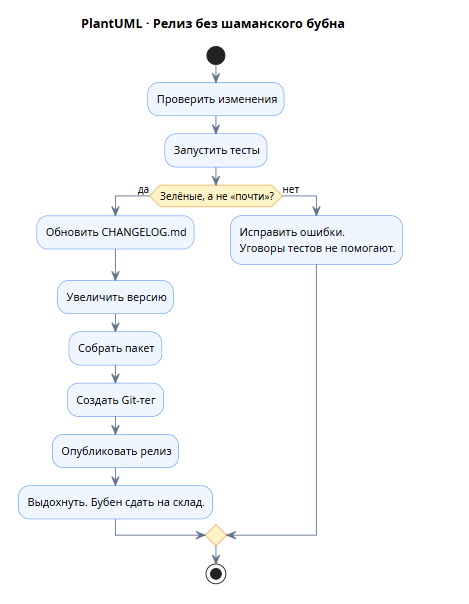
В‑третьих, LLM‑модель обычно не знает, как у вас устроен процесс разработки. Например, агент умеет пользоваться Git, запускать тесты, собирать проект и создавать релизы. Обучать его этому не нужно. Но он не знает, как именно в вашей компании принято выпускать релизы. Skill может описывать последовательность действий: проверить изменения, запустить тесты, обновить CHANGELOG.md, увеличить версию, собрать пакет, создать Git‑тег и опубликовать релиз. То есть Skill помогает освоить не технологию, а конкретный бизнес‑процесс.
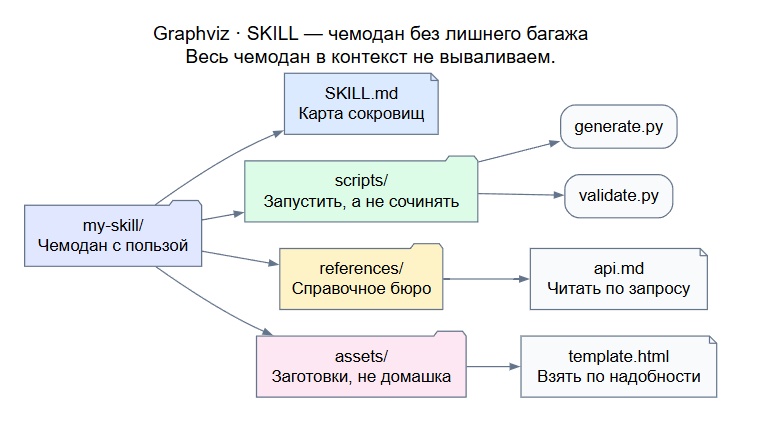
В‑четвертых, SKILL представляет собой не просто инструкцию, а целый набор инструментов. Помимо SKILL.md, в него можно положить готовые скрипты, документацию, шаблоны и другие файлы. И самое интересное: все эти файлы не загружаются в контекст автоматически. Агент читает их только по необходимости, а готовые скрипты может просто запускать, не тратя токены на генерацию кода. Таким образом, SKILL позволяет объединить инструкции, документацию и исполняемый код в один пакет, не раздувая контекст LLM. Например, структура может выглядеть так:
my-skill/
├── SKILL.md
├── scripts/
│   ├── generate.py
│   └── validate.py
├── references/
│   └── api.md
└── assets/
    └── template.html
Самое забавное: SKILL‑ы я заценил именно тогда, когда написал свою программу blueprint4llm. Идея ее создания возникла после того, как я попросил LLM‑агента сгенерировать файл plan.md с описанием задачи. Обычно он выдает большую портянку текста, которую медленно и тоскливо приходится читать. Мне захотелось сократить текст и добавить больше блок‑схем, таблиц, диаграмм и прототипов пользовательских интерфейсов. Как известно, в файлах.md (Markdown) из средств визуализации доступны только таблицы и диаграммы Mermaid. В них нет чартов, графиков, гистограмм, полноценных UML‑диаграмм и прототипов UI. В итоге с помощью blueprint4llm я добавил в.md поддержку таких форматов, как PlantUML, draw.io, Pencil, Balsamiq, Graphviz, Figma, OpenAPI, Excalidraw, Vega‑Lite, ECharts и D2.
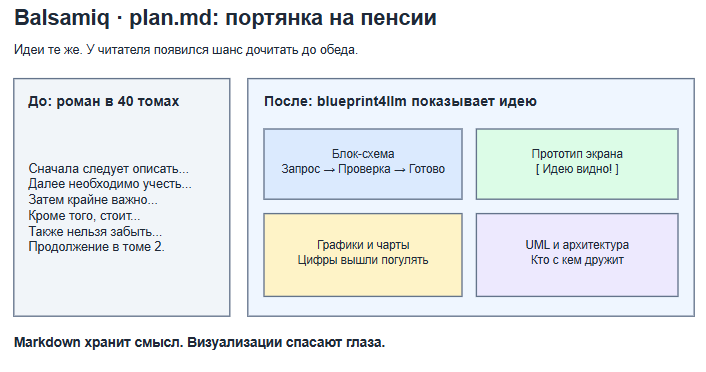
Подключив SKILL blueprint4llm, вы будете получать plan.md не в виде километрового текста, а в виде блок‑схем, прототипов, графиков и так далее. Кстати, blueprint4llm необязательно использовать только для создания plan.md. Например, я использовал этот SKILL, чтобы добавить по иллюстрации к каждому абзацу статьи и сделать ее веселее для чтения. Этот SKILL также удобно использовать, когда вы поручаете агенту собрать полное досье о какой‑либо компании, технологии или человеке и просите оформить итоговый файл result.md с помощью blueprint4llm. Его потом можно конвертировать в HTML или PDF, а можно попросить агента сразу показать его в браузере с графиками.
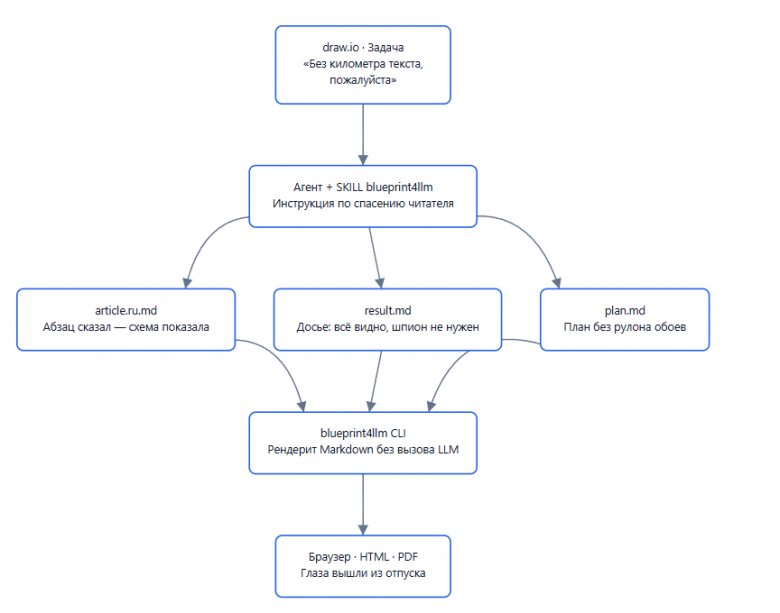
Вот так можно установить SKILL blueprint4llm.
# Codex
npx skills add evgenyigumnov/blueprint4llm --skill blueprint4llm --agent codex

# Claude Code
npx skills add evgenyigumnov/blueprint4llm --skill blueprint4llm --agent claude-code
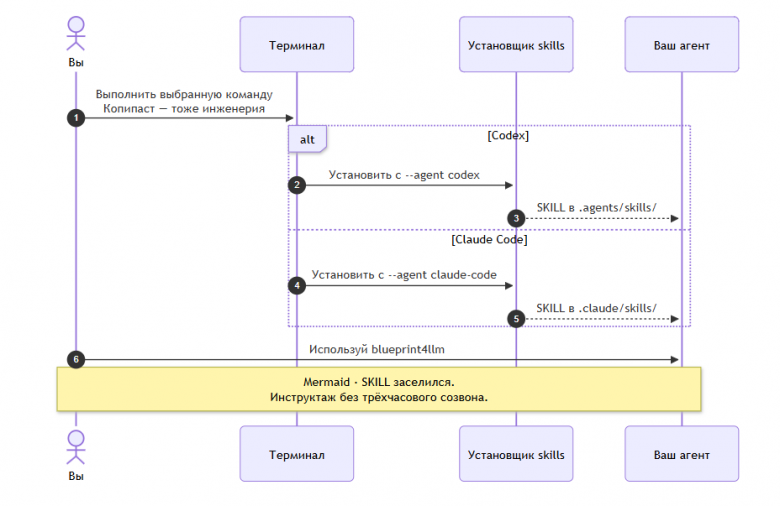
Если вам интересно посмотреть исходный код blueprint4llm, тулзы, которая генерирует всю эту красоту, или прислать пулл‑реквест, велком: https://github.com/evgenyigumnov/blueprint4llm
Комментарии (13)

riky
24.10.2026 16:46Не использую скиллы. Обычно в проекте есть куча документов (составленные им самим же). Агент когда начинает работать над задачей, делает поиск по проекту и натыкается на нужные документы. Там же есть правила использования скриптов, если надо.

Dimon_RB
24.10.2026 16:46Тоже самое у меня как то прижилось вести базу знаний проекта , документации по фичам , доки после их рефакторинга, планы для этих фичей , основные файлы типо vision.md , архитектуры , основных комманд или скриптов(зависимости от проектов). Но а так раньше юзал от карпатого скилл (но переделанный под меня , но как то не прижилось

igumnov Автор
24.10.2026 16:46По сути, у вас уже есть свои скиллы, просто без SKILL.md Разница скорее в стандартизации. Агенту не нужно каждый раз искать по проекту нужную документацию и разбираться, какой скрипт для чего предназначен. Он видит описание доступных скиллов и подключает нужный по ситуации. Плюс один и тот же скилл можно переиспользовать между разными проектами и агентами. А если всё работает в рамках одного проекта и документация хорошо организована, то ваш подход вполне рабочий.

rumataestor
24.10.2026 16:46Забавно получилось. Десятилетиями разработчики не хотели писать документацию, потому что её всё равно никто не читает. Теперь пишем SKILL.md, чтобы её хотя бы нейросеть прочитала. Прогресс!
igumnov Автор
24.10.2026 16:46Эволюция документации: сначала писали для людей, потом перестали, потому что никто не читает. Теперь снова пишем, потому что нейросети наконец-то начали читать. Но есть нюанс: SKILL это не просто документация, а ещё готовые скрипты, инструменты и инструкции, которые агент подтягивает по необходимости.


notwithstanding
24.10.2026 16:46Преамбула: я не понимал, зачем нужны SKILL‑ы для LLM‑агентов.
Фабула: все‑таки SKILL‑ы полезны и нужны. Во-первых, во-вторых, в-третьих, в-четвёртых. Самое забавное: SKILL‑ы я заценил именно тогда, когда...
Вы забыли подключить SKILL‑ы, которые удержат повествование связным и не разорвут его посередине payload-ом.
becefi
Трата токенов - обшибочное представление о скиллах. Скилл в контексте занимает 1 строку: название и краткое назначение. Модель при необходимости сама подтягивает полный текст скилла вызовом get_skill.
igumnov Автор
Я вроде в итоге написал то же самое. :)
dky
С MCP так нельзя?
igumnov Автор
Можно, если MCP-сервер поддерживает динамическую загрузку инструментов. Но обычный MCP сразу передаёт модели описания всех доступных инструментов…
becefi
если точнее, MCP сервер передает схему инструментов обвязке, когда обвязка его инициализирует. А обвязка уже предоставляет схему модели. Обвязка обычно передает ее целиком, но может как-то пытаться ее сократить.