

Когда создаешь техническую документацию в Word, периодически проходишь и отрицание, и гнев, и торг, и все остальные этапы принятия. Сначала надеешься, что функции мы менять не будем или обойдется минимумом правок. А понимая, что правки все‑таки будут и вносить изменения нужно в десяток файлов, хочешь сжечь рабочее место.
Но проблема не в Word. Как инструмент, он неплохо справляется со своими задачами — помогает оформлять документы. Только вот строить вокруг этого написание именно документации не стоит. Вордовский файл не должен быть «квантом» информации для продуктового описания.
В разработке ПО мы уже прошли путь от редактирования простыней кода к делению их на модули, системам контроля версий и автоматической сборке. В том же направлении давно пора идти и с технической документацией. И этот путь прослеживается. В нем отрасль отталкивается не от конкретных инструментов, а от логики построения работы.
В этой статье вспомню личный опыт и попробую ретроспективно взглянуть на то, как менялся подход к работе с информацией в документации. Разберу три подхода, которые помогают отделить суть от оформления, да и в целом облегчить жизнь технического писателя.
Уровень 1. Стили отдельно
Начну с текстового редактора, типа Word — классического инструмента технического писателя в тот период времени, когда я сама была в этой роли. В договоре с пользователем поставщик, на которого я работала, обязался предоставлять книжечки А5 с инструкцией к ПО в бумажном формате, хоть к тому моменту их уже никто и не читал. Word помогал их готовить, не углубляясь в более специализированные инструменты верстки.
Текстовый процессор уже помог отделить стили. Предположим, сегодня заголовки у нас в два раза крупнее и жирные, а завтра требования изменились и болдом мы больше не выделяем. Нам не придется править весь файл, достаточно будет изменить только стиль. Единообразное оформление — это уже хорошо.
К сожалению, с правками сути документа текстовый процессор справлялся не так хорошо. Имея разные сборки ПО и регулярно меняя отдельные его модули, мы постоянно сталкивались с тем, что после очередного релиза одни и те же изменения надо было вносить в десяток файлов. Даже если просто изменилось название элемента интерфейса, автозамена во всех документах ускоряла поиск вхождения, но не автоматизировала его полностью, поскольку ее корректность приходилось контролировать вручную. Смысл остался привязанным к тексту.
С текстовыми процессорами можно было экспериментировать, чтобы немного облегчить правки в будущем. Например, можно было разбить большой файл — хранить описание каждого модуля в отдельном документе. После очередного релиза исправлять модули и вручную собирать большие документы перед печатью. Получаем возможность редактировать описание каждого модуля отдельно, но все равно много сопутствующей рутины — работа с нумерацией разделов, перекрестными ссылками, оглавлениями, поехавшими при объединении стилями и тому подобное
Уровень 2. Markdown + Git + генерация документов
Текстовый процессор выносит оформление в стили, но те остаются привязанными к конкретным документам. Если случайно поменять стили в одном из файлов, при объединении появится много дополнительной ручной работы. Так что на следующем уровне оформление отделилось от документа полностью, за счет чего появилась возможность собирать большие описания автоматически. Кроме того, по аналогии с разработкой появился контроль версий исходников.
Пример этого подхода — MkDocs. Это опенсорсный инструмент для оформления проектной и технической документации. Проект появился еще в середине 2010-х, сейчас у него больше 27 тыс. звезд на GitHub.
Теперь текстовый исходник хранится в Markdown, где специальными символами выделена структура и основные элементы. Для каждого модуля есть не только текущее описание, но и все его предыдущие версии с пометками, кто и когда поменял данные. В качестве дополнительной опции имеем удобный процесс рецензирования внесенных изменений — таких возможностей у «чистого» текстового процессора не было.
Итоговое «Руководство пользователя» собирается из исходников автоматически. Документация начинает жить примерно по тем же правилам, что и программный код. Это большой шаг вперед.
Но и у этого подхода были недостатки. Автоматическая сборка и Markdown сильно облегчают жизнь технического писателя, но не избавляют его от рутинного исправления названия одного и того же модуля в пяти разных местах (если вдруг бизнес решил его переименовать). Система версионирования помогает отследить изменения, но не понимает, что все пять упоминаний относятся к одной сущности. А Markdown просто это красиво оформит.
Отчасти такой инструментарий напоминает конструктор LEGO. Есть кубики разного размера и цветов (markdown файлы). У каждого из них нет явного назначения, но из них можно собрать стену дома, дверь или кусок поезда. Блоки можно переиспользовать в разных местах, но о своей функции они не содержат никакой информации. Нужно много воображения, чтобы придумать, как сделать из этого, допустим, рулевое управление игрушечного автомобиля.
Я ушла в смежное направление на том этапе, когда организация пыталась перевести ведение документации из Word в один из подобных инструментов. Процесс сильно буксовал, поскольку объем уже созданной документации был гигантским, технические писатели — завалены срочными правками и «описание для печати под очередную большую поставку надо было сделать еще вчера». Как‑то так я и перестала следить за тем, что делается на рынке.
На тот момент мне казалось, что улучшать вроде бы нечего. Но не так давно наткнулась на следующую концепцию — третий уровень развития подхода.
Уровень 3. Информация как объект проекта
Следующий шаг — хранить в качестве исходника не текст как таковой, а структурированную информацию о системе, из которой по понятным правилам можно получить текст.
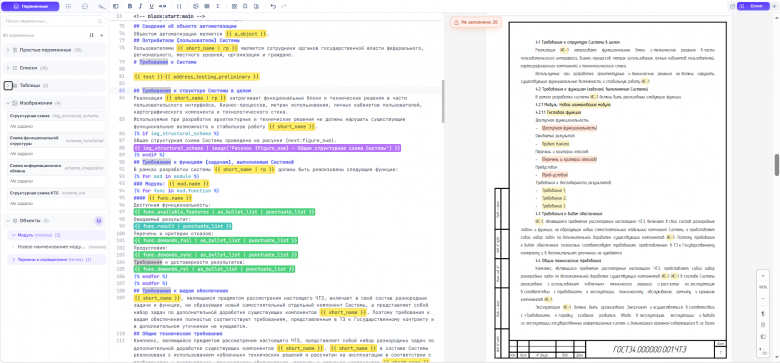
В целом идея, что контент надо разбивать на какие‑то логические блоки, появилась не вчера. Еще пока мы боролись с текстовым процессором в рамках первого подхода, была идея DITA (Darwin Information Typing Architecture) — открытого стандарта «конструктора» для документации. Но оборачиваясь назад, видно, что без конкретного простого инструмента это идея мало где прижилась. На вопрос, можно ли реализовать что‑то структурированное, но не с таким гигантским порогом входа, тогда я ответа не нашла. Но сейчас обнаружила, что отрасль шагнула вперед и похожий подход — структурированная разработка документации с отделением содержания от оформления — реализован, например у ГОСТ‑ОН. Это облачная платформа для разработки технической, проектной и эксплуатационной документации, которая умеет работать с российскими ГОСТами и требованиями Единого реестра российского ПО. Глобально ГОСТ‑ОН использует идею docs‑as‑a-code, но через сервис порог входа в эту концепцию получается существенно ниже.
Сервис использует автоматическую сборку все из того же Markdown, но в комплекте Jinja2. Это шаблонизатор для Python, который позволяет подставлять в текст значения переменных, использовать условия и циклы. Так можно часть содержания документа — названия модулей и функций, версии и тому подобное — задать переменными. Причем, такие переменные могут иметь свои собственные свойства, организованные в определенную иерархию.
Допустим, у нас есть модуль авторизации. Вместо того чтобы хранить его описание одним текстовым блоком, можно представить его как объект с набором характеристик:
Модуль авторизации
  - название
  - версия
  - назначение
  - функции
    --вход в систему
    --смена пароля
    --восстановление пароля
  -скриншоты
    --форма входа
    --восстановление пароля
Отдельно хранится шаблон, который описывает, какие поля надо включить в тот или иной большой документ. Когда нужно сделать Quick start guide, мы включаем в него только описание входа. А если генерируем полное описание, добавляем версию и все, что касается смены и восстановления пароля.
Получаем мы все это из одного источника правды. Если что‑то в модуле вдруг поменялось, правим именно его. Это сложнее, чем простая автозамена. Фактически, данные о системе мы наконец‑то отделили не только от стиля, но и от их текстового представления. На фоне этого версионность никуда не исчезает — все так же можно отследить, кто, что и когда поменял.
В этом подходе мы храним не готовые текстовые блоки для разных документов, а структурированную информацию, из которой можно собрать разные представления одной и той же системы.
В метафоре с конструктором это уже LEGO Technic. Помимо обычных кирпичиков разного цвета и размера можно использовать шестеренки, оси и даже некоторые готовые подвижные механизмы. Детали не просто соединяются друг с другом, а выполняют некую функцию и взаимодействуют по определенным правилам. Возможностей по сборке становится больше — уже не нужно столько воображения и авторской работы, чтобы собрать то же рулевое управление. Функцию как бы задают свойства и связи отдельных деталей. Причем, из одних и тех же деталей можно собрать несколько разных механизмов, каждый из которых будет выполнять свою функцию.
Очевидно, подход сложнее. Мы экономим время на правках, но тратим его на разработку структуры данных и шаблонов — ее изначально надо создать так, чтобы все это можно было расширять и поддерживать (а не стрелять себе в ногу, переписывая раз в полгода с нуля). Это не всегда оправдано — нет смысла впадать в автоматизацию ради автоматизации. Но вполне «окупается», если речь идет о каком‑то сложном и постоянно изменяющемся шаблоне — например, документации сложного продукта по ГОСТ.
И даже самая сложная объектная модель не отменяет работу технического писателя — примеры, объяснения подходов и сложных концепций.
Что в итоге
Честно признаюсь, я не без интереса влезла в идеологию сервиса ГОСТ‑ОН, потому что он отлично дополнил эволюцию подхода. Скорее всего, кто‑то пытался подобное реализовать и ранее, просто эти попытки не попадались мне на глаза. Возможно, есть и другие реализации подхода, заточенные не под ГОСТы, а под другие задачи.
Когда‑то я была техническим писателем на довольно большом проекте. И тогда подобный подход спас бы много нервных клеток. Сервис выглядит интереснее чем бесконечные правки десятка файлов в текстовом процессоре.
Однако подход ГОСТ‑ОН я бы не стала называть единственным правильным. Для его внедрения нужно разрабатывать модель данных, настраивать шаблонизатор. Это чуть сложнее. Конечно, при большом количестве взаимосвязанных документов (при наличии готовых шаблонов для типовых задач, как это есть у ГОСТ‑ОН) затраты на настройку окупятся. А вот если мы пишем простые правила к пасьянсу «Косынка», которые не меняются десятилетиями, предыдущие подходы будут выгоднее. Да даже текстовый процессор в таком случае будет оправдан! Важно понимать, в какой момент он перестает справляться.
Комментарии (16)

runaway
16.11.2026 14:59Описанная логика чем-то напоминает подход Eplan к проектированию электрических схем. В нём тоже каждое свойство, каждая логическая единица живёт отдельно, а условная клемма получается как набор этих свойств: артикул, производитель, цена, количество контактов, тип напряжения на каждом контакте, наличие перемычки, количество уровней, цвет корпуса и т. д., миллион полей. В итоге изначально здравый и логичный подход превращается в ад поддержки и контроля связей.

Smolensk
16.11.2026 14:59
Всем крышка! Проектировщики всея Руси (с Днём проектировщика, кстати!) «продолжают есть кактус» оформления результата свого труда в рукотворный чертёж. Совершенно неообъяснимый самовопроизводящийся скевоморфизм. ГОСТы уже лет 20 как позволяют обходится титульником вместо штампа, колонтитулами вместо рамок и arialами вместо псевдорукописных шрифтов. Идёт время, рождаются GUI, смартфоны, ретины, мимо бегут Lispы, Ruby, Pythonы и вся отрасль первым делом отчаянно впихивает каждую технологию в рамки из мира кульмана, который большинству уже ни разу и не встречался! Теперь вот ИИ заставляют это делать… Очнитесь, коллеги! Вы следующие на очереди, чьи разделы проектной документации он полностью заберёт и рамками этими не подавится. Постесняйтесь AGI, что он обо всех нас подумает, глядя на эти скриншоты 2026 года? «Ну тупыыые!..» ©

NikitaOsokin_ON
16.11.2026 14:59И вас с праздником!) Можем дать потестировать наш MCP-сервер ГОСТ-ОН. С ним и AGI и даже SI ждать не нужно)

Dhwtj
16.11.2026 14:59Лет 20 назад Rational умела собирать документацию.
Получалось говнище.
Но тогда документацию хотя бы читали. Сейчас никто много читать не будет

black_warlock_iv
16.11.2026 14:59Когда создаешь техническую документацию в Word
… то надо остановится и понять что и где пошло не так.
NikitaOsokin_ON
16.11.2026 14:59На последней TechWritersDays приводили результаты опросов используемых инструментов. 70% тех.писателей до сих пор частично или полностью задействуют Word или аналоги


ZorkyK
16.11.2026 14:59Недальновидно такой сервис, в общем-то неплохой, располагать в облаке. По ГОСТ-19 и ГОСТ-34 пишут документацию для продукции госзаказа и тем более гособоронзаказа. Ни одна компания-подрядчик не разрешит своим техписам пользоваться облачным сервисом для создания документации с красивыми рамочками. Это же коммерческая тайна. Если бы разработчики сделали десктопное приложение или по крайней мере on-premise решение - тогда другое дело. Это первое пожелание.
Второе пожелание. Было бы хорошо, чтобы этот сервис мог генерить пакет документов по разрабатываемой системе. То есть, в проекте такого софта должно быть пространство для метаданных, из которых генерится заказываемый набор документов по проекту, который будет называться конструкторской и эксплуатационной документацией. Перечень и структура документов по умолчанию берется из ГОСТов, но позволяется настраивать пользователю.
NikitaOsokin_ON
16.11.2026 14:59Все так. Серверная версия у ГОСТ-ОН есть) там и возможность закрытого контура без доступа в большой Интерне реализована.
Идея преобразовывать проектные решения в документы - это прям топ, к этому идем постепенно. На прошлой неделе сделали накаты, чтобы можно было формировать описание базы данных на основе выгрузки в формате DDL из DBeaver или аналогов. Еще кейс это описание API в JSОN/YAML. Сейчас еще экспериментируем с выгрузками из ArchiMate и Camunda.
Но тут тоже пока неоднозначно, надо ли делать прямую интеграцию, или достаточно все преобразовывать через MCP-сервер, который у нас как раз для On-premise решения действует.
P.S.
можно работать не только с ИТ-документами, есть шаблоны и по ГОСТ 2,3, 21, сейчас ставим эксперименты по разработке генеральных планов муниципальных образований.

kia_stc
16.11.2026 14:59Если хочется чего-то этакого, то вот есть такой интересный проект https://typst-gost.ru/
Шаблон под ГОСТ для Typst

itGuevara
16.11.2026 14:59Хорошо бы добавить семантику и онтологию. Как стартовый вариант (формализация задачи): Несемантические wiki с использованием онтологии.
Или что-то типа семантической разметки MD-LD. Понятно, что потом и "граф знаний" и т.п. Что-то типа "Obsidian с семантикой" - для ведения документации. Есть примеры таких семантических систем документирования (ведения документации)? Или может быть "проектные онтологии"? Связано.
NikitaOsokin_ON
16.11.2026 14:59Вкратце, ГОСТ-ОН это уже поддерживает. Можно взять шаблонную семантику из типового проекта по ГОСТ 19/34 или сделать свою кастомную с нуля. Все храним в JSON

dobrobobrrobot
Прекрасная реклама прекрасного сервиса ГОСТ-ОН
Сервис ГОСТ-ОН мне очень понравился
Не вижу причин, почему все еще не перешли на ГОСТ-ОН
(где получить мои копейки?)