

С чего всё началось?
Я работаю в аналитическом отделе крупной компании. Через отдел каждый день проходят сотни строк: заявки, сроки, контрагенты, закупки, начисления, реестры и даже претензии от бухгалтерии. Всё это надо свести, проверить, подтянуть, посчитать.
Главный инструмент отдела — Excel. Помимо самой аналитики я занимался приложениями для него: автоматические сводные, ВПР‑подтягивания, условные агрегаты (суммесли), подсчёт дней между событиями. Рутинная автоматизация, которая экономила отделу часы. Инструмент был один — VBA и сложные формулы в Excel.
Почему VBA, а не Python?
IT‑отдел, который занимался в основном защитой данных, категорически отказывал мне в установке Python и любых других языков. Я даже просил сделать отдельный эмулятор, где я бы писал приложения, а потом раздавал по отделам exe‑файлы. Но был тотальный запрет на всё: нельзя вставить флешку, запустить посторонний exe, выйти на какой‑то сайт, кроме белого списка. Полностью связанные руки. Работал только VBA — он и спасал.
А потом наш отдел перевели на Linux
Начался ужас. Макросы не работали. Excel‑подобные программы на Linux оказались совсем не тем, чего ждёшь. Google Таблицами пользоваться было нельзя: во‑первых, они не открывались, во‑вторых, я не мог отправлять информацию в облако. Вся работа за 1,5 года — коту под хвост. Наш отдел вернулся в прошлый век, и подготовка отчётов опять стала ручной работой.
Скажу честно: если бы не этот переезд на Linux, я бы не променял Excel и VBA на что‑то другое. Для меня Excel — это язык программирования номер один. Не «табличный редактор», а именно язык: со своей моделью данных, конструкциями и очень простой логикой. VBA поверх него — прямой инструмент, который делает то, что нужно. Excel и VBA остались бы в приоритете, если бы не новые реалии.
И тут появилась идея писать на JavaScript — языке, который по умолчанию есть на всех ПК. Но для меня это сложный язык: я без проблем напишу код на Python или на Delphi, а вот на JS возникают сложности. Первые приложения шли тяжело, но я потихоньку погружался в язык, учился на примерах, где‑то подсказывал ИИ.
В итоге пришла идея не писать километровые строки, а сделать небольшой скриптовый язык для обработки данных на основе JS.
Так я сделал для облегчения своего труда лёгкий браузерный язык, который под капотом превращал каждую функцию в полноценный код JS.
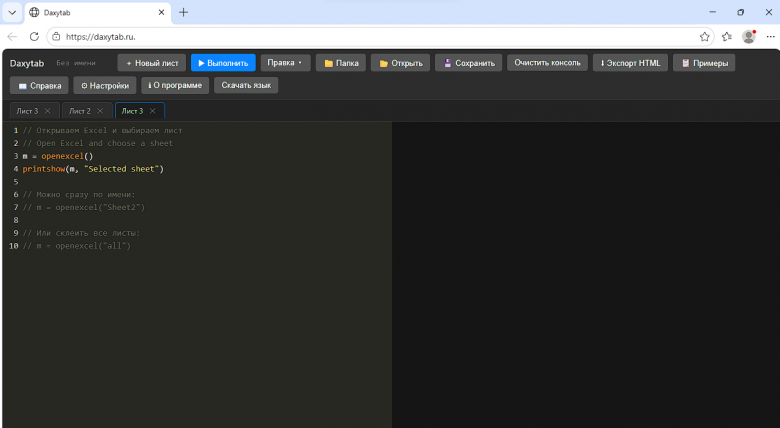
Так появился Daxytab. Он не замена Excel по идейным соображениям, а адаптация к обстоятельствам: к Linux, к запрету Python, к корпоративным ограничениям. Я адаптировал привычный способ думать о таблицах к новой среде, а не придумывал что‑то принципиально новое.
Теперь вы пишете код обработки таблицы, сохраняете скрипт, экспортируете его в автономный HTML‑файл. После экспорта код обрабатывает таблицу сам — без интернета и редактора. В файл попадают только те функции, которые вы использовали в коде.
По сути, это VBA для веба — но не замена Excel, а адаптация к обстоятельствам: только проще, а вместо макросов несколько строк функций.
И главное: язык работает даже на телефоне. Редактор открывается в любой ОС и мобильном браузере, код можно писать и запускать прямо с экрана смартфона.
Что взято за основу?
Работа с таблицами — вдохновлено pandas и Excel. Когда я проектировал работу с таблицами, я ориентировался на два источника.
Первый — pandas, библиотека Python. Она даёт программисту прямой и предсказуемый доступ к данным: явные столбцы, срезы, агрегаты, группировки. Именно pandas я считаю образцом того, как должна выглядеть работа с таблицами в языке программирования. Python у меня был до запрета, и pandas я знал по прошлому опыту. Именно его модель работы с таблицами я держал в голове, когда проектировал Daxytab, — хотя использовать сам Python на работе уже не мог.
Второй — сам Excel. И это даже важнее. Excel — это язык программирования номер один в мире, если смотреть на то, как люди реально работают с данными. Миллионы людей каждый день пишут в ячейках формулы, строят сводные, тянут ВПР — и не считают это программированием, хотя по сути это именно оно. VBA поверх Excel — уже полноценный язык, и я много лет на нём писал. В Daxytab я сознательно сохранил привычные понятия: ВПР, суммесли, условные агрегаты, фильтрация по столбцу. Человек, который знает Excel, должен узнать эти конструкции с первого взгляда.
В Daxytab обращение к столбцу почти как в pandas, только для удобства счёт начинается с 1, а не с 0. Строка 1 — это заголовок, строка 2 — первая строка данных.
t[:, «Отдел»] — по названию столбца (берутся только строки данных, заголовок в выборку не попадает)
t[:, 2] — по номеру столбца (берутся все строки включая заголовок)
t[2,:] — по номеру строки
t[2, 3] — одна ячейка
t[end, 1] — последняя строка
t[1, end] — последний столбец
t[end, end] — самая последняя ячейка в таблице
t[last 2,:] — последние две строки данных (без заголовка) t[:, last 3] — последние 3 столбца t[3:10, 2] — диапазон строк с 3 до 10 во 2 столбце
end подставляется по контексту: в позиции строки — номер последней строки, в позиции столбца — номер последнего столбца. last N тоже считается по строкам данных: для таблицы ниже t[last 2,:] вернёт Петрова и Сидорова, без шапки.
t = [“Сотрудник”, “Отдел”;
      “Иванов”,  “IT”;
      “Петров”,  “Финансы”;
      “Сидоров”, “IT”]

print(t[last 2, :])

Вывод:
Петров   Финансы Сидоров  IT
Фильтрация
Возьмём выдуманную таблицу — список сотрудников с отделами и зарплатами:
t = [“Сотрудник”, “Отдел”, “Зарплата”;
     “Иванов”,  “IT”,     120000;
     “Петров”,  “Финансы”, 90000;
     “Сидоров”, “IT”,      135000;
     “Кузнецов”,“Финансы”, 95000;
     “Смирнов”, “IT”,      110000]

r = filterif(t[:, “Отдел”] == “IT”) print(r)

Вывод:
Сотрудник  Отдел  Зарплата
Иванов     IT       120000
Сидоров    IT       135000
Смирнов    IT       110000

Сложные условия:
r = filterif(t[:, “Отдел”] == “IT” and t[:, “Зарплата”] > 120000) print®

Вывод:
Сотрудник  Отдел  Зарплата
Сидоров    IT       135000
Условия комбинируются через and, or, not; поддерживаются ==,!=, >, <, >=, <=. filterif оставляет только строки, подходящие под условие. Есть парный deleteif — он, наоборот, удаляет подходящие строки.
Мутация таблицы
Принцип простой. Если нужно создать ячейку за пределами таблицы, end — это последняя строка или столбец. Пишу end+2 и по строке, и по столбцу:
t[end+2, end+2] = 0
Язык не выдаст ошибку, а расширит таблицу до указанного диапазона: было 6×3, станет 8×5 — добавятся две строки и два столбца. Получится:
Сотрудник  Отдел    Зарплата  None  None
Иванов     IT         120000  None  None
Петров     Финансы     90000  None  None
Сидоров    IT         135000  None  None
Кузнецов   Финансы     95000  None  None
Смирнов    IT         110000  None  None
None       None         None  None  None
None       None         None  None     0
Для реальных выгрузок, где данные начинаются не со второй строки и заканчиваются не там, где ожидаешь, это удобнее, чем каждый раз пересобирать таблицу.
Почему не голый JavaScript?
Вот как выглядит та же фильтрация — по одному условию, как в первом примере выше, — на чистом JavaScript:
const t = [
  ["Сотрудник", "Отдел", "Зарплата"],
  ["Иванов",   "IT",      120000],
  ["Петров",   "Финансы",  90000],
  ["Сидоров",  "IT",      135000],
  ["Кузнецов", "Финансы",  95000],
  ["Смирнов",  "IT",      110000]
];

const header = t[0];
const idxDept = header.indexOf("Отдел");

const result = t.filter((row, i) => {
  if (i === 0) return false;
  return row[idxDept] === "IT";
});

const output = [header, ...result];
console.log(output);
На Daxytab та же задача — одна строка filterif(t[:, «Отдел»] == «IT») вместо более 10. Именно поэтому я перестал писать многокилометровые конструкции на JavaScript там, где можно обойтись одной строкой.
Можно указывать диапазоны: filterif(t[3:end, «Отдел»] == «IT»)
Строка 1 — заголовок, поэтому t[3:end, «Отдел»] начнётся с Петрова, то есть со 3 строки данных. Если нужна первая строка данных — t[:,2], используем двоеточие или (t[1:end,2] и столбец цифрой.
Это критично, потому что данные в реальных выгрузках редко начинаются со второй строки. Бывает, первые пять строк — шапка отчёта, следующие три — многоэтажные заголовки, и только потом идут данные. Или наоборот: данные с 10-й строки, а выше служебная информация. Например Синтаксис t[10:end, «Отдел»] позволяет сказать: «фильтруй по столбцу „Отдел“, но только с 10-й строки и до конца».
В аналитике это ежедневная реальность: выгрузки из разных систем устроены по‑разному, и жёсткое «данные всегда со второй строки» ломается на первом же отчёте.
Второй пример — ВПР (vlookup):
t = ["Сотрудник", "Отдел";
     "Иванов",  "IT";
     "Петров",  "Финансы";
     "Сидоров", "IT"]

depts = ["Отдел",    "Руководитель";
         "IT",       "Смирнов";
         "Финансы",  "Кузнецов"]

t[:, "Руководитель"] = vlookup(t[:, "Отдел"], depts[:, "Отдел"], depts[:, "Руководитель"])
print(t)

Вывод:
Сотрудник  Отдел    Руководитель
Иванов     IT       Смирнов
Петров     Финансы  Кузнецов
Сидоров    IT       Смирнов
Порядок аргументов — что искать, где искать, что вернуть. Ровно как в Excel, только без ИСТИНА/ЛОЖЬ в конце. С этой функции всё и начиналось.
Управляющие конструкции и циклы
Со временем выяснилось, что языку тесно в рамках «одна операция над таблицей». Задачи, где нужно пройтись по строкам, проверить условие, что‑то посчитать и записать в новую таблицу, требуют ветвлений и повторяющихся действий. Всё это уже не укладывается в одну строку filterif.
Поэтому в языке постепенно появились управляющие конструкции и циклы — if / else, while, for с параметрами to и step, а также break. Блоки, как и положено, выделяются фигурными скобками — без питоновских отступов и без экзотики:
t = ["Сотрудник", "Отдел", "Зарплата";
     "Иванов",  "IT",     120000;
     "Петров",  "Финансы", 90000;
     "Сидоров", "IT",      135000;
     "Кузнецов","Финансы", 95000;
     "Смирнов", "IT",      110000]

for i = 2 to lenrow(t) {
    if t[i, "Зарплата"] > 120000 {
        t[i, "Категория"] = "высокая"
    } else {
        t[i, "Категория"] = "обычная"
    }
}
print(t)

Вывод:
Сотрудник  Отдел    Зарплата  Категория
Иванов     IT         120000  обычная
Петров     Финансы     90000  обычная
Сидоров    IT         135000  высокая
Кузнецов   Финансы     95000  обычная
Смирнов    IT         110000  обычная
Теперь на Daxytab можно писать не только «одна операция над таблицей», но и полноценные сценарии: пройтись по строкам, проверить условие, что‑то посчитать, что‑то записать в новую таблицу. Синтаксис остался читаемым, а фигурные скобки делают границы блоков явными — не надо гадать, где заканчивается if.
Сейчас в языке несколько десятков функций:
Фильтрация и удаление по условию
Сортировка, дедупликация и ВПР
Вставка, копирование, перемещение, прямое удаление
Группировки и сводные таблицы
Объединение таблиц
Поиск (в т.ч. внутри ячейки) и размер
Агрегаты (в т.ч. условные) и статистика
Функции для работы внутри ячейки или текста, типы и даты
Оконные функции
Форматы данных — основная это excel, но есть поддержка csv, txt, parquet, sqlite
Вывод и UI
Примеры и доступность
На сайте есть примеры кода. Их можно скопировать и прогнать прямо на сайте, в редакторе, без установки. А можно скачать себе на компьютер или на телефон: если предприятие запрещает интернет как у нас, автономный HTML‑файл открывается локально и работает без сети.
Жду критики и предложений
Отдельно скажу: я жду замечаний по синтаксису. Если какая‑то конструкция кажется неудобной, противоречивой или просто странной — напишите.
Сразу скажу: это не реклама. Язык абсолютно бесплатный. Я не продаю подписки, не прячу функции за пейволом и не планирую. Я сделал его потому, что мне самому нужно было чем‑то работать после переезда на Linux.
Ссылка на язык: http://daxytab.ru/
Если он поможет ещё кому‑то, кто так же застрял между Excel, Linux и корпоративными запретами, — буду искренне рад. Именно для этого он и выложен.