

В сентябре появились новые, более мощные модели: Claude Fable 5.1, GPT-6 Astra, Gemini 3.8 Flash. Однако использовать эти модели становится всё сложнее — из-за сокращающихся лимитов подписок, роста стоимости (уже есть подписка по 500 долларов в месяц!) и внезапных блокировок аккаунтов.
Альтернатива — открытые модели, которые можно развернуть на своем оборудовании или арендованном сервере. Для части из них достаточно обычной RTX с 8–12 ГБ видеопамяти; для более крупных нужна будет уже GPU с 24–32 ГБ. Мы выбрали несколько таких моделей, включая новинки последних месяцев, чтобы разобрать, на что они способны и какие задачи могут решать.
DeepSeek: новая V4.1 Flash и более доступные версии R1-Distill
В сентябре DeepSeek представила V4.1 Flash — мультимодальную MoE-модель, которая работает с текстом и изображениями и поддерживает контекст до 1 млн токенов. В основе — 552 млрд параметров, при этом при обработке запроса используется только часть из них: 8 млрд на этапе чтения входных данных и 16 млрд при генерации ответа.
Для локального запуска на более доступном железе у DeepSeek есть другое семейство — R1-Distill. Это отдельные модели на базе Qwen2.5 и Llama 3, дообученные на данных, сгенерированных DeepSeek-R1. Компания выпустила версии на 1,5, 7, 8, 14, 32 и 70 млрд параметров; для диапазона 8–32 ГБ VRAM интереснее всего модели от 7B до 32B.
С квантованием требования к памяти становятся заметно ниже. Например, в формате Q4_K_M:
DeepSeek-R1-Distill-Llama-8B — 4,92 ГБ
DeepSeek-R1-Distill-Qwen-14B — 8,99 ГБ
DeepSeek-R1-Distill-Qwen-32B — 19,85 ГБ
Это только размер весов: дополнительная память потребуется под KV-кэш, контекст и сам движок инференса. Поэтому 8B можно запускать на RTX с 8 ГБ памяти, для 14B разумно ориентироваться минимум на 12 ГБ, а 32B — уже на 24–32 ГБ.
С ростом модели растет и качество. В официальных тестах DeepSeek результаты версий Qwen-7B, Qwen-14B и Qwen-32B выглядят так:
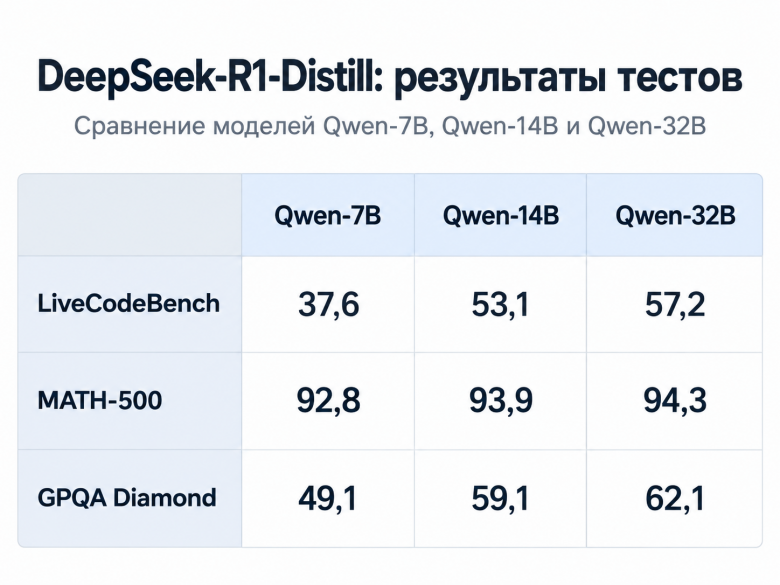
Для бизнеса выбор зависит от нагрузки и доступного железа. Версии на 7–8B подойдут для локальных помощников, обработки текста и несложного кода. 14B заметно сильнее в программировании и рассуждениях, но все еще помещается на одной потребительской видеокарте. 32B уже требует 24–32 ГБ памяти, зато лучше подходит для более сложного анализа и генерации кода.
Новая V4.1 Flash показывает верхний уровень семейства DeepSeek, но для одной RTX или одного облачного GPU из нашего диапазона она слишком велика. Для локального использования практичнее R1-Distill: можно подобрать размер модели под доступную видеопамять и запускать ее без обращения к внешнему API.
Qwen3.8-27B: универсальная модель для сложных рабочих задач
Если для запуска DeepSeek на одной видеокарте приходится выбирать компактные R1-Distill, то Qwen3.8-27B можно использовать целиком. Это модель на 27 млрд параметров, которая при подходящем квантовании помещается в 24 ГБ памяти.
Qwen3.8-27B распространяется под Apache 2.0 и изначально работает с текстом, изображениями и видео. Разработчики ориентируют ее на программирование, профессиональные задачи, исследования и длительные агентные сценарии. Нативный контекст составляет 262 144 токена, с возможностью расширения до 1 млн токенов.
В тестах разработчиков модель показывает высокие результаты в задачах, близких к рабочим:
Тест |
Что проверяет |
Результат |
SWE-bench Pro |
Решение задач по реальным программным репозиториям |
61,7 |
CoWorkBench |
Длительные рабочие задачи в программировании, финансах, праве и других областях |
70,7 |
OSWorld-Verified |
Работа с приложениями через интерфейс компьютера |
84,3 |
OmniDocBench 1.5 |
Анализ и понимание документов |
91,1 |
SWE-bench Pro и CoWorkBench особенно показательны для корпоративного применения: первый оценивает работу с реальным кодом, второй — способность выполнять длинные многошаговые задачи. OSWorld дополняет их проверкой работы с интерфейсами, а OmniDocBench — документами.
В независимом тесте на RTX 3090 с 24 ГБ VRAM скорость генерации составляла около 75 токенов/с при контексте порядка тысячи токенов и снижалась примерно до 43 токенов/с при заполнении контекста до 90 тыс токенов.
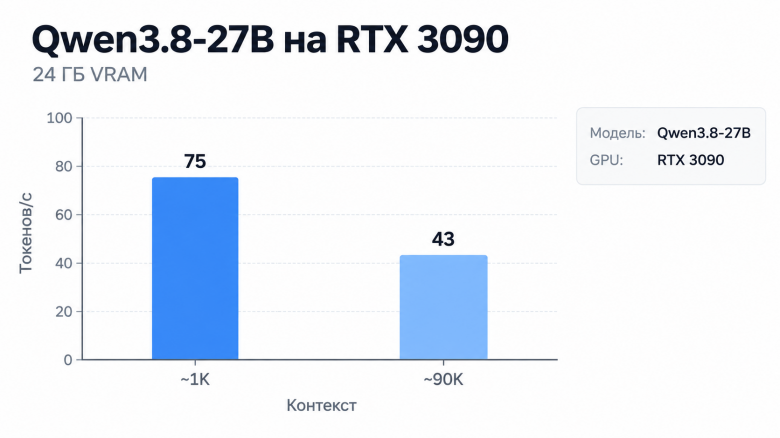
Конкретные цифры зависят от квантования, движка инференса и его настроек, но сама зависимость закономерна: чем больше контекст, тем больше памяти занимает KV-кэш и тем тяжелее становится обработка запроса
На практике 24 ГБ VRAM позволяют использовать Qwen3.8-27B для программирования, анализа документов, корпоративных помощников и агентных задач. Но запас памяти здесь уже важен: длинный контекст оставляет меньше места под KV-кэш, а несколько одновременных запросов быстро увеличивают потребление ресурсов. На GPU с 32 ГБ или больше, будет комфортнее, если есть такая возможность. Но в статье рассматриваем задачу, как "упихать" модели в более доступные карты, как для своей инфраструктуры, так и для аренды.
Qwen3.8-27B дает заметно больше возможностей, чем компактные модели на 7–14 млрд параметров, но и поднимает нижнюю планку по железу примерно до 24 ГБ. Если нужно уложиться в 12–16 ГБ, придется выбирать более компактные модели.
В mClouds доступны к аренде серверы с видеокартами NVIDIA L4 24GB, NVIDIA L40S 48GB, RTX 6000 PRO 96GB.
Qwen3.8-27B требует около 24 ГБ видеопамяти — Gemma 4 12B-it снижает порог входа до 16 ГБ VRAM или объединенной памяти, при этом остается мультимодальной. Google выпустила ее именно как модель для локального запуска на пользовательском железе. В официальном руководстве Google отдельно указана возможность работы на ноутбуках с дискретной GPU и 16 ГБ памяти.
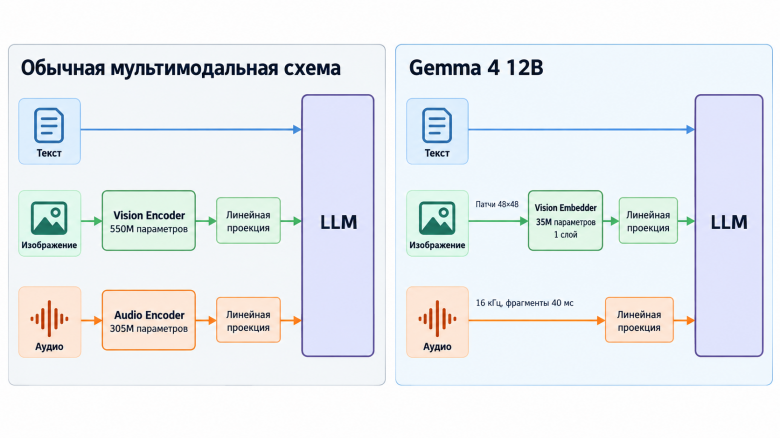
Основные сценарии у модели такие:
текст и документы — ответы на вопросы, суммаризация, RAG;
изображения и видео — анализ визуального содержимого вместе с текстовым запросом;
аудио — распознавание речи и работа со звуковыми данными;
код и агенты — программирование и многошаговые сценарии с внешними инструментами.
Для локального инференса поддерживаются распространенные инструменты вроде llama.cpp, vLLM, SGLang и Transformers. Также модель можно поднять как OpenAI-совместимый локальный API.
С семейством Gemma мы уже работали сами. В августе тестировали Gemma 4 E4B и Qwen3.5-9B в локальной RAG-системе на NVIDIA L4 с 24 ГБ VRAM. Стек состоял из vLLM и Open WebUI, а модели отвечали на русскоязычные вопросы по подключенной базе знаний.
Результаты выглядели так:
Модель в тесте mClouds |
Скорость генерации |
Размер модели в VRAM |
Gemma 4 E4B |
~45 токенов/с |
16 ГБ |
Qwen3.5-9B |
~28 токенов/с |
19,3 ГБ |
В этом тесте Gemma отвечала короче и точнее придерживалась вопроса, а Qwen чаще добавляла дополнительные детали. При небольших базах документов Gemma оказалась быстрее, тогда как Qwen лучше подходила для более объемных и связанных наборов данных.
На фоне Qwen3.8-27B у Gemma другой профиль: меньше требований к памяти, но при этом есть работа с текстом, изображениями и аудио. Поэтому она интересна для локальных ассистентов, RAG и сервисов, где одной текстовой модели уже недостаточно.
gpt-oss-20B: открытая модель OpenAI для своей инфраструктуры
Gemma 4 12B интересна прежде всего мультимодальностью. А вот gpt-oss-20b решает другую задачу: это текстовая модель с упором на рассуждения, программирование и работу с инструментами, которую OpenAI разрешает развернуть на своей инфраструктуре. Она не входит в ChatGPT и не предоставляется через OpenAI API — веса можно скачать и использовать самостоятельно.
В gpt-oss-20b используется архитектура MoE: всего в модели 20,9 млрд параметров, но при обработке каждого токена задействуется около 3,6 млрд. Это позволяет снизить вычислительную нагрузку по сравнению с плотной моделью такого же общего размера.
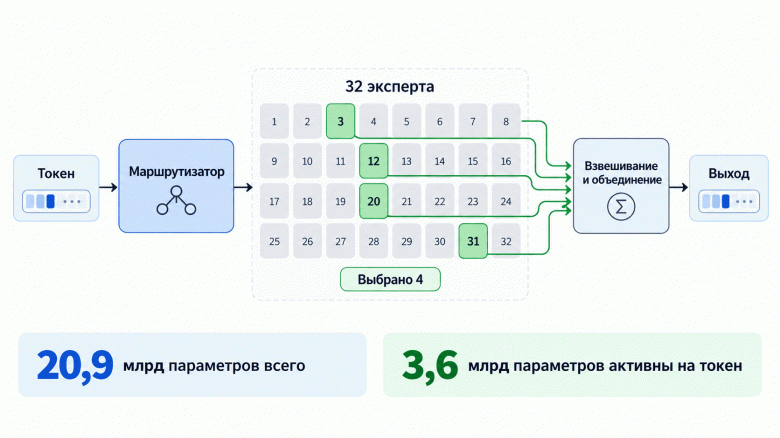
OpenAI приводит такие характеристики для модели:
Характеристика |
gpt-oss-20b |
Общее число параметров |
20,9 млрд |
Параметров, задействованных при обработке одного токена |
3,6 млрд |
Всего экспертов в MoE-слоях |
32 |
Эксперты, задействованные для одного токена |
4 |
Контекстное окно |
128 тыс. токенов |
Модель обучали преимущественно на англоязычных текстах с акцентом на STEM, программирование и общие знания. После основного обучения OpenAI дополнительно настраивала ее на рассуждения и работу с инструментами.
Для рабочих сценариев у gpt-oss-20b есть несколько полезных возможностей:
три уровня рассуждений — low, medium и high: можно выбирать между скоростью и глубиной анализа;
вызов функций и структурированный вывод — для интеграции с внутренними сервисами;
работа с инструментами — модель обучена использовать поиск и выполнение Python-кода;
дообучение под свои задачи — веса доступны, поэтому модель можно адаптировать под корпоративный сценарий.
С требованиями к железу есть важный нюанс. OpenAI указывает для gpt-oss-20b около 16 ГБ VRAM при использовании MXFP4 и называет модель подходящей для одной мощной потребительской видеокарты. Но в официальном руководстве по запуску уточняется, что аппаратная поддержка MXFP4 есть у Hopper и более новых архитектур — среди потребительских карт это RTX 50-й серии. В BF16 та же модель требует уже около 48 ГБ памяти.
Поэтому заявленные 16 ГБ нельзя автоматически переносить на любую RTX. На RTX 50xx модель укладывается в этот диапазон благодаря MXFP4. На более старых картах требования и скорость будут зависеть от движка и используемого формата весов. При работе с 24–32 ГБ памяти запас дает больше свободы для контекста и параллельных запросов.
В отличие от Gemma, gpt-oss-20b не работает с изображениями или аудио. Ее сильная сторона — текстовые задачи, где нужны рассуждения и инструменты: программирование, внутренние помощники, автоматизация цепочек действий и обработка документов. При этом модель остается внутри инфраструктуры компании, а вызовы к внешнему API для самого инференса не нужны.
MiMo-V2.6-Distill-Qwen-9B: небольшой ИИ для работы с кодом и инструментами
Модель gpt-oss-20b уже требует около 16 ГБ памяти в подходящем формате. Если нужно уложиться в более массовые RTX на 8–12 ГБ, интереснее MiMo-V2.6-Distill-Qwen-9B от Xiaomi. Это 9B-модель на базе Qwen3.5-9B, которую дополнительно обучили на данных MiMo для программирования и агентных задач. Модель рассчитана на код, работу с инструментами, визуальное программирование и задачи кибербезопасности.
Главное отличие от исходной Qwen3.5-9B видно в тестах Xiaomi:
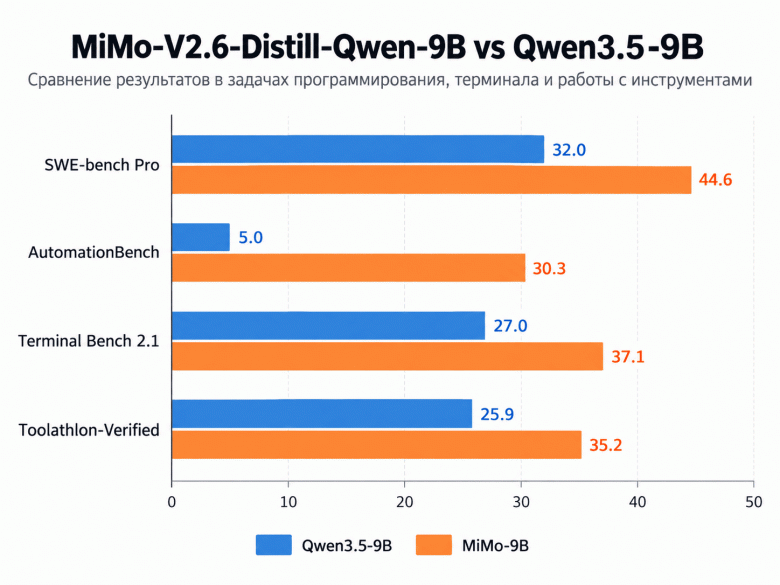
SWE-bench Pro проверяет работу с реальными программными репозиториями, AutomationBench — выполнение последовательностей действий, Terminal Bench — работу через терминал, а Toolathlon — использование внешних инструментов. То есть основной прирост пришелся как раз на сценарии, ради которых MiMo дообучали.
По требованиям к железу модель заметно доступнее, чем gpt-oss-20b. Полные BF16-веса занимают около 17,9 ГБ, а Q4_K_M-квантование занимает 5,84 ГБ. Это оставляет часть видеопамяти под KV-кэш и контекст даже на GPU с 8–12 ГБ.
Есть и практический замер на карте с 12 ГБ. При запуске Q6_K-версии MiMo потребляла около 7,6 ГБ VRAM при контексте 16K и 9,2 ГБ при 64K, а скорость генерации при коротком запросе составила 91,8 токена/с. То есть 12 ГБ позволяют держать модель целиком на GPU и оставляют некоторый запас под длинный контекст.
Для рабочих задач MiMo интересна прежде всего там, где модели недостаточно просто отвечать текстом: написать или исправить код, выполнить команды в терминале, вызвать инструмент и пройти последовательность действий. При этом Xiaomi публикует именно SFT-чекпойнт и называет его отправной точкой для исследований в области агентного reinforcement learning, а не готовой корпоративной системой. Поэтому надежность цепочек из нескольких действий стоит отдельно проверять на собственных сценариях.
MiMo закрывает нижнюю часть нашего диапазона по железу: агентную модель для кода и инструментов уже можно запускать на RTX с 8–12 ГБ, не переходя к 16–24 ГБ, которые нужны более крупным моделям.
Подведем итоги: какую модель выбрать под свою задачу
На видеокартах с 8–12 ГБ VRAM уже можно запускать модели для кода, рассуждений и агентных сценариев. 16 ГБ открывают доступ к Gemma 4 12B-it и gpt-oss-20b, а с 24–32 ГБ можно переходить к Qwen3.8-27B и старшим версиям DeepSeek-R1-Distill.
Модель |
GPU/VRAM |
Основные задачи |
Что учитывать |
DeepSeek-R1-Distill |
8–32 ГБ, зависит от версии |
Тексты, код, рассуждения |
Можно подобрать 7B, 14B или 32B под доступное железо; качество заметно растет с размером |
Qwen3.8-27B |
24–32 ГБ |
Код, документы, мультимодальные задачи |
Длинный контекст заметно увеличивает расход памяти и снижает скорость |
Gemma 4 12B-it |
От 16 ГБ |
Мультимодальные задачи, ассистенты, документы |
Мультимодальность при сравнительно умеренных требованиях к памяти |
gpt-oss-20b |
Около 16–32 ГБ в зависимости от GPU и формата |
Рассуждения, код, инструменты |
16 ГБ достижимы с MXFP4 на совместимом железе; на старых RTX требования могут быть выше |
MiMo-9B |
8–12 ГБ |
Код и агентные задачи |
Компактная модель, особенно сильная в агентных задачах относительно исходной Qwen3.5-9B |
Единого лидера здесь нет. MiMo-9B и младшие R1-Distill подходят для одной массовой RTX и задач, где важны невысокие требования к железу. Gemma 4 12B-it интереснее для RAG и мультимодальных сценариев. gpt-oss-20b ориентирована на рассуждения, программирование и работу с инструментами. Qwen3.8-27B требует уже 24–32 ГБ VRAM, но лучше подходит для более сложного кода, документов и длинных многошаговых задач.
Собственный запуск при этом не делает ИИ бесплатным. Вместо платы за токены появляются расходы на GPU, хранение моделей и обслуживание инференса. Зато данные можно оставить внутри своей инфраструктуры, а работа модели не зависит от лимитов подписки, изменений тарифов и доступности внешнего сервиса. Такой вариант особенно интересен при постоянной нагрузке и работе с внутренними документами.
Собственная линейка открытых моделей развивается и в России. 21 сентября Яндекс представил AliceAI-Foundation-80B-A3B-Base — MoE-модель на 80 млрд параметров, из которых для каждого токена активируются 3 млрд. Модель ориентирована в том числе на русский язык, программирование и задачи с рассуждениями.
Пока это базовая модель, а не готовый чат-ассистент. Яндекс использует ее как основу для экспериментов с будущей единой рассуждающей моделью, которая должна получить и агентные возможности. Срок публичного релиза пока не объявлен, поэтому конкретную новинку до конца года обещать рано.
Поделитесь, какие модели вы уже запускали у себя?
Комментарии (19)

melodicmsk
22.10.2026 07:45Статья устарела минимум на год. Полезности ноль. Уже повыходило движков, которые позволяют запускать гигантские модели даже на 16 гб врам с хорошей скоростью. Снесите статью, не морочьте людям голову. На досуге погуглите strata, Project maya и т. д.

AgentD22
22.10.2026 07:45Ну человек поделился опытом, я вот тоже думал может статью написать, а потом задумался... получу же такие же комментарии из разряда "ну и зачем ты это выложил"...
Просто я тоже, в свободное время дома иногда изучаю локальные модели, запускал разные, задавал вопросы, в таблицу сводил - по скорости и точности ответов. И по сути реально идеальное выбрать 100% нельзя, просто выбираешь то что тебе приемлемо. В том числе разворачивал и gpt-oss:20b, gemma4:12b, Qwen3.8-27B ... и куча других.
Потом захотел к Агентам подключить, а получилось что все агенты очень требовательные, пришлось писать своего Агента, где можно было гибко и в реальном времени регулировать параметры, потом к нему Веб интерфейс приделал, стало как ChatGPT (почти :)), только с кучей технических параметров :). И по сути реально можно теперь пользовать локальную модель, это стало удобно, и не так медленно.
Вы лучше подскажите про новые движки.... хотя бы в 3-5 строчках. Было бы интересно, а потом и погуглим еще :)melodicmsk
22.10.2026 07:45Я же написал что гуглить. На хабре было много статей вот про это всё, что тут. Только более развёрнуто и посвежее.
AgentD22
22.10.2026 07:45Погуглил, это совсем не для всех история c новыми "движками", так что не судите строго - текущая история имеет место быть еще...

mClouds_editor Автор
22.10.2026 07:45Тут, все таки, влияет разный уровень экспертности и вовлеченности в тему читателя, попробуем в следующих статьях затронуть варианты оптимизации памяти работы , спасибо за направление )
ENick
Если смысл статьи можно свести к одной таблице с общими фразами, то в чём смысл публикации?
mClouds_editor Автор
Наверное, как и смысл почти любой статьи, раскрыть как пришли к этой таблице вообще. А то если сделать только таблицу, то будут вопросы - откуда она вдруг такая появилась? ) Наверное, читатель может взять из статьи ровно то, что ему интересно, в этом плюс )
Ndochp
Только вот даже таблица как-то бесполезно выглядит. Нет чтобы локальная память- модель - попугаи. А то ни одного бенча повторяющегося для разных моделей и про разные кванты только общие слова, а качество того же квен 3.8-27 на 8, 12, 16, 32, 96 гигах будет сильно разным из за квантования и размера контекста.
NeoCode2
Мне как не имеющему опыта и попугаи ни о чем. ИМХО, лучше всего конкретные примеры задач на разных моделях и размерах памяти. Вот скажем задача "напиши компилятор некоего простого си-подобного языка программирования". Даем краткое описание синтаксиса. Цель - получить корректно компилируемый набор готовых исходников, из которых можно собрать корректно работающий бинарник. Какие модели справятся а какие нет, какое будет качество кода? И так прогнать несколько десятков конкретных задач разной сложности.
Ndochp
Так попугаи ясно не о чем, но важна не абсолютная величина, а соседние строчки. Так, у меня Радеон 6800, 16 ГБ задача код. Дипсик полный не влезает, Квен 3,8 влезает квант 2, квен 3.6 “влезает” 35 a3b У 3.8 в низком кванте 80 попугаев, у 3.6 - 85, значит беру 3.6.
А задача под агента по тому же принципу будет MiMo-9B в макс кванте.
А по текущей таблице я таких выводов сделать не могу. Вообще никаких не могу кроме того, что Qwen3.8-27B мне не влезет. Но и это не правда, это сейчас у меня основная локальная модель. Так как со strata в варианте swift-iq3_xxs влезает с контекстом 260к и дает 40 токенов в секунду и на вид чуть умнее чем прошлый фаворит
qwen3.6-35b-a3b-mtp q4km с контекстом 88к и всего 20 токенами.
ooptimum
Qwen3.6-35B-A3B занимает VRAM больше, чем Qwen3.8-27B. Как у вас вторая не влезает, а первая - влезает? В каком кванте?
ilia_pmpushnik
Так Qwen3.6-35B-A3B - экспертная, её экспертов можно частично выгружать в RAM и скорость не будет падать катастрофически, как в случае с плотной Qwen3.8-27B
SkalolazOther
Модель Qwen3.8-27B поместится в видеопамять, однако потребуется уменьшить количество слоев нейронной сети в VRAM или использовать квантование. При этом, в первом случае - стоит ожидать снижения пропускной способности и, как следствие, меньшего количества генерируемых токенов в секунду, во втором - увеличение количества галлюцинации и ошибок в ответах LLM.
NeoCode2
Так моя проблема в том что мне надо чтобы оно не только влезало, не только выдавало сколько то там токенов в секунду, но и осмысленно работало. А вот этой информации я вообще нигде не вижу и найти не могу (а это именно тесты на реальных задачах). Я тупо не понимаю покупать мне видеокарту на 16 гигов сейчас или тупо подождать несколько лет и купить что там будет тогда (при этом я уверен что хочу себе именно локальный ИИ, но не понимаю что я получу сейчас и что получу если буду ждать - а эксперименты ради экспериментов мне неинтересны).
Ndochp
Так вот бенчмарк-попугаи это и есть “тесты на реальных задачах” поэтому они рядышком со скоростью и нужны.