

Мы подготовили модель TAPe+ML к локальному исполнению внутри процессорного ядра. Напомним, что TAPe+ML — единая модель с общим ядром для классификации, детекции, сегментации и трекинга объектов. Модель помещается во внутренней памяти процессора и после первоначальной загрузки работает там. Для работы самой модели не требуется постоянно переносить ее параметры из оперативной памяти в процессор.
Текущая локальная поставка занимает около 4,2 МБ, а на протестированных CPU обработка кадра занимает от 8,6 до 15,8 мс.
Дисклеймер
Если вы впервые читаете о TAPe, можно начать с наших предыдущих материалов:
Напомним, что в нашей модели TAPe+ML высокое качество распознавания сочетается с компактной архитектурой: модель достигла 88,1% точности на ImageNet-1k и 65,3% mAP50–95 на COCO при менее чем 100 тысячах параметров. Это не предел. Читайте arXiv или краткое резюме на Хабре уважаемом.
От модели распознавания к локальному продукту
TAPe+ML использует структурированное представление данных и объединяет классификацию, детекцию и сегментацию в одном компактном ядре. В опубликованных на arXiv результатах v3 модель получила 88,1% Top-1 accuracy на ImageNet-1k, 65,3 mAP50–95 в детекции COCO и 58,4 Mask mAP50–95 в COCO instance segmentation при числе параметров менее 100 тысяч.
До работы над локальной поставкой у нас уже была платформа с загрузкой данных, ручной и автоматической разметкой, обучением, проверкой результатов и API для интеграции. Партнер мог подготовить собственный датасет, обучить модель и подключить распознавание к своему приложению.
Следующая задача — перенести исполнение непосредственно на оборудование заказчика. В сентябре мы начали работу над on‑premise‑версией. Требовалось не только запустить модель вне нашей инфраструктуры, но и подготовить защищенную поставку: решить вопросы упаковки, адаптации и сохранения ноу‑хау. Первые этапы этой работы прошли в проекте конкурса для метро, затем — в проекте «Ночной глаз». Для него мы подготовили первоначальную поставку размером около 28–30 МБ. По данным команды проекта, эта версия работала на RDBox (мини‑ПК на Intel N100 (4 ядра) со встроенной графикой Intel, NVMe 468 ГБ, Wi‑Fi, Ubuntu 24.04 и две USB‑камеры: обычная 1280×720 и тепловизор 640×480) с загрузкой ядра 30–60%.
Затем мы продолжили оптимизацию библиотек и исполнения под процессорное ядро — и сократили текущую локальную поставку до 4,2 МБ. О самом «Ночном глазе», обучении модели и испытаниях на воде рассказали подробно в отдельной статье.
Модель помещается внутри ядра и работает там
В ходе оптимизации мы пришли к исполнению, при котором модель помещается во внутренней памяти процессора. Это удалось реализовать в том числе на RDBox, используемом в проекте «Ночной глаз». После первоначальной загрузки модель работает внутри ядра.
Во внутренней памяти процессора (L‑cache) помещаются не только параметры модели, но и её активации — полное представление обрабатываемого изображения в TAPe‑формате. Именно размещение активаций в L‑cache дает основное ускорение: для работы с этим представлением не требуется постоянно обращаться к оперативной памяти, и обработка становится близкой к одномоментной.
Здесь есть связь с другим нашим решением — TAPe RVS. Поиск в подготовленном видеоархиве объемом в десятки тысяч лет требует лишь нескольких десятков обращений к памяти. В локальной TAPe+ML параметры модели и активации помещаются во внутренней памяти процессора — без необходимости постоянно переносить их из оперативной памяти.
Что мы оптимизировали
Мы не ограничились стандартным распараллеливанием готового программного продукта. Возможности TAPe использовались при проектировании самого исполнения: они определяли, какие операции и компоненты нужны модели, а какие можно исключить. Именно понимание внутреннего устройства TAPe позволило подготовить такой вариант работы под процессорное ядро.
У компактной модели и готового программного решения разные размеры. В локальную поставку входят не только параметры распознавания, но и код исполнения, библиотеки и упаковка. Так, в первой версии для «Ночного глаза» заметную часть объема составляла именно эта программная обвязка.
Мы последовательно сокращали эту обвязку: убирали ненужные компоненты и адаптировали исполнение к операциям, которые действительно использует TAPe+ML. В существующих конфигурациях итоговый размер поставки остается около 4,2 МБ. При этом задачи за пределами детекции, сегментации и классификации добавят весе и увеличить размер модели.
Работа не ограничивалась уменьшением пакета. Мы оптимизировали само выполнение модели под CPU. Архитектура изначально проектировалась для быстрого непараллельного исполнения; небольшое число параметров и слоев позволило дополнительно оптимизировать вычисления. Подготовленный подход удалось применить к нескольким процессорным конфигурациям, включая серверы, ноутбук и RDBox, о котором мы уже упоминали выше.
В исполнении через API мы использовали готовые библиотеки. Для локальной версии переработали этот путь под собственную модель — и получили более быстрое выполнение.
Текущая версия уже оптимизирована на максимальном уровне, исходя из нашего сегодняшнего понимания связки TAPe с тем, что называется сейчас ML, его принципами, методами, библиотеками и так далее. Именно ее мы готовы передавать заказчикам. Дальнейшие возможности оптимизации остаются, но для локальной поставки не требуется ждать следующего этапа разработки — берите.
Результаты на одном ядре
Мы протестировали TAPe+ML на четырех процессорных конфигурациях. Для сравнения использовали YOLO26s с 9,5 млн параметров и RF‑DETR‑S с 32,1 млн параметров. Все приведенные ниже измерения относятся к инференсу полностью на CPU с ограничением одним ядром.
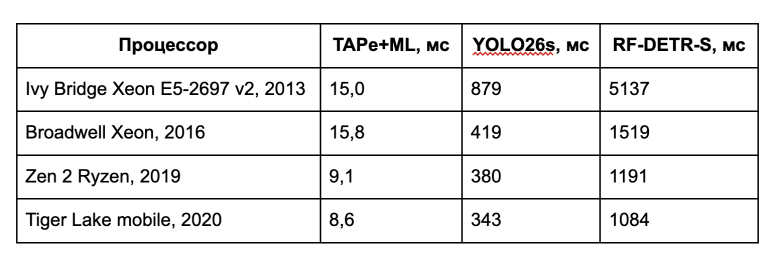
На этих конфигурациях TAPe+ML обрабатывала кадр за 8,6–15,8 мс, YOLO26s — за 343–879 мс, RF‑DETR‑S — за 1084–5137 мс.
Здесь важна не только задержка сама по себе, но и ресурс, на котором она получена. YOLO тоже может обрабатывать кадр примерно за 15 мс — но на GPU. Наш результат в приведенных тестах получен полностью на CPU, всего на одном ядре.
У сравнения на одном ядре есть особенность: YOLO и RF‑DETR сильно зависят от параллельного исполнения и не могут эффективно использовать свои возможности в таком режиме. При добавлении ядер их скорость меняется нелинейно. Например, переход с одного ядра на два может ускорить выполнение втрое, а не вдвое, причем оба ядра не обязательно будут полностью загружены. Поэтому результаты в таблице характеризуют именно однопоточный режим, а не максимальную производительность этих моделей на CPU. Сопоставить многопоточное исполнение при одинаковом суммарном потреблении процессорных ресурсов сложнее: на время обработки и загрузку ядер влияет много переменных.
Для TAPe+ML параллельное исполнение не является условием достижения приведенной скорости — модели достаточно одного ядра. На многоядерном сервере дополнительные ядра можно использовать для отдельных потоков обработки, а масштабирование продолжать за счет подключения новых серверов. В этом смысле потенциал горизонтального роста не ограничен необходимостью распараллеливать саму модель: она уже работает на одном ядре.
При этом речь идет о единой модели TAPe+ML с общим ядром распознавания для классификации, детекции, сегментации и трекинга объектов. На данный момент мы не видим ограничений в этих задачах, которые потребовали бы выхода за пределы такой схемы.
Как получить модель для своего оборудования
Путь начинается с данных задачи.
Начать можно на ml.comexp.net: загрузить свои изображения, разметить примеры, обучить модель и посмотреть результат распознавания. Для интеграции доступны API и инструменты подготовки данных. Этот цикл уже использовала команда проекта «Ночной глаз», которая самостоятельно готовила данные и обучала распознавание под объекты водной среды. Мы написали об этом отдельную статю чуть раньше.
После обучения мы можем подготовить локальное исполнение под процессор заказчика. Для уже реализованных конфигураций используется готовая адаптация. Новый тип процессора может потребовать ручной работы при первой поставке; в промежуточных случаях часть подготовки выполняется автоматически, часть — с участием разработчика.
Локальные версии передаются клиентам под контракт. Свободное распространение скачиваемых пробников мы рассматриваем отдельно: здесь необходимо учитывать защиту технологии и условия предоставления доступа.
Welcome.
Комментарии (3)

TomskDiver
22.10.2026 16:47Блин. Я вот верю вам что у вас супер результаты. Но как и в прошлой статье я спрошу (там остался без ответа): Как вы разместили свою поставку в памяти процессора? Я так понимаю речь про L3 кэш? Как вы сделали так чтобы ОС и другие процессы не вытесняли вашу 4Мб поставку из кэша? Или это какой-то спец процессор?
У меня такое ощущение что вы решили что раз у вас все меньше чем L3 кэш значит вы полностью там, а то что там еще от ОС и других приложений вы не учитываете. Ну или вы всё таки как-то замеряли аппаратные счётчики промахов LLC/L3 и обращения к памяти?

alexander_fedoseev
22.10.2026 16:47Круто конечно, даже очень. Но сейчас такие времена, что есть специальные NPU для ускорения моделей, и кстати вполне доступные по цене (например одноплатники Radxa). Смотря на них фокус смещается уже не в сторону как сделать быстрее, а в сторону как сделать качественнее. Ну и хотелось бы, конечно, видеть воочую, на видео в сравнении в YOLO.
Danusha0000000
скорость сравнили , а точность?