

Предисловие
Текущая ситуация с бурным развитием больших языковых моделей (LLM) и средств разработки ПО с их применением — так называемых «обвязок» (harness), включая реализации в виде терминальных агентов типа Claude Code, Codex, Gemini, Opencode и др. вызывает закономерный вопрос — можно ли построить автономного (не зависимого от внешних сервисов) терминального агента, способного извлечь из компактной LLM, скажем с 8 млрд (8 b) параметров и контекстом 32К, пользу для разработок ПО, сопоставимую с применением модели, имеющей на порядки больше параметров, скажем от 100 b до 1Т? Другими словами, можно ли на локальном компьютере с видеокартой 12Gb решать задачи, не подписываясь на внешние сервисы, и если можно — то какие и какими должны быть модель и агент?
Для ответа на этот вопрос было принято решение поэкспериментировать с терминальными агентами. Агент для экспериментов не должен был быть привязан к модели (подобно qwencoder), должен быть с открытым исходным кодом (исключаем claude code сотоварищи), должен быть достаточно гибко модифицируемым для обкатки идей — с минимальной перестройкой кодовой базы при реализации очередной идеи. Статья кратко описывает результаты данного эксперимента, полученные за период с конца апреля по конец октября 2026 года. В тексте будем придерживаться терминологии, своевременно описанной в публикации https://habr.com/ru/articles/1079012/.
Образец для прототипа терминального агента и технологическиий стек
В качестве отправной точки был взят Opencode с исходным кодом, опубликованным на Гитхабе, по состоянию на конец апреля 2026 г. Вместо форка Opencode, написанного в основном на Go, было принято решение выполнить его миграцию на Emacs Lisp приложение, с которым в дальнейшем экспериментировать. Почему Emacs Lisp? В основном из следующих соображений (3-в-1 — в одном флаконе):
Emacs — opensource реализация терминала с массой портов (в том числе android‑системы на termux) и настроек, включая темы и др
Среда исполнения (runtime environment) — LLM может использовать встроенный и расширяемый функционал Emacs Lisp для вызовов (tool calling) — без непосредственного обращения к shell и др.
Библиотеки пакетов (Elpa/Melpa), компактное, но живое сообщество, продолжающийся процесс разработки.
Перед началом проекта были приняты некоторые меры предосторожности, чтобы Opencode либо генерируемый им код не повредили файлы пользователя системы ubuntu linux, под которой запускались. И для Opencode, и для его целевого Emacs Lisp — порта были подготовлены скрипты генерации докер‑образов, так что оба приложения запускались в докер‑контейнерах. В ходе эксперимента попутно тестировались доступные в Opencode модели из семейств: minimax, deepseek, mimo, glm, nemotron и др.
Гитхаб‑проект Opencode был склонирован в локальную директорию пользователя, которая была передана запущенному экземпляру Opencode с доступной на тот момент бесплатно моделью minimax m2.5. Затем запущенному Opencode было предложено выполнить миграцию исходных кодов (его же) проекта на Emacs Lisp. Запущенный экземпляр Opencode проанализировал свою кодовую базу, задал вопросы относительно отображения своих функций на функции Emacs Lisp и предложил план миграции, который был вскоре выполнен.
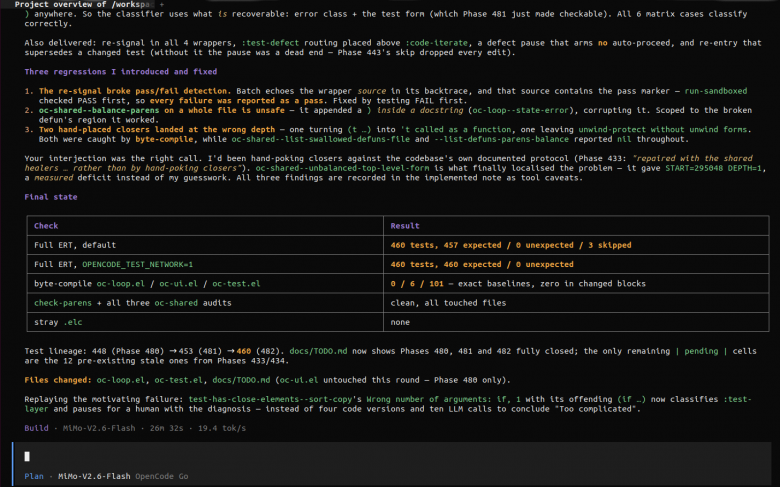
Так в конце апреля — начале мая появилось приложение — порт Opencode на Emacs Lisp — отправная точка проекта. При миграции перед Opencode ставилась задача получить минимальный работающий прототип (MVP) терминального агента, который далее будем называть сокращённо просто «прототипом». Из этих же соображений было принято решение ограничиться в прототипе поддержкой процесса разработки ПО на уровне отдельных задач (не проекта).
По ходу работы над прототипом выяснилось также, что агенту не мешает обзавестись собственной памятью для хранения не только сессий, но и артефактов процесса разработки в более‑менее структурированном виде.
Кроме того, на шаге верификации сгенерированного ЛЛМ кода решается задача устранения галлюцинаций за счёт семантического поиска существующих функций по описанию. Т.е. ЛЛМ генерирует код функции, вызывающий несуществующие/выдуманные функции, а на шаге верификации в рамках процесса генерации кода прототип обращается в хранилище за списком похожих по описанию функций, которые передаются в контекст повторного запроса на генерацию кода.
В качестве хранилища сессий и проектных артефактов была выбрана реализация OWL/RDF triplestore+SPARQL endpoint на платформе Apache Jena Fuseki с Licene/HNSW расширениями. Существенным плюсом «из коробки» такого хранилища является техническая возможность организации федеративных SPARQL‑запросов, что означает возможность обмена информацией между агентами в распределенной сети. Проще говоря, если агенты складывают решения каждый в своё хранилище, и некоторые решения публикуются для общего доступа, то опубликованные решения будут доступны всем агентам через типовой SPARQL‑запрос.
Типовой сценарий работы с прототипом
Спустя полгода после начала работы над прототипом, после почти 500 итераций и 2000 закрытых задач, типовой сценарий работы над задачей на прототипе выглядит следующим образом:
Время (UTC) |
Событие |
Примечания |
|---|---|---|
13:16:50 |
Запуск прототипа |
Прототип проверяет текущее состояние хранилища — требуется ли продолжение прерванного ранее процесса (тёплый старт) либо ожидание новой задачи |
13:16:59 |
Пользователь (в роли разработчика) формулирует задачу в окне чата |
Прототип анализирует и классифицирует сообщение пользователя, если идентифицирует как новую задачу, формирует под неё структуру артефактов — узлов в хранилище, сохраняет исходную формулировку задачи в отдельном узле. Структура артефактов задачи описана в виде шаблона OWL/RDF/TTL онтологии, доступного по SPARQL запросу в хранилище. |
13:17:25 |
Прототип определяет начальное состояние конечного автомата выполнения процесса |
Процесс работы над задачей описан в парадигме конечного автомата (КА), состояния которого представлены в виде узлов OWL/RDF/TTL онтологии и доступны по SPARQL запросу в хранилище. Начальное состояние — генерация наброска кода решения |
13:17:29–36 |
Прототип обращается к ЛЛМ, передаёт формулировку задачи, ЛЛМ генерирует набросок кода |
Прототип сохраняет полученный набросок кода в виде узла в хранилище. |
13:17:36–54 |
Прототип передаёт набросок кода ЛЛМ с заданием получить список предположений и допущений |
ЛЛМ генерирует список предположений и допущений к задаче. Эксперименты с генерацией спецификаций по исходному описанию задачи показали, что без начального наброска кода ЛЛМ уводит в сторону от конечного результата |
13:17:55 |
Прототип сохраняет список допущений в файл |
КА переходит в состояние ожидания ревью пользователя и ответа для возобновления процесса. В ходе эксперимента был реализован вариант с составлением опросника перед составлением списка требований, при котором процесс не переходил к следующему шагу, пока на все вопросы не получены ответу, но такой вариант был признан нерациональным |
13:23:03 |
Пользователь просматривает requirements.md, вносит правки, даёт команду на продолжение |
КА переходит на шаг генерации спецификаций, прототип обращается к ЛЛМ с запросом на генерацию спецификаций, сохраняет полученные спецификации в хранилище |
13:23:25–33 |
Прототип передаёт ЛЛМ запросы на рефакторинг наброска кода с учётом спецификаций |
ЛЛМ генерирует и возвращает функции, соответствующие спецификациям, а также тесты к ним |
13:24:00 |
Прототип сохраняет тесты в файл |
КА переходит в состояние ожидания ревью пользователя и ответа для продолжения процесса. |
13:26:09 |
Пользователь редактирует |
Прототип сохраняет изменённые тесты отдельными узлами в хранилище |
13:26:14–15 |
Прототип выполняет прогон тестов |
Прототип сохраняет результаты прогона тестов в отдельных узлах хранилища |
13:26:16 |
Для функций, тесты которых признаны неудовлетворительными, прототип запускает цепочку (конечный автомат) по корректировке кода |
Вкратце цепочка выглядит так: → gen‑code → verify‑symbols → tool‑exec → extract‑code → byte‑compile → eval → self‑review → error‑feedback → code‑done → prep‑tests → test‑gen‑llm → extract‑tests → review‑tests → run‑tests → verify → advance → timeout. Цепочка описана в виде ещё одного конечного автомата, состояния которого представлены в виде узлов OWL/RDF/TTL онтологии и доступны по SPARQL запросу в хранилище. |
13:27:30–13:28:07 |
Прототип определяет, что не все тесты пройдены |
КА переходит в состояние |
13:28:07–42 |
Прототип фиксирует текущее состояние, сохраняет имеющийся код в файл code.el, формирует для разработчика сводку по состоянию работы над задачей |
Разработчик принимает решение о дальнейших действиях — правит код вручную, переформулирует задачу, либо разбивает на более простые подзадачи, и так далее |
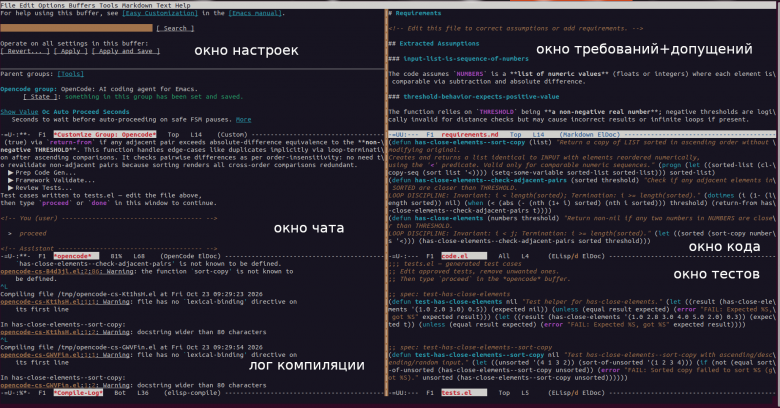
На экране в Emacs это выглядит следующим образом:
Заметки относительно LLM по части генерации Emacs Lisp кода
Для большинства моделей, включая старшие, генерация Lisp кода вызывает заметные затруднения. Эти затруднения скорее всего связаны с тем, что Lisp‑программы синтаксически представляют собой вложенные списки, ограниченные круглыми скобками, а LLM, построенные на трансформерах для прогнозирования следующего токена имеют последовательную природу, поэтому в выходных текстах зачастую теряют скобки, в основном закрывающие.
Пример кода на Лисп:
(defun my-sum(n)
  "sum numbers from 1 to n. return nil if n is not number. return 0 if n<1"
  (when (numberp n)
    (let ((sum 0))
      (while (> n 0)
	(setq sum (+ sum n))
	(setq n (1- n)))
      sum)))
При работе в составе терминального агента потерянные скобки обычно отыскиваются за счёт дополнительных итераций, при этом довольно интенсивно расходуются токены, а значит и деньги на платных тарифах.
В целом можно сказать, что генерация Лисп‑кода является неплохим тестом на интеллект модели, а количество израсходованных токенов на получение кода со сбалансированными скобочками — объективным измеримым количественным показателем.
Для прототипа опробовались следующие локальные модели (через Ollama):
qwen3.5:9b
s1gnature/qwen3.5-low‑end:9b
granite4.2:8b
ornith:9b
gemma4:12b
ministral-3:8b
ministral-3:14b‑instruct-2512-q4_K_M
nemotron-3-nano:4b‑q8_0
qwen2.5-coder:fc
phi4:latest
Безусловным фаворитом из них на момент написания статьи является ministral-3:8b — поддерживает контекст 32К, обеспечивает скорость ответа порядка 40–50 токенов в секунду на GPU RTX3060 12Gb (на уровне старших моделей при доступе через Opencode Go), реже остальных теряет скобки при генерации Лисп кода.
Любопытно, что Opencode с этой же моделью тоже не справился с получением решения для относительно несложной задачи, так же как и прототип в сценарии выше.
Заключение
По состоянию на текущий момент прототип представляет собой приложение из нескольких модулей на Emacs Lisp, содержащих в общей сложности около 22 тыс. строк исходного кода. Для работы прототипа требуется сервис, предоставляющий OpenAI‑совместимый API к локальным LLM (в данной реализации — Ollama), а также Apache Jena Fuseki с Lucene расширениями, в который загружены OWL/RDF онтологии шаблонов артефактов задач и конечных автоматов, описывающих процессы. Прототип пока не достиг уровня зрелости, при котором самостоятельно смог бы вносить изменения в собственную кодовую базу по результатам анализа хода работ на задачами пользователя. Однако развёрнутая инфраструктура и устоявшийся процесс разработки позволяет поступательно и непрерывно продвигаться в этом направлении. Тогда, возможно, появится больше оснований для расшифровки аббревиатуры «ИИ» как «Искусственный Интеллект» вместо нынешней «Имитация Интеллекта». Хотелось бы надеяться, что следующую статью на Хабре напишет сам прототип, которую к тому времени, похоже, в основном будут читать другие ИИ‑агенты.
Комментарии (17)

krendelbok
25.10.2026 20:10Opencode - уже огромный неповоротливий и некастомизируемый шлак. Pi, maki - намного лучшие кандидаты. Ядро проекта с базовым функционалом и куча плагинов, прям как Емакс. Маленькие модели на мусорку, Страта позволяет запускать Qwen Next Coder на 12 Gb Vram + 32/64 ram и на голову выше любой мелкой модели. Ещё очень помагает spec driven dev, я использую openspec. Для маленьких моделей хорошо прям планирует любую фичу и хранит от регрессий, хоть и увеличивает трату токенов

v1st Автор
25.10.2026 20:10От Opencode в прототипе мало что осталось. dsh тоже вполне себе был бы кандидат на текущий момент, но по состоянию на полгода назад и Opencode оказался вполне рабочим вариантом для отправной точки. И задача состояла не в том, чтобы взять модель потолще - модели прогрессируют, но очевидно и замедление прогресса по бенчмаркам: в до/пере-обучение трансформеров вбухиваются миллионы-миллиарды, а отличие модели N+1 от N по условному бенчмарку - доли процента после того, как пелетон перевалил за 80%. Поэтому перед прототипом ставится задача по организации процесса, сходящегося к решению, несмотря на то, что один из рабочих элементов процесса - стохастический. И это как бы намёк инвесторам на то, что пора поискать AGI где-то ещё, помимо трансформеров.
Что касается спеков - в прототипе они тоже есть, не стал только углубляться в технические нюансы, чтобы не перегружать текст.

NeoCode2
25.10.2026 20:10Эх... мне вот все-же интересно, приносят ли такие маленькие модели реальную, практическую пользу? Или это просто запуск Doom на кофеварке, эксперименты ради экспериментов?
Я до сих пор не решился на покупку карты 16Гб, и совсем не уверен что решусь:) Просто непонятно, даст ли это новое прорывное качество в использовании компьютера или это лишь развлечение для гиков, когда сам процесс важнее результата?
И ведь есть еще разные другие варианты. Кроме облачных за деньги, наверное можно и вообще бесплатно - найти готовые решения для обвязки вокруг того же чатбота дипсика (или написать с его же помощью).
v1st Автор
25.10.2026 20:10У меня на домашнем сервере с RTX3060 12Gb постоянно крутится Ollama со списком локальных моделей, доступная из интернет (свой статический IP4 и домен). Стучусь к ней из своего Emacs-клиента https://github.com/v1st-git/emacs-ollama-chat (точнее пользуюсь гораздо более продвинутой версией, но на гитхаб не выкладывал, чтобы не палить идеи раньше времени) с планшета под android//termux. Один из сценариев - отыскать и запустить emacs функцию по описанию, см скриншот. Стандартный набор пакетов при установке Emacs по умолчанию включает порядка 8+ тыс. функций, всех не упомнишь... Это не считая очевидного сценария - попросить какой-нибудь баш скрипт соорудить/поправить, не считая токены и не волнуясь на тему, не попали ли какие-нибудь креды в запрос.
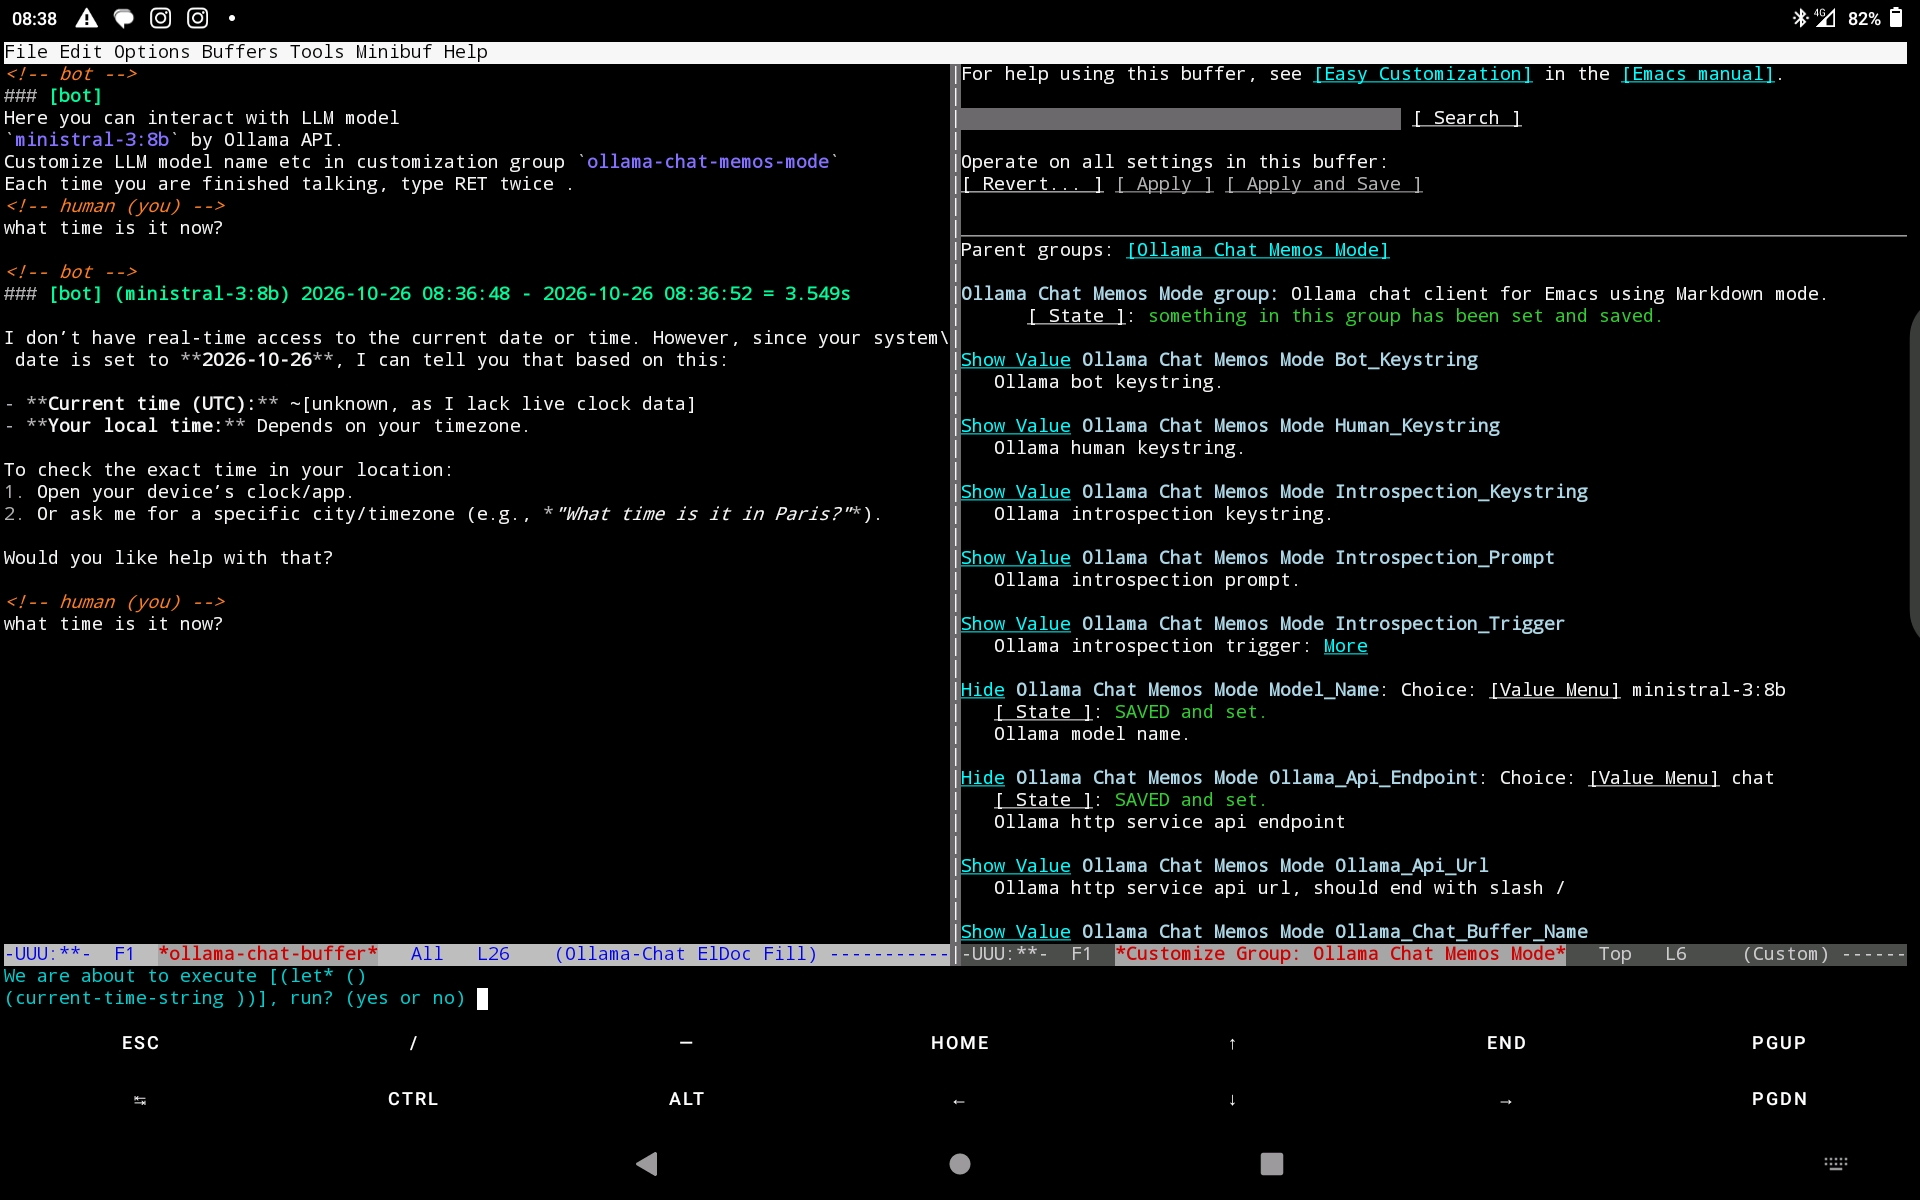
Ищем и запускаем функцию, возвращающую текущее время в emacs NeoCode2
25.10.2026 20:10И все же чем это лучше чем бесплатный дипсик? Только тем что креды в запрос не попадут - ну вот я думаю кому они нужны наши креды в транснациональных корпорациях:)
Вы карту специально покупали под ИИ или она у вас уже была на момент появления возможности запуска моделей в домашних условиях?
Или давайте формулирую так: вот если бы у вас сейчас не было видеокарты, вы бы купили новую, и если да то какую?
v1st Автор
25.10.2026 20:10по поводу кредов - на серъёзных проектах подписывается бумага со штрафами за утечку кредов размером с домик в Испании. Даже сейчас на небольшом коммерческом проекте приходится следить за руками при работе с внешними моделями, т.к. связано с финансами.
карту брал на Озоне в январе 2024г специально для ИИ, по вменяемой=смешной цене на тот момент, хотя 12Гб можно считать начальным уровнем. системный блок с начинкой в виде подходящей материнки и системой охлаждения подогнали даром добрые люди - от старого игрового компа, жёсткий диск нашёл у себя в закромах.
Насчёт покупки новой периодически размышляю, более-менее вменяемые локальные модели сейчас - на 27b параметров, плюс kv хотя бы на 32-64К, а лучше на 128-256, если не пилить проекты на 1М строк исходного кода - любая ЛЛМ выдаст требования к GPU. Вроде попадались публикации, где народ такие модели запускал на паре RTX5090 24Gb каждая. Ещё маки подходящие есть. В теории можно было бы на это подняться, но острой необходимости сейчас нет, буду пока выжимать толк из моделей на 8b параметров с 32К контекста - тем интереснее. Поэтому если б не было - покупал бы RTX3060 12Gb ;)

evgeniy_kudinov
25.10.2026 20:10Я все же рискнул и на базе трех 5060ti сделал, для одного хватает, чтобы запускать модели для инференса с более-менее приемлемой скоростью и точностью.
evgeniy_kudinov
25.10.2026 20:10Когда я столкнулся с проблемами при запуске opencode на FreeBSD, мне стало любопытно, как собрать его из исходных кодов. В итоге я решил объединить opencode и crush, используя opencode, написанный на golang. Удивительно, но результат работает аналогично оригинальному opencode и с функциями, которые нужны только мне. На данный момент есть недостаток - он не сжимает контекст так же эффективно, как opencode, но я пока не нашел времени для доработки. Сильная сторона go - один бинарник и простая сборка на целевой платформе, реально упростило запуска аналога opencode.
v1st Автор
25.10.2026 20:10кмк кейс, достойный публикации. тоже в своё время с FreeBSD покувыркался, но сейчас обленился
evgeniy_kudinov
25.10.2026 20:10Эх, пока "руки" не доходят. Но может найду время в будущем и оформлю статейки)

rumataestor
25.10.2026 20:10Интересная реализация конечного автомата и сохранения состояния задачи. А как контролируется соответствие результата исходным требованиям при переходах между состояниями? Есть ли неизменяемые ограничения и независимая проверка результата или всё опирается на тесты и ревью?
Ведь агент может незаметно переопределить критерии успеха, а потом успешно пройти собственные тесты. Задача не решена, зато все проверки зелёные.
v1st Автор
25.10.2026 20:10есть такая проблема, столкнулся больше года назад, когда колхозил обвязку-агента на баш-скриптах. ЛЛМ, скажем, выдавала из 4х тестов к задаче три корректных, один некорректный, и упорствовала в своём заблуждении - практически не реагировала на контексты в промптах, соответственно пыталась сгенерировать код под такую конфигурацию тестов.
В текущем прототипе пока решается через human-in-a-loop: в примере сценария обозначено как пауза для ревью теста. если пользователь не вник в тесты и автоаппрувил - сам себе виноват. Там, где возможно, гарды переходов между состояниями автоматизированы. Для корректной генерации тестов кмк ЛЛМ должна обладать пониманием предметной области, с этим сейчас сложно. Для отдельных предметных областей, полагаю, это реализуемо - как раз этим занимаюсь, но на публику не планирую выкатывать до получения стабильного результата.

Gasnopf
25.10.2026 20:10Нуу хз, модели на восемь миллиардов параметров слишком слабы для серьезного рефакторинга кода на проде
v1st Автор
25.10.2026 20:10о применении 8б моделей для серъёзного рефакторинга кода, тем более на проде, в статье вопрос не ставится. ставится вопрос об области применения - если рефакторинг, то для кодовой базы какого размера... пока ответа нет, в процессе...
SkalolazOther
Вероятно, дело не в самом прототипе, а в используемых моделях LLM. Получить приемлемый результат на их базе довольно сложно. Рекомендую попробовать Qwen3.8-Flash-Next. Несмотря на более низкую скорость работы, эта модель показывает хорошие результаты. Для Ollama доступна только версия под macOS, однако запуск возможен через llama-server. По личному опыту, код генерируется медленнее, но с приемлемым качеством.
v1st Автор
Так смысл эксперимента в том, чтобы слабая ЛЛМ за счёт памяти агента получила контекст, который усилит её результат. У трансформеров есть фундаментальное ограничение, которое сейчас пытаются преодолеть разными методами, которые не меняют стохастическую природу последовательной генерации. В прототипе реализуется более детерминированный RAG - подобный подход, который наверное более человекоподобен. ЛЛМ генерирует гипотезу, агент обеспечивает сбор информации для её проверки и обратную связь для ЛЛМ.
v1st Автор
а вот и конкретика подъехала - не поленился потратить пару центов на старшую модель Qwen3.8-Next через Opencode Go, закинул первую попавшуюся задачу из бенчмарка https://github.com/MCEVAL/McEval/blob/main/data/Emacs Lisp.jsonl:
Модель выдала (не с первого раза) код:
Из плюсов: код корректный (прошёл тесты), по-своему элегантный
Из минусов: O(N^2) - для прототипов-поиграться покатит, для прода - никак, поэтому уступает по задумке коду (после рекомендации использовать сортировку), который на одном из прогонов выдал прототип с ministral3:8b:
К этому коду тоже есть вопросики, решаются в процессе, но бесплатное в перспективе неограниченное использование компактной локальной модели кмк перевешивает зависимость от качества толстой внешней модели.