

Привет, Хабр!
В процессе преподавания дисциплин, связанных с анализом больших данных и распределёнными вычислениями, я регулярно сталкиваюсь с необходимостью организовывать практическую работу студентов с Apache Spark. На первый взгляд задача достаточно простая: подготовить серверы, установить необходимые компоненты, настроить взаимодействие между ними и предоставить студентам доступ к работающему кластеру.
Но когда речь идёт не об одном стенде, а о целой учебной группе, подготовка инфраструктуры превращается в отдельную задачу. Особенно если каждому студенту необходимо предоставить собственный кластер для выполнения лабораторных работ. Некоторое время назад я решил автоматизировать этот процесс и разработал небольшое настольное приложение для развёртывания Apache Spark на виртуальных серверах.
Со временем проект развивался, и недавно я завершил работу над его второй версией – Spark Cluster 2.
Это приложение с графическим интерфейсом, которое помогает развернуть учебный кластер Apache Spark на VPS, подготовить необходимые компоненты инфраструктуры и перейти непосредственно к выполнению практических заданий. При этом я решил не ограничиваться самой программой и дополнить проект учебными материалами. В этой статье расскажу, зачем понадобилось отдельное приложение, как оно устроено, какие задачи решает и что изменилось по сравнению с первой версией.
Зачем понадобилось отдельное приложение?
Apache Spark можно использовать в разных режимах. Для первоначального знакомства с технологией вполне достаточно локального запуска PySpark. Можно установить необходимые библиотеки, открыть Jupyter Notebook и начать работать с DataFrame API или Spark SQL. Для изучения основ обработки данных такой подход удобен и не требует сложной инфраструктуры.
Однако при переходе к распределённым вычислениям хочется показать студентам не только выполнение отдельных операций, но и устройство самого кластера.
Например, разобраться:
Как взаимодействуют Spark Master и Workers?
Каким образом распределяются вычислительные задачи?
Как Spark использует доступные вычислительные ресурсы?
Где хранятся данные и как организуется доступ к ним?
Как наблюдать за состоянием кластера и выполняемых заданий?
Для этого уже полезно иметь отдельную учебную инфраструктуру. Разумеется, кластер можно развернуть вручную. Подключиться к серверам по SSH, установить Docker, подготовить конфигурационные файлы, запустить контейнеры и проверить их взаимодействие. Но здесь возникает вопрос: сколько времени должно уходить на подготовку окружения, если основная цель занятия – изучение Apache Spark? На мой взгляд, значительную часть этих операций можно автоматизировать.
Так появилась идея создать приложение, которое позволит подготовить кластер через графический интерфейс, не заставляя пользователя вручную выполнять десятки команд.
Что представляет собой Spark Cluster 2?
Spark Cluster 2 – настольное приложение для автоматизации развёртывания учебного кластера Apache Spark на виртуальном сервере.
Проект ориентирован прежде всего на преподавателей, студентов и начинающих специалистов, которые хотят познакомиться с распределённой обработкой данных на практике. Основная задача приложения – упростить подготовку инфраструктуры. Пользователю не нужно самостоятельно устанавливать и настраивать каждый компонент кластера. Вместо этого он работает с графическим интерфейсом, через который организуется процесс развёртывания.
При разработке я придерживался нескольких принципов.
Простота использования. Приложение должно быть доступно не только системным администраторам, но и студентам, которые впервые сталкиваются с Apache Spark.
Автоматизация. Максимально возможное количество типовых операций должно выполняться программой.
Воспроизводимость. Разные пользователи должны иметь возможность получать сопоставимые учебные окружения.
Практическая направленность. В результате работы приложения пользователь должен получить настоящий работающий кластер, а не его имитацию.
Образовательная составляющая. Развёртывание инфраструктуры — только первый этап. Важно также понимать, как использовать полученное окружение.
В результате Spark Cluster 2 стал не просто набором скриптов, а самостоятельным программным продуктом.
На чём написано приложение?
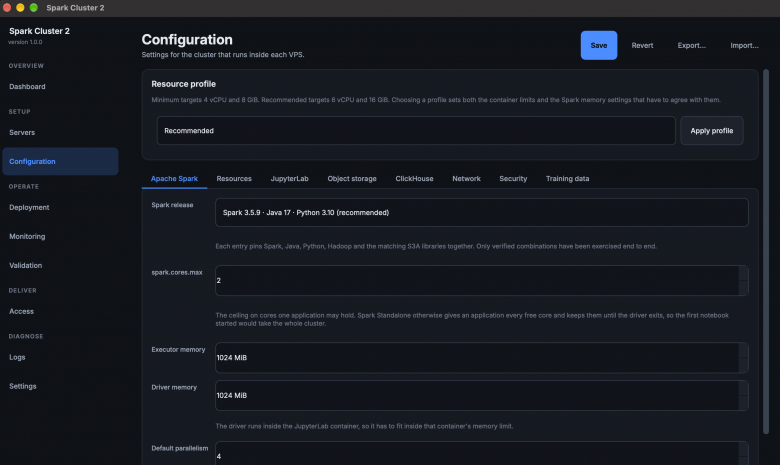
Для разработки Spark Cluster 2 я использовал Python и PySide6. Python оказался удобным выбором благодаря наличию библиотек для автоматизации, работы с удалёнными серверами и обработки конфигураций. PySide6 используется для создания графического интерфейса.
В первой версии проекта интерфейс был реализован на PyQt. При разработке второй версии я решил переработать приложение и перейти на PySide6. Одной из целей было создание более современного и удобного интерфейса, который позволял бы последовательно выполнять необходимые операции.
Приложение распространяется в виде готовых сборок для двух платформ:
Windows;
macOS на Apple Silicon.
Таким образом, пользователю не требуется самостоятельно устанавливать Python и зависимости проекта. Достаточно скачать приложение для своей операционной системы.
Какую инфраструктуру разворачивает Spark Cluster 2?
В состав учебного окружения входят несколько компонентов.
Apache Spark
Основной компонент инфраструктуры. Кластер включает управляющий узел Spark Master и два вычислительных узла Spark Worker. Такой подход позволяет познакомиться с работой Spark в кластерном режиме и наблюдать за распределением вычислительных задач.
ClickHouse
Аналитическая СУБД, которую можно использовать для выполнения практических заданий, связанных с обработкой и анализом данных. Её присутствие в учебном окружении позволяет знакомиться не только с Apache Spark, но и с другими инструментами аналитической инфраструктуры.
MinIO
Объектное хранилище, совместимое с S3 API. Оно позволяет организовать хранение наборов данных и использовать их при выполнении практических заданий. В результате пользователь получает небольшую инфраструктуру, включающую средства распределённой обработки, аналитическую СУБД и объектное хранилище. Все компоненты запускаются в Docker-контейнерах.
Это позволяет использовать заранее подготовленные конфигурации, упрощает сопровождение окружения и делает процесс развёртывания более воспроизводимым.
Как происходит развёртывание?
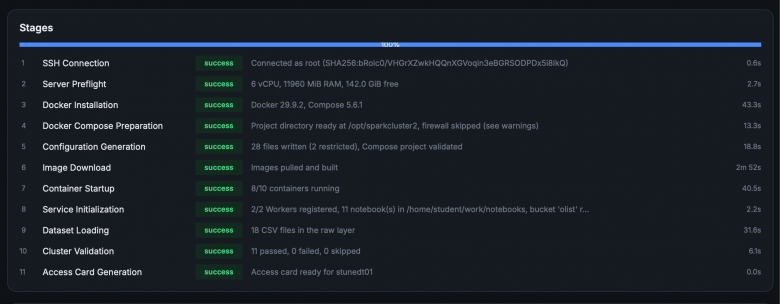
В общем виде процесс достаточно простой. Сначала пользователь подготавливает виртуальный сервер с подходящими характеристиками. Затем запускает Spark Cluster 2 и указывает необходимые параметры подключения. После этого приложение выполняет предусмотренные операции по подготовке инфраструктуры и развёртыванию компонентов кластера.
В результате на VPS формируется окружение, с которым можно работать в рамках учебных заданий. При этом само приложение работает на компьютере пользователя, а вычислительная инфраструктура размещается на удалённом сервере. Это позволяет разделить управление кластером и выполнение вычислительных задач.
Для студентов такой подход особенно удобен: не требуется устанавливать все компоненты Apache Spark непосредственно на собственный компьютер. Кроме того, использование VPS позволяет работать с относительно одинаковыми конфигурациями независимо от характеристик студенческих ноутбуков.
Что изменилось по сравнению с первой версией?
Вторая версия проекта – это не просто обновление интерфейса. Я также пересмотрел архитектуру учебного кластера. В первой версии приложения использовались четыре отдельных VPS:
Сервер |
Назначение |
|---|---|
VPS 1 |
Spark Master |
VPS 2 |
Spark Worker 1 |
VPS 3 |
Spark Worker 2 |
VPS 4 |
ClickHouse и MinIO |
Такая конфигурация позволяла получить действительно распределённую инфраструктуру с несколькими независимыми серверами. Однако при использовании приложения в учебном процессе обнаружились определённые сложности. Для группы из 20 студентов требовалось одновременно развернуть 80 виртуальных серверов.
В условиях ограниченной доступности вычислительных мощностей у некоторых российских VPS-провайдеров это оказалось не самой простой задачей. Я неоднократно сталкивался с ситуациями, когда у провайдера не было необходимого количества свободных серверов либо действовали ограничения на число VPS в одном аккаунте.
Дополнительной проблемой стала стоимость аренды. Поэтому при разработке Spark Cluster 2 я решил перейти к более простой архитектуре.
Теперь все компоненты учебного кластера размещаются на одном VPS с более производительными характеристиками.
Spark Master, два Workers, ClickHouse и MinIO запускаются в отдельных Docker-контейнерах. В результате для каждого студента требуется только один виртуальный сервер. Например, для группы из 20 человек теперь достаточно 20 VPS вместо 80.
Конечно, новый сервер должен обладать большим объёмом оперативной памяти и вычислительными ресурсами, чем отдельные небольшие VPS в первоначальной архитектуре. Кроме того, такая конфигурация имеет определённые ограничения. Поскольку все компоненты работают на одном хосте, речь идёт о логически распределённом кластере, а не об инфраструктуре из нескольких независимых физических узлов.
Однако для большинства вводных лабораторных работ по Apache Spark этого вполне достаточно. Студенты могут знакомиться с архитектурой кластера, наблюдать за распределением задач и выполнять практические задания. А преподавателю становится значительно проще организовать работу целой группы.
Почему я использую Docker?
В основе развёртывания лежит Docker. Для учебных проектов контейнеризация имеет несколько существенных преимуществ.
Во-первых, она позволяет стандартизировать окружение. Студенты получают одинаковые версии компонентов и сопоставимые конфигурации.
Во-вторых, упрощается повторное развёртывание инфраструктуры. Если возникли проблемы с отдельным компонентом, его можно пересоздать без необходимости полностью переустанавливать сервер.
В-третьих, контейнеры позволяют логически разделить компоненты кластера, даже если все они работают на одной виртуальной машине.
И наконец, Docker помогает уменьшить количество проблем, связанных с зависимостями и различиями между программными окружениями.
При этом важно понимать, что контейнеризация не устраняет ограничений физических ресурсов. Все компоненты используют процессор, оперативную память и дисковую подсистему одного VPS. Поэтому характеристики сервера необходимо подбирать с учётом предполагаемой нагрузки.
Какие требования к VPS?
Для небольшого учебного стенда можно ориентироваться на следующие характеристики:
Ресурс |
Ориентировочная конфигурация |
|---|---|
CPU |
4–8 vCPU |
RAM |
8–16 ГБ |
Диск |
60–100 ГБ SSD |
ОС |
Linux |
Контейнеризация |
Docker |
Конкретная конфигурация зависит от характера практических заданий и объёма обрабатываемых данных. Для знакомства с архитектурой Apache Spark и выполнения небольших вычислений требования могут быть относительно скромными. Для более ресурсоёмких задач потребуется увеличить объём оперативной памяти и количество виртуальных процессоров.
Важно также учитывать, что ClickHouse и MinIO используют часть ресурсов сервера. Отдельно отмечу, что аренда VPS не входит в состав приложения. Spark Cluster 2 автоматизирует подготовку инфраструктуры, но сам виртуальный сервер пользователь арендует у выбранного провайдера.
Не только приложение, но и учебные материалы
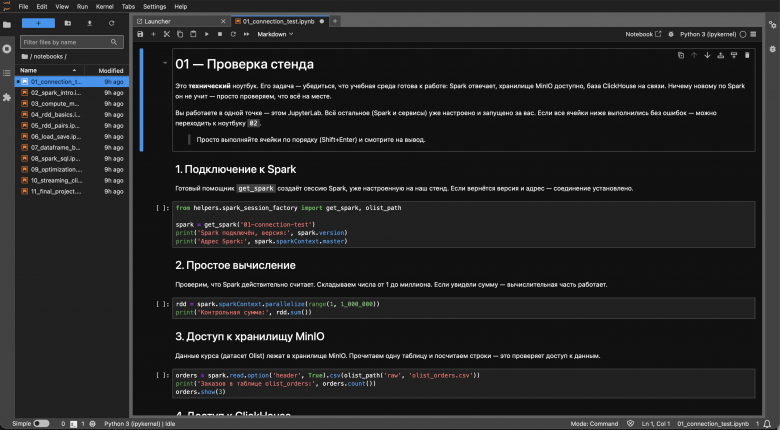
При разработке Spark Cluster 2 я решил не ограничиваться автоматизацией развёртывания. На мой взгляд, получение работающего кластера – только начало. Предположим, студент успешно развернул Apache Spark. Что делать дальше? Без соответствующей подготовки наличие работающей инфраструктуры само по себе не гарантирует понимания распределённых вычислений. Поэтому я решил дополнить проект учебными материалами.
Они предназначены для знакомства с Apache Spark и выполнения практических заданий на развёрнутом кластере. Таким образом, Spark Cluster 2 объединяет две составляющие.
Программную – приложение, которое помогает подготовить инфраструктуру.
Образовательную – материалы, позволяющие использовать эту инфраструктуру для изучения распределённой обработки данных.
В дальнейшем я планирую развивать обе составляющие проекта. Особенно интересно расширять набор практических заданий, чтобы студенты могли последовательно переходить от простых примеров к более сложным сценариям обработки данных.
Для кого предназначен Spark Cluster 2?
Первоначально приложение создавалось для использования в собственном учебном процессе. Однако постепенно стало понятно, что оно может быть полезно более широкой аудитории.
Преподавателям. Для организации лабораторных работ по Apache Spark, распределённым вычислениям и технологиям Big Data.
Студентам. Для самостоятельного развёртывания кластера и выполнения практических заданий.
Начинающим аналитикам и инженерам данных. Для знакомства с инфраструктурой распределённой обработки информации.
Разработчикам. Для создания небольших экспериментальных стендов и проверки различных сценариев работы с Apache Spark.
При этом я сознательно позиционирую Spark Cluster 2 прежде всего как образовательный инструмент. Для развёртывания промышленных кластеров существуют более специализированные решения, ориентированные на сложные инфраструктуры, масштабирование и обеспечение отказоустойчивости.
Моя задача несколько другая – сделать первоначальное знакомство с Apache Spark и организацию практических занятий максимально доступными.
Что планируется дальше?
Spark Cluster 2 — один из проектов, которые я развиваю в рамках Golubnichiy Technologies. В дальнейшем планирую совершенствовать интерфейс приложения, расширять возможности управления кластером и добавлять новые учебные материалы.
Отдельное направление – развитие инструментов диагностики и мониторинга.
Мне хотелось бы, чтобы приложение позволяло не только развернуть кластер, но и удобнее наблюдать за его состоянием, анализировать возникающие проблемы и контролировать использование вычислительных ресурсов.
Также рассматриваю возможность расширения набора поддерживаемых компонентов инфраструктуры. В целом мне интересна идея создания небольших специализированных программных продуктов для образования и анализа данных. Spark Cluster 2 стал очередным шагом в этом направлении.
Где скачать Spark Cluster 2?
Приложение распространяется в рамках проекта Golubnichiy Technologies. На данный момент доступны версии для Windows и macOS (Apple Silicon). Вместе с приложением предоставляются учебные материалы и инструкции по использованию.
Получить Spark Cluster 2 можно двумя способами:
по подписке Boosty уровня Superset Pro;
через разовую покупку без оформления подписки.
Скачать приложение с учебными материалами: Golubnichiy Technologies на Boosty
Другие проекты и инициативы в рамках проекта регулярно публикую в ТГ канале.
Буду рад обратной связи от преподавателей, студентов и специалистов, работающих с Apache Spark.
Особенно интересно узнать, какие возможности вы хотели бы видеть в подобном приложении и какие инструменты считаете наиболее полезными для организации практических занятий по распределённым вычислениям.
Спасибо за внимание!