

Певец держит одну ноту, а обработанный голос на мгновение перескакивает на октаву. Такое случается, когда плагин принимает сильную гармонику за основной тон. Чем быстрее коррекция, тем заметнее может стать этот промах.
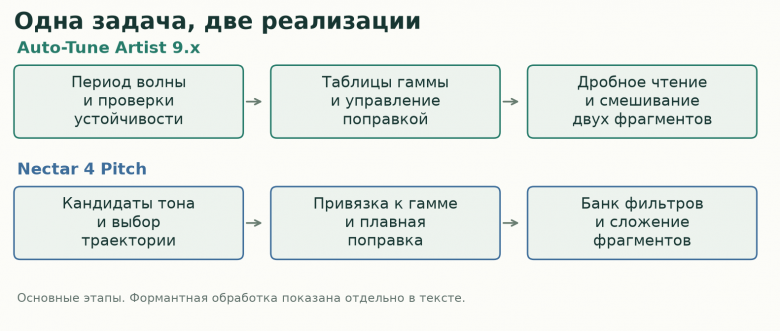
Разберу, как Auto-Tune Artist 9.x и модуль Pitch из Nectar 4 определяют высоту и что делают с волной после выбора ноты. Здесь есть интересные различия: как удержать оценку на ровном звуке, прочитать запись между сэмплами, перенести фрагмент без щелчка. На этих деталях и остановлюсь.
Для начала возьмём одну вокальную дорожку. С хором или аккордом задача была бы другой. Небольшие функции на C++ покажут отдельные расчёты, а пример на Python можно запустить целиком: он меняет высоту звука, сохраняя длину записи.
Как плагин находит ноту
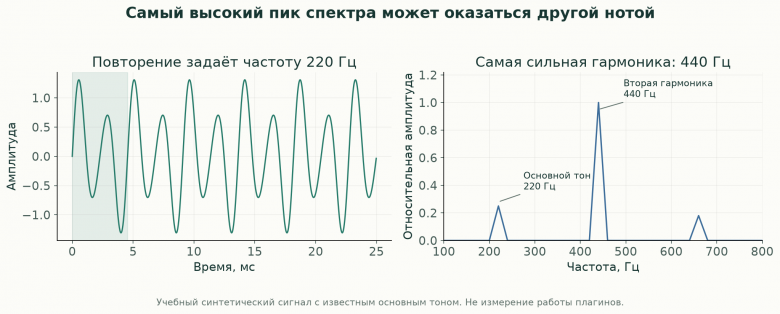
На протяжённом гласном голосовые складки колеблются почти периодически. На записи видно, как повторяется форма волны. Если повторений 220 в секунду, основной тон равен 220 Гц. На каждое приходится около 4,55 мс. Это время называется периодом.
В звуковом файле хранятся отдельные значения волны, сэмплы. При частоте записи 48 кГц их 48 000 на секунду. Наш период займёт 48 000 / 220 ≈ 218,18 сэмпла. Граница повторения вполне может попасть между двумя значениями; к этой дробной части ещё вернёмся.
Помимо основного тона в звуке есть гармоники, колебания с кратными частотами. Для 220 Гц это 440, 660, 880 Гц и дальше. На спектре видна сила каждой составляющей. Гармоника на 440 Гц может оказаться громче основного тона, поэтому самый высокий пик не обязательно укажет на спетую ноту. Именно так и получается ошибка на октаву.
На рисунке ниже основная частота равна 220 Гц, а амплитуда второй гармоники вчетверо больше первой. На спектре она доминирует. Полная форма волны при этом повторяется с частотой 220 Гц.
Период можно искать непосредственно в записи. Детектор сравнивает волну с её сдвинутой копией: при сдвиге на полный период похожие участки накладываются друг на друга. Остаётся измерить, насколько хорошо они совпали, и выбрать подходящий сдвиг. Сильная гармоника при таком сравнении тоже может сбить оценку, поэтому одного совпадения недостаточно.
Хороший разбор этого способа есть в статье о YIN. Авторы подробно объясняют, как измерять несовпадение и выбирать период. Ниже понадобятся похожие операции сравнения; это не утверждение, что Auto-Tune использует YIN.
Auto-Tune уточняет период между сэмплами
В детекторе Auto-Tune для такого сравнения накапливаются квадраты отсчётов и произведения исходной волны на сдвинутую. За этим стоит знакомое равенство: (x - y)² = x² + y² - 2xy. Чем лучше совпали две волны, тем меньше их разность.
Вернёмся к периоду 218,18 сэмпла. Если оставить только 218 или 219, часть точности потеряется. Auto-Tune берёт найденную точку и двух её соседей, проводит через них параболу и уточняет, где находится вершина. Этот небольшой шаг выглядит так:
#include <algorithm>
#include <cmath>

// left, center, right: ошибка совпадения на соседних сдвигах.
double refinePeriod(double left, double center, double right, int lag) {
    const double bend = left - 2.0 * center + right;
    if (std::abs(bend) < 1e-12) return lag;
    const double offset = 0.5 * (left - right) / bend;
    return lag + offset;
}
На вход refinePeriod подаются целый сдвиг lag и три значения ошибки вокруг найденного минимума. Результат имеет те же единицы, но уже содержит дробную поправку offset. Если парабола почти плоская, функция оставляет целый сдвиг. В полном детекторе результат ещё проверяется на допустимость и переводится в масштаб исходной частоты дискретизации.
Эта функция только уточняет найденный период. До неё нужны фильтрация входа, поиск и пороговые проверки; после неё оценки можно обработать медианным фильтром. Например, из 220, 440 и 221 он выберет 221: после сортировки это среднее по положению значение. Так одиночный ошибочный скачок на 440 не уводит результат на октаву.
Детектор также должен уметь отказаться от ответа. У протяжённого «а» обычно есть устойчивый период. У «ш» его может не быть. Придуманная на этом месте нота способна испортить согласную ещё до того, как синтезатор начнёт менять высоту.
Nectar выбирает последовательность оценок
Nectar 4 использует FFT, быстрое преобразование Фурье, в расчёте периодичности. Оно переводит сигнал в частотное представление. Дальше движок сохраняет несколько возможных оценок высоты и ищет среди них последовательность, согласующуюся с соседними участками записи.
Вернёмся к ошибке с октавой. Певец держит 220 Гц, но в одном коротком фрагменте детектор отдаёт предпочтение 440 Гц. Изолированное решение даёт скачок вверх и обратно. У Nectar остаётся другой кандидат, около 220 Гц, и он может выиграть за счёт соседних оценок. Для этого и нужна история.
При выборе пути движок складывает стоимость предыдущих решений с оценкой текущего кандидата и штрафом за переход. Чем меньше получившееся число, тем лучше путь. Вот расчёт для одной пары кандидатов:
// pos: частота в логарифмической шкале движка; local: его локальная оценка.
float candidateCost(float prevPos, float curPos, float prevLocal,
                    float curLocal, float prevCost) {
    float distance = prevPos - curPos;
    distance = distance * distance;
    float weight = (prevLocal + curLocal) * -0.5f;
    weight = weight + 1.01f;
    return curLocal + (prevCost + distance * weight);
}
Функция candidateCost сравнивает предыдущую частоту prevPos с текущей curPos. Обе записаны в логарифмической шкале движка. Чем дальше они друг от друга, тем больше квадрат расстояния. prevCost переносит накопленную стоимость, а параметры local содержат внутренние оценки кандидатов. Переводить их в проценты уверенности нельзя.
Для каждой текущей оценки проверяются разрешённые варианты из предыдущего шага. Выбирается переход с наименьшей стоимостью, и движок запоминает, откуда он пришёл. По этим отметкам потом можно восстановить весь путь. Чтобы числа не росли бесконечно, из всех накопленных стоимостей вычитается общий минимум. На выборе лучшего варианта это не сказывается.
В одном из режимов Nectar история содержит 14 шагов по 110 кандидатов. Поиск предшественников идёт в кольцевом окне ±8 позиций, то есть до 17 вариантов для кандидата. Размеры истории зависят от режима. Четырнадцать шагов внутреннего анализа нельзя приравнивать к четырнадцати буферам звуковой программы.
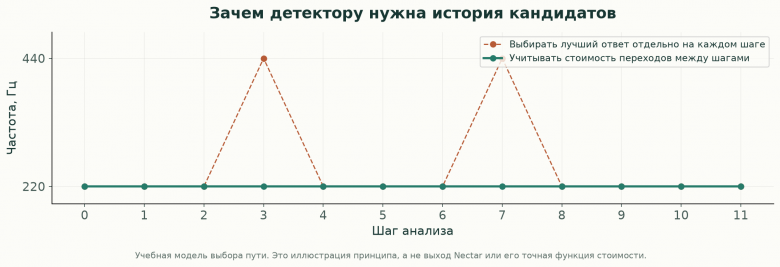
Самостоятельный пример работы с несколькими гипотезами есть в pYIN, 2014. Этот алгоритм получает кандидатов из YIN, назначает им вероятности и выбирает последовательность через скрытую марковскую модель и алгоритм Витерби. Общая идея состоит в том, чтобы сохранить альтернативные оценки до выбора траектории; это не означает, что Nectar использует именно pYIN.
Найденную частоту ещё нужно связать с музыкой
Плагин определил 430 Гц. Ближайшая привычная нота, ля, находится на 440 Гц, но подтягивать голос к ней нужно не всегда. Вокалист мог петь переход или намеренно отклониться от ноты. Решение зависит от заданной гаммы и режима коррекции. По одной частоте замысел певца не определить.
При выборе ближайшей ноты мажорной гаммы в Nectar частота сначала приводится к одной опорной октаве. Затем выбирается ближайшая разрешённая нота, после чего результат возвращается в исходную октаву. Сравнение идёт в логарифмах: для слуха одинаковые интервалы соответствуют одинаковым отношениям частот. Между 220 и 440 Гц такая же октава, как между 440 и 880.
Для положительной частоты freq и непустой таблицы разрешённых нот этот выбор можно записать так:
float snapToScale(float freq, const float* notes, int count) {
    const int octave = int(std::floor(std::log2(freq / notes[0])));
    const float scale = std::ldexp(1.0f, octave);
    const float folded = std::log(freq / scale);
    int best = 0;
    for (int i = 1; i < count; ++i)
        if (std::abs(folded - std::log(notes[i])) <
            std::abs(folded - std::log(notes[best]))) best = i;
    return scale * notes[best];
}
notes содержит частоты разрешённых нот одной опорной октавы, включая её верхнюю границу. Например, для до мажора это до, ре, ми, фа, соль, ля, си и следующее до. При входных 430 Гц ближайшей окажется ля 440 Гц.
В Auto-Tune выбор связан с подготовленными таблицами гаммы и банком периодов в управлении синтезом. Таблицы для Classic и Flex-Tune формируются раздельно. Выбор ноты связан с режимом коррекции: важно не только, какие ноты разрешены, но и как движок реагирует на приближение к ним.
Ошибка в гамме слышна даже при хорошем детекторе. Если певец намеренно берёт си-бемоль, а в разрешённых нотах оставили только до мажор, алгоритм начнёт тянуть его к си или ля. Он будет выполнять заданное ему правило.
Почему голос прилипает к ноте
Переход от 430 к 440 Гц требует множителя 440 / 430 ≈ 1,02326. В музыкальных единицах это 1200 × log₂(440 / 430) ≈ 39,8 цента. Сто центов составляют полутон.
Даже когда цель известна, до неё можно добраться резко или плавно. Nectar хранит текущую поправку в переменной glide. На каждом шаге она приближается к нужному значению, причём расчёт идёт в логарифмической шкале:
float correctionRatio(float detected, float snapped,
                      float amount, float coef, float& glide) {
    const float wanted = amount * (std::log(snapped) - std::log(detected));
    glide += coef * (wanted - glide);  // Состояние сохраняется между вызовами.
    if (std::abs(glide) < 1e-6f) glide = 0.0f;
    return std::exp(glide);           // От логарифма обратно к множителю.
}
Например, при coef = 0,25 первый шаг убирает четверть расстояния до цели. Следующий уберёт четверть того, что осталось. Так получается плавное подтягивание. amount задаёт величину желаемой коррекции, а экспонента в последней строке превращает логарифм обратно в множитель частоты. Крошечные остаточные значения обнуляются.
Если на каждом буфере обнулять glide, до нормального плавного движения дело не дойдёт. Поправка будет постоянно начинаться сначала.
В Auto-Tune для управления поправкой работают фильтры второго порядка, дополнительные состояния и условия, меняющие реакцию. Механизм Retune Speed поэтому не получится целиком заменить одной строкой сглаживания из примера Nectar.
Для музыканта различие проявляется в поведении на переходах и протяжённых нотах. В Auto-Tune Artist Retune Speed задаёт скорость коррекции, Flex-Tune позволяет оставлять больше отклонений при уходе от целевой ноты, Humanize помогает сохранить движение на длинных звуках. Назначения этих ручек описаны в руководстве производителя.
PSOLA меняет высоту короткими фрагментами
После выбора ноты нужно изменить саму запись. Простое ускорение поднимет высоту, но сократит фразу. Для вокального корректора это не подходит: слова должны остаться на своих местах в музыке.
PSOLA работает с короткими фрагментами записи, привязанными к периодам голоса. Полное название, Pitch-Synchronous Overlap-Add, описывает эту операцию: фрагменты сдвигают и складывают с перекрытием. Подход разобран в работе Мулина и Шарпантье. На постоянной ноте его можно показать без сложного детектора.
Найти метки. Для ровного звука 200 Гц волна повторяется каждые 5 мс. Отметим соответствующие места соседних повторений, например одинаковые характерные пики. В живом голосе расстояние между метками будет немного меняться.
Взять фрагменты. Вокруг каждой метки вырежем два периода: по 5 мс с каждой стороны. Края плавно ослабим до нуля. Такое ослабление называется окном. Оно нужно, чтобы резкое обрезание волны не создавало щелчок.
Расставить их заново. Для 300 Гц новые метки должны идти через 3,33 мс. В каждую новую позицию перенесём фрагмент примерно из того же места исходной записи. Некоторые фрагменты понадобятся повторно.
Сложить перекрытия. Пока один фрагмент затихает, соседний набирает амплитуду. Их сумма образует новую волну. Длительность всей записи остаётся прежней, а расстояние между повторениями становится другим.
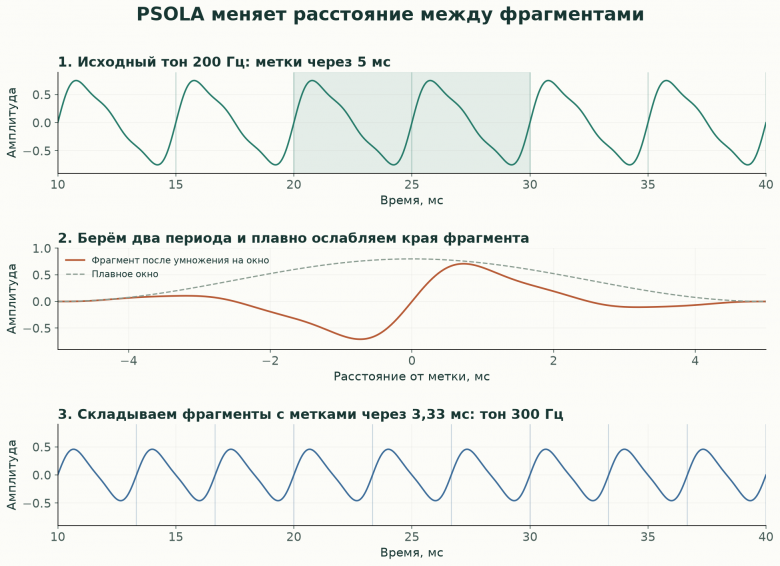
Это не повторение слов или слогов: перемещаются кусочки длиной в несколько миллисекунд. Для понижения высоты метки раздвигаются, и часть исходных фрагментов пропускается. Непериодические участки, например согласные, требуют отдельного обращения; один из вариантов описан в документации Praat.
Как склеить звук без щелчков
В Auto-Tune при смешивании двух фрагментов используются две позиции чтения звукового буфера. Буфер кольцевой: после его конца чтение продолжается с начала. Когда одну позицию нужно перенести к следующему фрагменту, выход плавно переключается между ними. Если сейчас вклад первого равен w, смешивание имеет вид first × w + second × (1 - w).
Сами позиции могут быть дробными. В одном из режимов Auto-Tune для чтения между отсчётами используются три соседних значения:
// fraction: дробное смещение от центрального отсчёта.
double readThree(float left, float center, float right, double fraction) {
    const double bend = 0.5 * double(left + right) - center;
    const double slope = 0.5 * double(right - left);
    return center + fraction * (slope + fraction * bend);
}
При нулевом смещении функция вернёт центральный отсчёт. Если позиция оказалась между соседями, значение даст парабола. Чтение перестаёт прыгать только по целым индексам. А от щелчка в момент переноса фрагмента защищает уже плавное смешивание двух чтений.
Nectar использует для дробного чтения полифазный фильтр. Название сложнее самой идеи: для разных положений между сэмплами заранее заготовлены разные наборы весов. Здесь таких положений 4096, обычно по 16 коэффициентов на каждое; у нулевой фазы 17.
Вместо оценки по трём соседям выходной отсчёт получается как взвешенная сумма более длинного участка. Сокращённый скалярный вариант:
struct Kernel {
    int base;            // Сдвиг к первому исходному отсчёту.
    int count;           // Число коэффициентов.
    const float* coef;   // Коэффициенты выбранного фильтра.
};

// bank: таблица фильтров; src: исходные отсчёты; pos: позиция чтения.
float readPolyphase(const float* src, double pos, const Kernel* bank) {
    const double shifted = pos + 0.5 / 4096.0;
    const int index = int(shifted);
    const int phase = std::min(4095, int((shifted - index) * 4096));
    const Kernel& filter = bank[phase];
    float sample = 0.0f;
    for (int k = 0; k < filter.count; ++k)
        sample += src[index - filter.base + k] * filter.coef[k];
    return sample;
}
Целая часть pos выбирает место в записи, дробная часть выбирает фильтр. Его коэффициенты говорят, с какими весами сложить соседние отсчёты. 4096 здесь означает число вариантов дробного положения, а не увеличение частоты записи в 4096 раз. Входной массив должен содержать и соседние отсчёты, которые читает фильтр. Сам банк коэффициентов передаётся готовым; функция показывает его применение.
На коэффициенты такого банка нужно около 256 КиБ: 4096 × 16 × 4 байта. Обработка 64 выходных отсчётов одного фрагмента обычным 16-точечным фильтром требует примерно 1024 умножений. Если одновременно звучат несколько фрагментов или обрабатываются два канала, эта работа повторяется.
Далее Nectar накладывает окно с нарастанием, ровной серединой и спадом. Для краёв используются таблицы по 1024 значения. Обработанные фрагменты складываются в выходном буфере, а позиция чтения сохраняется для следующего вызова.
Если включён режим целочисленного чтения с шагом 1 и фрагмент не пересекает границу буфера, ресэмплер может просто скопировать отсчёты. Вычислять каждый из них через фильтр на таком участке незачем.
В коде выше показан обычный цикл суммирования. В Nectar для macOS скалярное произведение вычисляет vDSP_dotpr из Apple Accelerate. Векторная функция может складывать произведения в другом порядке, чем простой цикл. Из-за округления последние разряды результата тогда отличаются, хотя математическая операция та же. Такое расхождение само по себе не говорит об ошибке определения ноты.
Почему после смены ноты должен сохраниться гласный
Можно спеть «а» низко и высоко, и оба раза это останется «а». Высота задаётся повторением колебаний, а звучание гласного зависит ещё и от резонансов глотки и рта. Они усиливают определённые области спектра. Эти области называют формантами.
При сдвиге всего спектра форманты тоже переместятся. Гласный изменит окраску: на сильном повышении может появиться характерный «мультяшный» голос. Чтобы сохранить привычный тембр, формантами приходится заниматься отдельно.
В Auto-Tune для этого используется LPC, линейное предсказание. Текущий отсчёт вычисляется по нескольким предыдущим; расхождение с настоящим значением образует остаток. Сначала из сигнала убирают оценённую спектральную огибающую. Высоту меняют у остатка, а затем восстанавливают огибающую фильтром синтеза. Так резонансы голоса можно обрабатывать отдельно от частоты повторения.
В коде ниже показаны вычитание предсказания и обратная операция. Расчёт коэффициентов LPC здесь опущен:
double removeEnvelope(double sample, const double* a,
                      const double* pastInput, int order) {
    for (int k = 0; k < order; ++k) sample -= a[k] * pastInput[k];
    return sample;
}

double restoreEnvelope(double residual, const double* a,
                       const double* pastOutput, int order) {
    for (int k = 0; k < order; ++k) residual += a[k] * pastOutput[k];
    return residual;
}
В a передаются коэффициенты модели. Первая функция получает прошлые отсчёты входа pastInput и возвращает остаток. Вторая берёт остаток и историю собственного выхода pastOutput, чтобы восстановить сигнал. Истории у этих фильтров разные; подставить в обе функции один массив прошлых значений не получится.
При обработке речи коэффициенты модели пересчитываются и плавно сменяются. Для включённой формантной обработки одна из конфигураций Auto-Tune задаёт порядок 50 при 48 кГц, 100 при 96 кГц и 200 при 192 кГц. Порядок показывает, сколько прошлых отсчётов участвует в предсказании. Удержание тембра при смене высоты поэтому требует дополнительного расчёта.
Короткий буфер не делает коррекцию мгновенной
При буфере 64 сэмпла и частоте записи 48 кГц обработчик получает новую порцию звука примерно каждые 1,33 мс. Один период низкого голоса 80 Гц длится 12,5 мс. В отдельном таком буфере не помещается даже один период, поэтому анализировать каждую порцию независимо не получится.
Nectar сохраняет историю кандидатов и накопленную поправку, а синтезатор продолжает чтение фрагментов с прежних позиций. В Auto-Tune между вызовами сохраняются оценки периода, состояния фильтров, история LPC и позиции синтеза. На границе буфера звук не начинается заново.
Поэтому состояние нужно хранить в экземпляре обработчика. Локальный массив внутри функции обработки исчезнет после вызова, и следующему блоку придётся начинать анализ с нуля. Нельзя без необходимости сбрасывать историю и при повороте ручки. Изменения из интерфейса передаются в звуковой поток согласованно, без тяжёлой перестройки во время обработки.
Retune Speed задаёт скорость подтягивания к ноте. Даже при мгновенном переходе к цели плагину нужно время на анализ и синтез, иногда с заглядыванием вперёд. Через какое время участок входной записи появится на выходе, определяет задержка обработки. Поворот ручки Retune Speed сам по себе не делает весь этот путь мгновенным.
У Auto-Tune Artist для этого есть отдельная настройка Use Low Latency. В руководстве её рекомендуют включать при живом мониторинге и выключать при сведении, когда приоритетом становится качество обработки. Компромисс между задержкой и качеством существует и внутри одного коммерческого продукта. Руководство Auto-Tune Artist.
В чём различаются реализации
Участок |
Auto-Tune Artist |
Nectar 4 Pitch |
|---|---|---|
Устойчивость оценки |
Проверки периода, уточнение, медианная обработка |
История кандидатов и выбор пути с минимальной стоимостью |
Управление поправкой |
Фильтры второго порядка, дополнительные состояния и условия |
Сглаживание логарифма поправки, затем экспонента |
Чтение между сэмплами |
Три соседних отсчёта в одном из режимов |
Полифазный банк из 4096 фильтров |
Стыковка фрагментов |
Плавное смешивание двух позиций чтения |
Нарастание, ровная середина и спад окна; сложение фрагментов |
В таблице сопоставлены основные механизмы; конкретное поведение зависит от режима. История нужна обоим корректорам: у Auto-Tune тоже сохраняются оценки периода, состояния фильтров и позиции чтения.
PSOLA целиком: от массива к новой высоте
Для опыта понадобятся Python 3 и NumPy. Создадим секундную запись: основной тон 200 Гц с двумя более слабыми гармониками. Функция получит известный период и целевую частоту 300 Гц. Детектора в ней нет, так что можно проверить именно перенос и сложение фрагментов.
В цикле q задаёт место, куда нужно положить фрагмент. Исходную метку p выбираем поблизости от этого места в записи. Если новые метки идут чаще прежних, некоторые исходные фрагменты используются повторно. Косинусное окно ослабляет края, а массив weight собирает сумму окон. Деление на неё в конце выравнивает уровень при перекрытии.
import numpy as np

def psola_tone(x, sr, f0, target):
    period = sr / f0
    marks = np.arange(period, len(x) - period, period)
    if len(marks) < 2:
        raise ValueError("Недостаточно исходных меток")
    y = np.zeros(len(x))
    weight = np.zeros(len(x))
    axis = np.arange(len(x))

    for q in np.arange(0.0, len(x), sr / target):
        p = marks[np.argmin(np.abs(marks - q))]
        left = max(0, int(np.ceil(q - period)))
        right = min(len(x), int(np.floor(q + period)) + 1)
        dst = np.arange(left, right)
        offset = dst - q
        window = 0.5 + 0.5 * np.cos(np.pi * offset / period)
        grain = np.interp(p + offset, axis, x)
        y[dst] += grain * window
        weight[dst] += window

    return np.divide(y, weight, out=np.zeros_like(y), where=weight > 1e-8)

sr = 48000
t = np.arange(sr) / sr
x = (np.sin(2 * np.pi * 200 * t)
     + 0.28 * np.sin(2 * np.pi * 400 * t)
     + 0.12 * np.sin(2 * np.pi * 600 * t))
y = psola_tone(x, sr, f0=200, target=300)
assert len(y) == len(x)

spectrum = np.abs(np.fft.rfft(y * np.hanning(len(y))))
peak_hz = np.argmax(spectrum) * sr / len(y)
print(f"Сэмплы: {len(x)} -> {len(y)}")
print(f"Пик спектра: {peak_hz:.0f} Гц")
Вывод при запуске:
Сэмплы: 48000 -> 48000
Пик спектра: 300 Гц
В этой проверке частота меняется с 200 до 300 Гц, а длительность остаётся равной одной секунде. Спектральный максимум здесь совпадает с основным тоном благодаря устройству выбранного сигнала. Для произвольного голоса брать самый сильный пик нельзя, как показано в начале статьи.
Функция рассчитана на постоянный известный период. Для вокала нужны меняющиеся метки, обработка согласных и переходов между нотами. В коммерческом корректоре именно эти решения связывают определение тона, музыкальную цель и пересборку звука в непрерывную обработку.
При отладке я бы выводил отдельно найденную частоту, выбранную ноту и поправку. Тогда видно, на каком этапе началась ошибка. Скачок оценки на октаву возвращает нас к детектору и сильной гармонике. Верная оценка с неверной целью указывает на музыкальные настройки. Если обе частоты в порядке, а на выходе щёлкает, проверять нужно синтез: метки, окна, сохранение позиций на стыке буферов.
Что уже есть в открытом коде
У разработчика есть и готовые открытые реализации. Сначала стоит разобраться, что именно даёт проект. У автокорректора уже есть детектор и выбор ноты. Библиотека изменения высоты может принимать только заданный множитель: остальные решения придётся написать самому.
Решение |
Что уже умеет |
Основной компромисс |
|---|---|---|
Автоматическая коррекция одноголосного сигнала, автокорреляционный детектор, пересборка по периодам, работа с формантами |
Плагин LADSPA; автор указывает теоретический минимум задержки 43 мс при 48 кГц |
|
Коррекция голоса по разрешённым нотам или MIDI, управление силой коррекции и сглаживанием |
Приложение для звукового сервера JACK; формантная коррекция отсутствует |
|
Изменение высоты и длительности, режимы сохранения формант, потоковый API |
Это вычислительная библиотека; определение ноты и выбор музыкальной цели нужно добавить отдельно |
Autotalent позволяет изучить корректор целиком, от определения тона до выхода. В описании названы автокорреляция и сложение фрагментов, синхронное с периодом. То есть похожая основа есть и в открытом плагине. Разницу в звуке придётся искать в деталях обработки, а по одному слову PSOLA выбрать победителя нельзя.
Zita-AT1 показывает другой компромисс. Его руководство указывает обычную задержку около 21 мс и примерно вдвое меньшую в режиме Low Latency. При этом данные о высоте становятся примерно на 10 мс старше звука, к которому применяется поправка. На ровной ноте это может работать хорошо; на быстром переходе устаревшая оценка способна помешать. Автор рекомендует небольшие исправления высоты, поскольку сохранения формант нет. Руководство Zita-AT1.
Rubber Band удобнее рассматривать как основу синтеза. Например, его движок R2 использует фазовый вокодер: обработку частотных составляющих и их фаз. Это другой подход к изменению времени и высоты, чем короткий пример PSOLA выше. Вокальный автокорректор поверх такой библиотеки всё равно должен сам решить, какую ноту человек поёт и куда её направить. Техническое описание R2.
При выборе Rubber Band важно различать интерфейсы и настройки. Для RubberBandStretcher документация приводит типичную начальную задержку R2 с коротким окном в 512 сэмплов, около 10,7 мс при 48 кГц. У R3 с коротким окном указано 1280 сэмплов, около 26,7 мс. А для отдельного интерфейса RubberBandLiveShifter документация предупреждает о задержке от 50 мс в зависимости от конфигурации. Поэтому обещание «Rubber Band даст такую-то задержку» без названия API и режима мало что значит. Задержки Stretcher, описание LiveShifter.
Это значения из документации разных инструментов, а не результаты одного сравнительного теста. Они не включают весь путь от микрофона до наушников. Но уже по ним видно, что открытая реализация может быть рассчитана и на небольшую задержку, и на более сложную обработку с заметным ожиданием.
Что лучше и для какой задачи
Для живого пения я бы сначала смотрел на Auto-Tune Artist. В нём можно отдельно настроить скорость подтягивания ноты, реакцию на длинные звуки и сохранение свободной интонации. Для мониторинга есть Use Low Latency. Такой набор хорошо подходит, когда коррекция становится частью исполнения. Назначение и настройки Auto-Tune Artist.
При обработке вокала в миксе у Nectar есть практическое удобство: рядом с Pitch находятся эквалайзер, компрессоры, деэссер и пространственные эффекты. Цепочку можно собрать внутри одного плагина. Это экономит переключения между окнами, хотя качество самой коррекции всё равно придётся оценивать на записи. Состав Nectar 4.
Для своего инструмента я бы выбирал основу по тому этапу, который предстоит менять. У Autotalent можно изучить всю цепочку. У Zita-AT1 интересен компромисс с задержкой оценки. Rubber Band подойдёт, если нужен механизм изменения высоты, а детектор и правила коррекции будут собственными. Сравнивать эти проекты как взаимозаменяемые плагины было бы ошибкой.
Если сравнивать только дробное чтение одной позиции, трёхточечная интерполяция требует меньше арифметики, чем фильтр на 16 коэффициентов. Более длинный фильтр позволяет иначе спроектировать частотную характеристику. Ни одно из этих наблюдений не определяет качество всего корректора: на него влияют и метки, и переходы, и форманты, и ошибки детектора.
Естественность звучания стоит сравнивать на одинаковых записях, при сопоставимых настройках и слепом прослушивании. Большое число коэффициентов ещё не гарантирует лучший результат. Сильная гармоника, неверно принятая за основной тон, испортит ноту даже после самого аккуратного синтеза.
Научные статьи для продолжения
Moulines E., Charpentier F. Pitch-synchronous waveform processing techniques for text-to-speech synthesis using diphones. Speech Communication, 1990, 9:453-467. Классическая работа о синхронной с периодами обработке, изменении высоты и длительности речи.
de Cheveigné A., Kawahara H. YIN, a fundamental frequency estimator for speech and music. JASA, 2002, 111(4):1917-1930. Подробное объяснение оценки основного тона, нормировки критерия и борьбы с ошибками периода.
Mauch M., Dixon S. pYIN: A fundamental frequency estimator using probabilistic threshold distributions. ICASSP, 2014, 659-663. Пример алгоритма, который сохраняет несколько кандидатов высоты и выбирает последовательность с учётом времени.
Комментарии (2)

CitizenOfDreams
27.10.2026 01:37Певец держит одну ноту
Это какой-то продвинутый певец старой школы, современные такого уже не умеют.
Ponkratov_expert
Благодарю, интересно, только пока сложновато для меня. Буду разбираться.