

История о том, как реализовать надежный протокол поверх ненадежного UDP: скользящее окно, SACK, чексумма и почему при потерях сеть внезапно заработала быстрее
Зачем вообще писать свой RDT-протокол? Каждый джун знает, что TCP у нас «надежный, но медленный», а UDP — «быстрый, но ненадежный». Но это очень поверхностные знания, которые не раскрывают всего масштаба происходящего под капотом. И как раз недавно я задался вопросом: а почему бы не попытаться повторить TCP? Амбициозная цель: приблизить своё детище к работе TCP, поработить мир и захватить умы человечества, объединив всех в единый организм… Кхм, ну что-то типа того.
Получилось ли у меня? Захватить мир — пока нет, а вот добиться надежной доставки данных через ненадежную сеть с потерями, порчей данных, дублированием, задержками и так далее — более чем. Так что хочу рассказать свою историю о том, как я писал это чудо, с чего начинал, с какими проблемами столкнулся и как пришел к рабочему варианту протокола: с поддержкой скользящего окна, SACK, таймаутов, флагов и прочих прелестей, которые я подглядел в архитектуре TCP. Протокол прошел краш-тест с 30% потерь в сети и смог передать данные байт-в-байт, правда, с нюансами, о которых расскажу дальше :)
Анатомия заголовка и первый запуск
Начал с рутины: написал Makefile, накидал базовую структуру каталогов, санитайзеры и прочую чепуху для slay boys. Сам протокол решил назвать Protocol-7 (P7). Почему так? Потому что: Let’s all love Lain!
Первой моей целью стало передать хоть что-то и хоть как-то, используя UDP. Для этого я по-быстрому накидал простую логику для создания сокета и отправки сырого текста, попутно, конечно, не забыв налажать с порядком байт (забыл про htons) и некоторое время промучавшись с тем, что мой чудесный порт 6767 упорно не открывался. Исправив это недоразумение, я наконец получил свой первый вывод:
# Терминал 1:
[I] [cortex@thinkpad ~/c/protocol-7]$ ./protocol7 -s
debug send: Hello from sender

# Терминал 2:
[I] [cortex@thinkpad ~/c/protocol-7]$ ./protocol7 -r
debug recv: Hello from sender
Казалось бы, на этом можно и закончить, но это был только первый шаг в пыточную…
Очевидно, что передавать захардкоженный текст — такая себе идея. Нужно отправлять полноценный файл и корректно собирать его на другой стороне. Читать файл на отправителе не составило особых проблем, а вот записывать пришедшие куски данных оказалось немного сложнее: дело в том, что получатель крутится в бесконечном цикле, принимая сегменты данных и складывая их в открытый файл. Но вот беда: а как получателю понять, что это конец данных и файл для записи можно закрывать? А никак, ха-ха! Так что на этом этапе я временно решил перенаправить поток данных просто в stdout (вывод терминала), без записи на диск.
Имея в руках такое нововведение, я принялся тестировать передачу файла и вывод данных на получателе. Отправляю  ничего не происходит. Проверяю
tcpdump тишина. Промучавшись минут 15, я внезапно осознал, что… пытался отправить пустой файл, лол.
Первый заголовок
Понятно, что на чистом UDP далеко не уедешь: как только начнутся проблемы в сети, UDP-датаграмма просто потеряется и всё — никакой надежности блин. Так что я принялся планировать, каким именно образом буду обеспечивать эту самую надежность. Ну и какой протокол без заголовка? Это первое, о чем стоит подумать: не только чтобы почувствовать себя крутыми сетевыми инженерами, но и чтобы строить вокруг этих данных базовую логику.
Вдохновившись заголовком TCP, я взял то, что посчитал нужным на данном этапе, и, не побоюсь этого слова, спроектировал вот это чудо современной инженерии:
.0                   1                   2                   3
 0 1 2 3 4 5 6 7 8 9 0 1 2 3 4 5 6 7 8 9 0 1 2 3 4 5 6 7 8 9 0 1
+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+
|                            seq_num                            |
+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+
|                            ack_num                            |
+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+
|     flags     |           checksum            | Padding (0x00)|
+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+
Да, всё по канонам RFC, всё-таки мы тут серьезными вещами занимаемся, хахаха))
seq_num (4 байта)
Первый и очень важный вопрос, которым я задался при проектировании: а как нумеровать сегменты? Понятно, что нумерация нам жизненно необходима, иначе как получатель поймет, в каком порядке склеивать наши огрызки данных, если они прилетели вразнобой (а такое в сети сплошь и рядом).
Первое, что приходит на ум: нумеровать сегменты по порядку — «сегмент 1», «сегмент 2» и так далее. Просто? Да. Но пахнет плохо. Почему? Если я захочу разбить поток на сегменты разного размера, простая нумерация пакетов превратится в адскую боль. Поэтому я подсмотрел просветление у деда TCP: там используется нумерация смещением байтов (byte-offset), а не номерами самих сегментов.
Чё это такое?
Каждый байт в потоке данных имеет свой порядковый номер. Если файл весит 10 000 байт, то первый сегмент пойдет со смещениемseq_num = 0, а второй — сразу сseq_num = 1400(если в первом сегменте улетело ровно 1400 байт полезной нагрузки), и так далее.
В чем профит?
Получателю вообще плевать, как и какими кусками к нему прилетели данные. Он просто смотрит на номер смещения и точно знает, в какую именно позицию файла положить этот огрызок. Получается ничего себе настоящий «поток данных», да?
ack_num (4 байта)
С seq_num понятно, а как узнать, что получатель жив и вообще что-то принял?
Можно, конечно, используя телепатию, считывать электрические импульсы прямо с процессора получателя, но я пока не освоил этот навык, так что довольствуемся классикой: получатель будет слать в ответ ACK-сегменты, где ack_num — это порядковый номер байта, который он ожидает получить следующим.
Получили сегмент с seq_num = 0 и полезной нагрузкой 1400 байт отправляем обратно ACK, в котором указываем: «жду 1400-й байт» (ack_num = 1400). Впрочем, в TCP это работает ровно так же.
Флаги (1 байт / 8 бит)
У нас их всего 4: ACK, SYN, FIN, RST. Остальные 4 бита остаются в резерве на случай добавления флага ЛГБТ или Доминиканской Республики.
Чексумма (2 байта)
С потерями сегментов разобрались, но что, если пакет дошел, а по пути космическая радиация инвертировала случайный бит? Нужна проверка целостности.
Эту проблему решает контрольная сумма. Шарящие гении сразу скажут мне: «А ничё, что в UDP есть своя чексумма, нафига делать еще одну?». Да, но есть пара уточнений:
Я хочу свою.
В UDP чексумма опциональна (для IPv4), лол. Согласно RFC 768: «Переданное значение контрольной суммы, состоящее из одних нулей, означает, что передатчик не генерировал контрольную сумму». Так что чексумму обязательно делаем свою, а вот как именно она будет работать — разберемся чуть позже.
Что за паддинг в конце заголовка?
Просто заполнил оставшееся свободное место нулями (0x00), чтобы структура красиво выравнивалась в памяти по 4-байтовой границе :)
Где поле длины данных?
Его нет. Протокол на данном этапе не поддерживает опций, заголовок строго фиксирован (12 байт), а значит длина полезных данных элементарно вычисляется получателем:.
Где порт и IP-адрес отправителя?
В TCP-заголовке есть поля портов, но я решил брать эту информацию прямо из заголовка UDP-датаграммы через параметры сокета, чтобы не дублировать байтики зря.
Фиксим запись в файл + FIN-флаг
Напоминаю, что на этом этапе наш получатель крутится в бесконечном цикле и понятия не имеет, что передача данных закончена. Для решения этой проблемы я прикрутил проверку FIN-флага: получатель видит его в заголовке, закрывает файл, освобождает ресурсы и спокойно завершает работу. Примитивно, временно, но спасает и позволяет нормально сохранить данные на диск.
А вот на стороне отправителя началась настоящая акробатика.
Идея отправлять FIN отдельным пустым сегментом отпала сразу: тратить целый RTT ради одного бита в пустом сегменте — это расточительство и непозволительная роскошь. Поэтому я решил делать по-взрослому через piggyback-FIN («свиной зад», чё? ахаха). Проще говоря: FIN-флаг должен лететь «верхом» прямо на последнем куске полезных данных.
И тут вскрылась проблемка: а как во время чтения файла заранее понять, что текущий чанк — абсолютно последний?
Стандартный fread в Си устроен коварно: он сообщает о конце файла (EOF), только когда ты пытаешься прочитать следующий кусок, а функция возвращает тебе 0. Если делать в лоб, получается беда: отправляешь кусок данных, читаешь следующий чанк, видишь 0 байт (файл кончился!)… и остаешься у разбитого корыта: отправлять больше нечего, а последний сегмент уже улетел без FIN-флага. В итоге ты всё равно вынужден слать пустой сегмент ради несчастного одного бита.
Я обыграл эту проблему через особую технику чтения (look-ahead) с двойным буфером: читаем чанк в первый буфер, меняем указатели местами, читаем во второй, отправляем первый буфер, снова меняем, и так далее.
В итоге мы всегда на шаг впереди: пока в сети летит текущий сегмент, мы уже заранее знаем результат чтения следующего куска. Если там EOF — взводим FIN-флаг прямо перед отправкой. Красиво? Красиво!
// Сердце нашего двойного буфера и look-ahead чтения while ((bytes_read = fread(current + P7_HEADER_SIZE, 1, P7_MSS, fp)) > 0) { swap_ptr(¤t, &previous); // На первом шаге просто заполняем первый буфер и ждем второй if (is_previous == 0) { previous_bytes_read = bytes_read; is_previous = 1; continue; } // Отправляем предыдущий сегмент, зная, что за ним точно есть еще данные p7_serialize_header(&header, previous, P7_HEADER_SIZE + P7_MSS); sendto(sock_fd, previous, P7_HEADER_SIZE + previous_bytes_read, 0, ...); previous_bytes_read = bytes_read; } // Если цикл завершился, проверяем feof: текущий (previous) буфер - абсолютно последний if (feof(fp)) { header.flags = (1 << 3); // Взводим FIN-флаг p7_serialize_header(&header, previous, P7_HEADER_SIZE + P7_MSS); sendto(sock_fd, previous, P7_HEADER_SIZE + previous_bytes_read, 0, ...); }
Теперь последний сегмент уходит как надо:
--- HEADER ---
00 00 00 00 00 00 00 00 08 00 00 00
                         ^
                     00001000 (FIN-флаг)

--- PAYLOAD ---
49 66 20 79 6f 75 20 64 65 63 6f 64
65 20 74 68 69 73 20 68 65 78 2c 20
79 6f 75 20 61 72 65 20 61 77 65 73
6f 6d 65 21 20 3a 29 0a
Как видим, бит, отвечающий за FIN-флаг, активен (0x08), а в полезной нагрузке (payload) лежат реальные данные!
Наживаем себе проблемы и решаем их
Все мы любим localhost, и мой протокол любит localhost, потому что, в отличие от реальной сети, localhost не теряет пакеты, не портит их и не дублирует. А как решать проблемы, которых нет? Создать проблемы самому!
Для этого я написал небольшой прокси-сервер на Python, который принимает пакеты на одном порту, рандомно теряет часть из них, а уцелевшие исправно пересылает на порт реального получателя (и точно так же в обратную сторону). Теперь в терминале можно наблюдать суровую сетевую реальность:
[PROXY] Server running on 127.0.0.1:5656 to 127.0.0.1:6767 with drop mode...
[DROP] #1 (1472 bytes) 127.0.0.1:40600 -> X
[DROP] #2 (1472 bytes) 127.0.0.1:40600 -> X
[PROXY] #3 (92 bytes) 127.0.0.1:40600 -> 127.0.0.1:6767
[I] [cortex@thinkpad ~/c/protocol-7]$ diff test.txt out.txt -q
Files test.txt and out.txt differ
[I] [cortex@thinkpad ~/c/protocol-7]$ wc -c test.txt out.txt
3000 test.txt
  80 out.txt
3080 total
Как видно, мы пытались отправить 3000 байт данных, но первые 2 сегмента по 1472 байта потерялись, и до получателя долетел только финальный сегмент на 92 байта (из которых полезных данных всего 80 байт, а остальные 12 байт — заголовок).
SeqNum и ACK
Для решения проблемы потерь необходимо, чтобы получатель отправлял подтверждения (ACK) на каждый успешно принятый сегмент (а если не принял — просто молчал). А чтобы отправитель понимал, на какой именно кусок данных прилетел ответ, сегменты нужно нумеровать.
Так что первым делом я реализовал заполнение полей seq_num и ack_num:
При отправке выставляем
seq_numв текущее локальное смещение байт.На стороне получателя при приеме куска данных отправляем обратно ACK-сегмент, где
ack_num = seq_num + payload_len(то есть подтверждаем всё, что получили, и запрашиваем следующий байт).Отправитель, получив валидный
ack_num, сдвигает локальныйseq_numи отсылает следующую порцию.
«Гениальный» затуп случился, когда я поздней ночью сел писать отправку ACK с получателя. По какой-то неведомой причине я решил, что клиенту-отправителю нужен отдельный фиксированный порт, чтобы принимать входящие ACK-пакеты. Но занять тот же порт, что и сервер, клиент на одной машине не может — порт уже занят.
Решение пришло когда я сидел в tcpdump и глядя на логи, вспомнил, что, хотя я и не вызываю bind() на клиенте, операционная система всё равно автоматически выделяет ему случайный эфемерный порт, и этот же порт исправно подставляется в UDP-заголовок датаграммы. В итоге серверу достаточно просто слать ответы обратно на тот IP и порт, откуда пришли данные. Так я получил классическую честную логику Stop-and-Wait:
23:45:11.982846 IP 127.0.0.1.33226 > 127.0.0.1.6767: UDP, length 1472
23:45:11.982946 IP 127.0.0.1.6767 > 127.0.0.1.33226: UDP, length 12
23:45:11.991081 IP 127.0.0.1.33226 > 127.0.0.1.6767: UDP, length 1472
23:45:11.991148 IP 127.0.0.1.6767 > 127.0.0.1.33226: UDP, length 12
23:45:11.999487 IP 127.0.0.1.33226 > 127.0.0.1.6767: UDP, length 92
23:45:11.999584 IP 127.0.0.1.6767 > 127.0.0.1.33226: UDP, length 12
А сам ACK-сегмент (ровно 12 байт заголовка без полезной нагрузки) выглядит в шестнадцатеричном дампе так:
--- HEADER ---
00 00 00 00 00 00 0b b8 02 00 00 00
                    ^    ^
        2 байта ack_num  |
        (0x0bb8 = 3000)  |
                       0010 -> флаг ACK

--- PAYLOAD ---
# Пустое тело
Логи
Объем кодовой базы постепенно рос, и протоколу потребовались нормальные человекочитаемые логи, чтобы не переводить в уме огромные hex-дампы на каждый чих. Поскольку мы пишем сетевой протокол, критически важно видеть точное время отправки и получения каждого сегмента — причем не просто часы и минуты, а тайминги с точностью до миллисекунд!
В Си форматирование времени с миллисекундами — это отдельный сорт удовольствия, поэтому пришлось набросать вот такого монстра:
void p7_log_segment(void) {
  struct timespec ts;
  clock_gettime(CLOCK_REALTIME, &ts);
  struct tm *t = localtime(&ts.tv_sec);
  char time_buffer[32];
  strftime(time_buffer, sizeof(time_buffer), "%H:%M:%S", t);
  int milliseconds = (int)(ts.tv_nsec / 1000000);
  char full_time_buffer[40];
  snprintf(full_time_buffer, sizeof(full_time_buffer), "%s.%03d", time_buffer,
           milliseconds);
  fprintf(stderr, "[%s] Test\n", full_time_buffer);
}
Дописав к этому делу аккуратный вывод флагов, номеров смещений и адресов, я наконец получил красивейшую картину:
[18:55:13.799] SEND  DATA     seq=0        size=1472  flags=----  -> 127.0.0.1:5656
[18:55:13.809] RECV  ACK      ack=1460     size=12    flags=A---  <- 127.0.0.1:5656
[18:55:13.809] SEND  DATA     seq=1460     size=1472  flags=----  -> 127.0.0.1:5656
[18:55:13.818] RECV  ACK      ack=2920     size=12    flags=A---  <- 127.0.0.1:5656
[18:55:13.818] SEND  FIN      seq=2920     size=92    flags=--F-  -> 127.0.0.1:5656
[18:55:13.818] RECV  ACK      ack=3000     size=12    flags=A---  <- 127.0.0.1:5656
[Sender] Success file transfer!
Конкретно это — пример лога на отправляющей стороне. Думаю, формат интуитивно понятен и не нуждается в подробном разборе каждого столбца :)
Ретрансмиссии и таймеры
Несмотря на то что клиент теперь знает, когда сервер успешно получил его сегмент, он всё еще понятия не имеет, что делать, если сервер сегмент НЕ получил. Представим, что мы — клиент: отправили сегмент, ждем ACK от сервера, проходит  миллисекунд, а в ответ тишина. Логично предположить, что пакет помер по дороге, а значит, его нужно просто переотправить!
Обдумав, как на этом этапе проще всего реализовать таймер, я пришел к очевидному решению: SO_RCVTIMEO — это стандартная опция сокета, которая задает максимальный таймаут ожидания на вызов recvfrom().
Логика получилась предельно линейной:
Отправляем сегмент
ждем ACK в recvfrom().Если сработал таймаут
переотправляем сегмент заново.Если же ACK благополучно пришел вовремя
сервер всё сохранил, и можно переходить к отправке следующего куска.
После исправления всех мелких шероховатостей я получил в терминале вот такой классический ретрай:
[20:33:51.292] SEND  DATA     seq=0        size=1472  flags=----  -> 127.0.0.1:5656
[20:33:52.312] RETR  DATA     seq=0        size=1472  flags=----  -> 127.0.0.1:5656
[20:33:53.325] RETR  DATA     seq=0        size=1472  flags=----  -> 127.0.0.1:5656
[20:33:54.339] RETR  DATA     seq=0        size=1472  flags=----  -> 127.0.0.1:5656
[20:33:55.355] RETR  DATA     seq=0        size=1472  flags=----  -> 127.0.0.1:5656
[20:33:55.356] RECV  ACK      ack=1460     size=12    flags=A---  <- 127.0.0.1:5656
[20:33:55.356] SEND  DATA     seq=1460     size=1472  flags=----  -> 127.0.0.1:5656
[20:33:56.365] RETR  DATA     seq=1460     size=1472  flags=----  -> 127.0.0.1:5656
[20:33:57.382] RETR  DATA     seq=1460     size=1472  flags=----  -> 127.0.0.1:5656
[20:33:58.395] RETR  DATA     seq=1460     size=1472  flags=----  -> 127.0.0.1:5656
[20:33:59.405] RETR  DATA     seq=1460     size=1472  flags=----  -> 127.0.0.1:5656
[20:33:59.406] RECV  ACK      ack=2920     size=12    flags=A---  <- 127.0.0.1:5656
[20:33:59.406] SEND  FIN      seq=2920     size=92    flags=--F-  -> 127.0.0.1:5656
[20:33:59.406] RECV  ACK      ack=3000     size=12    flags=A---  <- 127.0.0.1:5656
[Sender] Success file transfer!
По логу отлично видно: клиент отправляет сегмент, ловит таймаут, после чего упорно долбит повторами (RETR) до тех пор, пока сервер наконец не ответит подтверждением.
Казалось бы, теперь потери нам не страшны. Но как бы не так…
Отправив файл размером 3000 байт, на стороне получателя я внезапно обнаружил файл весом ~8700 байт! Несложно догадаться, что в канале возникло дикое дублирование данных. Но откуда?
Ответ кроется в сценариях ретрансмиссии:
Сценарий 1: Отправленный сегмент потерялся
ACK не пришел переотправили. Тут всё чисто.Сценарий 2: Сегмент благополучно дошел до сервера
сервер сохранил данные на диск сервер отправил ACK но этот ACK потерялся на обратном пути! (Подтверждения ведь точно так же летают по ненадежной сети). Клиент, не дождавшись ответа, справедливо решает, что данные не дошли, и ретраит сегмент. Сервер снова получает этот кусок и… радостно дописывает его в файл второй раз!
Чтобы избавиться от каши в файле, на стороне сервера пришлось добавить строгую проверку seq_num: если пришедшие данные у нас уже есть, мы не сохраняем их повторно, а просто еще раз высылаем ACK на этот сегмент, чтобы клиент успокоился и понял, что эти байты записаны.
После этого патча логи сервера стали идеальными, а diff файлов наконец-то сошелся:
[I] [cortex@thinkpad ~/c/protocol-7]$ ./protocol7 -r -p 6767 -f ./out.txt
[20:58:13.059] RECV  DATA     seq=0        size=1472  flags=----  <- 127.0.0.1:5656
[20:58:13.059] SEND  ACK      ack=1460     size=12    flags=A---  -> 127.0.0.1:5656
[20:58:14.072] RECV  DATA     seq=0        size=1472  flags=----  <- 127.0.0.1:5656
[20:58:14.072] SEND  ACK      ack=1460     size=12    flags=A---  -> 127.0.0.1:5656
[20:58:15.086] RECV  DATA     seq=1460     size=1472  flags=----  <- 127.0.0.1:5656
[20:58:15.086] SEND  ACK      ack=2920     size=12    flags=A---  -> 127.0.0.1:5656
[20:58:18.126] RECV  DATA     seq=1460     size=1472  flags=----  <- 127.0.0.1:5656
[20:58:18.126] SEND  ACK      ack=2920     size=12    flags=A---  -> 127.0.0.1:5656
[20:58:20.155] RECV  FIN      seq=2920     size=92    flags=--F-  <- 127.0.0.1:5656
[20:58:20.155] SEND  ACK      ack=3000     size=12    flags=A---  -> 127.0.0.1:5656
[Receiver] Success file transfer!
[I] [cortex@thinkpad ~/c/protocol-7]$ diff test.txt out.txt
[I] [cortex@thinkpad ~/c/protocol-7]$ # файл целый ура ура
Вот теперь запахло настоящей надежностью! В ходе тестов мне удалось без единой ошибки передать JPG-картинку весом 15 КБ с эмуляцией потерь в 30% — а это экстремальные условия, в которых обычный UDP дохнет сразу же
Чексумма
К сожалению, одними потерями проблемы сети не заканчиваются: не забываем про нашу «космическую радиацию». И поскольку пакеты на localhost не бьются сами по себе, мне пришлось научить наш прокси-скрипт еще и искажать данные (режим corrupt). Теперь можно тестировать протокол с заданным процентом вероятности того, что случайные биты сегмента инвертируются прямо на лету.
Причем никакой сегмент и никакая его часть от этого не застрахованы: сегмент может успешно долететь до адресата, но внутри него окажется мусор. Протестировав протокол в таком режиме, я увидел, что diff исходного и принятого файлов постоянно расходится на пару символов, а один раз в логах вылез вот такой шедевр:
[15:52:35.121] SEND  DATA     seq=0        size=1472  flags=----  -> 127.0.0.1:5656
[15:52:35.122] RECV  FIN      seq=0        size=12    flags=-SFR  <- 127.0.0.1:5656
Мы отправили обычный кусок данных (1472 байта), сервер его принял, отправил нам скромный ACK, но по пути биты исказились, и поле флагов превратилось в «новогоднюю ёлку». Сегмент с флагами SYN+FIN+RST одновременно! Естественно, это ломает логику конечного автомата к чертям — как-то ненадежно совсем, эх :(
Но как доверять данным в сети, если на них не написано, фальшивые они или настоящие? Через великую математику!
Нужно реализовать механизм контрольной суммы, но для начала — выбрать конкретный алгоритм. Я рассмотрел 3 классических варианта:
Простая сумма байтов. Все байты просто складываются подряд с отбрасыванием переполнения. Это элементарно в коде, но на этом плюсы заканчиваются. Главный минус — нечувствительность к перестановке байтов местами (сумма останется прежней) и абсолютная слепота к добавлению или удалению нулевых байтов (
0x00).One’s Complement Sum. Дедовский метод: данные разбиваются на 16-битные слова, которые складываются друг с другом. Если возникает перенос из старшего 16-го бита, он циклически прибавляется обратно к младшему разряду (end-around carry). Благодаря этому алгоритм отлично ловит сдвиги и изменения данных. Реализуется чуть сложнее, но, между прочим, именно он используется в IPv4, UDP и TCP!
CRC32 (Cyclic Redundancy Check). Мощно, надежно, но для нас — оверинжиниринг. Данные рассматриваются как коэффициенты огромного бинарного полинома, который делится по модулю 2 на заранее оговоренный порождающий полином.
Я остановился на каноничном One’s Complement Sum: несмотря на все свои компромиссы, для нашей задачи его надежности хватает с головой.
Теперь перед отправкой сегмента мы берем весь буфер (вместе с заголовком), прогоняем через алгоритм, получаем 16-битное число и записываем его в заранее подготовленное поле заголовка (где предварительно были нули). Сама функция подсчета получилась достаточно компактной:
uint16_t p7_calculate_checksum(uint8_t *data, size_t data_size) {
  uint32_t sum = 0;

  for (size_t i = 0; i < data_size; i += 2) {
    uint16_t word = (data[i] << 8) | (i + 1 < data_size ? data[i + 1] : 0);
    sum += word;
  }

  while (sum >> 16) {
    sum = (sum & 0xFFFF) + (sum >> 16);
  }

  return (uint16_t)~sum;
}
Здесь я завел 32-битный аккумулятор sum (вдвое больше 16 бит), чтобы при сложении сотен слов не потерять биты переполнения. Затем мы циклом по 2 байта упаковываем байты в 16-битные слова в сетевом порядке (Big-Endian) и суммируем. После этого циклом while (sum >> 16) аккуратно складываем старшие биты переполнения с младшими, пока число не уложится ровно в 16 бит.
В самом конце результат инвертируется побитовым NOT (~sum). Зачем? Ради сетевой магии: если записать эту инвертированную сумму прямо в заголовок сегмента, то при повторном вычислении контрольной суммы от всего принятого сегмента на стороне получателя валидный сегмент автоматически компенсирует сам себя в 0x0000!
Попробовав реализовать эту задумку, я столкнулся с проблемой, которая ввела меня в ступор: на стороне получателя вместо заветного 0x0000 вылетал абсолютный рандом.
Вариантов было море: неинициализированная память, косяки с порядком байт, баги в цикле… Но реальная причина оказалась куда интереснее.
Наш алгоритм шагает по памяти строго 16-битными (2-байтовыми) словами. А в заголовке поле checksum находилось на 9-м и 10-м байтах — то есть начиналось на нечетном смещении!
В итоге при пошаговом суммировании контрольная сумма буквально разрывалась пополам:
Старший байт склеивался в одно слово с байтом
flags;Младший байт склеивался с байтом паддинга.
Естественно, ни о какой самокомпенсации инвертированной суммы и речи быть не могло — биты инвертированного числа попадали совсем в другие весовые разряды сложения!
Поле контрольной суммы ОБЯЗАНО быть выровнено по 16-битной сетке. Решение оказалось элементарным: просто поменять местами flags и checksum в структуре заголовка, сдвинув чексумму на четные байты 8 и 9. Стоило подвинуть поля, как всё взлетело:
CHECKSUM: 0    # для валидного сегмента
CHECKSUM: 5100 # для битого сегмента
А схема заголовка приобрела новый вид:
.0                   1                   2                   3
 0 1 2 3 4 5 6 7 8 9 0 1 2 3 4 5 6 7 8 9 0 1 2 3 4 5 6 7 8 9 0 1
+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+
|                            seq_num                            |
+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+
|                            ack_num                            |
+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+
|           checksum            |     flags     | Padding (0x00)|
+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+
Так что в реальных сетевых стеках поля checksum выравниваются по 2- или 4-байтовой границе именно из-за математики суммирования, а не ради красоты (никакого самовыражения блин)
Теперь логика проста: если пришедший сегмент не сходится в 0 — мы его молча отбрасываем (DROP). Отправитель не получит ACK, поймает таймаут и честно переотправит небитую копию.
Добавив эту проверку, я добился передачи тестовой картинки размером 15 КБ при 30% вероятности порчи данных в сети. В логах это выглядело чудесно:
# Отправитель:
...
[19:39:02.918] RETR  DATA     seq=10220    size=1472  flags=----  -> 127.0.0.1:5656
[19:39:03.931] RETR  DATA     seq=10220    size=1472  flags=----  -> 127.0.0.1:5656
[19:39:03.931] RECV  ACK      ack=11680    size=12    flags=A---  <- 127.0.0.1:5656
[19:39:03.931] SEND  DATA     seq=11680    size=1472  flags=----  -> 127.0.0.1:5656
[19:39:03.932] DROP  ACK      ack=13140    size=12    flags=A---  <- 127.0.0.1:5656
[19:39:03.932] RETR  DATA     seq=11680    size=1472  flags=----  -> 127.0.0.1:5656
[19:39:03.932] RECV  ACK      ack=13140    size=12    flags=A---  <- 127.0.0.1:5656
[19:39:03.933] SEND  DATA     seq=13140    size=1472  flags=----  -> 127.0.0.1:5656
[19:39:03.933] RECV  ACK      ack=14600    size=12    flags=A---  <- 127.0.0.1:5656
[19:39:03.933] SEND  FIN      seq=14600    size=656   flags=--F-  -> 127.0.0.1:5656
[19:39:04.944] RETR  FIN      seq=14600    size=656   flags=--F-  -> 127.0.0.1:5656
[19:39:04.944] RECV  ACK      ack=15244    size=12    flags=A---  <- 127.0.0.1:5656
[Sender] Success file transfer!

# Получатель:
...
[19:39:02.918] DROP  DATA     seq=10220    size=1472  flags=----  <- 127.0.0.1:5656
[19:39:03.931] RECV  DATA     seq=10220    size=1472  flags=----  <- 127.0.0.1:5656
[19:39:03.931] SEND  ACK      ack=11680    size=12    flags=A---  -> 127.0.0.1:5656
[19:39:03.932] RECV  DATA     seq=11680    size=1472  flags=----  <- 127.0.0.1:5656
[19:39:03.932] SEND  ACK      ack=13140    size=12    flags=A---  -> 127.0.0.1:5656
[19:39:03.932] RECV  DATA     seq=11680    size=1472  flags=----  <- 127.0.0.1:5656
[19:39:03.932] SEND  ACK      ack=13140    size=12    flags=A---  -> 127.0.0.1:5656
[19:39:03.933] RECV  DATA     seq=13140    size=1472  flags=----  <- 127.0.0.1:5656
[19:39:03.933] SEND  ACK      ack=14600    size=12    flags=A---  -> 127.0.0.1:5656
[19:39:03.933] DROP  FIN      seq=14600    size=656   flags=--F-  <- 127.0.0.1:5656
[19:39:04.944] RECV  FIN      seq=14600    size=656   flags=--F-  <- 127.0.0.1:5656
[19:39:04.944] SEND  ACK      ack=15244    size=12    flags=A---  -> 127.0.0.1:5656
[Receiver] Success file transfer!
[I] [cortex@thinkpad ~/c/protocol-7]$ diff image-in.jpg image-out.jpg
[I] [cortex@thinkpad ~/c/protocol-7]$ # чисто!
Дублирование сегментов
Как я уже говорил, реальная сеть умеет не только терять и портить сегменты, но еще и нагло дублировать их. Так что следующим этапом я добавил в наш прокси эмуляцию дублирования пакетов и с ходу обнаружил восхитительную дыру:
[I] [cortex@thinkpad ~/c/protocol-7]$ ./protocol7 -s -f ./test.txt -p 5656
[17:51:09.034] SEND  DATA     seq=0        size=1472  flags=----  -> 127.0.0.1:5656
[17:51:09.034] RECV  ACK      ack=1460     size=12    flags=A---  <- 127.0.0.1:5656
[17:51:09.035] SEND  DATA     seq=1460     size=1472  flags=----  -> 127.0.0.1:5656
[17:51:09.035] RECV  ACK      ack=1460     size=12    flags=A---  <- 127.0.0.1:5656
[17:51:09.035] SEND  FIN      seq=2920     size=92    flags=--F-  -> 127.0.0.1:5656
[17:51:09.035] RECV  ACK      ack=1460     size=12    flags=A---  <- 127.0.0.1:5656
[Sender] Success file transfer!
Отправителю было вообще до лампочки на поле ack_num! Я просто забыл его валидировать, ахахах. То есть клиент отправлял кусок данных и ждал «ну хоть какой-нибудь ACK». Прилетел старый сдублированный ответ? «О, кайф, подтвердили, шлем следующий!». Файл при этом умудрился дойти целым только чудом.
Но стоило исправить это недоразумение и начать строго сверять ack_num == expected_ack, как нарисовалась следующая беда.
Получая дубликат старого ACK, отправитель воспринимал это как повод запаниковать и переотправить сегмент заново. Получатель, видя повторные данные, вежливо отвечал на них еще одним ACK… В сети начинался настоящий шторм ретраев и бесконечный пинг-понг пакетами. И хотя в конечном итоге файл собирался без ошибок, логи напоминали поле боя.
Поэтому логику отправителя пришлось остудить: дублирующие ACK мы пока что просто тихо игнорируем и ждем либо правильный ack_num, либо честный таймаут (почему это поведение критически важно для будущего механизма быстрой ретрансмиссии — обсудим чуть позже).
После этого фикса логи наконец-то стали выглядеть цивилизованно:
# Получатель:
[I] [cortex@thinkpad ~/c/protocol-7]$ ./protocol7 -r -p 6767 -f ./out.txt
[18:22:27.579] RECV DATA seq=0 size=1472 flags=---- <- 127.0.0.1:5656
[18:22:27.579] SEND ACK ack=1460 size=12 flags=A--- -> 127.0.0.1:5656
[18:22:28.080] RECV DATA seq=1460 size=1472 flags=---- <- 127.0.0.1:5656
[18:22:28.080] SEND ACK ack=2920 size=12 flags=A--- -> 127.0.0.1:5656
[18:22:28.081] RECV FIN seq=2920 size=92 flags=--F- <- 127.0.0.1:5656
[18:22:28.081] SEND ACK ack=3000 size=12 flags=A--- -> 127.0.0.1:5656
[Receiver] Success file transfer!

# Отправитель:
[I] [cortex@thinkpad ~/c/protocol-7]$ ./protocol7 -s -f ./test.txt -p 5656
[18:22:27.579] SEND DATA seq=0 size=1472 flags=---- -> 127.0.0.1:5656
[18:22:27.580] RECV ACK ack=1460 size=12 flags=A--- <- 127.0.0.1:5656
[18:22:27.580] SEND DATA seq=1460 size=1472 flags=---- -> 127.0.0.1:5656
[18:22:28.080] RECV ACK ack=1460 size=12 flags=A--- <- 127.0.0.1:5656 # Дубль
[18:22:28.080] RECV ACK ack=1460 size=12 flags=A--- <- 127.0.0.1:5656 # Еще дубль
[18:22:28.081] RECV ACK ack=2920 size=12 flags=A--- <- 127.0.0.1:5656 # Пришел нужный!
[18:22:28.081] SEND FIN seq=2920 size=92 flags=--F- -> 127.0.0.1:5656
[18:22:28.581] RECV ACK ack=3000 size=12 flags=A--- <- 127.0.0.1:5656
[Sender] Success file transfer!
[I] [cortex@thinkpad ~/c/protocol-7]$ diff test.txt out.txt
[I] [cortex@thinkpad ~/c/protocol-7]$ # чистота :)
Механизм TIME_WAIT
Представим такую ситуацию: мы — сервер, получили сегмент с FIN-флагом. Отправив ACK на этот сегмент, мы, казалось бы, спокойно можем сворачивать лавочку и завершать работу. Так ведь?
А вот и нет.
Что будет, если ACK, который мы отправили, потеряется по дороге? Клиент решит, что мы не получили его FIN, и будет упорно переотправлять его. Но отправлять-то уже некому — сервер закрылся, сокет умер. В итоге клиент будет биться головой о стену, ретраить в пустоту и завершится по аварийному таймауту с ошибкой. Некрасиво.
Эту проблему деды сетевых технологий решили через состояние TIME_WAIT (в классическом TCP оно длится 2MSL — то есть два максимальных времени жизни сегмента в сети).
Идея простая: после отправки ACK на FIN сервер не закрывается сразу, а переходит в режим ожидания и ждет секунд:
Если за это время прилетел повторный FIN — значит, наш предыдущий ACK потерялся! Сервер послушно переотправляет ACK и перезапускает таймер ожидания.
Если таймер истек и никаких сегментов больше не приходило — значит, клиент получил наш ACK и успешно закрылся. Теперь и сервер может спокойно идти отдыхать.
Реализовав эту логику, я провел тесты и отловил показательный кейс, с которым протокол справился на ура:
# Отправитель:
...
[17:11:41.151] RECV  ACK      ack=2920     size=12    flags=A---  <- 127.0.0.1:5656
[17:11:41.151] SEND  FIN      seq=2920     size=92    flags=--F-  -> 127.0.0.1:5656
[17:11:42.163] RETR  FIN      seq=2920     size=92    flags=--F-  -> 127.0.0.1:5656
[17:11:43.176] RETR  FIN      seq=2920     size=92    flags=--F-  -> 127.0.0.1:5656
[17:11:44.190] RETR  FIN      seq=2920     size=92    flags=--F-  -> 127.0.0.1:5656
[17:11:45.203] RETR  FIN      seq=2920     size=92    flags=--F-  -> 127.0.0.1:5656
[17:11:46.216] RETR  FIN      seq=2920     size=92    flags=--F-  -> 127.0.0.1:5656
[17:11:46.217] RECV  ACK      ack=3000     size=12    flags=A---  <- 127.0.0.1:5656
[Sender] Success file transfer!

# Получатель:
...
[17:11:41.150] RECV  DATA     seq=1460     size=1472  flags=----  <- 127.0.0.1:5656
[17:11:41.150] SEND  ACK      ack=2920     size=12    flags=A---  -> 127.0.0.1:5656
[17:11:41.151] RECV  FIN      seq=2920     size=92    flags=--F-  <- 127.0.0.1:5656
[17:11:41.151] SEND  ACK      ack=3000     size=12    flags=A---  -> 127.0.0.1:5656
[17:11:42.163] RECV  FIN      seq=2920     size=92    flags=--F-  <- 127.0.0.1:5656
[17:11:42.163] SEND  ACK      ack=3000     size=12    flags=A---  -> 127.0.0.1:5656
[17:11:44.190] RECV  FIN      seq=2920     size=92    flags=--F-  <- 127.0.0.1:5656
[17:11:44.190] SEND  ACK      ack=3000     size=12    flags=A---  -> 127.0.0.1:5656
[17:11:46.217] RECV  FIN      seq=2920     size=92    flags=--F-  <- 127.0.0.1:5656
[17:11:46.217] SEND  ACK      ack=3000     size=12    flags=A---  -> 127.0.0.1:5656
[Receiver] Success file transfer!
Так что теперь вы знаете, почему иногда сокет не биндится сразу после перезапуска сервера (Address already in use): всё дело в механизме TIME_WAIT, который решает важную проблему как в TCP, так и в моем протоколе с этого момента.
Sliding Window
Наш протокол научился бороться с множеством проблем в сети, и сейчас его уже спокойно можно назвать надежным. Достижение! Но есть нюанс.
Сейчас мы отправляем один сегмент, замираем в ожидании ACK, после чего снова отправляем, ждем, и так далее. В мире сетевых технологий это называется Stop-and-Wait, и скорость такой передачи жестко ограничена одним RTT на сегмент — медленнее только телеграф.
Чтобы решить эту проблему, нам понадобится реализовать конвейер: систему, при которой отправитель будет выстреливать сегменты десятками штук без ожидания подтверждения на каждый, удерживая «в полете» целое окно данных и параллельно разгребая приходящие ACK.
К слову: во время работы я наткнулся на лабораторные работы Стэнфордского университета (CS144), в которых студенты проходят ровно тот же путь (разве что с более простым вариантом нумерации сегментов, о котором я рассказывал в начале). И после Stop-and-Wait они так же вручную пилят Sliding Window. Я же постараюсь сделать это немного взрослее и круче, чем в лабах Стэнфорда. Почему бы и нет?
Отправитель
Главная идея Sliding Window — держать в канале сразу пачку сегментов, не дожидаясь подтверждения на каждый.
Для этого я сперва снес всю старую логику отправки (радикальный подход, да), после чего завел две структуры: одну для отдельного слота, вторую — для самого окна, состоящего из слотов:
typedef struct {
  uint32_t seq_num;
  uint8_t data[P7_HEADER_SIZE + P7_MSS];
  size_t data_len;
  int is_acked;
  uint64_t send_time_ms;
} p7_sender_slot_t;

typedef struct {
  p7_sender_slot_t slots[P7_WINDOW_SIZE];
  uint32_t base;
  uint32_t new_seq;
} p7_sender_window_t;
Память под сегменты выделил один раз при старте через calloc под фиксированный размер окна P7_WINDOW_SIZE. Получился обычный кольцевой буфер:
[0][1][2][3][4][5][6][7]  <- Слоты кольцевого буфера
 ^           ^
 base        new_seq       <- In-flight: сегменты 0, 1, 2, 3 уже в полете
base— байтовое смещение самого старого неподтвержденного байта (левый край окна);new_seq— смещение следующего байта, готового к отправке (правый край окна).
Для контроля данных «в полете» считаем размер очереди через in_flight = new_seq - base. Если эта разница меньше размера окна — значит, место еще есть и можно тулить следующие сегменты в сокет, не ожидая хорошей погоды.
Дальше нужно было организовать главный цикл, в котором будет происходить вся магия. Его логика предельно линейна:
Забиваем окно под завязку: читаем данные из файла, упаковываем в слоты и залпом отправляем пачку в сеть.
-
Слушаем сокет: делаем
recvfrom()с таймаутом в 20 мс (временный костыль):Если прилетает ACK — берем кумулятивное подтверждение
ack_numи радостно сдвигаем окноwindow->baseвперед (это и есть скольжение окна).Если за 20 мс ничего не произошло — просто идем дальше.
Ретрансмиссия по таймауту: пробегаем по окну, смотрим, какие сегменты отправлены, но не подтверждены. Если разница между текущим временем и
send_time_msпревысила таймаут — переотправляем конкретный сегмент.
Получились три этапа, которые крутятся в бесконечном цикле, создавая в терминале красивейшую картину:
[01:45:12.417] SEND  DATA     seq=0        size=1472  flags=----  -> 127.0.0.1:5656
[01:45:12.417] SEND  DATA     seq=1460     size=1472  flags=----  -> 127.0.0.1:5656
[01:45:12.417] SEND  DATA     seq=2920     size=1472  flags=----  -> 127.0.0.1:5656
[01:45:12.418] SEND  DATA     seq=4380     size=632   flags=----  -> 127.0.0.1:5656
[01:45:12.418] RECV  ACK      ack=1460     size=12    flags=A---  <- 127.0.0.1:5656
[01:45:12.418] RECV  ACK      ack=2920     size=12    flags=A---  <- 127.0.0.1:5656
[01:45:12.418] RECV  ACK      ack=4380     size=12    flags=A---  <- 127.0.0.1:5656
[01:45:12.418] RECV  ACK      ack=5000     size=12    flags=A---  <- 127.0.0.1:5656
[Sender] Transfer complete successfully!
Как видно, вся пачка ушла в сеть почти одновременно без ожидания подтверждения на каждый шаг — это уже выглядит бодро! Но радоваться было рано.
На этом этапе у нас вскрылись две проблемы:
Кумулятивный ACK в условиях потерь — боль: если мы отправили сегменты 1, 2, 3, 4, а потерялся только сегмент 2, получатель не сможет сдвинуть свое окно (об этом чуть позже) и будет упорно спамить ACK на 1-й сегмент. Отправитель же в этот момент понятия не имеет, что сегменты 3 и 4 благополучно дошли.
Задержка 20 мс: костыль с
SO_RCVTIMEOморозит поток на 20 мс при любом простое, а в сетях это целая вечность.
Начал с фикса костыля. Для нормального неблокирующего цикла нужно было переписать реализацию с тайм-аутов на сетевой мультиплексор. Но какой выбрать?
select— легаси дед, не привлекает;poll— сладкий мальчик;epoll— тяжелый люкс.
Выбор пал на poll(): он куда приятнее и проще select(), но при этом не является оверинжинирингом вроде epoll() (для одного-то сокета).
Создал структуру pollfd с ожиданием события POLLIN, дернул poll() и раскидал результат:
== 0— честный таймаут (пора проверить, не нужно ли отретраить потерянные сегменты);< 0— реальная ошибка сокета;> 0(в нашем случае1) — на сокете есть входящие данные! Забираем их черезrecvfrom().
Такая обновка дала кучу профита:
Честный контроль над ошибками: раньше
recvfromсSO_RCVTIMEOпревращал каждый таймаут в ошибку (возвращал-1), и приходилось лезть вerrno, чтобы понять, была ли это реальная ошибка или просто никто не ответил. Теперьpollвозвращает строгое разделение (< 0,0,> 0).Полноценный Event Loop, емаё: отправитель заполняет окно, ждет вердикта от
poll, после чего имеет четкую развилку: либо пришел ACK и мы двигаем окно, либо сработал таймаут и мы занимаемся ретрансмиссией.Масштабируемость: теперь можно без проблем добавлять новые фичи: прерывание по нажатию клавиши, второй порт для команд управления, мониторинг других дескрипторов. Единственный поток может одновременно следить и за сетью, и за файлами, и за консолью.
Получатель
После того как с отправителем мы разобрались, перед нами встала новая задача: сделать получателя значительно умнее. Он должен уметь принимать сегменты, прилетевшие вразнобой, и аккуратно буферизовать их до тех пор, пока не подтянутся потерянные куски.
Для этого я спроектировал приемное окно, очень похожее на окно отправителя:
typedef struct {
  uint8_t data[P7_MSS];
  size_t data_len;
  int is_received;
  int is_fin;
} p7_recv_slot_t;

typedef struct {
  p7_recv_slot_t slots[P7_WINDOW_SIZE];
  uint32_t expected_seq;
} p7_recv_window_t;
Логика главного цикла теперь выглядит так:
Забираем датаграмму из сокета, проверяем контрольную сумму и десериализуем заголовок.
Проверяем, попадает ли
seq_numсегмента в диапазон текущего окна. Если да — кладем данные в соответствующий слот буфера и помечаем его флагомis_received = 1.Сегменты, которые лежат левее окна (старые дубликаты), мы не сохраняем, а просто подтверждаем повторным ACK.
Сброс данных на диск: мы бежим по слотам окна начиная с
expected_seq. Пока в слоте есть данные (is_received == 1), мы непрерывно сбрасываем их в файл и двигаем границу окнаexpected_seqвперед. Как только натыкаемся на дыру (is_received == 0) — моментально тормозим запись на диск и ждем нашу потеряшку.После сдвига окна отправляем клиенту обновленный кумулятивный ACK.
В очередной раз переписав логику и победив пачку багов с индексами кольцевого буфера, я наконец добился стабильной работы окна даже в режиме с потерями!
Осталось только выяснить: а стоила ли вообще игра свеч?
Начнем с математики:
Дано:
— размер сегмента в битах (вместе с заголовком)
— пропускная способность канала (бит/с)
— время передачи (сериализации) одного пакета
— время кругового оборота пакета
В эпоху наивного Stop-and-Wait коэффициент утилизации канала составлял:
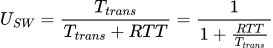
Теперь же со скользящим окном размером в слотов мы имеем конвейер:
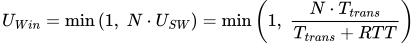
Теоретический прирост скорости — ровно в раз (по размеру окна) вплоть до 100% заполнения физической емкости канала. Утилизация доступных ресурсов на максимуме — кайфарики!
А что на реальных цифрах?
Подставим стандартные значения:  байт (
 бит), скорость канала
 Мбит/с, пинг
 мс.
Stop-and-Wait:
Утилизация канала: всего ~0.58%;
Скорость передачи: жалкие ~72.5 КБ/с.
Наш Sliding Window (размер окна = 32):
Утилизация канала: уже ~18.58%;
Скорость передачи: 2268 КБ/с (около 2.22 МБ/с).
Прирост просто космический — в целых 32 раза!
Казалось бы: а давайте просто задерем размер окна до 512 слотов и получим на бумаге ускорение в 512 раз? Но на практике результат окажется совсем другим, и чуть позже мы обязательно наступим на эти грабли :)
Время бенчмарков!
Для того чтобы измерить реальные показатели протокола, я накидал скрипт на Python, который прогоняет автоматические тесты, замеряет скорость передачи и валидирует целостность принятого файла.
Начал я с небольшого окна в 8 слотов, и… Честно говоря, даже когда я родился, мои родители не были так сильно разочарованы, как я, глядя на эти результаты:
[TEST] Mode: normal | Size: 10 MB | Drop=0% Corr=0% Dbl=0%
[*] Generating 10 MB test file...
       -> Time: 0.185s | Speed: 53.95 MB/s | Integrity: [OK] PASS

[TEST] Mode: drop | Size: 10 MB | Drop=5% Corr=0% Dbl=0%
[*] Generating 10 MB test file...
       -> Time: 294.266s | Speed: 0.03 MB/s | Integrity: [OK] PASS
Это просто катастрофа! При скромных 5% потерь скорость передачи падает практически до нуля, а на передачу несчастных 10 МБ уходит аж 294 секунды (почти 5 минут!)…
У меня в голове было два варианта, как исправить эту трагедию. И для начала я решил внедрить механизм быстрой ретрансмиссии.
Fast Retransmit
Главная проблема классической ретрансмиссии по таймеру — таймаут ну ооочень долгий.
В реальной сети таймаут всегда выставляют с запасом (например, 300–500 мс или даже больше), чтобы случайно не начать спамить повторными копиями сегментов, которые просто задержались в пути из-за сетевого джиттера.
А теперь давайте представим картину:
Мы выстрелили в сеть окно из 10 сегментов (№1, №2, … №10).
Сегмент №2 потерялся. А вот сегменты с №3 по №10 благополучно долетели до адресата.
Окно отправителя забито под завязку (лимит исчерпан). Новых данных слать нельзя.
Что происходит дальше? Отправитель уныло сидит и ждет истечения медленного таймаута (скажем, целых 300 мс). Всё это время конвейер намертво стоит, сокет простаивает, скорость передачи падает в ноль. В сетевом мире это называется pipeline stall (засыхание конвейера).
Как эту проблему решает быстрая ретрансмиссия?
Нужно вспомнить, как ведет себя получатель в подобных ситуациях.
Получатель, у которого образовалась дыра в данных (пришли 3, 4, 5, но нет 2), по строгим правилам кумулятивного ACK обязан на каждый следующий пришедший кусок отвечать: «Я всё еще жду байт №2!».
Отправителю прилетает пачка ответов:
На сегмент №3
ACK 2(дубль 1)На сегмент №4
ACK 2(дубль 2)На сегмент №5
ACK 2(дубль 3)
Отправитель видит эту очередь дубликатов и делает гениальный вывод:
«Подождите-ка. Если мне непрерывно приходят ответы от получателя, значит сеть жива! Пакеты не застряли. Раз получатель уже трижды кричит, что ждет именно сегмент №2, значит сегменты 3, 4 и 5 он уже принял, а сегмент №2 с вероятностью 99.9% погиб смертью храбрых. Зачем мне ждать еще 300 мс до конца таймера?!»
После такого озарения отправитель мгновенно просыпается и без всякого ожидания переотправляет потерянный сегмент прямо из буфера. Простой ликвидирован, туда его!
Давайте посмотрим, что теперь говорят бенчмарки:
=== RESULT TABLE ===
Mode       | Size (MB)  | Impairment           | Time (s)   | Speed (MB/s)    | Integrity
-------------------------------------------------------------------------------------
NORMAL     | 10         | None                 | 0.188      | 53.14           | PASS
DROP       | 10         | Drop: 5%             | 33.874     | 0.30            | PASS
DROP       | 10         | Drop: 15%            | 295.606    | 0.03            | PASS
CORRUPT    | 10         | Corrupt: 5%          | 34.969     | 0.29            | PASS
DOUBLE     | 10         | Double: 10%          | 0.205      | 48.80           | PASS
Совсем другое дело! С учетом того, что локальные таймауты у меня и так стояли мизерные (~50 мс), результат всё равно оказался почти в 10 раз лучше, чем раньше. Теперь передача 10 МБ при 5% потерь занимает не 294 секунды, а 33. Жить уже можно!
Serial Experiments с размером окна
Ранее по формулам мы прикинули, что, задрав размер окна до 512 слотов, мы теоретически сможем добиться прироста в 512 раз по сравнению со Stop-and-Wait. Давайте сделаем это и проверим теорию практикой:
Mode       | Size (MB)  | Impairment           | Time (s)   | Speed (MB/s)    | Integrity
-------------------------------------------------------------------------------------
NORMAL     | 10         | None                 | 24.139     | 0.41            | PASS
DROP       | 10         | Drop: 5%             | 15.760     | 0.63            | PASS
DROP       | 10         | Drop: 15%            | 21.936     | 0.46            | PASS
CORRUPT    | 10         | Corrupt: 5%          | 23.913     | 0.42            | PASS
DOUBLE     | 10         | Double: 10%          | 26.864     | 0.37            | PASS
Интересный результат… Явно не то, о чем мечталось перед запуском: вместо бешеного ускорения система легла. Ситуация стала сильно хуже, чем с маленьким окном в 8 слотов (хахаха), причем скорость катастрофически просела даже в идеальных условиях без потерь (с 53 МБ/с до жалких 0.41 МБ/с)!
Почему так?
Отправляя без пауз сразу 512 датаграмм по 1472 байта (залпом выплевывая около 754 КБ), мы моментально забиваем буфер сокета (SO_SNDBUF / SO_RCVBUF). Ядро ОС (в моем случае Linux) просто не успевает переваривать этот объем и молча отбрасывает часть пакетов прямо в памяти стека, создавая локальный затор.
При этом можно заметить забавную аномалию: скорость в режиме с потерями 5% оказалась выше, чем в идеальном режиме (0.63 МБ/с против 0.41 МБ/с)! Это произошло только потому, что наши искусственные потери слегка сбивали бешеный темп отправителя и давали буферу ядра хоть немного отдышаться — получился своего рода rate-limiter на коленке.
Давайте попробуем найти золотую середину — окно размером 32 слота:
Mode       | Size (MB)  | Impairment           | Time (s)   | Speed (MB/s)    | Integrity
-------------------------------------------------------------------------------------
NORMAL     | 10         | None                 | 0.151      | 66.19           | PASS
DROP       | 10         | Drop: 5%             | 5.403      | 1.85            | PASS
DROP       | 10         | Drop: 15%            | 121.971    | 0.08            | PASS
CORRUPT    | 10         | Corrupt: 5%          | 16.683     | 0.60            | PASS
DOUBLE     | 10         | Double: 10%          | 0.197      | 50.74           | PASS
Вот это уже другое дело! Результат значительно лучше, чем при окнах в 8 и 512 слотов, причем в любых условиях. Если сравнить с окном 8, то время передачи при 5% потерь сократилось еще в 6 раз — с 33 секунд до 5.4 секунды для 10 МБ. Просто чудесно)
Конечно, в настоящем TCP размер окна никогда не бывает статичным: там работают суровые механизмы контроля перегрузки (Congestion Control), динамически подстраивающие размер окна под ширину канала. Но мы алгоритмы перегрузки пока опустим, ха-ха :)
Selective ACK
Как уже было выяснено в тестах с 15% потерь, одного кумулятивного ACK и быстрой ретрансмиссии мало. Если в пределах одного окна выбивает сразу несколько сегментов, отправитель оказывается в состоянии полной информационной слепоты.
Получатель флудит: «Жду сегмент №5!». Отправитель честно пересылает №5. Но что с остальными? Сегменты №7, №8, №9 долетели или тоже погибли? Непонятно. Приходится либо угадывать и вслепую пересылать вообще всё окно (тратя драгоценный трафик), либо ждать.
Чтобы вернуть отправителю зрение, нужен Selective ACK (SACK) — механизм выборочного подтверждения.
Идея элементарная: помимо базового кумулятивного ack_num, получатель передает дополнительную подсказку. В переводе на человеческий язык это звучит так:
«Дружище, я принял всё подряд до байта №5 включительно. Но пока ты тупил, мне уже долетели сегменты №7 и №8, они в надежном месте! Поэтому пришли мне только потерянный №6, а 7 и 8 повторно не шли, не забивай канал».
Зная точную карту того, что уже лежит на той стороне, отправитель может точечно, как снайпер, досылать только реально потерянные фрагменты мозаики.
В классическом TCP для этого нагородили тяжелые SACK-опции с диапазонами байтов. Я же решил временно обойтись изящным вариантом через 32-битную маску в заголовке. Это не самый универсальный подход: каждый из 32 бит этой маски обозначает ровно 1 сегмент в окне, и если окно динамически изменит свой размер, вся эта логика пойдет по одному месту. Но удивительным образом сложились обстоятельства: наше окно как раз зафиксировано на 32 слотах, и 32 бита маски идеально вписались в 4-байтовое слово структуры заголовка!
Первым делом я изменил заголовок, добавив поле для самой маски. Теперь заголовок выглядит так:
.0                   1                   2                   3
 0 1 2 3 4 5 6 7 8 9 0 1 2 3 4 5 6 7 8 9 0 1 2 3 4 5 6 7 8 9 0 1
+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+
|                       Sequence Number (32)                    |
+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+
|                    Acknowledgment Number (32)                 |
+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+
|                      Selective ACK Mask (32)                  |
+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+
|          Checksum (16)        |    Flags (8)  | Reserved (8)  |
+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+
|                                                               |
:                            Payload                            :
|                                                               |
+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+
А в коде получателя теперь отмечаем единичными битами те слоты, которые были получены после пропущенного (начиная со смещения ack_num). То есть кумулятивный ACK останавливается перед первой дырой, а всё, что получено после нее, отмечается битами в маске.
На отправителе же линейно проходимся по каждому биту маски и выставляем is_acked = 1 на каждом слоте, который соответствует биту маски:
uint32_t base_idx = (window->base / P7_MSS) % P7_WINDOW_SIZE;
for (int i = 0; i < P7_WINDOW_SIZE - 1; i++) {
    if (ack_header.ack_mask & (1U << i)) {
        uint32_t acked_idx = (base_idx + i + 1) % P7_WINDOW_SIZE;
        window->slots[acked_idx].is_acked = 1;
    }
}
Сама же логика переотправки пропускает слоты, которые уже отмечены как подтвержденные:
uint32_t start_seg = window->base / P7_MSS;
uint32_t end_seg = window->new_seq / P7_MSS;

for (uint32_t i = start_seg; i <= end_seg; i++) {
    uint32_t slot_idx = i % P7_WINDOW_SIZE;
    p7_sender_slot_t *slot = &window->slots[slot_idx];

    if (!slot->is_acked && (now_ms - slot->send_time_ms > P7_TIMEOUT_MS)) {
        sendto(session.sock_fd, slot->data, slot->data_len, 0, ...);
        slot->send_time_ms = now_ms;
    }
}
Архитектурных проблем с внедрением этого механизма не было, большая часть логики была готова сама по себе — так что единственной проблемой стал мой тупняк на элементарных вещах, но без этого никуда :)
А вот и дебаг-лог, на котором наглядно видно, как работает та самая маска:
[18:35:35.588] RECV  ACK      ack=14560    size=16    flags=A---  <- 127.0.0.1:5656
[18:35:35.588] RECV  ACK      ack=16016    size=16    flags=A---  <- 127.0.0.1:5656
[18:35:35.588] RECV  ACK      ack=16016    size=16    flags=A---  <- 127.0.0.1:5656
[SACK DEBUG] Received SACK mask: 0x00000001 for base=16016
[18:35:35.588] RECV  ACK      ack=16016    size=16    flags=A---  <- 127.0.0.1:5656
[SACK DEBUG] Received SACK mask: 0x00000011 for base=16016
[18:35:35.589] RECV  ACK      ack=16016    size=16    flags=A---  <- 127.0.0.1:5656
[SACK DEBUG] Received SACK mask: 0x00001011 for base=16016
[18:35:35.589] RETR  DATA     seq=16016    size=1472  flags=----  -> 127.0.0.1:5656
Но куда интереснее посмотреть на бенчмарки, ведь так? Насколько же стало лучше?..
Mode       | Size (MB)  | Impairment           | Time (s)   | Speed (MB/s)    | Integrity
-------------------------------------------------------------------------------------
NORMAL     | 10         | None                 | 0.168      | 59.62           | PASS
DROP       | 10         | Drop: 5%             | 11.558     | 0.87            | PASS
DROP       | 10         | Drop: 15%            | 132.706    | 0.08            | PASS
CORRUPT    | 10         | Corrupt: 5%          | 5.393      | 1.85            | PASS
DOUBLE     | 10         | Double: 10%          | 0.213      | 47.03           | PASS
А лучше не стало! Более того, стало даже заметно хуже в некоторых сценариях. Возникает логичный вопрос: если скорость просела, зачем это вообще нужно было делать?
Да, по секундомеру передача замедлилась. Но что, если копнуть глубже? Давайте посмотрим на то, как работает реальный интернет.
В реальности пропускная способность канала всегда жестко ограничена, а пинг высокий (например, 50–100 мс через океан). В реальной сети повторная пересылка даже одного лишнего мегабайта — это катастрофа, которая забивает канал на секунды. Так что экономия трафика многократно окупает накладные расходы на CPU.
А что произошло на наших тестах? На loopback-интерфейсе пропускная способность сети условно бесконечна, а задержка стремится к нулю. Узким местом стал вовсе не канал, а процессор и системные вызовы.
Получается, что SACK спас сеть от лишних байтов данных ценой накладных расходов на их обработку. В условиях реальной трансконтинентальной сети это был бы однозначный вин!
Вывод: почему TCP — это шедевр
На этой ноте я хочу завершить первую часть истории Protocol-7.
Да, «убийцу TCP» мы не получили (да и не планировали), мир захватить тоже пока не удалось, но главное здесь совсем другое. Попробовав своими руками реализовать надежную доставку поверх ненадежного хаоса, я на собственной шкуре осознал, насколько же TCP монументален. Это без преувеличения величайший шедевр коллективной инженерной мысли, который полировался десятилетиями тысячами людей со всего мира.
Легко открыть спецификацию и попытаться повторить ее в коде. Но представить, каково было инженерам полвека назад с нуля проектировать эти абстракции, когда под ногами не было абсолютно ничего, — это вызывает искреннее восхищение.
Мы каждый день открываем браузер, смотрим видосы на ютуб или запускаем банальный curl в терминале. Мы привыкли воспринимать надежную передачу данных как абсолютную данность: нажал кнопку — байты прилетели. Но теперь, зная, сколько боли, математики и нюансов скрывается за каждым потерянным пакетом, начинаешь смотреть на индикатор загрузки совсем другими глазами.
Зачем вообще писать свой сетевой стек сегодня? Точно не для того, чтобы выкатить его в прод. А для того, чтобы раз и навсегда снять для себя «магию» с технологий. Перестать воспринимать сеть как черную коробку и научиться буквально видеть физику движения каждого бита.
Protocol-7 пока еще очень далек от совершенства — это скорее боевой прототип и концепт. Впереди остался целый океан взрослых механик настоящего TCP, до которых дико чешутся руки:
Полноценный контроль перегрузки;
Алгоритм Карна и динамический расчет RTT/RTO на скользящих средних;
Борьба с синдромом глупого окна (алгоритмы Нейгла и Кларка);
Честное трехстороннее рукопожатие (3-Way Handshake) со случайными начальными номерами (ISN) для защиты от спуфинга.
И это только малая часть… Всё это я планирую допиливать в свободное время, и если увижу интерес с вашей стороны — обязательно напишу продолжение.
Исходный код Protocol-7, эмулятор потерь на Python и скрипты бенчмарков выложены на GitHub: by-cortex/protocol-7. Буду рад звездочкам, ревью и форкам!
А если вам интересна тема сетей, низкоуровневого программирования, Linux и разработки других проектов — заглядывайте в мой маленький Telegram-канал @cortex_log. Там я делюсь процессом разработки в реальном времени, своими граблями и мыслями.
Также мне будет очень интересно ответить на любые вопросы и почитать конструктивную критику в комментариях. А пока…
Отправляю вам FIN и ухожу в TIME_WAIT :)


HyperWin
Обожаю подобные проекты, плюсик от меня. На досуге почитаю, а то много букавак:) я когда мелкий был то тоже пытался что то подобное сделать, только это было плюшево и несерьезно, а тут... масштаб
by_cortex Автор
Спасибо огромное за теплый отзыв и плюсик! Букав и правда получилось прилично, но очень хотелось показать весь путь и эволюцию проекта. Надеюсь, лонгрид не разочарует :)