

Привет, Хабр! Мы — студенты мастерской по сервисам и платформам ИИ Инженерно-математической школы НИУ ВШЭ и VK: Павел Алексеев, Александр Рожкин, Андрей Аргаткин, Алексей Павлов и Матвей Каменев. В этом проекте мы проверяли, как повысить качество моделей с линейным вниманием до уровня обычного трансформера. Такой механизм позволяет обрабатывать длинные последовательности без квадратичного роста вычислительных затрат. Это делает его перспективным для более экономного обучения языковых моделей и обработки длинных документов. При авторегрессионной генерации текста он помогает экономить память: вместо растущего KV-cache можно хранить состояние фиксированного размера.
Отправной точкой стала архитектура Dense Attention. Она использует простые матричные операции без softmax, но в опубликованных экспериментах показывает высокое качество. Наш руководитель Андрей Аргаткин в статье о Dense Attention задал новое направление исследования. Мы разберёмся, какие компоненты модели обеспечивают этот результат и можно ли перенести их на другие варианты внимания.
Рабочая гипотеза — линейные модели отстают по качеству не только из-за замены softmax, но и из-за архитектурных настроек и обучения. Число голов, позиционное кодирование и схема слоёв, подобранные для стандартного трансформера, не обязательно оптимальны для линейного механизма. Мы проверяли, сократят ли разрыв по качеству изменение этих компонентов и MLM-предобучение, если не возвращаться к глобальному softmax-вниманию.
Мотивация
Трансформеры стали одной из основных архитектур для моделирования последовательностей в глубоком обучении. Успехом они обязаны механизму self-attention, который позволяет учитывать глобальные зависимости между элементами входных данных. Но у стандартного внимания квадратичная вычислительная сложность  относительно длины последовательности
 . Это сильно увеличивает затраты на обучение и применение моделей при работе с длинным контекстом.
Обойти это ограничение могут помочь архитектуры линейного внимания (Linear Attention). Они аппроксимируют softmax-внимание или заменяют его альтернативной функцией сходства. Это позволяет изменить порядок вычислений и снизить сложность до  при фиксированных размерностях признаков и значений. Но при всех вычислительных преимуществах линейные модели нередко уступают классическим трансформерам по качеству. Особенно это заметно в задачах, требующих моделирования сложных зависимостей между удалёнными элементами последовательности.
Мы хотели повысить качество линейных моделей на задачах Long Range Arena (LRA) до уровня трансформерных моделей с квадратичной сложностью внимания или превзойти их, сохранив линейную вычислительную сложность по длине последовательности. В этой статье мы рассматриваем эксперименты на Pathfinder32. Мы проверяли позиционное кодирование, число голов внимания, чередование локальных и глобальных слоёв, MLM-предобучение, а также гибридное и полиномиальное внимание.
Почему мы выбрали двунаправленное внимание
Механизмы линейного внимания, о которых пойдёт речь, поддерживают как двунаправленный, так и каузальный режим. Мы исследовали двунаправленный режим, где представление каждого токена строится с учётом полного контекста. Это естественно для задач, где входная последовательность известна целиком: классификации, извлечения признаков и восстановления замаскированных элементов. Для авторегрессионной генерации вводится каузальное ограничение: каждый токен учитывает только текущую и предыдущие позиции. Так один механизм внимания подходит и для энкодерных моделей, и для моделей авторегрессионной генерации.
В односторонних рекуррентных архитектурах ради организации двунаправленной обработки нужно изменить вычислительную схему. Обычно для этого объединяют представления, полученные при прямом и обратном проходах, как, например, в Vision Mamba.
От стандартного внимания к линейному
Для одной головы стандартное внимание записывается в матричном виде:
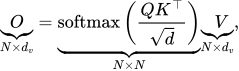
Здесь 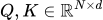 содержат запросы и ключи,
 — значения, а
 обозначает длину последовательности. Softmax применяется по строкам. Размер матрицы попарных оценок —
 , поэтому сложность вычислений квадратична по
 при фиксированных
 и
 .
В линейном внимании сходство задаётся скалярным произведением  . Преобразование признаков
 называют feature map. Такое сходство может аппроксимировать экспоненциальное ядро, но это не обязательное условие. Пусть
 переводит каждый запрос и ключ в вектор размерности
 . Тогда благодаря ассоциативности матричного умножения взвешенную сумму значений можно вычислить без матрицы
 :
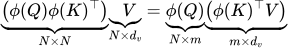 .
В правой части сначала вычисляем матрицу  : её размер
 не зависит от длины входа. В стандартном внимании такую перегруппировку не даёт сделать softmax между двумя умножениями.
С учётом нормирующего знаменателя выход для токена  выглядит так:
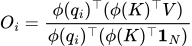 .
Здесь  — вектор-столбец запроса, а
 состоит из
 единиц. В двунаправленном режиме
 и
 вычисляются один раз по всей последовательности и используются для всех запросов. Агрегация и вычисление выходов требуют
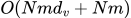 операций. Если размерности фиксированы, а
 применяется независимо к каждому токену, общая сложность линейна по длине входа:
 .
Что мы проверяли
Эта вычислительная схема объясняет преимущества линейного внимания, но сама по себе не гарантирует высокого качества. В двунаправленном режиме глобальное внимание даёт каждому токену доступ ко всему входу. Однако модели ещё нужно учитывать порядок токенов и выделять полезные связи между ними. Поэтому в экспериментах мы проверяли не только функцию сходства, но и позиционное кодирование, устройство слоёв и способ обучения.
Позиционная информация
Если запросы и ключи не содержат позиционной информации, функция  сравнивает признаки токенов, не учитывая их расположения. Поэтому один из первых вопросов — как передать модели информацию о позициях. В базовом поиске Dense Attention мы сравнивали три подхода: фиксированное синусоидальное кодирование, обучаемые позиционные эмбеддинги и Rotary Position Embedding, или RoPE.
В отличие от аддитивного позиционного кодирования, RoPE поворачивает запросы и ключи так, что позиционная часть их скалярного произведения зависит от разности индексов токенов. Нелинейная feature map может изменить эту зависимость. Поэтому для Linear Transformer мы также проверяли, как порядок применения RoPE и feature map влияет на качество.
Локальный и глобальный контекст
Позиционное кодирование сообщает модели о расположении токенов, но не ограничивает область их взаимодействия. Глобальное внимание связывает любые позиции, тогда как локальный слой обрабатывает только токены внутри одного окна. За основу мы взяли схему Local-LocalShifted-Global, которую Андрей Аргаткин описал в статье о Dense Attention.
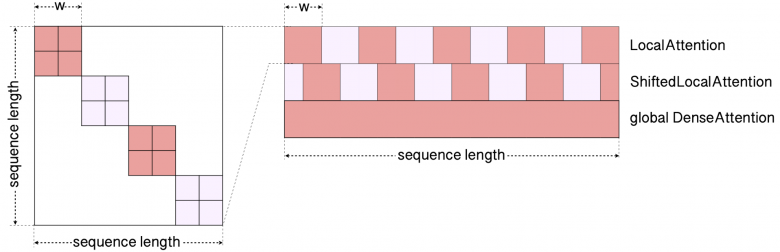
Здесь чередуются локальный, сдвинутый локальный и глобальный слои. Это позволяет отдельно обрабатывать ближайшее окружение и обмениваться информацией между удалёнными участками последовательности. Мы проверяли, улучшает ли эта схема качество по сравнению с моделью, использующей только глобальные слои.
Здесь локальные окна нужны прежде всего для обработки локальных зависимостей, а не для изменения уже линейной асимптотики. Дополнительно мы проверяли, улучшит ли качество замена линейного внимания внутри окон на softmax. Так появилась гибридная конфигурация: глобальные слои сохраняют Dense Attention, а локальные используют softmax для обработки ближайшего окружения.
Число голов и предобучение
Помимо области взаимодействия токенов, мы меняли число голов внимания. При фиксированном hidden size это меняет и размерность каждой головы. Для hidden size 128 восемь голов работают с векторами размерности 16, а одна использует все 128 компонент. Несколько голов позволяют вычислять разные оценки сходства, а одна широкая голова использует больше признаков в каждой оценке. Поэтому мы сравнивали оба варианта, не предполагая, что увеличение числа голов обязательно улучшит результат.
Идею проверить предобучение мы почерпнули из работы Never Train from Scratch. Там предобучение повысило качество моделей на LRA и сократило разрыв между трансформерами и SSM. В отличие от классификации с одной меткой на всю последовательность, Masked Language Modeling (MLM) обучает модель восстанавливать замаскированные элементы по контексту с обеих сторон. Мы проверяли, поможет ли это сформировать полезные для классификации представления у выбранных одноголовой и восьмиголовой Dense-конфигураций и сохранится ли после предобучения соотношение между их результатами.
Функция сходства и нормировка
Ещё один вопрос касался выбора самой функции сходства. В серии SymPower мы рассмотрели полиномиальное ядро из работы Symmetric Power Transformers. В нём скалярное произведение запросов и ключей возводится в степень  . Чем выше степень, тем сильнее различаются большие и малые по модулю оценки. Это может помочь модели выделять отдельные взаимодействия без softmax.
Одновременно меняется масштаб результата, поэтому степень ядра мы рассматривали вместе с масштабированием и нормировкой выхода внимания. Нас интересовало, какие сочетания этих настроек дают высокое качество при обучении с нуля, без MLM.
Задача и условия экспериментов
Мы использовали Pathfinder32 из бенчмарка Long Range Arena. Здесь нужно определить, принадлежат ли две отмеченные точки одному пути на изображении размером 32 на 32 пикселя. Модель получает одномерную последовательность из 1 024 значений пикселей без явно заданной двумерной структуры. Задача требует учитывать как локальное продолжение линий, так и связи между удалёнными участками. Метрика качества: доля правильных ответов, accuracy; уровень случайного угадывания составляет 50%.
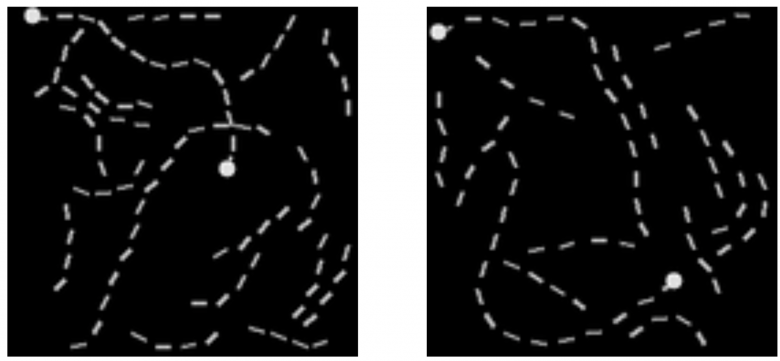
В сериях Dense Attention, гибридной модели, SymPower и обычного трансформера модели обучали классификации в течение 210 эпох с batch size 100. Использовались hidden size 128, GELU, максимальный learning rate  и weight decay 0,1. Расписание LR задавало цикл длиной 320 000 шагов. За первые 32 000 шагов learning rate линейно увеличивался до
 , затем оставался постоянным до начала следующего цикла. Оптимизатором был AdamW с
 : для базовых Dense, SymPower и трансформера использовалось
 , для итоговых 9L и гибрида
 . Seed был равен 100. В Dense и гибриде для классификации использовалось представление первого токена.
В таблицах — максимальные значения test accuracy по доступным эпохам и запускам. Там, где есть результаты повторных запусков одной конфигурации, дополнительно указаны среднее, выборочное стандартное отклонение (std) и число запусков n. Для их расчёта от каждого запуска берётся его максимальная test accuracy по эпохам. Запись «среднее ± std» показывает среднее в процентах и разброс между запусками в процентных пунктах.
Dense Attention и локальные окна
Начнём с Dense Attention, на которой мы проверяли основные архитектурные настройки. В этом механизме нет softmax, нелинейной feature map и деления на сумму весов. Входные представления X служат ключами и значениями, а для запросов применяется обучаемая матрица  :
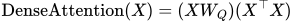 .
Размер  не зависит от длины входа, поэтому вычисления линейны по
 при фиксированной ширине модели. Здесь нет отдельных проекций ключей и значений — это дополнительно сокращает число параметров.
У базовых моделей — шесть слоёв, hidden size 128 и FFN expansion 1. Мы сравнили одну и восемь голов, три вида позиционного кодирования и две схемы: только глобальные слои или чередование локальных, сдвинутых локальных и глобальных. Всего 12 конфигураций.
Локальные слои использовали окна по 256 токенов. Сдвинутые локальные слои смещали границы окон на 128, чтобы объединять информацию из соседних локальных областей предыдущего слоя. Это окна в одномерной последовательности пикселей, а не квадратные области изображения.
Результаты базового поиска
Базовые модели мы обучали с нуля: исходные запуски проводились в FP16, последующие — в BF16. В таблице приведены результаты с синусоидальным кодированием, обучаемыми эмбеддингами и RoPE.
Число голов |
Позиционное кодирование |
Только глобальные слои, % |
Глобальные и локальные слои, % |
|---|---|---|---|
1 |
Синусоидальное |
50,05 |
50,05 |
1 |
Обучаемое |
70,92 |
50,32 |
1 |
RoPE |
79,12 |
84,96 |
8 |
Синусоидальное |
50,05 |
50,05 |
8 |
Обучаемое |
50,06 |
50,05 |
8 |
RoPE |
86,45 |
87,99 |
Синусоидальное кодирование в наших запусках не позволило моделям выйти за уровень случайного угадывания. Обучаемые эмбеддинги дали заметно лучший результат только в одноголовом варианте без локальных слоёв. RoPE работал во всех четырёх конфигурациях, а наибольшую accuracy в этой группе дали восемь голов и локальные окна.
Базовый поиск выделил две конфигурации для дальнейшей работы: одну и восемь голов с RoPE и локальными окнами. При обучении с нуля более высокий результат давали восемь голов. Далее мы проверили, сохранится ли это соотношение после предобучения.
Предобучение и число голов
Для MLM-предобучения мы использовали одномерные последовательности из 1 024 значений пикселей Pathfinder32. Маскированные примеры формировались на лету. При загрузке примера каждый элемент последовательности с вероятностью 0,5 заменялся специальным маскирующим токеном. Модель училась предсказывать исходные значения замаскированных элементов по остальной последовательности. На этом этапе мы не применяли классификационные метки. После предобучения полученные веса мы использовали для инициализации модели, которую затем дообучали на классификацию Pathfinder32.
Мы выбрали конфигурации с RoPE и локальными окнами. В сравнении у обеих моделей шесть слоёв, FFN expansion 1 и они обе используют BF16.
Число голов |
Обучение с нуля, % |
После MLM, % |
|---|---|---|
1 |
84,96 |
90,52 |
8 |
87,99 |
88,83 |
При обучении с нуля восьмиголовая модель показала более высокую accuracy. После MLM лучше оказалась одноголовая. Её результат вырос на 5,56 процентного пункта, а у восьмиголовой прирост составил 0,84 пункта.
Это отвечает на вопрос о совместном выборе числа голов и способа обучения. После MLM восьмиголовая модель уступила одноголовой, хотя её собственная accuracy тоже выросла. В следующих экспериментах с более ёмкой Dense Attention мы использовали одну голову и предобучение. При этом MLM добавляет отдельный этап обучения, поэтому результаты с ним и без него получены при разных вычислительных затратах.
Модель 9L и гибридное внимание
Следующий вопрос — какого качества достигнет Dense Attention, если по числу параметров будет сопоставима с нашей шестислойной реализацией трансформера? При одинаковом числе слоёв, hidden size и размере FFN BERT на основе Dense Attention содержит меньше параметров. В его блоках внимания нет отдельных обучаемых проекций ключей и значений, а также выходной проекции. Поэтому у девятислойной Dense Attention 1,36 млн параметров, а у нашего трансформера — 1,24 млн. Шесть слоёв, hidden size 128 и промежуточная размерность FFN 512 соответствуют конфигурации Transformer + RoPE для Pathfinder из работы Never Train from Scratch (таблица 4).
Относительно базовой Dense Attention мы увеличили число слоёв с шести до девяти, а FFN expansion — с 1 до 4. При hidden size 128 промежуточная размерность FFN стала равна 512. В модели сохранили одну голову и RoPE, а размер локального окна изменили на 64.
Одновременно мы изменили нормировки. Стандартный LayerNorm использовался на уровне эмбеддингов, на выходе модели, а также до и после внимания в глобальных и локальных слоях. Обучение проводилось в BF16. Dropout был отключён, а AdamW работал с  . Для классификации загружались веса из MLM-чекпойнта после 201-й эпохи предобучения.
В трёх повторных запусках этой конфигурации с  средняя test accuracy составила 95,00 ± 0,21%, а лучший результат достиг 95,17%. Здесь менялась не только глубина: вместе с ней мы изменили FFN, нормировки, локальное окно и настройки обучения. Поэтому результат характеризует итоговую конфигурацию сопоставимого с трансформером размера, а не отдельный эффект добавления трёх слоёв.
Локальный softmax в гибридной модели
Локальные окна в предыдущих моделях ограничивали область взаимодействия токенов, но внутри окна по-прежнему работал Dense Attention. В гибридной модели мы проверили, повысится ли качество, если взять обычный softmax для локальной обработки. Глобальные слои сохранили Dense Attention с одной головой, а локальные и сдвинутые локальные слои получили softmax-внимание с восемью головами.
Для softmax внутри окон размером W вычислительная сложность по длине последовательности составляет O(NW) при фиксированной размерности представлений. Если W фиксирован, эта стоимость линейна по N.
В итоговом гибриде было семь слоёв и окно размером 256. Как и в 9L, мы взяли FFN expansion 4, стандартные LayerNorm, BF16 и AdamW с  , а dropout отключили. Гибрид также дообучали после MLM, с весами из чекпойнта эпохи 201.
Модель |
Параметры |
Размер окна |
MLM |
n |
Среднее ± std, % |
Максимум, % |
|---|---|---|---|---|---|---|
Dense Attention 9L |
1 363 712 |
64 |
Да |
3 |
95,00 ± 0,21 |
95,17 |
Гибрид 7L |
1 314 048 |
256 |
Да |
— |
— |
97,13 |
Для гибрида данные по повторным запускам этой конфигурации недоступны, поэтому среднее и std не указаны.
Гибрид показал лучший результат среди наших Dense-конфигураций, хотя параметров у него немного меньше, чем у 9L. Гибрид отличается от 9L не только типом локального внимания, но и числом слоёв и размером окна. Таблица сравнивает две итоговые конфигурации, а не изолированный эффект замены Dense на softmax.
RoPE и локальные слои улучшили качество Dense Attention. Далее мы проверили, помогают ли они в Linear Transformer, где к запросам и ключам применяется нелинейная feature map.
RoPE в Linear Transformer
В отдельной серии мы взяли Linear Transformer с преобразованием признаков 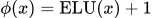 . В отличие от Dense Attention, здесь запросы и ключи проходят через нелинейное преобразование. Поэтому влияние RoPE нужно было проверить заново. Мы сравнивали одну и восемь голов, обучаемые позиционные эмбеддинги и RoPE, а также варианты с локальным вниманием и без него.
Когда RoPE стоял до feature map, модели в наших запусках оставались около 50% accuracy. С обучаемыми позиционными эмбеддингами часть конфигураций обучалась и превышала 80%. Это отличие от Dense Attention заставило нас рассмотреть не только выбор позиционного кодирования, но и порядок операций внутри внимания.
Вращение до и после преобразования признаков
Обозначим через  матрицу поворота RoPE для позиции
 . Тогда для запроса и ключа на позициях
 и
 выполняется равенство:
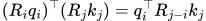 .
Позиционная часть скалярного произведения зависит от разности индексов. Но если после вращения применить нелинейную feature map, результат уже не обязан сохранять эту форму:  и
 в общем случае не совпадают. Поэтому для преобразования на основе ELU нельзя напрямую перенести рассуждение, справедливое для обычного скалярного произведения. Позиционная информация не исчезает полностью, но участвует в вычислении сходства иначе.
Мы проверили обратный порядок: сначала feature map, затем RoPE. При таком вычислении вращённые признаки могут давать отрицательные оценки сходства. Если их использовать и в знаменателе, положительные и отрицательные слагаемые могут компенсировать друг друга. Деление на малую величину создаёт риск нестабильности. В этом варианте мы отключили знаменатель настройкой no_reweight.
Для глобального двунаправленного внимания выход принимает вид
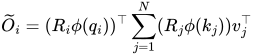 .
Результаты изменения порядка RoPE
Ниже — результаты конфигураций с одной и восемью головами внимания. Среднее и std мы рассчитали по всем результатам из сводки запусков, включая неудачные;  — число этих запусков. Во всех вариантах с RoPE вращение шло после feature map, а нормирующий знаменатель был отключён.
Число голов |
Позиционное кодирование |
Локальное внимание |
n |
Среднее ± std, % |
Максимум, % |
|---|---|---|---|---|---|
1 |
Обучаемые эмбеддинги |
Нет |
7 |
81,15 ± 2,27 |
84,04 |
1 |
Обучаемые эмбеддинги |
Есть |
6 |
65,05 ± 16,68 |
84,40 |
1 |
RoPE после feature map |
Нет |
2 |
50,00 ± 0,00 |
50,00 |
1 |
RoPE после feature map |
Есть |
5 |
50,80 ± 1,79 |
54,00 |
8 |
Обучаемые эмбеддинги |
Нет |
5 |
70,39 ± 16,55 |
85,10 |
8 |
Обучаемые эмбеддинги |
Есть |
6 |
65,90 ± 17,44 |
83,20 |
8 |
RoPE после feature map |
Нет |
2 |
77,10 ± 3,68 |
79,70 |
8 |
RoPE после feature map |
Есть |
4 |
84,00 ± 0,96 |
85,10 |
Когда мы перенесли RoPE после feature map и отключили знаменатель, восьмиголовая модель смогла обучиться. В исходном варианте она оставалась около случайного угадывания. С локальными слоями она показала лучшее среднее в этой серии: 84,00 ± 0,96% при максимуме 85,10%. Эта конфигурация выиграла у обучаемых эмбеддингов и по средней, и по максимальной accuracy при том же числе голов и той же схеме слоёв.
Для одной головы та же схема не дала сопоставимого качества: лучшие результаты оставались на уровне 50–54%. Преимущество RoPE проявилось в сочетании с подходящим порядком преобразований, нормировкой и конфигурацией модели.
SymPower и нормировка выхода внимания
Затем мы проверили, что даст замена самого ядра внимания. В полиномиальном механизме на основе Symmetric Power Transformers, далее SymPower, сходство определяется степенью скалярного произведения запросов и ключей:
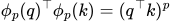 .
Увеличение p усиливает относительные различия между большими и малыми по модулю оценками. При нечётной степени знак сохраняется. Разложение через  позволяет взять линейный порядок вычислений, но размерность признаков растёт со степенью. Поэтому при фиксированном p асимптотика остаётся линейной по длине входа. Но выигрыш по затратам перед квадратичным вычислением может исчезнуть.
RoPE мы применяем к запросам и ключам до вычисления ядра. Тогда сходство принимает вид  и сохраняет относительную позиционную зависимость.
Что мы меняли
Во всех SymPower-экспериментах мы брали шесть слоёв, восемь голов, hidden size 128 и FFN expansion 4. Мы обучали модели в BF16 с нуля, без MLM, с RoPE и только глобальными слоями внимания.
Мы сравнивали степени  и
 , масштабирование ядра d_scale и нормировку выхода post_norm. Во всех восьми конфигурациях было включено
no_reweight=True: деления на сумму весов не было. До дополнительной нормировки выход имеет вид
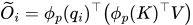 .
Здесь  и
 — запросы и ключи с уже применённым RoPE; мы опустили постоянные коэффициенты масштабирования для краткости.
d_scale масштабирует вычисление ядра с учётом размерности головы. Мы проверяли его как способ ограничить рост величин при возведении скалярных произведений в степень.
post_norm применяется после агрегации значений прямо к вектору  . В нашей конфигурации это LayerNorm на выходе каждой головы внимания. Он нормирует компоненты выходного вектора, а не сумму весов по токенам. Этим нормировка выходного вектора отличается от деления на сумму весов в стандартном линейном внимании.
Результаты SymPower
Степень p |
d_scale |
post_norm |
Test accuracy, % |
|---|---|---|---|
2 |
Нет |
Нет |
77,18 |
2 |
Да |
Нет |
76,94 |
2 |
Нет |
Да |
81,85 |
2 |
Да |
Да |
84,90 |
3 |
Нет |
Нет |
86,80 |
3 |
Да |
Нет |
81,31 |
3 |
Нет |
Да |
96,18 |
3 |
Да |
Да |
96,68 |
В каждой из четырёх пар настроек кубическое ядро ( ) показало более высокую accuracy, чем квадратичное (
 ). Для
 особенно полезной оказалась нормировка выхода. Без d_scale она подняла accuracy с 86,80 до 96,18%, а с d_scale — с 81,31 до 96,68%.
Само по себе d_scale качество не улучшало. Без post_norm оно немного снижало accuracy для  и заметнее для
 . Но вместе с нормировкой выхода масштабирование давало лучший результат для обеих степеней. Поэтому эти настройки стоит подбирать вместе.
Лучшая конфигурация достигла 96,68% без MLM. По accuracy она близка к гибридной модели с 97,13% после предобучения. Но модели различаются архитектурой и обучением. Поэтому мы сравниваем итоговые конфигурации, а не оцениваем отдельно влияние механизма внимания.
Результаты согласуются с предположением, что более контрастные оценки сходства полезно сочетать с нормировкой агрегированного вектора. Но они не позволяют отдельно установить причину выигрыша кубического ядра. В этой серии мы наблюдаем преимущество сочетания  и post_norm. Эффект удаления знаменателя мы здесь не измеряли: он был отключён во всех запусках.
Сравнение с обычным трансформером
Для обычного трансформера с softmax-вниманием мы провели аналогичный поиск по числу голов, позиционному кодированию и схеме слоёв. У моделей было шесть слоёв, hidden size 128 и FFN expansion 4. Мы обучали их с нуля, без MLM. В таблице собраны все восемь конфигураций, и для каждой указан максимум test accuracy за 210 эпох одного запуска.
Число голов |
Позиционное кодирование |
Только глобальные слои, % |
Глобальные и локальные слои, % |
|---|---|---|---|
1 |
Обучаемое |
72,06 |
50,07 |
1 |
RoPE |
96,10 |
93,93 |
8 |
Обучаемое |
83,40 |
89,12 |
8 |
RoPE |
98,77 |
97,04 |
RoPE заметно улучшил качество и обычного трансформера. Но локальные слои в моделях с RoPE снижали accuracy: на 2,17 процентного пункта для одной головы и на 1,73 для восьми. У базовых Dense-моделей то же изменение, напротив, давало прирост на 5,84 и 1,54 пункта соответственно. С обучаемыми эмбеддингами локальные слои помогли восьмиголовому трансформеру, но одноголовая модель осталась около случайного угадывания. Переход к одной голове не улучшил ни один из рассмотренных вариантов трансформера.
Лучший softmax-вариант использовал восемь голов, RoPE и только глобальные слои при 1,24 млн параметров. Максимума — 98,77% — модель достигла на эпохе 202. На всех последних 10 эпохах accuracy оставалась в диапазоне 98,53–98,77%. Локальные слои, полезные для Dense Attention с RoPE, не улучшили уже сильную softmax-конфигурацию. Эффект MLM для трансформера в этой серии мы не проверяли.
Итоги
Эксперименты на Pathfinder32 подтвердили нашу основную гипотезу: качество линейных моделей зависит не только от замены softmax, но и от согласованного выбора архитектуры и обучения.
RoPE оказался лучшим позиционным кодированием для Dense Attention в базовом поиске. Но прямой перенос в Linear Transformer не сработал. Улучшение дали вращение после feature map и отключение знаменателя, причём только для восьмиголовых моделей
Локальные и глобальные слои улучшили Dense Attention с RoPE, но снизили качество трансформера с RoPE. Лучшей Dense-конфигурацией стал гибрид с глобальным линейным и локальным softmax-вниманием
MLM и число голов. Предобучение улучшило обе проверенные Dense-конфигурации с RoPE и локальными слоями: до MLM лучше работали восемь голов, после него — одна. Универсального преимущества ни у одного числа голов не было
SymPower. Кубическое ядро превосходило квадратичное во всех проверенных сочетаниях настроек, а нормировка выхода дополнительно повышала качество. Самостоятельная польза d_scale не подтвердилась: масштабирование помогало только вместе с post_norm. Лучший результат мы получили без MLM
Ниже собраны лучшие результаты наших моделей и опубликованные оценки. Размеры моделей, обучение и протоколы оценки различаются: это сопоставление качества, а не вычислительных бюджетов.
Модель |
Результат из публикации, % |
Наш максимум, % |
Наше среднее ± std, % |
|---|---|---|---|
76,64 |
— |
— |
|
94,16 |
— |
— |
|
94,20 |
— |
— |
|
94,92 |
— |
— |
|
96,23 |
— |
— |
|
96,01 |
— |
— |
|
94,41 |
— |
— |
|
S5, ICLR 2023 |
95,33 |
— |
— |
HOPE-SSM, ICLR 2025 |
95,73 |
— |
— |
S4D-FT, ICLR 2025 |
95,89 |
— |
— |
B₂S₆, препринт 2025 |
95,93 |
— |
— |
Transformer + RoPE с изменённым обучением, препринт 2025 |
96,28 |
— |
— |
Linear Transformer + RoPE, 8 голов, локальные слои |
— |
85,10 |
84,00 ± 0,96 ( |
Dense Attention 9L + MLM |
— |
95,17 |
95,00 ± 0,21 ( |
SymPower, |
— |
96,68 |
— |
Гибрид 7L + MLM |
— |
97,13 |
— |
Transformer + RoPE, 8 голов, глобальные слои, обучение с нуля |
— |
98,77 |
— |
 )
 )
 , обучение с нуля
Гибрид достиг 97,13% и приблизился к нашему трансформеру с 98,77% при сопоставимом числе параметров. Превзойти его не удалось, но и без глобального softmax модель показала высокое качество. Dense Attention и гибрид при этом сохраняют линейную сложность по длине входа при фиксированных ширине модели и размере окна. Найденные решения заметно улучшили линейные модели, но не стали универсальным рецептом для любого механизма внимания.