

Последний год я переписываю Vigo Pulse, аналитический продукт с большим количеством метрик и разрезов. Пользователь может выбирать фильтры, группировки и период, а на одном графике могут оказаться сотни линий. Загрузка и отрисовка такого объёма данных давно были проблемной областью.
Я отвечаю за фронтенд и BFF на Node.js. При переработке приложения я решил пересмотреть весь путь от выбора фильтров до появления графика на экране. Для этого нужно было понять, как выбирать данные, в каком виде передавать их в браузер и что делать, когда линий становится слишком много. Ниже расскажу, какие варианты проверил и к чему пришёл.
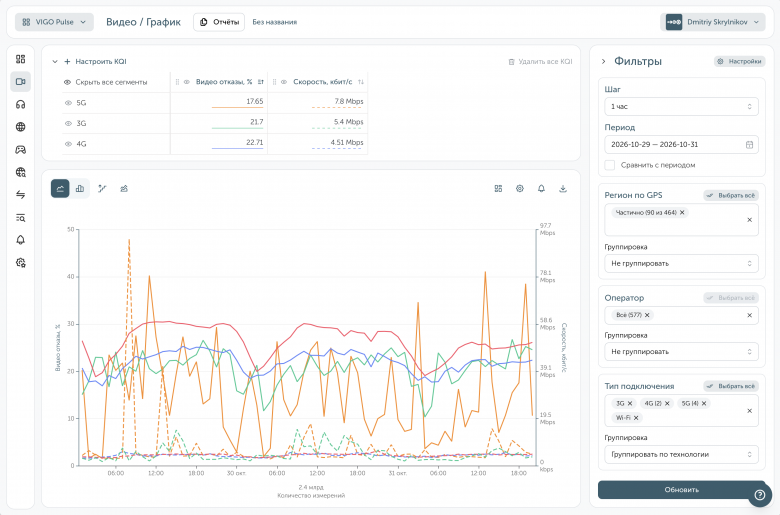
Как графики работали раньше
Загрузка графиков выглядела так. Фронтенд отправлял запрос в BFF. Тот проверял корректность запроса и права пользователя, преобразовывал запрос в формат бэкенда и через RabbitMQ передавал его Java-сервису. Java-сервис получал данные из ClickHouse и сохранял их в S3. BFF забирал данные из S3, преобразовывал в формат для фронтенда и возвращал ответ.
Ответ BFF выглядел так:
{
  "data": [
    {"time": 1791021600, "key": {"operator": 1}, "value": {"s": 850, "b": 12.37}},
    {"time": 1791021600, "key": {"operator": 2}, "value": {"s": 700, "b": 10.93}},
    {"time": 1790971200, "key": {"operator": 1}, "value": {"s": 900, "b": 12.58}},
    {"time": 1790971200, "key": {"operator": 2}, "value": {"s": 600, "b": 11.2}}
  ]
}
Данные не были отсортированы по времени. Время, ключ сегмента и имена метрик повторялись много раз.
Далее фронтенд сортировал ответ по времени, подготавливал серии и отрисовывал графики с помощью Highcharts.
Ответы для сложных графиков за большой период получались объёмными. Фронтенд тратил время на парсинг JSON, сортировку и преобразование в нужный формат. Я решил попробовать изменить формат ответа и проверить, поможет ли это уменьшить его размер и упростить подготовку графика.
Какой формат ответа выбрать
Для сравнения форматов я написал демо. В таблицах указана медиана 20 измерений времени от запроса до готовых серий, без отрисовки графика.
Демка, методика и тестовые наборы
Генератор хранит общий набор перемешанных наблюдений {time, metric, segment, value}. Сервер заново преобразует его в каждый формат ответа. Преобразование и сериализация входят в измерения, генерация исходного набора — нет.
Сервер и Chromium работали на одном Mac с Apple M3 Pro. Использовал Node.js 24.13.0, Chromium 156 и production-сборку. Запросы выполнялись последовательно. Перед измерениями каждое сочетание один раз прогревал. Прогревочные запросы в результаты не включал.
Все размеры приведены в десятичных единицах. Для ответа использую КБ (1000 байт), для памяти — МБ (1 000 000 байт).
Потребление памяти измерял отдельными прогонами. Δ RSS показывает прирост резидентной памяти за запрос. Для Node.js это максимальное значение среди снимков по этапам минус значение перед запросом. Для Chromium — значение после подготовки серий минус значение перед запросом. Сначала вычисляется разность внутри каждой попытки, затем берётся медиана.
Нулевой прирост RSS означает, что в медианном замере процесс использовал уже выделенные страницы памяти. Кратковременный пик между снимками мог остаться незамеченным.
Взял небольшой и большой набор данных, чтобы сравнить поведение форматов при разном объёме ответа. В обоих случаях временная сетка регулярная, пропусков нет.
Набор |
Метрик |
Сегментов |
Точек на серию |
Всего значений |
|---|---|---|---|---|
Малый |
2 |
3 |
60 |
360 |
Большой |
16 |
32 |
1440 |
737 280 |
Что даст группировка точек по ключу?
Сначала я попробовал сгруппировать точки по ключу.
{
  "data": [
    {
      "key": {"operator": 1},
      "serie": [
        {"time": 1791021600, "s": 850, "b": 12.37},
        {"time": 1790971200, "s": 900, "b": 12.58}
      ]
    },
    {
      "key": {"operator": 2},
      "serie": [
        {"time": 1791021600, "s": 700, "b": 10.93},
        {"time": 1790971200, "s": 600, "b": 11.2}
      ]
    }
  ]
}
Таким образом удаётся избавиться от повторяющегося ключа. Подготавливать такой массив для отрисовки проще, но остаются повторяющиеся имена метрик и поле time.
Набор |
Формат |
Ответ, КБ |
Время, мс |
Δ RSS Node.js, МБ |
Δ RSS Chrome, МБ |
|---|---|---|---|---|---|
Малый |
Строки |
17,2 |
0,7 |
0 |
0,23 |
Малый |
Сгруппированные точки |
11,4 |
0,7 |
0 |
0,18 |
Большой |
Строки |
18 414 |
349 |
18,8 |
107 |
Большой |
Сгруппированные точки |
15 418 |
296 |
15,4 |
123 |
Группировка убрала повторяющиеся ключи. На большом наборе ответ уменьшился примерно на 16%, а время — на 15%. При этом прирост RSS браузера не уменьшился, поэтому одной группировки недостаточно для выигрыша по всем показателям.
Что дадут колонки?
Побрейнштормив с LLM, я пришёл к такому формату.
{
  "key": {
    "operator":[1,2]
  },
  "time":[1790971200, 1791021600],
  "series": {
    "s":[[900, 850], [600, 700]],
    "b": [[12.58,12.37], [11.2, 10.93]]
  }
}
Значение series.s[i][j] соответствует метрике s для key.operator[i] в момент time[j]. В таком случае ключи и имена метрик больше не повторяются в каждой точке. Значения уже сгруппированы по метрикам и ключам и расположены в порядке общей временной сетки. Перед отрисовкой их не нужно заново группировать и сортировать. В колоночном формате отсутствующие значения приходится заполнять null. Для разреженных данных это создаёт дополнительные накладные расходы.
Набор |
Формат |
Ответ, КБ |
Время, мс |
Δ RSS Node.js, МБ |
Δ RSS Chrome, МБ |
|---|---|---|---|---|---|
Малый |
Строки |
17,1 |
0,7 |
0 |
0,23 |
Малый |
Колонки |
4,25 |
0,6 |
0 |
0,16 |
Большой |
Строки |
18 414 |
349 |
18,8 |
107 |
Большой |
Колонки |
4 927 |
170 |
4,93 |
73,2 |
На большом наборе колонки уменьшили ответ почти в 4 раза, а время до готовых серий — примерно вдвое. Прирост RSS также оказался ниже и на сервере, и в браузере.
Помогают ли колонки, если уже есть gzip?
Изначально у меня было подозрение, что gzip может свести экономию к нулю. При изменении формата мы избавляемся от повторяющихся полей, которые и так должны хорошо сжиматься. Поэтому я протестировал всё то же самое, но с gzip.
Набор |
Формат |
Сжатие |
Ответ, КБ |
Время, мс |
Δ RSS Node.js, МБ |
Δ RSS Chrome, МБ |
|---|---|---|---|---|---|---|
Малый |
Строки |
Без сжатия |
17,2 |
0,7 |
0 |
0,23 |
Малый |
Колонки |
Без сжатия |
4,25 |
0,6 |
0 |
0,16 |
Малый |
Строки |
gzip |
2,29 |
0,9 |
0,00 |
0,23 |
Малый |
Колонки |
gzip |
1,50 |
0,7 |
0,00 |
0,15 |
Большой |
Строки |
Без сжатия |
18 414 |
349 |
18,8 |
107 |
Большой |
Колонки |
Без сжатия |
4 927 |
170 |
4,93 |
73,3 |
Большой |
Строки |
gzip |
2 701 |
536 |
18,8 |
129 |
Большой |
Колонки |
gzip |
811 |
235 |
4,93 |
77,4 |
По размеру ответа преимущество колонок сохраняется. На большом наборе сжатый колоночный ответ оказался примерно в 3 раза меньше строчного. На локальном соединении затраты на компрессию увеличивают общее время. Дальше проверю, окупаются ли они при ограниченной скорости передачи.
Можно ли не передавать массив времени?
Так как шаг и период фиксированы, можно было бы пойти дальше и не отправлять массив со временем.
Набор |
Время |
Сжатие |
Ответ, КБ |
Время, мс |
Δ RSS Node.js, МБ |
Δ RSS Chrome, МБ |
|---|---|---|---|---|---|---|
Малый |
Массив |
Без сжатия |
4,25 |
0,6 |
0 |
0,16 |
Малый |
Вычисляемое |
Без сжатия |
3,60 |
0,6 |
0 |
0,15 |
Малый |
Массив |
gzip |
1,50 |
0,7 |
0 |
0,15 |
Малый |
Вычисляемое |
gzip |
1,36 |
0,7 |
0 |
0,15 |
Большой |
Массив |
Без сжатия |
4 927 |
170 |
4,93 |
73,3 |
Большой |
Вычисляемое |
Без сжатия |
4 912 |
167 |
4,92 |
72,1 |
Большой |
Массив |
gzip |
811 |
235 |
4,93 |
77,4 |
Большой |
Вычисляемое |
gzip |
807 |
236 |
4,92 |
74,5 |
На большом наборе отказ от массива времени уменьшил gzip-ответ примерно на 0,5%. Медиана времени практически не изменилась. Для этого сценария дополнительное усложнение формата даёт небольшой выигрыш. Поэтому я решил оставить массив времени.
Что добавляют другие алгоритмы сжатия?
После gzip решил проверить и другие алгоритмы сжатия. Взял gzip level 6, deflate level 6, Brotli quality 4 и Zstandard level 3.
Набор |
Сжатие |
Строки, КБ |
Колонки, КБ |
Время строк, мс |
Время колонок, мс |
|---|---|---|---|---|---|
Малый |
Без сжатия |
17,2 |
4,25 |
0,7 |
0,6 |
Малый |
gzip |
2,29 |
1,50 |
0,9 |
0,7 |
Малый |
Brotli |
2,23 |
1,43 |
1,0 |
0,7 |
Малый |
deflate |
2,28 |
1,49 |
1,0 |
0,7 |
Малый |
Zstandard |
2,46 |
1,51 |
1,0 |
0,7 |
Большой |
Без сжатия |
18 414 |
4 927 |
349 |
170 |
Большой |
gzip |
2 701 |
811 |
536 |
235 |
Большой |
Brotli |
2 710 |
791 |
462 |
195 |
Большой |
deflate |
2 700 |
811 |
540 |
238 |
Большой |
Zstandard |
2 885 |
888 |
397 |
186 |
При выбранных настройках минимальный размер колонок дал Brotli. Среди сжатых вариантов минимальное локальное время показал Zstandard. На малом наборе различия времени слишком малы для уверенного ранжирования.
А если вместо JSON взять бинарный формат?
Затем решил проверить бинарные форматы вместо JSON. Сравнивал их только на колоночной структуре данных.
Размер тела ответа, КБ:
Набор |
Сериализатор |
Без сжатия |
gzip |
Brotli |
deflate |
Zstd |
|---|---|---|---|---|---|---|
Малый |
JSON |
4,25 |
1,50 |
1,43 |
1,49 |
1,51 |
Малый |
MessagePack |
3,81 |
2,02 |
2,13 |
2,00 |
2,11 |
Малый |
BSON |
5,54 |
2,79 |
2,54 |
2,78 |
2,72 |
Большой |
JSON |
4 927 |
811 |
791 |
811 |
888 |
Большой |
MessagePack |
4 987 |
984 |
803 |
984 |
845 |
Большой |
BSON |
8 729 |
3 185 |
2 235 |
3 185 |
2 156 |
Время до готовых серий, мс:
Набор |
Сериализатор |
Без сжатия |
gzip |
Brotli |
deflate |
Zstd |
|---|---|---|---|---|---|---|
Малый |
JSON |
0,6 |
0,7 |
0,7 |
0,7 |
0,7 |
Малый |
MessagePack |
0,6 |
0,7 |
0,7 |
0,8 |
0,7 |
Малый |
BSON |
0,6 |
0,9 |
0,8 |
0,8 |
0,8 |
Большой |
JSON |
170 |
235 |
195 |
238 |
186 |
Большой |
MessagePack |
132 |
170 |
154 |
176 |
149 |
Большой |
BSON |
242 |
422 |
281 |
427 |
274 |
На большом наборе MessagePack оказался быстрее JSON во всех локальных сочетаниях. При этом размер зависит от компрессора: с gzip он примерно на 21% больше JSON, а с Zstandard — примерно на 5% меньше. BSON для этой структуры оказался объёмнее и медленнее.
Что меняется на медленной сети?
Локальные тесты показывают затраты на подготовку и обработку ответа, но передача по быстрому соединению занимает мало времени. Поэтому отдельно проверил большой набор при ограничении скорости до 4 Мбит/с, без дополнительной задержки.
В этом сравнении оставил JSON и проверил влияние структуры ответа и HTTP-сжатия. В таблице отдельно показаны подготовка ответа в Node.js, компрессия, передача и подготовка серий в браузере. Все значения времени указаны в миллисекундах.
Формат |
Сжатие |
Подготовка Node.js |
Компрессия |
Передача |
Подготовка в браузере |
Всего |
|---|---|---|---|---|---|---|
Строки |
Без сжатия |
257 |
0 |
36 834 |
208 |
37 342 |
Колонки |
Без сжатия |
125 |
0 |
9 859 |
43,1 |
10 037 |
Строки |
gzip |
261 |
198 |
5 403 |
84,8 |
5 979 |
Колонки |
gzip |
126 |
58 |
1 623 |
27,9 |
1 851 |
Строки |
Brotli |
250 |
108 |
5 421 |
87,4 |
5 903 |
Колонки |
Brotli |
126 |
24 |
1 584 |
28,0 |
1 779 |
Строки |
deflate |
255 |
196 |
5 403 |
87,8 |
5 966 |
Колонки |
deflate |
127 |
57,3 |
1 623 |
27,2 |
1 8512 |
Строки |
Zstandard |
261 |
56,5 |
5 773 |
93,7 |
6 214 |
Колонки |
Zstandard |
133 |
12,4 |
1 778 |
29,6 |
1 964 |
Время передачи также включает обработку HTTP-потока браузером.
На соединении 4 Мбит/с уменьшение ответа заметно повлияло на время загрузки. Даже без сжатия переход к колонкам сократил время до готовых серий с 37 до 10 секунд, то есть почти в 4 раза. При включении сжатия колонки оказались быстрее примерно в 3 раза.
Компрессия дала дополнительное ускорение. По сравнению с передачей без сжатия gzip ускорил строчный вариант в 6 раз, а колоночный — в 5 раз. Затраты на компрессию окупились сокращением времени передачи.
Минимальную медиану для колонок показал Brotli — 1,78 секунды. Это в 5,6 раза быстрее несжатых колонок и примерно в 21 раз быстрее исходного строчного ответа без сжатия.
Какой вариант я оставил
Показатель |
Строки |
Колонки |
|---|---|---|
Ответ без сжатия, КБ |
18 414 |
4 927 |
Ответ с gzip, КБ |
2 701 |
811 |
Время локально с gzip, мс |
536 |
235 |
Время при 4 Мбит/с с gzip, мс |
5 979 |
1 851 |
Прирост RSS Node.js без сжатия, МБ |
18,8 |
4,93 |
Прирост RSS Chromium без сжатия, МБ |
107 |
73,3 |
Для продукта я выбрал колоночный JSON с общим массивом времени. На большом наборе он уменьшил ответ и время подготовки серий, а также показал меньший прирост RSS.
MessagePack обрабатывался быстрее в локальных тестах, но преимущество по размеру зависело от компрессора. Дополнительная зависимость ради такого результата показалась мне неоправданной.
Сжатие в продукте уже настроено на reverse proxy. Его настройки я не менял. Сравнение компрессоров в демке использовал для оценки их влияния на размер ответа и время загрузки.
Как я изменил загрузку и отрисовку графиков
Как новый ответ превращается в график
При переписывании приложения я также заменил Highcharts на ECharts и выбрал Canvas для отрисовки. В предыдущей реализации графики строились через SVG. Для графиков с большим количеством линий и точек Canvas быстрее. Вместе с библиотекой изменилась и подготовка данных для графика.
Исходные данные могут приходить в произвольном порядке. При подготовке ответа BFF раскладывает их по общей временной сетке. Благодаря этому в браузер приходит уже упорядоченная структура, которую не нужно повторно группировать по сегментам и сортировать по времени.
На фронтенде остаётся преобразовать массивы времени и значений в серии для ECharts. Каждая комбинация метрики и сегмента становится отдельной линией. Ключ сегмента используется для её подписи, а общий массив времени задаёт положение точек по горизонтальной оси.
Компактный ответ уменьшает затраты на загрузку и подготовку данных. При этом пользователь всё ещё может выбрать тяжёлую комбинацию фильтров или получить сотни линий. Поэтому следующим шагом я занялся выбором источника данных и оценкой объёма ещё до загрузки.
От множества вкладок к настройке фильтров
В предыдущей версии приложения каждой таблице на бэкенде соответствовала отдельная вкладка. Таблицы отличались наборами метрик и доступных фильтров. Разработчикам было удобно копировать вкладку при появлении новой таблицы. Но пользователю приходилось переключаться между похожими экранами и заново настраивать фильтры. Он мог выбирать значения фильтров, но не мог менять их состав. Набор доступных фильтров был задан выбранной вкладкой.
При этом на бэкенде есть и более универсальные таблицы, которые поддерживают почти все фильтры. Но у них свои ограничения. Запросы выполняются медленнее, а данные хранятся за меньший период.
В новой версии я оставил вкладки для разных наборов метрик, а состав фильтров пользователь настраивает сам. Для выбранного набора приложение подбирает подходящую таблицу с наивысшим приоритетом. Приоритет отражает ожидаемую скорость получения данных.
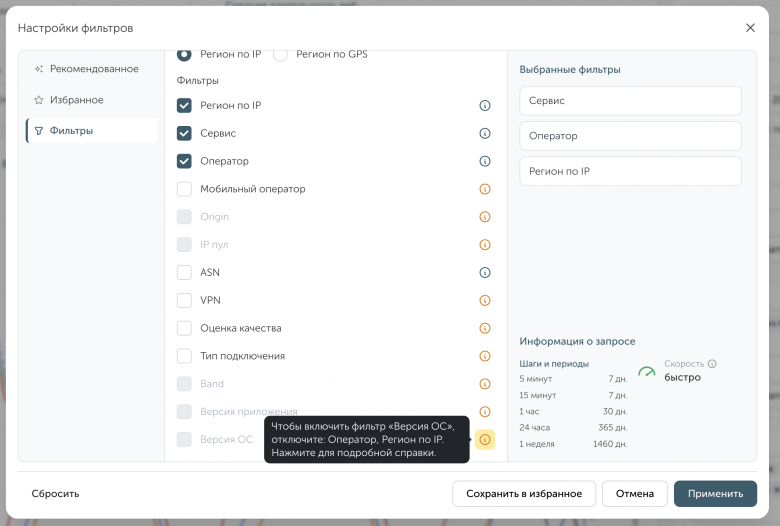
Не все сочетания фильтров доступны одновременно. Если фильтр нельзя включить, подсказка объясняет, какие настройки нужно изменить. Например, чтобы включить «Версию ОС», нужно отключить «Оператора» и «Регион по IP».
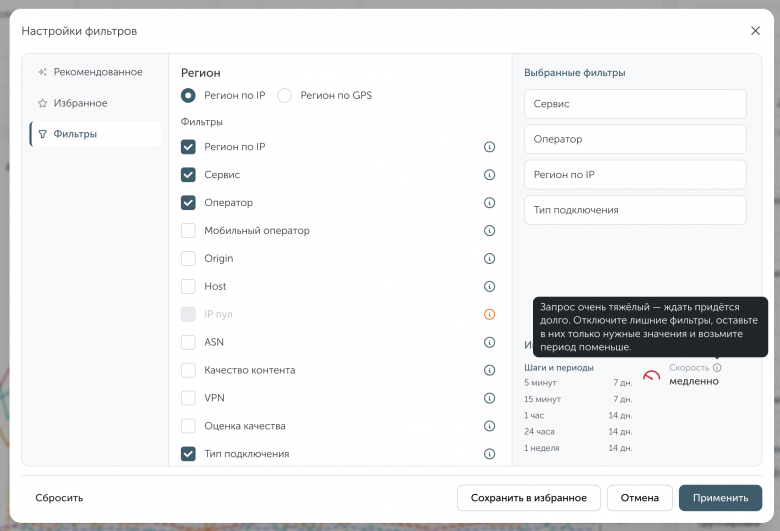
Индикатор в виде спидометра показывает ожидаемую скорость запроса для выбранной таблицы. Для тяжёлого запроса подсказка предлагает отключить лишние фильтры, оставить только нужные значения и уменьшить период.
Для выбранного набора фильтров интерфейс также показывает доступные шаги агрегации и глубину истории. Например, в одном из показанных наборов часовые данные доступны за 30 дней, а в другом только за 14.
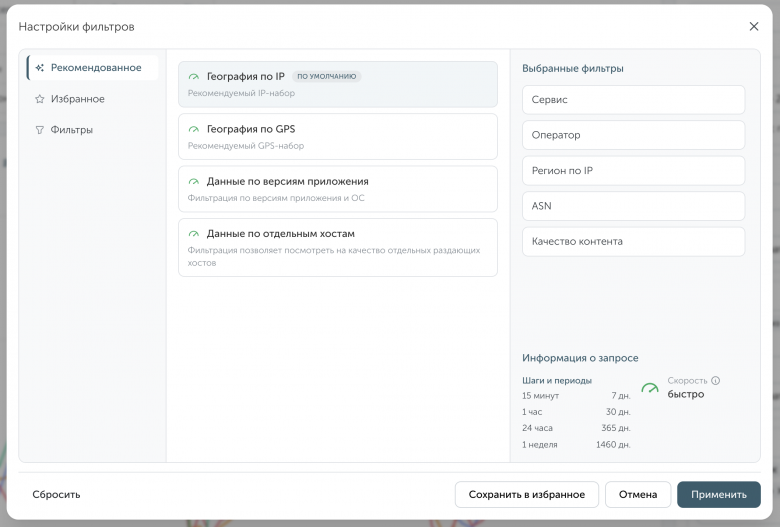
Чтобы не собирать набор фильтров каждый раз, его можно сохранить в избранное. Для типовых задач мы также подготовили рекомендованные наборы.
Оцениваем число линий до запроса
Перед загрузкой приложение оценивает максимально возможное количество линий для выбранных метрик и группировок.
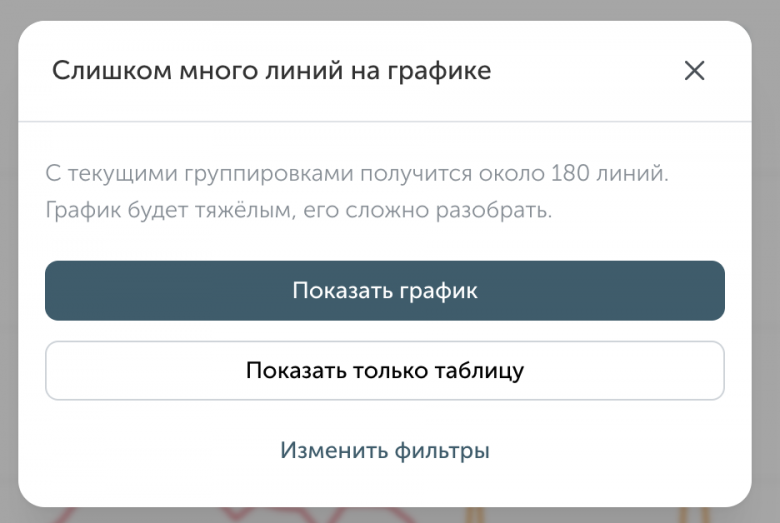
Если их больше 100, приложение показывает предупреждение. Пользователь может дождаться загрузки графика или получить только таблицу с суммарными значениями.
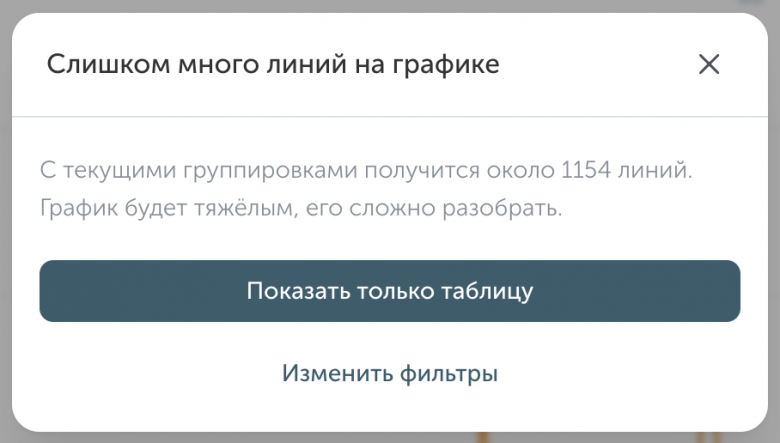
Если ожидается больше 500 линий, остаётся только вариант с суммарными данными.
Суммарные значения рассчитывает ClickHouse. Если пользователь выбирает только таблицу, приложение запрашивает агрегаты без точек временных рядов. Это уменьшает объём данных, передаваемых из базы в приложение и далее в браузер, а также избавляет браузер от подготовки и отрисовки графика.
Но предварительная оценка может быть завышена. Не все возможные сочетания фильтров обязательно присутствуют в ответе, и фактических линий иногда оказывается гораздо меньше. Если были загружены только суммарные значения, данных для построения графика уже нет. В бэклоге лежит задача добавить кнопку, по которой пользователь сможет отдельно загрузить график.
Упрощаем отрисовку после загрузки
Когда данные получены, приложение уже знает фактическое количество линий. Если их больше 32, отключаются анимации и подсветка линий при наведении, а толщина уменьшается с 2 до 1,5 пикселя.
Так для небольших графиков сохраняется привычное поведение, а для более сложных используется упрощённый вариант отображения.
Пока загружаются данные
Даже после оптимизаций данные иногда приходится ждать. Смотреть на обычный крутящийся лоадер было скучно, поэтому во время загрузки я добавил короткие сообщения.
«Опрашиваем сервера…»
«Перекладываем нули…»
«Считаем до десяти. Медленно…»
Часть сообщений общая для всего приложения, часть зависит от раздела. Например, при загрузке графиков появляются «Выравниваем оси…», «Считаем точки на графике…» и «Подбираем цвета для линий…».
Заготовки помогла сделать LLM. Я сгенерировал сто общих сообщений и по сто сообщений для каждого раздела. Затем примерно половину удалил, так как они мне не понравились.
Пользователи писали, что им эта деталь понравилась. Получилось небольшое дополнение к техническим оптимизациям, которое сделало ожидание приятнее.
Что получилось
В продукте я перешёл на колоночный формат с общим массивом времени. В демке на большом наборе он уменьшил gzip-ответ в 3,3 раза, а время до готовых серий при 4 Мбит/с — примерно в 3,2 раза.
В продукте на одном из больших запросов размер сжатого ответа уменьшился с 1 МБ до 500 КБ. При скорости соединения 4 Мбит/с время до отрисовки графика сократилось с 3 до 1.5 секунд. На быстрой сети экономия на передаче данных менее заметна, но время обработки ответа на сервере и в браузере тоже зависит от его структуры.
Для тяжёлых графиков добавил возможность загрузить только суммарные значения. Настройка фильтров теперь показывает доступную глубину истории и ожидаемую скорость запроса ещё до загрузки данных.