

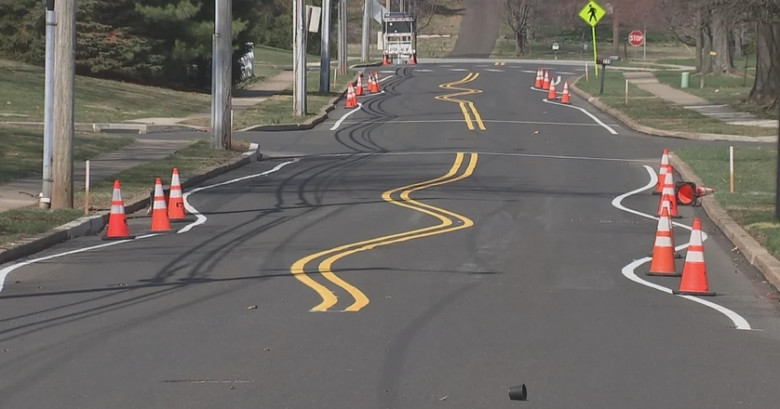
Мудрость Спольски
В 2001 году Джоэл Спольски, сочинения которого сильно повлияли на мою карьеру, написал великолепную статью Back to Basics. Суть её заключается в том, что практикующим программистам нужно разбираться в основах: какой бы абстрактной и далёкой от базовых алгоритмов ни казалась наша работа, от них неожиданно глубоко зависят наши проекты.
В качестве одного из примеров подобного Джоэл приводит ловушку «маляра Шлемиля», в которой кажущийся простым выбор приводит к квадратичной временной сложности. В притче о Шлемиле маляр, рисующий линии на дороге, не носит с собой банку с краской. Он движется вперёд, и ему приходится всё больше времени тратить на то, чтобы вернуться к банке.
Удивительно, насколько часто паттерн маляры Шлемиля встречается1 даже в 2026 году.
Мой сервис не выдерживает нагрузки
Несколько дней назад я опубликовал пост о выпущенном мной сервисе анализа шахматных партий2. Это преимущественно сервис на Rust с базой данных SQLite, который распределяет задачи анализа между раннерами. Каждый такой раннер обрабатывает до нескольких сотен шахматных партий и возвращает основному сервису большой набор JSON‑пакетов. Там они обрабатываются, а затем записываются в SQLite.
Хотя для анализа задействуются два десятка ядер раннера на протяжении нескольких минут, сохранение данных должно занимать миллисекунды. Даже доли миллисекунды.
Представьте моё удивление, когда при обработке первого действительно большого набора партий простая операция вставки JSON‑данных (примерно сорок тысяч записей) в хранилище заняла несколько минут. Во время всех моих тестов эта операция ни разу не становилась узким местом, но на большом наборе записей внезапно превратилась в серьёзную проблему.
Ещё больше меня озадачило то, что операция полностью загружала одно ядро процессора, то есть была ограничена производительностью CPU. Как простая вставка JSON в SQLite могла отнимать столько процессорного времени?
На сцену вышел маляр Шлемиль. Спойлер: в проект его привёл компилятор cc из Zig и реализованная в нём замена функций стандартной библиотеки.
Небольшая проблема Zig становится серьёзной проблемой производительности
Проект написан не на Zig, а на Rust. Крейту sqlx для SQLite требуется компиляция под целевую платформу — сама SQLite, разумеется, написана на C. Поэтому для упрощения кроссплатформенной сборки, позволяющей создавать на этой машине двоичные файлы для Mac ARM64 и Linux ARM64 / x86-64, используется zig cc: при сборке под Linux он компилирует SQLite, обеспечивая кроссплатформенную поддержку через cargo‑zigbuild.
С помощью одного скрипта сборки и развёртывания на моём Mac я могу собирать приложения для все целевых платформ без контейнеров и отдельных машин для сборки. Изящная библиотека libzigc из Zig заново реализует стандартную библиотеку, позволяя статически компоновать необходимую функциональность.
Zig использует musl (переписанную реализацию стандартной библиотеки), но постепенно разработчики переносят её компоненты на чистый Zig (в составе libzigc), по одной устраняя зависимости от C.
Именно здесь и появилась проблема с производительностью.
В переписанной strspn, заменяющей реализацию musl вариантом на чистом Zig, первым делом вычисляется полная длина строки. То же самое можно увидеть в новых реализациях strcspn, strpbrk и strstr.
Это представляет проблему для токенизаторов. Токенизатор получает огромную строку; типичный шаг при её обработке — пропустить символы пробелов, перейти к новой позиции в строке, а затем снова повторить эту последовательность действий. Из‑за появившегося в этих новых реализациях паттерна «маляра Шлемиля» при продвижении по тексту токенизатор каждый раз заново вычисляет длину оставшейся части строки.
Именно это и стало причиной проблем с производительностью. К тому же это объясняет, почему они проявились в Linux, но не возникали на моём Mac (где Zig при компиляции SQLite не использовался).
Токенизация файла JSON размером 1,2 МБ, передаваемого SQLite, при использовании этого паттерна происходит примерно в 12 тысяч раз медленнее. По мере увеличения размера файла замедление растёт квадратично.
Повторение классических проблем
Я ни в коем случае не хочу оскорбить участвующих в разработке этих великолепных инструментов, сильно расширивших наши возможности, но любопытно было отметить, что даже в 2026 году мы по‑прежнему сталкиваемся с теми же старыми проблемами, поэтому нам всё ещё нужно быть настороже. Кажущиеся тривиальными действия могут приводить к сильному торможению процессов в неожиданно тривиальных местах.
Изначально я устранил эту проблему в своём коде предварительным вырезанием пробелов из JSON, что существенно снизило затраты на токенизацию в sqlite3, но поскольку я не знал, где ещё могут возникнуть проблемы, то перенёс сборки для Linux в Linux‑контейнеры.
Примечания
-
Много лет назад, когда практически обязательным был бенчмарк Sunspider, а браузеры хвалились своими показателями в нём, тот же паттерн можно было наблюдать при обработке конкатенации строк в Firefox, из‑за чего его показатели в этом бенчмарке оказывались низкими. Выполнение бенчмарка Sunspider каким‑то образом приводило к огромному количеству конкатенаций строк (даже если тесты не были связаны со строками), и простое профилирование3 прогона бенчмарка демонстрировало, что существенную долю времени исполнения занимало постоянное распределение постепенно увеличивающейся памяти под строки, копирование в новое место и повтор этого паттерна. Это как раз и был паттерн маляра Шлемиля.
Я устранил эту проблему: выделял для строк память с запасом, размер которого зависел от текущей длины строки. Благодаря этому при последующих конкатенациях можно было повторно использовать тот же буфер, пока не возникала необходимость увеличить его размер. При каждом таком увеличении снова выделялся дополнительный запас. Я написал об этом в блоге, Брендан Айк обратил внимание на эту идею, и вуаля — Firefox вышел в лидеры бенчмарка4. Такая мелочь превратила его из медлительного аутсайдера в лидера тестирования.
Я не испытываю иллюзий по поводу того, что смогу содержать семью на деньги от нишевого сервиса анализа шахматных партий: максимум, на что я рассчитываю — что он оправдает затраты на его эксплуатацию. Я выложил его в открытый доступ, потому что счёл свою работу в этом направлении полезной для собственной игры. Надеюсь, что время от времени она будет находить тех, кому пригодится, и при этом не будет создавать для меня дополнительных расходов.
Профилировщики — удивительные программы. Это самые мощные из имеющихся у нас инструментов, поэтому мне кажется странным, что их настолько редко применяют.
И стоит отметить, что конкатенация строк была чрезвычайно распространена практически во всех веб‑проектах, поэтому выигрыш был весьма ощутим и в реальных условиях. Существовала рекомендация использовать для этого специальные string builder, но очень часто разработчики просто соединяли строки в цикле.
Комментарии (15)

Chupaka
10.11.2026 11:05Почувствовал себя немного Шемелем, листая вручную к сноскам и обратно, без прямых ссылок...

oracle_schwerpunkte
10.11.2026 11:05Ну зачем SQLite ? Это же просто fopen() на стероидах. Гениальный инструмент, но не для сервисов. Сейчас вы решили одну проблему, но вас ждут еще много удивительных приключений https://habr.com/ru/articles/1073978/.


sorosgpt
10.11.2026 11:05только мюсли штаны отстирали со своим нетакусиковым crypt(), а тут уже и свидетели ещёболеенетакусиковеого zig-а подоспели.

aegoroff
10.11.2026 11:05В переписанной strspn, заменяющей реализацию musl вариантом на чистом Zig, первым делом вычисляется полная длина строки.
далеко не факт что это неправильно, просто для вашего варианта использования (гигантские строки) это не подходит. Например полная длина строки нужна чтобы случайно не заехать за границу выделенного под строку буфера, и таким образом не получить повреждение памяти со всеми вытекающими. Т.е. это, возможно, изменение сделанное в угоду безопасности, но очень сильно влияющее на производительность.


lazarus_net
10.11.2026 11:05А не вариант вместо json что-нибудь более нормальное использовать? На одних скобках и кавычках можно куче места съэкономить.
Попробовали бы результаты партии или в CSV завернуть, или в какой-нибудь формат, который или SQLite может нарэпрчмуб импортировать или который пансион удобнее. Например, в старые добрые времена когда надо было большие текстовые файлы парсить каждая строка начиналась с ее длинны, а потом уже данные, что позволяло существенно ускорить разбор. …..
vanxant
Не понял, зачем переписывать libc на zig, чтобы что? Ну фор фан понятно, но зачем тащить этот недоделанный овнокод в прод?
zelenin
чтобы кросс-компилить статические приложения
vanxant
... и чем обычная libc на C этому мешает?
это раз. Ну и два, а вы вообще пробовали что-нибудь запустить на машине без libc.so? Я пробовал, запустить можно аж целое ничего:)
zelenin
видимо ключевое слово кросс
Gaikotsu
Видимо потому что оригинальный libc имеет фатальный недостаток :)
Siemargl
А фокус тут в том, что не овнокод)
Просто идиому работы со строками/слайсами/массивами тупо перенесли с языка на язык. А она разная.
Типичная кстати ошибка будет для ии-трансляций.
А сам перенос для генерации бинарников без зависимостей, как это сделано в go, например. Кстати, в Циг еще замахивались на аналогичную тему в виндовс, перейти на прямые вызовы ядра.