

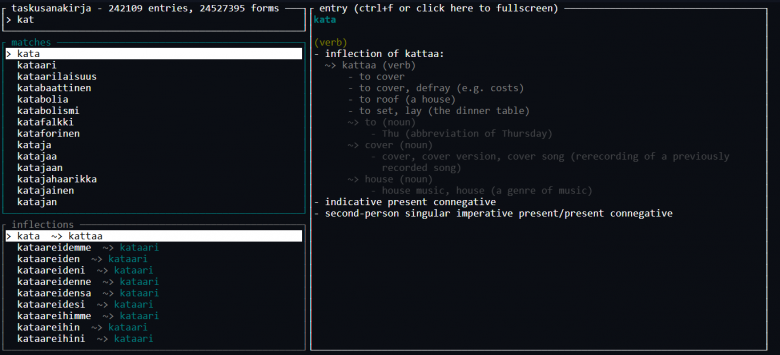
Примечание для любителей чисел: все значения в статье округлены до первого значимого разряда, потому что я фанат метода «zequals» Роба Истэуэя, который позволяет сразу переходить к сути при выполнении оценочных расчётов. Гораздо полезнее запомнить такую эвристику: «Один парень сократил потребление памяти в 300 раз, заменив самодельную базу данных на крошечную статическую специализированную структуру данных, которая делает именно то, что ему нужно, и ничего лишнего».
В одни выходные мне представилась невероятно редкая возможность поработать с Taskusanakirja, часто называемым tsk — финско‑английским словарём с инкрементальным поиском в процессе набора1. Принципиально эта задача сводится к префиксному поиску, а каноническое решение префиксного поиска с автозавершением — это реализация префиксного дерева.
Она замечательно работала в первой реализации tsk, написанной на Go (о которой я уже много раз рассказывал). В ней используется несколько базовых оптимизаций. Чтобы не выполнять поиск по нескольким процентам от общего числа слов (а их было несколько сотен тысяч), которые мы встраивали непосредственно в исполняемый файл (с самого начала одной из целей проектирования было поставлять всю программу в виде одного файла .exe, одного файла .app или одного статически скомпонованного исполняемого файла), мы установили ограничение: например, возвращать только первые 50 или 100 совпадений. Кроме того, мы просто заранее кэшировали все комбинации из 1, 2 и 3 символов. После этого за целый год интенсивного личного использования я больше ни разу не замечал сколько-нибудь ощутимых задержек в работе программы. При помощи подобных простых оптимизаций мы смогли сжать префиксное дерево примерно в 60 МБ.
Однако финский язык отличается чрезвычайно развитой агглютинацией. Одно-единственное исходное слово может иметь более сотни возможных окончаний, если учитывать все их комбинации. Причём эти комбинации не образуются по какому-то простому регулярному правилу!2 Кроме того, чрезвычайно последовательная орфография финского языка означает, что написание слов точно отражает то, как носители языка действительно их произносят. Поэтому по мере добавления окончаний исходные слова причудливым образом удлиняются, изменяются и трансформируются, приобретая благозвучные формы. Всё это кажется совершенно естественным, если ты уже пару лет погружён в изучение языка. Но новичок, увидев предложение вроде «Opiskelijassammekin on leijonan sydän», с большой вероятностью споткнётся об одно конкретное слово. Одна из задач этой программы — помочь изучающему понять, где именно нужно правильно разделить слово на составляющие, и для этого она тоже включает в себя всю необходимую информацию.
Здесь префиксное дерево даёт сбой. Можно хранить 400 тысяч элементов в префиксном дереве, занимающем около 50 МБ ОЗУ, но этот трюк не масштабируется до 40–60 миллионов элементов. По крайней мере, если вы пытаетесь работать на древнем ноутбуке студента из Джакарты. Вконец отчаявшись и понимая, что время на исходе, я развёл руками и сказал: «Ладно, выпущу словоформы в отдельной базе SQLite с полнотекстовым поиском (FTS, Full-Text Search). Пусть ищут там, если им так уж приспичило». Это сработало — по-прежнему без каких-либо заметных задержек, — но для этого пользователям приходилось единовременно скачивать целых 3 ГБ данных. Не самое удачное решение!
На этом закончилась история примерно девять месяцев назад. В эти выходные, уже имея девять дополнительных месяцев опыта напряжённой разработки ПО, я задал смелый вопрос: не переписать ли мне всё это на Rust?3
Оказалось, что очень умный человек по имени BurntSushi (Эндрю Гэллант), известный разработкой крайне быстрого grep под названием ripgrep (этот инструмент настолько универсален и полезен, что несколько лет назад я поместил его в «Святую Троицу» современных команд оболочки), тоже однажды столкнулся с похожей проблемой и написал пост Index 1,600,000,000 Keys with Automata and Rust. (Предупреждение: это длинный, но чрезвычайно интересный текст.) В самом начале есть спойлер:
Оказалось, конечные автоматы полезны не только для выражения вычислений. Они также применимы для компактного представления упорядоченных множеств или таблиц строк, по которым можно выполнять быстрый поиск [prefix, fuzzy, suffix].
Мне показалось, что это звучит многообещающе. Попробуем написать минимальную программу на Rust для извлечения данных из этой базы данных размером 3 ГБ и сжатия их в конечный автомат4. Должен сказать, я всегда осознавал, что это хак; зато это лучший хак, который я смогу реализовать с имеющимися у меня временем и силами. Насколько маленьким его удастся сделать?
Десять мегабайт. В 300 раз меньше. Даже в мире пользователей крейта fst это приложение — сопоставление форм спряжения и склонения в языке с чрезвычайно развитой агглютинацией с их исходными словарными формами — оказалось исключительно удачно подходящим для этой технологии. В отличие от префиксных деревьев, FST сжимают и префиксы, и суффиксы, а в таком языке, как финский, есть всего несколько очень распространённых суффиксов, которые многократно повторяются во всём словарном корпусе. При этом набор данных остаётся неизменным во время выполнения программы, что позволяет обойти «главный недостаток» fst.
И всё же хочу особо отметить: мне удалось экспериментировать без особых затрат и в итоге совершенно случайно наткнуться на это удачное решение лишь благодаря тому, что девять месяцев назад, оказавшись перед выбором между плохим, но простым решением и хорошим, но несуществующим решением, я выбрал плохое, но простое5. База данных SQLite выполняла свою задачу! Я понимал, как она устроена изнутри: как работают её B-деревья и расширение для полнотекстового поиска. Кажется, я даже использовал то же самое расширение FTS для реализации некоторых менее востребованных функций, которых пока нет в альфа-версиях tsk v2.0.0 и от которых, скорее всего, придётся отказаться вовсе, если ради них потребуется пожертвовать теперь уже просто восхитительно малым объёмом занимаемой памяти.
Потому что версия Pro v2 должна даже со всеми наворотами занять всего 20 МБ, что в три раза меньше бесплатной версии v1. Посмотрим, что в итоге останется после окончательного «монтажа».
Изначально
tskбыла TUI-программой на Go и на самом деле эволюционировала из более раннего прототипа на базеfzfпод названиемfinstem. Подробнее об этом я писал в статье The highest‑ROI program I’ve written so far. Идея «карманного словаря» (финское слово taskusanakirja буквально означает «карманный словарь») с самого начала была принципиально важной: если программа не помещается на стареньком пыльном ноутбуке, который мог достаться вам по наследству от дяди, то это уже не карманный словарь, а старый добрый Oxford Dictionary, только с возможностью компиляции.Лингвисты называют изменения, вызываемые суффиксами, чередованием ступеней и сингармонизмом. В финском языке действуют оба этих явления одновременно. Возьмём для примера слово katu («улица»): его форма родительного падежа — не katun, а kadun —
tпереходит вd, потому что слог стал закрытым. А теперь представьте, что подобные изменения нужно учитывать для 15 падежей, двух чисел (единственного и множественного), шести притяжательных суффиксов и ещё неопределённого количества возможных клитик. Становится понятно, почему наивное префиксное дерево не может быть решением. Оно просто не умеет распределять затраты на хранение между тысячами слов, оканчивающихся на-ssa-mme-kin(«в‑ нашем [X]‑ тоже»).«Переписать на Rust» («Rewrite It In Rust») — это уже само по себе мем, которому посвящён целый жанр постов с критикой этой идеи. Но если отбросить шутки, в нём есть рациональное зерно. Например, можно сформулировать его так: если ваша задача одновременно требует высокой производительности и переносимости, а существующие инструменты отличаются крайне неудобной работой с памятью, Rust может оказаться для вас настоящей находкой.
Секрет, благодаря которому FST намного компактнее префиксных деревьев при работе с естественными языками, заключается в совместном использовании суффиксов (suffix sharing). Префиксное дерево объединяет общие начала слов (так,
kadunиkaduilleиспользуют первые три узла совместно), но для каждого уникального пути к окончанию создаёт отдельную ветвь. Минимальный ациклический детерминированный конечный автомат (DAFSA), напротив, объединяет любые поддеревья с одинаковой структурой. Для корпуса, в котором 100 000 слов оканчиваются одной и той же дюжиной словоизменительных моделей, это означает практически неограниченные возможности экономии памяти.В моих заметках постоянно повторяется одна и та же мысль, к которой я всё время возвращаюсь в контексте принципа «решать одну и ту же задачу дважды — это нормально». Можно сказать, что в первую четверть своей жизни я, несмотря на постоянное увлечение программированием, никак не мог избавиться от чувства вины: а вдруг инструмент, который я сейчас создаю, уже давно устарел, потому что кто-то другой написал гораздо более совершенную реализацию ещё тридцать или сорок лет назад? Например, я мог написать утилиту для поиска и замены с поддержкой TSV, а мог узнать об
awkи одним махом решить целый класс подобных задач. Моя главная мысль заключается в том, что это ловушка. Чтобы добраться до переднего края наших знаний об изобретении колёс, нужно самому изобрести несколько колёс. Не тысячу, но и не ноль. В большинстве областей, вероятно, достаточно четырёх-пяти, а в наиболее развитых с точки зрения строгости познания дисциплинах, таких как математика или информатика, — возможно, двадцати-тридцати. Каждое заново изобретённое колесо и каждый целенаправленный вопрос, который вы задаёте по пути к этому, приближают вас к настоящему переднему краю знаний быстрее, чем тот же объём времени, потраченный на пассивное изучение теории; возможно даже в пять раз быстрее. По сути, это взгляд, близкий к позиции Брайана Каплана: «Если школы почти не обучают профессиональным навыкам, перенос знаний из одной области в другую — в значительной степени лишь благие пожелания, а влияние образования на интеллект во многом иллюзорно, то как же тогда люди вообще становятся хорошими специалистами? Тем же способом, каким попадают на сцену Карнеги-холла: благодаря практике». А если вам больше нравятся призывы к действию, то моя любимая неприятная, но действенная рекомендация — «делайте в десять раз больше».